ARTICLE · 1037514
论文不再只是PDF:Paper2Agent把方法变成接口,也把边界带进系统
在一个与低密度脂蛋白胆固醇相关的基因位点案例里,Paper2Agent生成的AlphaGenome agent把SORT1列为最可能的因果基因;原AlphaGenome论文强调的却是CELSR2和PSRC1。三者分数都很高,也都有显著eQTL。这个分歧没有证明agent发现了新基因,也不能反过来证明原论文正确。它说明了一个更实际的问题:分析流程可以被封装和调用,科学判断却不会因此自动完成。
2026年9月16日,《Nature》正式发表Paper2Agent论文。这个系统不只是让AI回答“论文讲了什么”,而是读取论文及其公开代码,运行教程,抽取可复用步骤,再将它们组装成下游AI Agent能够调用的MCP server。
研究团队对100篇计算生物学论文进行了测试,其中74篇完成了agent化;系统生成599个候选工具,593个通过自动验证。这个结果证明了工作流转换可以规模化,却没有证明论文一旦变成Agent,就具备普遍的科学可靠性。Paper2Agent把论文里可执行的部分变成了接口,原本散落在代码、环境、作者经验和实验失败记录中的问题,也随之进入系统运行链。
一个“会执行”的论文,为什么仍需要研究者
Paper2Agent最吸引人的能力,是把“理解方法”向前推进到“运行方法”。在AlphaGenome案例中,agent不只给出文字解释,还会调用工具完成分析和候选排序。但工具忠实执行了代码,不代表原始实现、数据选择、默认参数和解释方式一定适合新的研究问题。
候选排序也不等于因果确证。在另一个银屑病案例中,三个paper agent协作,对GPR137提出了“可能的因果基因”支持。用于验证的signature-correlation策略并非来自源论文;人类研究者从十个候选方案中选择了这条路线。Agent参与了分析设计和数据整合,最后的策略选择与因果判断仍有人类介入。
这样的分工并不削弱Paper2Agent的价值。它缩短的是从论文、代码到一次可运行分析之间的距离,而不是替研究者作最后裁决。
Paper2Agent重建的不是摘要,而是一段工作流
Paper2Agent的构建流程分为六步:
定位并下载代码库 建立隔离环境 扫描仓库中的教程 用示例数据执行并审计教程 将可复用步骤抽取为参数化工具并测试修复 最后组装MCP server
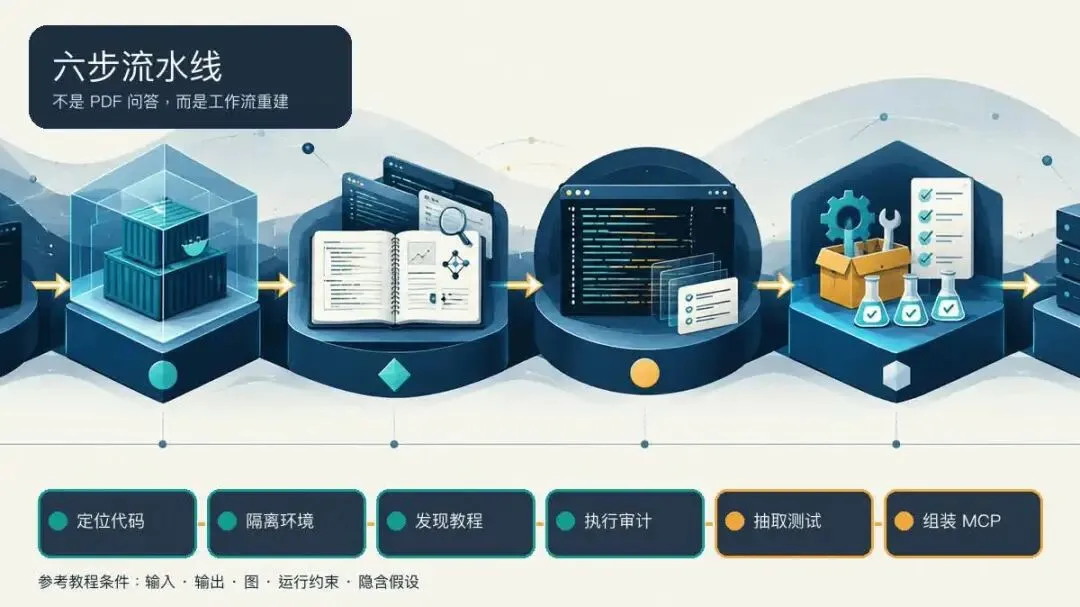
这里的核心资产不是论文摘要,而是能够运行的教程。系统会记录输入、输出、图、运行约束和隐含假设;每个函数最多经历六次生成、执行、诊断与修复。持续失败的函数会被排除,不进入最终server。Paper2Agent因此更接近一个由代码、环境、教程和测试驱动的工作流抽取器,不负责凭空补写仓库中没有的算法。
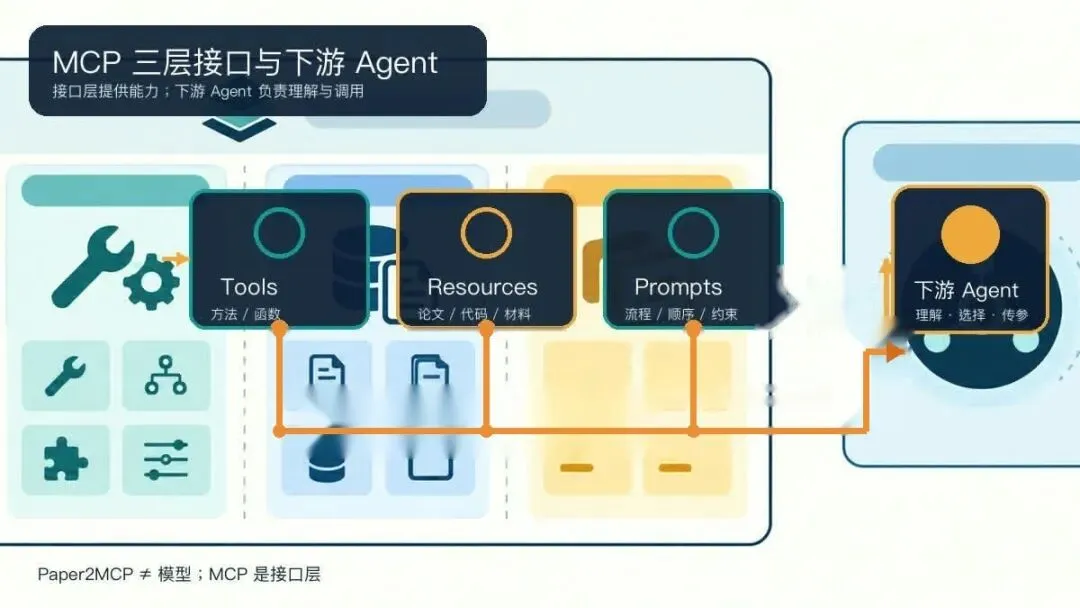
生成的MCP server包含三类组件:Tools封装可执行函数,Resources提供论文、代码和补充材料,Prompts记录复杂工作流的顺序与约束。以Scanpy为例,Prompt可以规定质量控制、标准化、特征选择、降维、建图、聚类和细胞类型注释的执行次序。
Claude Code或其他兼容Agent连接这些组件后,负责理解问题、选择工具、传入参数并整理结果。MCP在这里是接口层,不是模型本身。
91.2%的准确率,回答的是一个有限问题
在100篇计算生物学论文构成的评测中,研究团队准备了300个基于教程的问题。Paper2Agent配合Sonnet 4取得91.2±1.6%的准确率;让Claude直接读取仓库时,Sonnet 4为80.3±2.3%,Sonnet 4.6为86.3±1.1%。
关键评估数字:Paper2Agent + Sonnet 4:91.2±1.6%;直接读取仓库的Sonnet 4:80.3±2.3%;Sonnet 4.6:86.3±1.1%。
这组数据说明,把运行步骤提前封装成工具,比让模型临时阅读仓库、现场组织代码更稳定。不过,准确率对应的是论文设定的问题和参考答案,口径是mean accuracy±s.e.m.,不能外推成开放科研任务的普遍正确率。
AlphaGenome的评测进一步展示了这种边界。基准包含15个tutorial问题和15个novel问题,每类运行5次,结果分别为98.7±1.3%和100.0±0.0%;在30个开放式问题上,结果降到82.7±2.4%。题目数量、专家构造方式和参考流程共同限定了这些数字的含义。
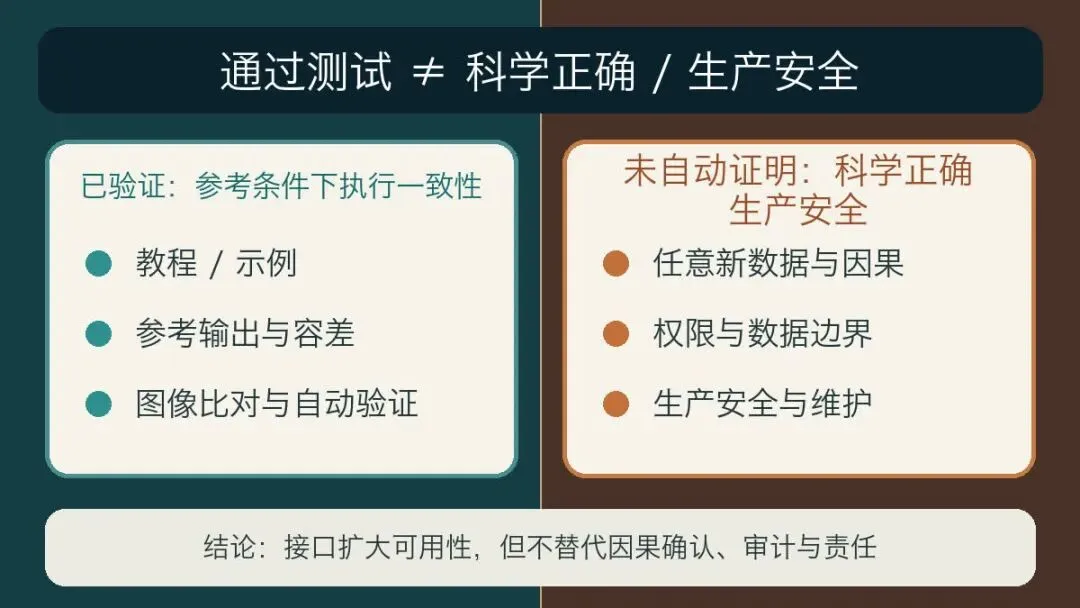
工具层也有明确的验收规则:数值结果允许3%的容差,图像采用感知哈希比对,Hamming distance小于20。它能检查文件是否生成、数值是否接近教程输出、图像是否相似。任意新数据上的统计有效性、因果解释以及生产环境的安全性,不在这套自动测试的证明范围内。
规模化测试中的失败同样重要。100篇论文中有26篇没有顺利完成agent化,常见原因是代码不完整、文档缺失或环境配置无法解析。成功数字与失败样本共同定义了适用范围:系统可以把部分论文方法转成经过参考条件测试的接口,但没有验证整篇论文、整个代码库或全部输入空间。
Scanpy案例用约45分钟和13美元生成了7个工具,并全部通过自动验证。这是特定工作流、模型版本、API价格、输入规模和个人电脑条件下的实验记录,不是任意论文的固定报价或服务承诺。
论文之外的知识,会变成接口的运行条件
论文和代码通常不是完整的实验记录。斯坦福官方介绍提到,失败实验、实验设置中的取舍,以及只有作者掌握的判断,并不会全部进入手稿,需要作者通过对话补充。《Nature》论文也明确保留了人的位置:开放式科学推理、假设生成和机制解释仍需人在环。
传统阅读过程中,使用者可能通过邮件、组会或反复试错补齐这些信息。工作流被包装成接口后,遗漏不会消失,而会表现为运行契约的缺口:哪些输入不适用,哪个参数需要调整,什么情况下应该拒答,哪些输出只能视为候选,何时必须回到原论文或请领域专家复核。
工具化让隐性知识变得更容易被看见,也要求它被记录、版本化和持续维护。不能公开的数据、难以重建的实验条件,以及高度依赖现场判断的研究,不会因为有了MCP就自然变得可移植。
从Demo到基础设施,还有一整条运行链
Paper2Agent依赖Python和Git,也可能需要目标仓库指定的R、原生CLI、数据、GPU和外部API。AlphaGenome需要API key;项目README要求凭证保留在主机的secret机制或环境变量中,不能写进生成代码、notebook、报告或压缩包。
项目还演示了通过HTTP连接托管在Hugging Face上的远程MCP。能访问一个URL,只能证明入口存在,无法证明认证、数据保留、限流、算力和上游依赖已经受到长期治理。公开仓库采用MIT许可证,也不意味着论文全文、数据集、模型权重、第三方代码和外部API自动获得同样的使用许可。
如果这类接口要进入正式研究流程,平台团队至少需要管理以下资产:
源码commit,以及依赖、数据和模型版本; 外部API版本、凭证权限与撤销机制; 执行环境、网络边界和敏感数据流向; 工具调用、结果、失败状态和拒答日志; 结果到论文、代码及数据的引用回链; 上游变化后的回归测试与维护责任。
“这次教程跑通了”和“这项服务现在仍然可审计”是两种验收。远程服务变化、数据下载状态、模型API行为和依赖升级,都可能让同一个接口在以后产生不同结果。安全、合规和长期维护能力需要额外证据,不能从论文提供了server直接推导。
决定是否把一篇论文变成Agent,可以先问五个问题
原始代码和数据是否完整、可获得,并允许按现有许可证使用?仓库缺文件、文档不全或关键数据不可访问,转换可能在起点就失败。 教程和测试覆盖了哪些输入,哪些只是示例?参考教程、人工构造问题、新数据执行和开放式科学问题需要分别验收。 源码、依赖、数据、模型和外部API是否锁定了版本?没有这些记录,所谓复现可能只是再次调用了一个同名接口。 工具具有什么权限,数据会去哪里,谁能审计和撤销?API key、GPU、远程MCP和外部数据服务都属于运行面。 结果是否携带不确定性、引用回链和失败状态,长期维护由谁负责?候选排序需要保留候选性质,输出也应说明生成它的版本和参考流程。
这五个问题评估的不是Agent会不会说话,而是工具能否被复核、授权、回滚和维护。
论文成为接口之后,边界也必须进入接口
Paper2Agent展示了一条可行的工程路线:将公开论文和代码中的选定工作流,包装成能够由自然语言调用的工具、资源和提示词。它减少了手工拼接环境、教程和参数的工作,让研究方法更容易被采用和复用。
这种便利没有删除原来的限制,只是改变了限制所在的位置。执行一致性不能替代科学有效性,公开代码不等于完整实验知识,可连接也不等于可以安全、稳定地投入生产。AlphaGenome案例中的候选结果能够更快到达研究者手里,但因果确认仍属于研究工作。
未来衡量paper agent是否成熟,不宜只数它们的数量。每个接口能否携带可追溯的版本、权限、失败记录、引用回链和责任归属,才决定它能否从演示进入长期使用。论文变成工具时,证据与维护义务也要一起进入工具。