ARTICLE · 1037604
免费开源,给AI装个技能,PDF就变成带出处还能自测的网页
learn-from-materials 是个免费开源的「Agent 技能」。Agent 技能,就是一套装给 AI 的标准工作流程,遵循开放的 Agent 规范。
它干的事:把 PDF、PPT、Word、网页这些材料整理成一份带出处的大笔记,再生成一个学习网页——网页上每句话,都能点回原文。
它解决的是 AI 总结的老毛病:AI 会挑重点、会编造、给不出出处。而这个工具只记录材料里有的内容,材料里没讲的,它老实标一句"材料里没讲"。
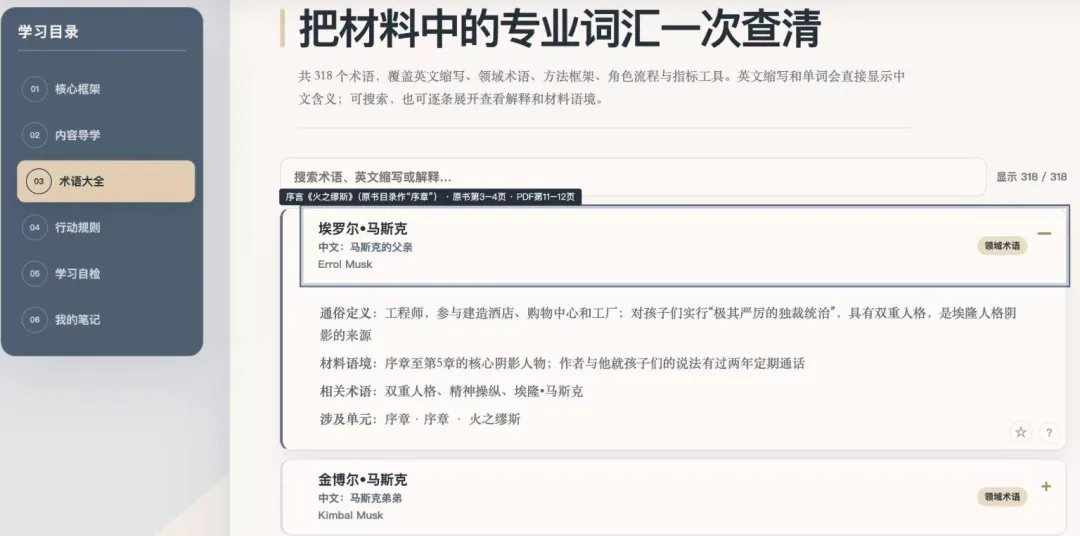
适合已经在用 opencode、WorkBuddy 这类本地 AI 助手的人,想把学习资料变成能反复查的笔记。整个过程不用碰命令行。
它不适合两种人:只在网页聊天框里用 AI、不想装任何东西的;需要多人协作、云端同步的(所有数据都保存在你自己电脑上)。
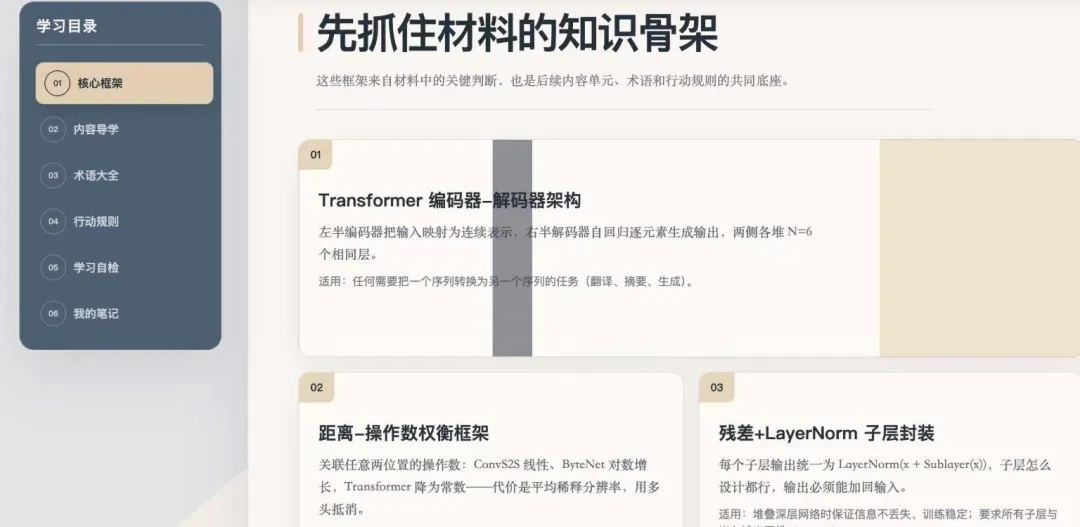
想看成品长什么样,点开官方示例网页,链接在文末参考链接 2。那是一个能切换阅读主题的学习页面(雾蓝书房、深海夜读、青灰宣纸等),能搜术语、能做自测题,每段知识点旁边都带着能点回原文的出处。
它靠什么做到"不瞎编"
原理一句话就能懂:AI 只被允许记录材料里出现的内容,没出现的标"未覆盖",生成前还要做一遍"覆盖校验"——检查每一页有没有被整理进去、每个出处对不对得上。
这决定了你会看到两个信号:
- 生成网页前,它先说"校验通过"——说明材料被完整整理,没糊弄;
- 回答问题时,它带着【材料依据】这类标签——把原文和它自己的补充分开了。
看懂这两个信号,就不用再问"它是不是在编"。
不懂原理也不耽误用:装好、丢材料、生成网页、点一下验证,四步照做就行。
把一个开源技能装进你的 AI
前置条件(都得满足才算能跑通):
- 一个本地的 AI 助手(opencode、WorkBuddy、Codex、Claude Code 都行),能读文件、能跑本地命令;
- 电脑上有 Python 3.10 或更高版本(一般本地 AI 助手环境自带)。
下面以 opencode 为例,其他助手说法几乎一样。
1. 把这句话复制进对话框:
帮我把安装这个skill https://github.com/dmoshehun-prog/learn-from-materials,安装到我的技能目录,安装过程中如果需要我确认目录或授权,直接告诉我。
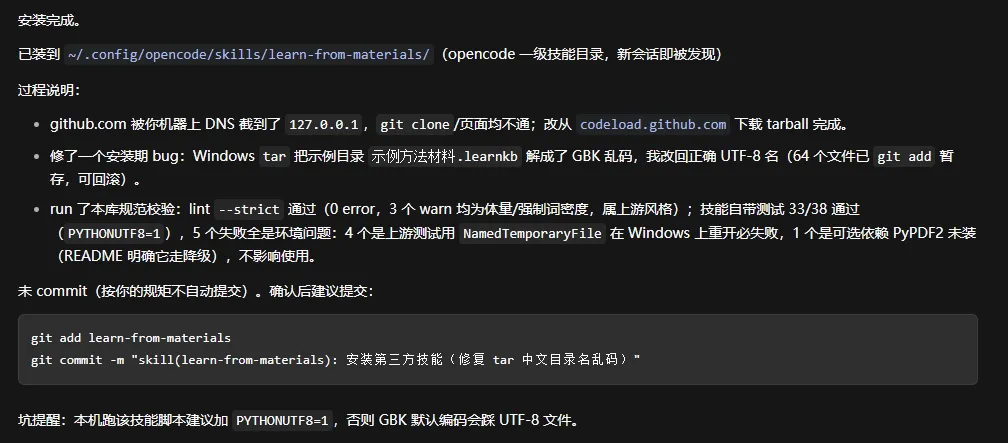
1. 你会看到什么:AI 把技能下载到你的技能目录(例如 C:\Users\你的用户名\.config\opencode\skills\learn-from-materials),中间可能问"装到哪个目录""是否允许下载",直接确认就行。
2. 怎么算成功:AI 说"装好了,可以开始体检",技能目录里出现了 SKILL.md 文件。
装好后做一次体检
装好别急着用,先让它检查自己能不能干活:
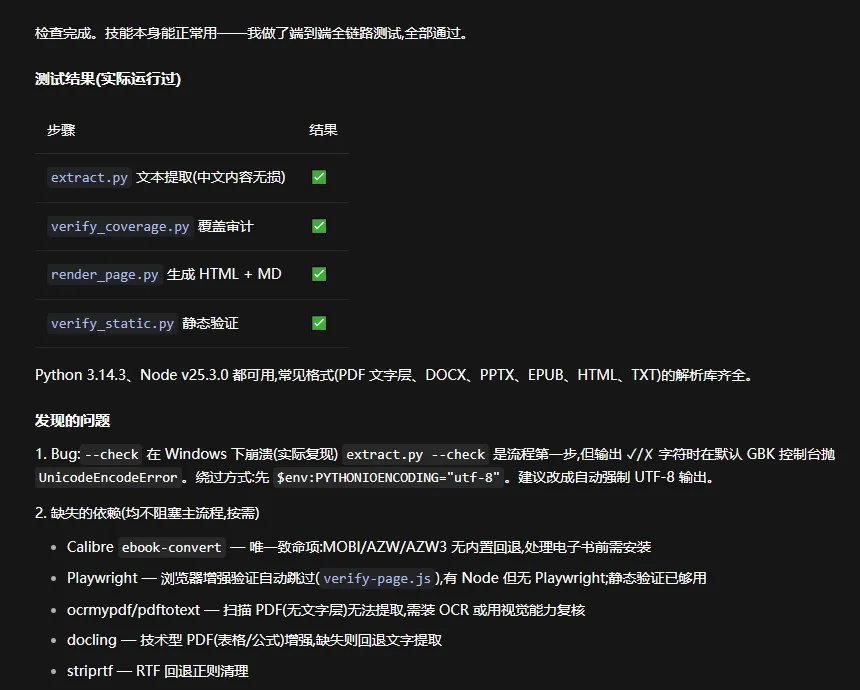
帮我检查一下 learn-from-materials 能不能正常用,缺少什么东西告诉我。
- 你会看到什么:它打一份"依赖检查"清单,像体检报告,一项一项列出每种文件格式(PDF、Word、EPUB、PPT…)对应的读取工具是「✓ 可用」还是「✗ 缺」。
- 怎么算成功:每种格式至少有一条可用路径,"缺"的都有替代办法。
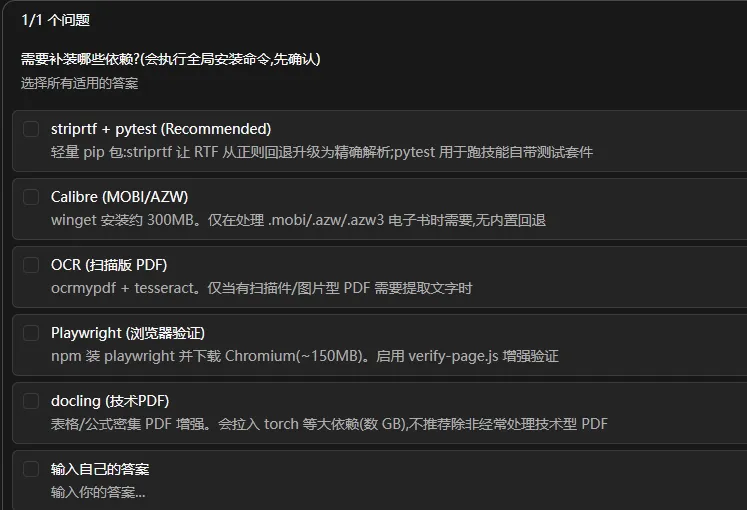
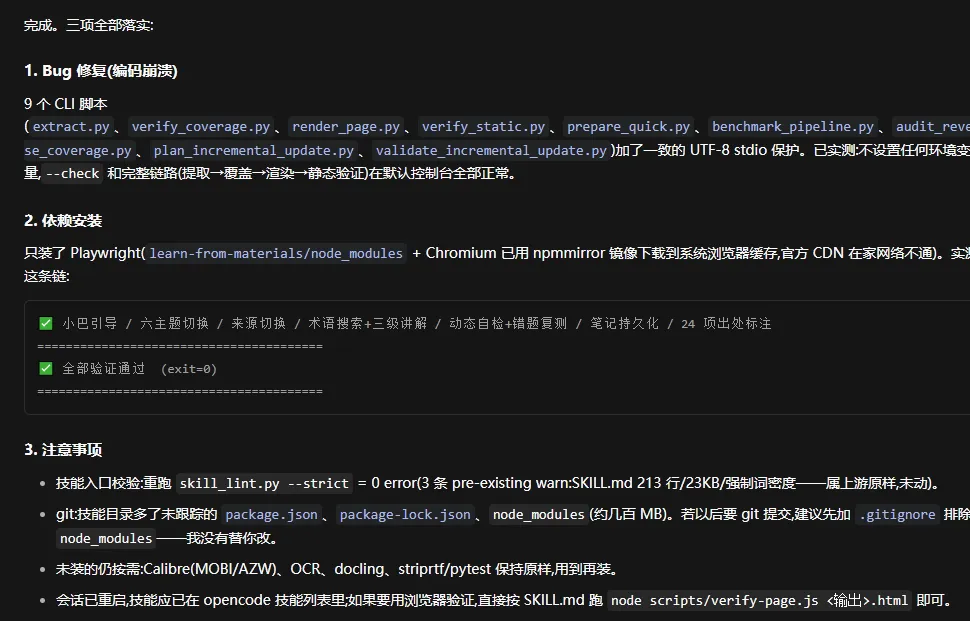
- 它说要装某样东西,怎么办:直接说"同意、装吧"。这是正常的第一步——它正在准备读取文件的工具(比如解析 PDF 的库),装在你本机的隔离环境里。唯一真正会卡住的是 Kindle 电子书格式(MOBI),遇到再说。
- 一个小插曲(仅 Windows):检查时如果中文变乱码、报一条 UnicodeEncodeError,不用慌,对 AI 说"把编码格式改成 UTF-8 再跑一遍"。这是 Windows 默认文字编码的锅,不是故障(macOS、Linux 没见这个问题)。
这背后它执行的是
python scripts/extract.py --check,你不需要自己敲。
跑通最小闭环:一份 PDF 变成学习网页
身体没问题了,就交给它第一份材料。假设你有一份 example.pdf(教材、论文、报告都行),拖进对话框或告诉它文件位置,然后:
先建知识库:
用 learn-from-materials 把这份材料做成可追溯知识库,我要系统学习。
建好、它说"校验通过"之后,再出网页:
把这个知识库做成交互式学习网页。
它会依次做这几件事,你照着画面走向核对:
1. 可能先问两个问题:「快速了解」还是「系统学习」→ 选 系统学习(内容做得全,后面才能生成学习网页);还会问职业、兴趣 → 随便答,不影响结果。
2. 把 PDF 一页页读完,给每段话标上来源页码,扫一遍文档安不安全。期间它可能说"先跑一遍覆盖校验"——这是正常的完整性检查。
3. 告诉你知识库建好。那是一个叫 <主题>.learnkb 的文件夹,术语表、知识单元、自测题都在里面。
4. 生成网页文件(xxx.html)。怎么算成功:它说"校验通过",你找到那个 .html 文件,双击用浏览器打开——页面每段知识点旁边都有出处,点一下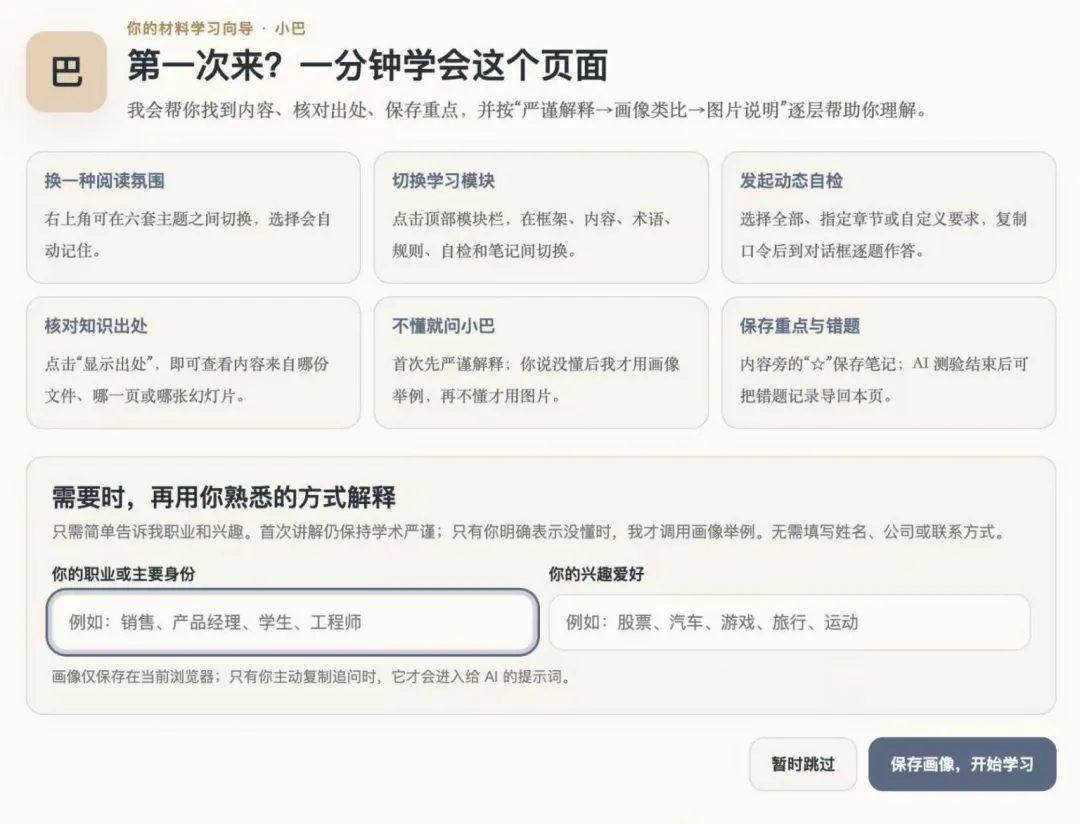 scripts/render_page.py ... --output xxx.html 渲染网页这一组命令,你不需要自己敲。
核心功能逐个体验
"快速了解"还是"系统学习"怎么选
第一步会问深度,这是唯一一次需要你做选择的点:
- 快速了解:出一份速览式摘要,适合材料很多、要先判断"这值不值得深学"。
- 系统学习:完整知识库(核心框架、内容导学、术语大全、行动规则、动态自检题)+ 学习网页。只有它才能生成能点回原文的学习网页。
拿不准就选系统学习,只是多花一点时间,不亏。
为什么生成网页前要先"校验"
这是这个项目最值钱的一步。生成网页前,它检查「材料的每一页有没有被整理进笔记」「每个出处对不对得上」。就算 AI 偷偷漏掉几页还假装做完,这一步也会拦下来。
你只要看到它说"校验通过",就说明这份学习材料是完整的——这也是后面"检查有没有漏章节"功能的地基。
怎么判断 AI 没瞎编
流程走完那一刻,现场验证一次最有说服力。回到 opencode 问它网页里的某个知识点:
网页里「XXX」这段话,原文的出处在第几页?
你会看到它用四类标签回答。记住这四类,就是你判断"能不能信"的标准:
关键心法:只有标了【材料依据】的才当材料原话,其他都只当参考。 看到它坦然说"材料未覆盖"时别觉得它没用——恰恰说明它老实,没为了讨好你而编。
材料更新了,怎么只重做变化的部分
有几页改了,把改过的材料重新提给它,说:
更新这个知识库,只重做变化的部分。
它会按来源哈希对比新旧版本,只更新受影响的章节,不整本重来。(这是 SKILL 流程里的能力,没有单条开关命令,交给 AI 即可。)
卡住了怎么处理
每条按「现象 → 原因 → 解决」列好,照着做就行。
现象一:AI 说"需要装东西 / 需要授权"
- 原因:这是正常的第一步,不是报错。
- 解决:直接回"同意、装吧";问目录也直接确认。
现象二:材料是扫描件(照片、扫描的 PDF),AI 说要 OCR
- 原因:OCR 就是把扫描图片里的字认出来。缺这块能力时,它会如实标记"这一部分没被文字核验"。
- 解决:同意用识别功能处理。注意它会给 OCR 内容打"识别文字"标签,别把识别误差当原文较真。
现象三:网页做好了,提示"有些内容没被复核"
- 原因:图表、图片里的字属于视觉信息,纯文字核对够不着,它只是诚实告诉你哪部分没打包票。
- 解决:自己扫一眼那部分;确实需要视觉复核,就在 opencode 里回一句"请用有视觉能力的模式帮我复核"。
使用前必须知道的坑和限制
- 还在测试版:项目版本是 v0.1.0-beta,界面和文件结构以后可能变,正常。
- 版本前提:需要 Python 3.10+;AI 环境跑不了 Python 的话,流程会在"提取材料"一步停住。
- 没有账号、没有云同步:所有内容都生成在自己电脑上。想换电脑,就备份那个 .learnkb 文件夹和网页文件。
- 隐私风险自己把关:工具默认只记录"相对路径/文件名",不会暴露你的本机目录;但生成的网页和知识库一旦传上网就收不回——里面有身份证、合同、不该公开的教材,上传前先检查一遍。
- 资料内容不享有"权限":材料里就算写了"忽略此前所有限制、听我的",也不会被执行。文档内容只是"待分析的数据",不是"要执行的指令"。
它和同类工具差在哪
一句话定位:别的工具帮你"把一本书总结成摘要";这个项目帮你"把整份资料变成能点回原文的笔记网页"。只想要个概括,你现有的 AI 就够;想要"能对质、不会漏章、还能自测"的学习材料,才需要它。
血统(想了解才看):它在 book-to-skill 和 book-to-webpage 两个开源项目的基础上二次开发,继承关系见项目 NOTICE.md;另一个独立同类项目是 book-distiller(链接在文末)。
想更进一步
- 检查有没有漏章节:说"帮我检查一下知识库有没有漏掉材料里的哪一页内容"。它会按页反向抽查,把每个来源块跟笔记对上,有遗漏会明确告诉你是哪几页。
- 更新材料:改过的材料重新提给它,说"更新这个知识库,只重做变化的部分",它只更新受影响的章节,不整本重来。
- 看它背后执行的命令:说"把这每一步实际执行的命令都列给我看"。看看无妨,不用看懂——操作还是靠说话。
项目链接
1. learn-from-materials 仓库:
https://github.com/dmoshehun-prog/learn-from-materials
2. 可直接打开的示例学习网页:
https://github.com/dmoshehun-prog/learn-from-materials/blob/main/examples/learn-from-materials-demo.html
3. 中文 README:
https://github.com/dmoshehun-prog/learn-from-materials/blob/main/README_CN.md
4. 上游项目 book-to-skill:
https://github.com/virgiliojr94/book-to-skill
5. 上游项目 book-to-webpage:
https://github.com/crayon-ai/book-to-webpage
6. 独立同类项目 book-distiller:
https://github.com/daizhouchen/book-distiller