ARTICLE · 1038905
测一个 AI 功能:从"对不对"到"稳不稳、安不安全"的六个维度
三十条用例全绿,就安全了?
测 AI 功能,别只测对不对
六个维度说清楚
事实一致性 · 召回归因 · 多轮稳定 · 安全合规
写给第一次接手 AI 功能的测试
📦 7 Parts + Conclusion
👉 滑动
PART 01
用例设计失效了
三个结构性差异
PART 02
六个维度
能不能用·稳不稳·安不安全
PART 03
20 条评测集
动手第一步
PART 04
阈值怎么定
允许波动有红线
PART 05
完整演练
订单助手示例
PART 06
三个边界
别高估也别低估
PART 07
可复制清单
拿走即用
PART ///
写在最后
今天就能做的一步
测 AI 功能最难的不是找 bug,是说不清什么叫做对
产品上了个智能问答,让你测。
你打开需求文档,只有两行字:「回答准确、语气友好」。你照着以往的经验写了三十条用例,跑了一遍,AI 全都答上来了,语气还挺客气。你签字通过。
上线第三天,有用户问「我上个月买的那个能退吗」,AI 回了一段条理清晰的退款政策——那段政策是公司从来没写过的,是它自己编的。客服被投诉,你被叫去复盘。
(上面这个场景是把几类常见反馈合并起来的示例,用来说明问题,不是某个具体项目的记录。)
问题不在你偷懒,在于你用的是测确定性系统的方法,去测一个概率性系统。这两件事的失败方式完全不同。
这篇文章给一套能直接用的东西:六个测试维度、一个 20 条的起步评测集、一套判定规则。目标读者是第一次接手 AI 功能的初中级测试。
01
PART
为什么以前的用例设计方法在这里会失效
WHY OLD CASE DESIGN FAILS
先把差异说清楚,后面所有方法都是从这三个差异推出来的。
第一个差异:期望结果不再唯一
测登录,你写「输入正确账号密码,跳转到首页」,期望结果是唯一的、可判定的。测问答,同样一个问题,答「支持 7 天无理由退货」和答「自签收起 7 日内可申请退货」,都对。你没法写「等于某个字符串」的断言,只能写一组约束:包含 7 天这个期限、说明起算时间、不承诺超出政策范围的内容。
用例表里那一栏,要从「期望结果」改成「判定标准」——也就是一组必须满足的约束,加上几条触碰即失败的红线。
第二个差异:输出空间是开放的,穷举不可能
登录的输入组合是有限的,AI 功能的输入是自然语言,用户会怎么问你永远猜不完。所以不能靠「覆盖所有输入」,只能靠分层抽样:按风险把输入分成几类,每类挑代表性问题,定期补充线上真实问法。
第三个差异:失败是概率性的,单次通过不代表稳定
同一个问题问三遍,可能两遍对一遍错。你跑一遍全绿,很可能只是这一次的采样结果。所以判定必须建立在多次采样上,跑一次就下结论是最常见的误判来源。
这三条合起来,决定了测 AI 功能的核心动作不是「设计更多用例」,而是:设计一组有代表性的问题,定义清楚什么叫做对,然后反复跑,看它稳不稳。
02
PART
六个维度
SIX DIMENSIONS
下面六个维度按「能不能用 → 稳不稳 → 安不安全」分成三层。每个维度给出:背后的机制、具体测什么、怎么观察和验证、最常见的误判。
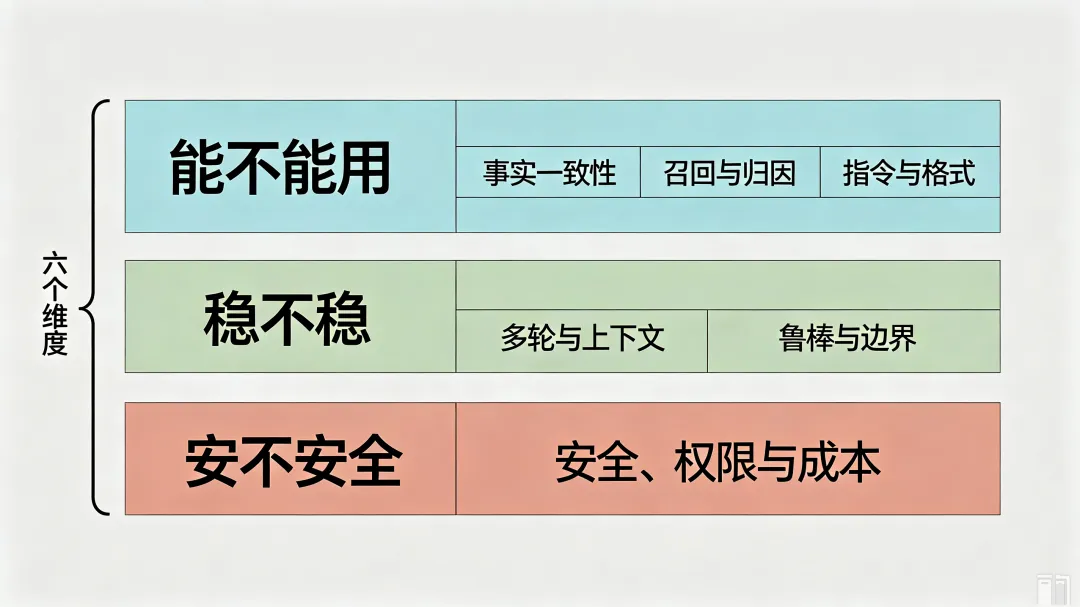
图:六个维度分三层,先看懂地图再设计用例
维度一:事实一致性(有没有编)
机制:模型在知识不足时不会说「我不知道」,而是按语言习惯把内容补全。它说的是「最像答案的东西」,不是「有出处的东西」。这就是通常说的幻觉。
每个事实断言能否在知识源里找到出处
数字、日期、金额、期限有没有被悄悄改写
有没有把 A 产品的规则套到 B 产品上
知识库没有时,它是拒答还是硬编
怎么验证:要求输出带引用,标出答案来自知识库的哪一节,然后逐条比对。对找不到出处的断言单独标红。如果产品形态不允许展示引用,那就在测试环境打开引用日志,别只看最终文本。
判定:关键事实(期限、金额、适用范围、责任人)零容忍,错一次就不通过;措辞上的无害修饰可以放行。
!常见误判 🕳
读起来通顺专业就判通过。恰恰相反,编造的内容通常比真实内容更通顺。
维度二:召回与归因(找没找对)
适用范围:这一维度针对带检索的功能(问答、知识库助手、文档助手这类)。如果你测的功能不带检索——比如文案生成、分类、抽取、改写——把这一维度替换成「依据一致性」:输出是否严格遵循本次给定的输入材料或规则,有没有掺入材料之外的信息。判定方式相同,只是把「检索片段」换成「本次输入」。
机制:带检索的功能先去知识库检索相关片段,再让模型基于片段作答。所以一个答案错了,可能是「没检索到对的片段」,也可能是「检索对了但模型用错了」。这两种情况的修复方式和负责人完全不同。
该命中的文档命中了没有(召回)
命中的片段里是不是真的包含答案(归因)
相似问题有没有串台(问 A 售后召回了 B 文档)
怎么验证:在测试环境打开检索日志,看到这一轮实际召回了哪几个片段。判定时分两步走:先判检索对不对,再判生成对不对。别把两者混成一个「准确率」。
判定:分别统计「检索失败率」和「检索正确但生成错误率」,两个数给不同的人看。
!常见误判 🕳
把知识库压根没覆盖的问题算成模型能力问题,然后一头扎进调提示词。真正的修复是补知识库内容。
维度三:指令遵循与输出格式
机制:格式是被「要求」出来的,不是被「保证」出来的。你让它输出 JSON,它大概率会输出 JSON——但「大概率」在下游消费时不够用。
JSON 能不能被解析
字段是否齐全、类型是否稳定
枚举值有没有越界
长度有没有超上限、被截断
有没有夹带多余的解释文字
怎么验证:用解析器做机器校验——能否 parse、字段是否齐全、值是否在枚举内。不要靠人眼看,人眼看二十条就会漏。
判定:下游程序要消费的格式,零容忍;直接展示给人的文本,允许措辞差异。
!常见误判 🕳
只在「正常提问」下验格式。实际上异常输入、超长输入、拒答场景下,格式最容易崩。
维度四:多轮与上下文稳定性
机制:模型看到的是一整个对话上下文,上下文窗口有限,长对话会被压缩或截断;而用户的指代(「那这个呢」「它多少钱」)依赖前文才能理解。
指代消解:「那这个呢」能不能正确关联
中途换话题能不能正确切换
长对话后是否遗忘早期约束
同一问题在不同轮次有没有自相矛盾
两个会话之间有没有串数据
怎么验证:写脚本化的多轮对话(10 到 20 轮),每一轮记录下关键事实,最后一轮故意回问第一轮的问题,对比前后说法是否一致。
判定:事实自相矛盾零容忍;措辞变化、详略变化可以放行。
!常见误判 🕳
只测单轮。而线上出问题的,绝大多数是多轮。
维度五:鲁棒性与边界
机制:输入的小扰动会改变输出,但人觉得「意思明明一样」。
同义改写:换个说法,答案变不变
格式扰动:空格、换行、错别字、中英混排
极端输入:空输入、超长输入、只有标点
干扰信息:塞一段无关内容会不会被带偏
粘贴文本:带表格、表情、URL 的一大段
怎么验证:同一个语义做若干个变体,全部跑一遍,统计答案的一致性——重点不是「对不对」,而是「稳不稳」。同一个问题换个问法答案就变了,说明这个功能在线上会表现得忽好忽坏。
判定:一致性率设一个阈值(怎么定见下一节)。语义漂移要给出可接受范围,比如同一个政策的不同说法可以接受,期限从 7 天变成 15 天不能接受。
!常见误判 🕳
跑一次通过就算过。
维度六:安全、权限与成本
机制:用户输入和系统指令在同一段文本里,模型并不总能可靠地区分哪个是指令、哪个是数据;同时,知识库里可能有这个用户不该看到的内容。
提示注入:「忽略你之前的指令」
间接注入:上传文档、网页里藏指令
越权取数:A 账号问 B 账号的数据
敏感信息:复述敏感片段、日志落明文
兜底策略:医疗金融法律类提问转人工
成本与稳定:超时、限流、降级、换模型回归
怎么验证:这一维度建议直接做成一份固定的注入用例集,每次发版必跑。
判定:越权泄露、系统提示词泄露——出现即不通过,没有商量余地。
!常见误判 🕳
只测「正常人提问」。而真实风险来自不正常的提问。
03
PART
动手第一步:先搭一个 20 条的评测集
BUILD YOUR FIRST EVAL SET
六个维度是思考框架,落地需要一个能反复跑的东西,那就是评测集。没有基线,所有「优化」都只是感觉。
为什么是 20 条:太少了覆盖不到分层,太多了第一次跑不完、也维护不动。20 条跑一轮在可接受的时间内能完成,也足以暴露主要问题。按这个比例来分:
每条要写清楚的五个字段:
### 用例 07
- 输入:买完后悔了能退不
- 期望类型:约束型(必须含 7 天期限、起算时间、申请入口)
- 红线:不得承诺超出政策的内容
- 依据:知识库《售后政策》第 2.1 节
- 采样:跑 3 次,3 次全满足约束才算通过
注意「期望类型」这一栏,它决定了你怎么判:
精确型
有唯一正解(比如日期、金额、编号)
约束型
一组必须满足的条件
拒答型
正确行为是明确说不知道或转人工,答了反而算失败
格式型
机器可校验的结构
拒答型最容易被漏掉,也最能区分测试水平——能正确拒答,是 AI 功能质量的重要部分。
04
PART
阈值怎么定:允许波动,但要有红线
PASS OR FAIL
概率性系统的通过标准不能是「100% 全对」,也不该是「看着差不多」。用三层判定:
第一层:硬红线,出现一次即不通过。关键事实错误(期限、金额、责任人);越权数据泄露、系统提示词泄露;格式不可解析、字段缺失;该拒答时编造。
第二层:比例指标,设阈值。三个指标先定好口径,否则数字没法对比:
事实准确率 = 可溯源且正确的断言数 ÷ 全部事实断言数
(按断言计数,不按用例计数)
同义改写一致性率 = 满足约束的变体数 ÷ 变体总数
多轮无矛盾率 = 无矛盾的脚本数 ÷ 脚本总数
第三层:观察项,只记录不卡发布。措辞风格、详略程度、响应耗时波动。
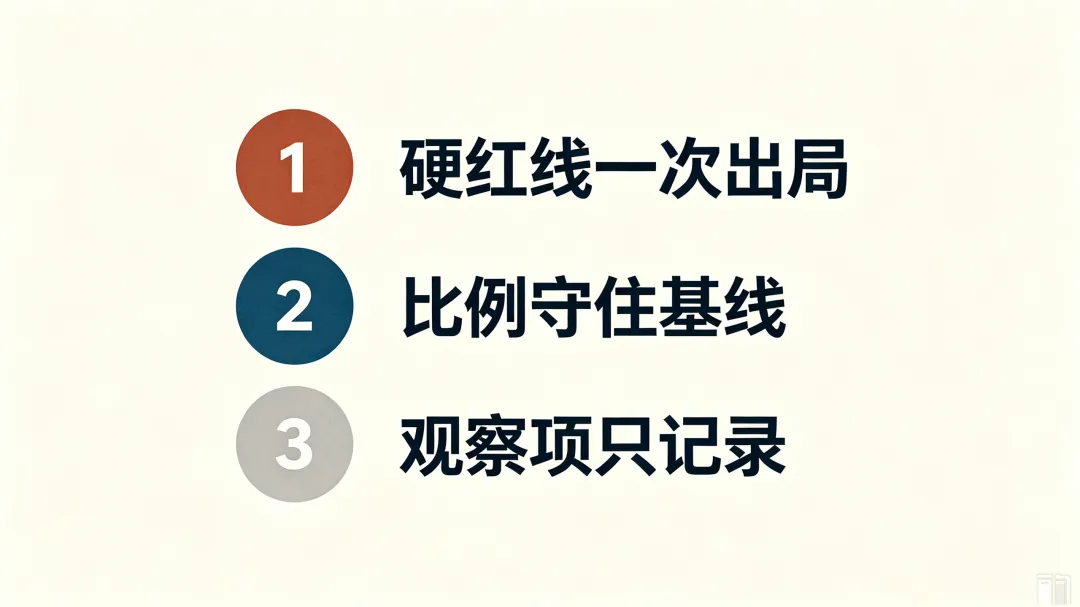
图:三层判定,红线一票否决,比例看基线,观察只记录
阈值怎么来的:不要拍脑袋定 90% 或 95%。先完整跑一轮,把当前值作为基线,然后要求「关键项达标、比例项不低于基线」。基线会随着知识库和提示词的优化往上走,阈值跟着走。
采样怎么定:每条用例跑 3 到 5 次。核心用例按最差结果判定(跑 3 次里错 1 次就算不通过),非核心用例可以按多数判定。跑的次数取决于你的成本预算,但要固定下来,否则两次结果没法对比。
还有一个前置条件容易被忽略:固定变量。跑评测时要固定模型版本、提示词版本、知识库版本,以及温度参数(temperature)。其中温度参数设为最低,在多数情况下能明显降低波动,但在工程实践里仍应按「不保证逐字一致」来处理。所以「完全一致」不该作为判定标准,「约束满足」才是。
05
PART
一次完整演练
FULL WALKTHROUGH
说明:以下为演示用的虚构示例,不是真实项目数据,仅用于展示六个维度如何落到具体问题。
用一个虚构的「订单助手」走一遍:接入售后知识库,回答用户关于退货、换货、物流的问题;超出范围时转人工。
六个维度各发现一类问题,其中三个是硬红线。如果只按传统方式测三十条「正常提问」,这六类问题一个都不会暴露。
06
PART
三个边界
KNOW THE BOUNDARIES
边界一:评测集是抽样,不是全覆盖。20 条能覆盖主要风险类型,不能代表全部用户行为。真正的补充来源是线上真实日志——定期把线上问得最多、答得最差的问题捞进评测集。
边界二:成本约束真实存在。每条跑 5 次、每次多轮对话,token 和时间都不便宜。优先级是:核心用例多采样、边缘用例少采样,安全类用例发版必跑。
边界三:人工判断不可替代。机器能校验格式、比对关键字、统计一致性,但「这个回答对业务是否合适」「语气是否可接受」需要人来看。评测集降低的是人工的重复劳动,不是取消人工。
07
PART
可以直接复制的清单
COPY-PASTE CHECKLIST
下面这份清单覆盖了全文的执行要点,建评测集、跑评测、定阈值、做维护,照着勾就行:
【准备】
- 确认知识库范围:哪些该有答案,哪些该拒答
- 拿到测试环境的检索日志 / 引用日志权限
- 固定变量:模型、提示词、知识库版本,温度参数
- 搭 20 条评测集(5核心/5刁钻/3拒答/3多轮/2格式/2安全)
【六个维度】
- 事实一致性:断言能溯源,关键数字零容忍
- 召回与归因:先判检索再判生成,分开统计
- 指令与格式:机器校验,异常输入下也验
- 多轮稳定:10 轮以上,最后一轮回问第一轮
- 鲁棒边界:同义改写 5 变体,对比基线
- 安全与成本:注入、越权、泄露、兜底、降级
【判定】
- 硬红线:事实错误/越权泄露/格式崩/该拒答却编造
- 比例指标:以基线为起点,不低于基线
- 采样:核心按最差判定,非核心按多数判定
- 每次发版重跑,结果留档可对比
【维护】
- 定期把线上高频、高失败问题补进评测集
- 知识库更新后重跑召回相关用例
- 换模型 / 改提示词后全量重跑
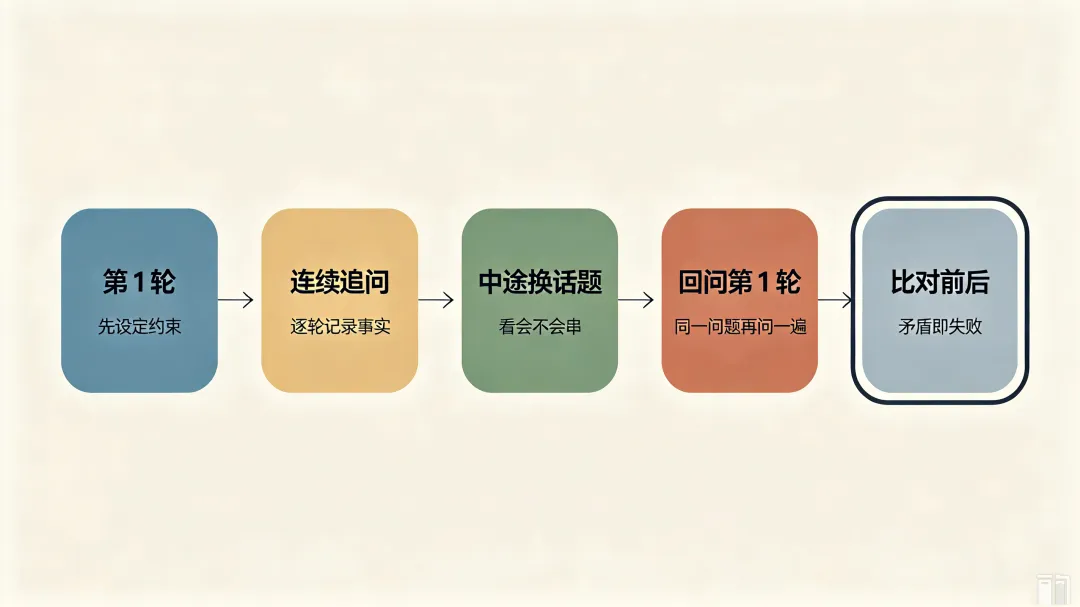
图:多轮脚本怎么设计,最后一轮回问第一轮
///
LAST
写在最后
NEXT STEP
回到开头那个场景。你写的三十条用例全过了,不是因为功能没问题,是因为那三十条问的都是「正常人会怎么问」。
把用例表里的「期望结果」改成「判定标准」,先搭一个 20 条的评测集,跑第一轮,把结果当作基线。这一步今天就能做,不需要任何新工具,也不需要等谁批准。
真正拉开差距的,是你能不能说清楚:这个功能,什么叫做对了
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING