ARTICLE · 1044846
企业级文档管理:从 BM25 到元数据驱动
如何让标书信息提取真正产生商业价值
一、从一个真实需求说起
用户按部门上传文档 在项目管理系统中,把项目相关的招标文件、投标文件、技术协议、合同、发票、对账单、凭证等,按项目维度聚合展示 从招标文件中精准提取60+个关键指标,并支持点击跳转到原文位置看起来是"文档管理",实际上触及了一个更深层的问题:
二、BM25:优势、劣势与召回率提升
2.1 BM25 的本质
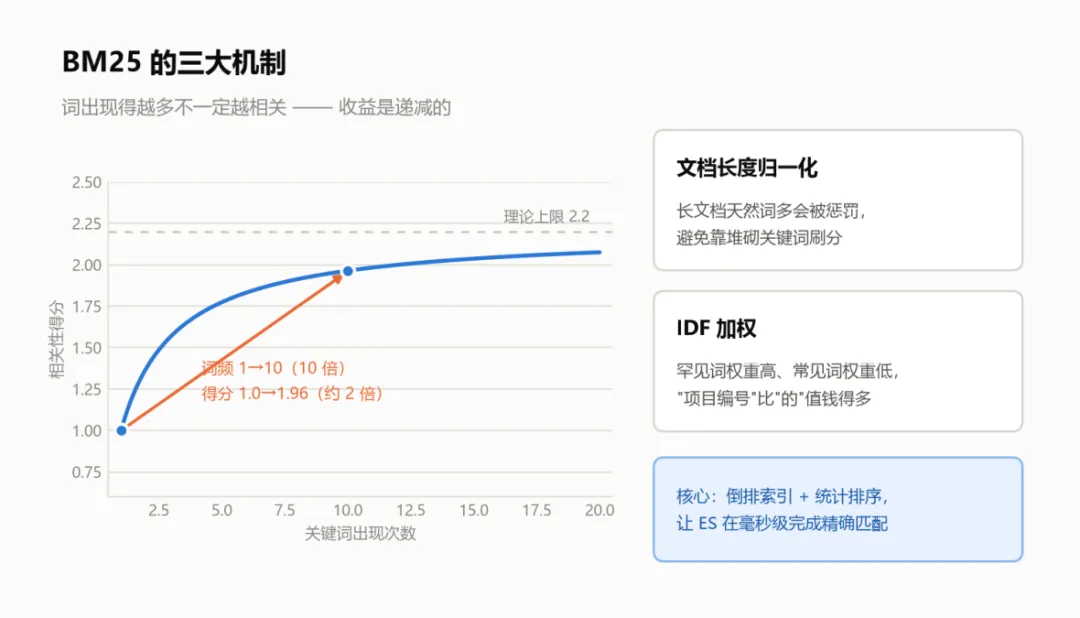
BM25(Best Matching 25)是一种基于词频统计的精确匹配排序算法,也是 Elasticsearch / Lucene 的默认相似度算法。
它的核心机制有三个:
2.2BM25的优势优势
优势 | 对你的价值 |
精准匹配强 | 标书中的这类专有名词几乎不会漏 |
零训练成本 | 上传文档即可建立索引,冷启动快 |
可解释性强 | 每个词的贡献可拆解,得分可追溯 |
毫秒级响应 | 倒排索引,适合大量文档实时检索 |
对短文本友好 | 标书切片、标题、字段值匹配效果好 |
2.3 BM25 的劣势劣势
劣势 | 对你的影响 |
词汇鸿沟 | 搜"交货时间",文档写"交付周期",直接漏召回 |
无法处理同义词 | "甲方" vs "采购人" vs "招标人"被当成三个词 |
对分词极度敏感 | "潼关储能"被切成"潼关/储能",搜全称匹配不上 |
无上下文理解 | "不接受联合体投标"和"接受联合体投标"几乎一样 |
无法处理拼写错误 | 少打一个字就召回失败 |
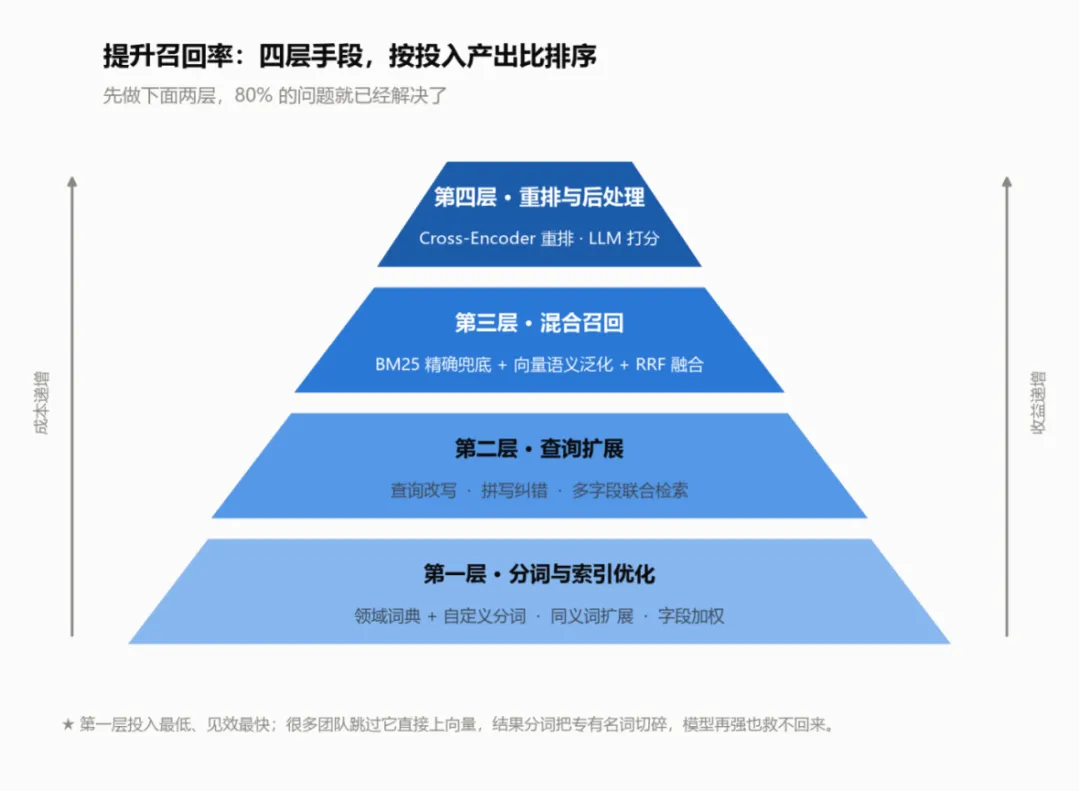
2.4 提升召回率的手段(按投入产出比排序)
2.5 一个关键认知
三、关键字元数据:
BM25 的"燃料"切片里的关键字元数据,和 BM25 关系非常紧密——它是 BM25 能有效工作的燃料。
· 直接使用:把切片内容直接喂给 BM25,它自动分词、计算词频
· 元数据增强:手动把关键实体提取成独立字段,查询时加权检索,匹配到关键字的文档得分更高但要注意:如果关键字与业务无关,不仅没用,还会严重拖后腿——引入噪音、稀释真正权重、拉低召回率。
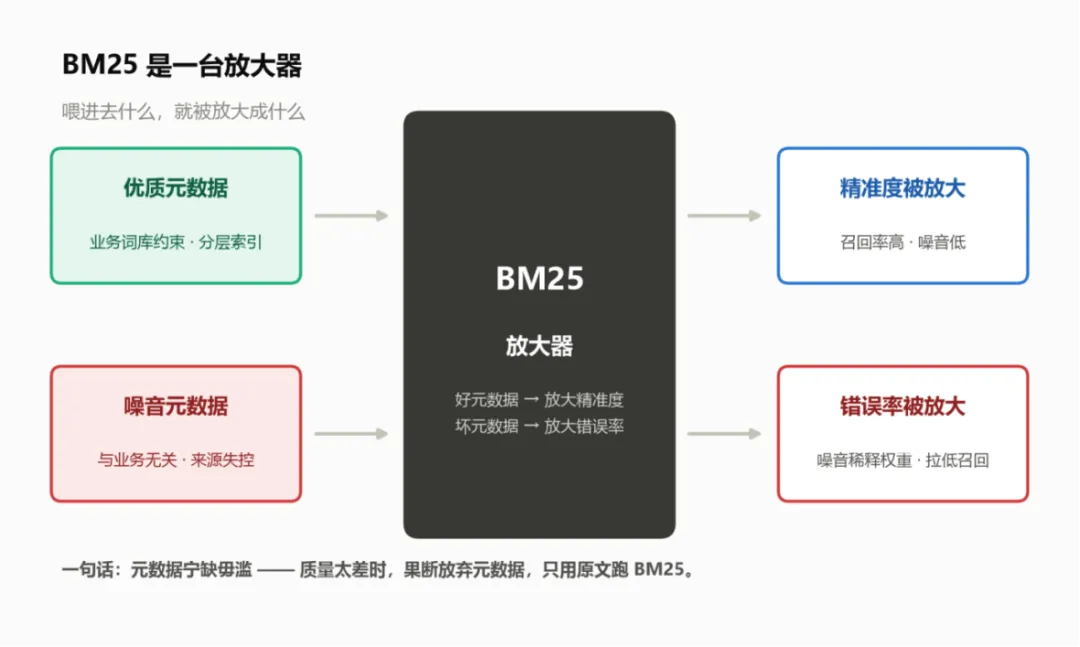
源头治理:用业务词库约束,只允许从"产品库""物料号表"里选词 分层索引:业务核心层高权重,通用描述层低权重 极端情况降级:如果元数据质量太差,果断放弃,只用原文跑 BM25
四、标书场景的特殊性:为什么通用方案不够用
标书关键信息提取,有几个独特挑战:
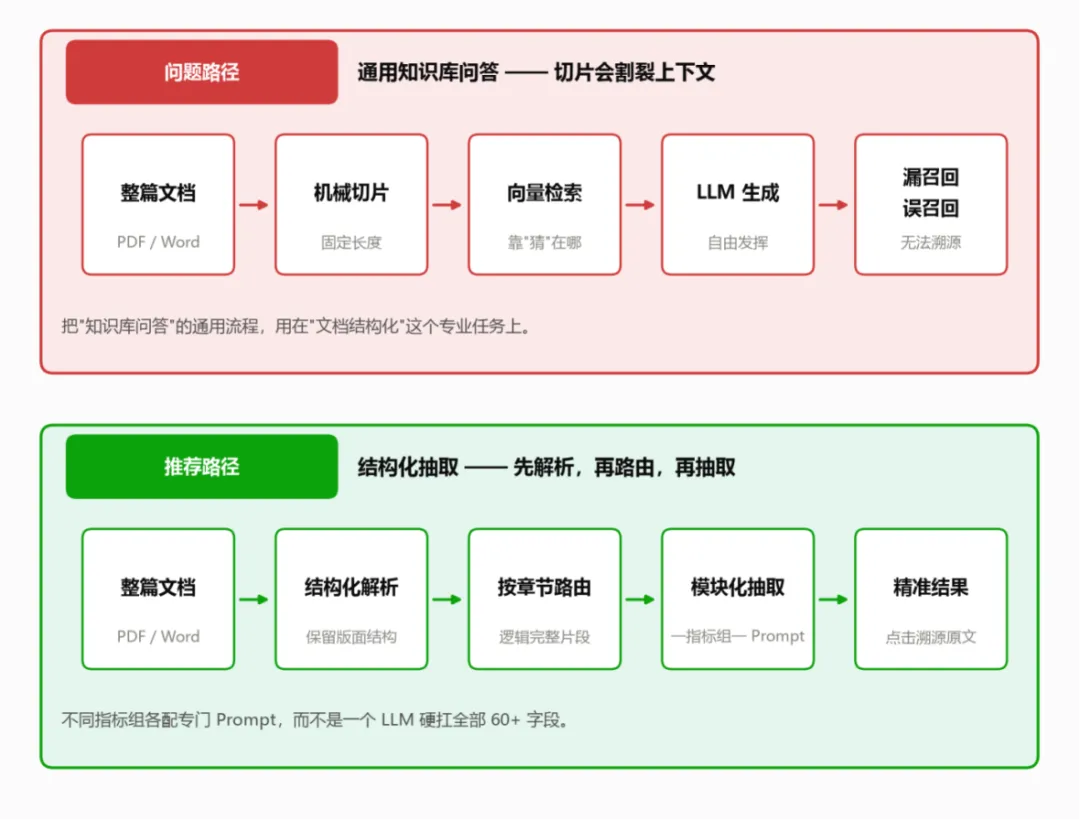
必须按原文提取:不能改写,不能概括 信息分散:同一个指标可能出现在文档各个位置,比如"废标项"分散在全文多处 需要溯源:提取结果要能点击跳转到原文位置 指标众多:60+ 个字段,涵盖基础信息、商务、技术、报价等多个维度 用 Dify 知识库循环抽取,为什么不准?
五、PageIndex vs Agentic Search:谁更适合标书提取?
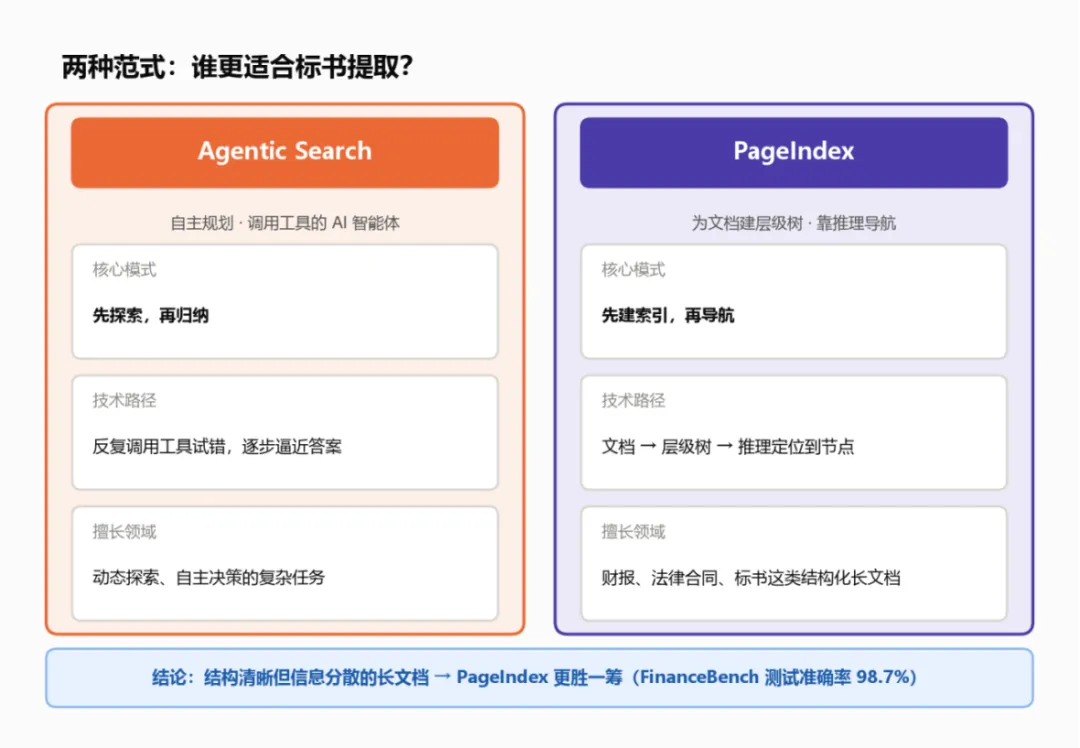
对比维度 | Agentic Search | PageIndex |
核心模式 | 自主规划、调用工具的AI 智能体 | 为文档构建层级树,AI 靠推理导航 |
技术路径 | 先探索,再归纳 | 先建索引,再导航 |
擅长领域 | 动态探索、自主决策的复杂任务 | 财报、法律合同、标书等结构化长文档 |
六、企业级文档管理系统的架构设计
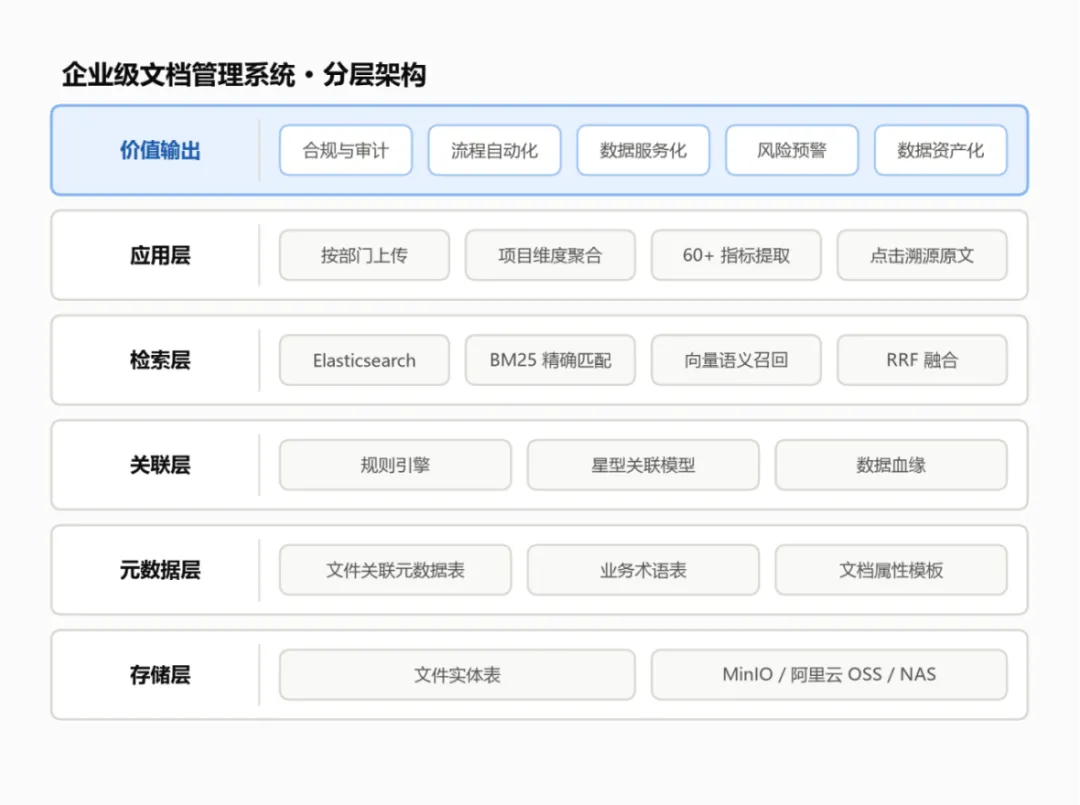
文件实体表:只负责存储文件的原始属性和物理位置 文件关联元数据表:建立文件与业务实体的多对多关系
6.2 元数据标签库:解决"叫法不一"的问题
层级 | 名称 | 作用 |
业务层 | 业务术语表 | 定义全公司统一的业务名词,如"客户 = 甲方 = 采购人 = 招标人" |
技术层 | 文档属性模板 | 为每类文档定义属性字段,如招标文件模板含项目名称、客户名称、开标日期等 |
6.3 规则引擎或者Ontology:建立数据血缘
不要只做"文档 A 关联文档 B"的简单链表,而是建立"以项目为核心的星型关联模型"。
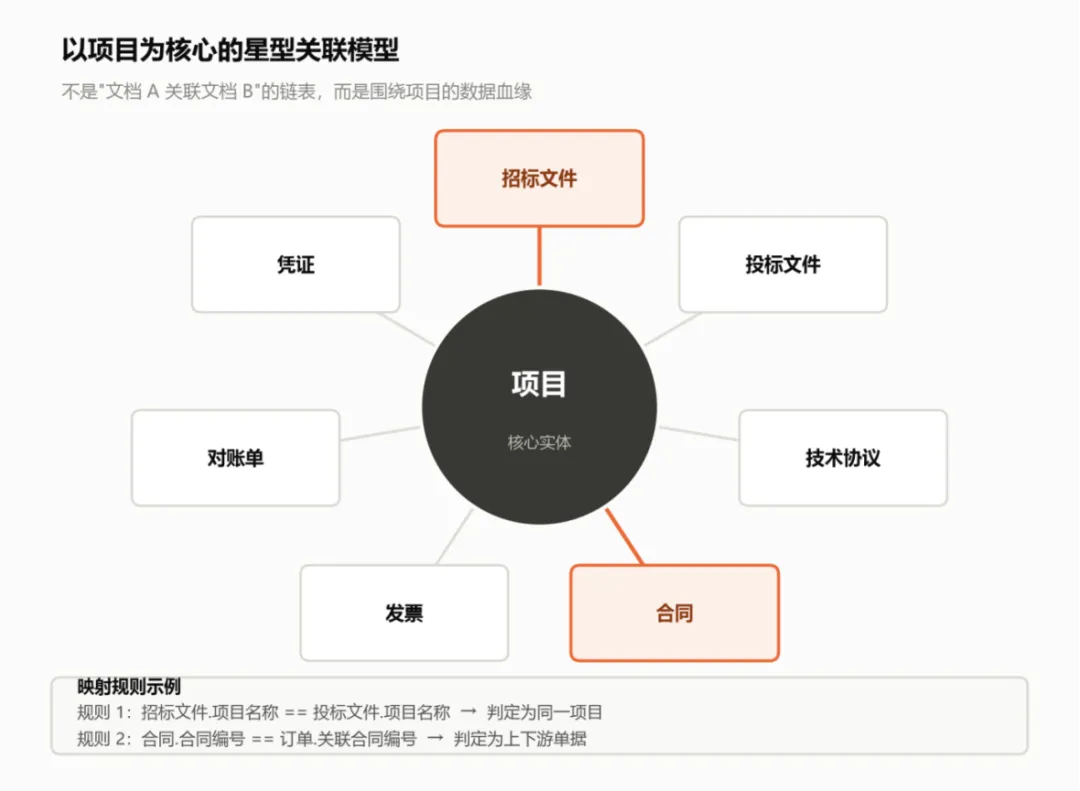
6.4 技术选型参考
七、商业价值:从"管文件"到"数据资产化"
如果只是为了"找文档方便、消除混乱",投入产出比确实不高。这套架构的真正价值,在于把数据从非结构化的文档形态,转化为结构化的数据资产。
7.1 五条商业价值路径
合规与审计价值:快速提供完整交易链路证据链,降低合规风险 流程自动化:财务对账自动比对,异常项目标红 数据服务化:实时输出结构化数据,支撑 BI 报表和业务决策 风险预警:规则引擎配置风控规则,如"合同金额 > 中标金额 15% 自动预警" 数据资产化:把结构化数据封装成数据产品,对外输出变现
7.2 数据资产等级模型
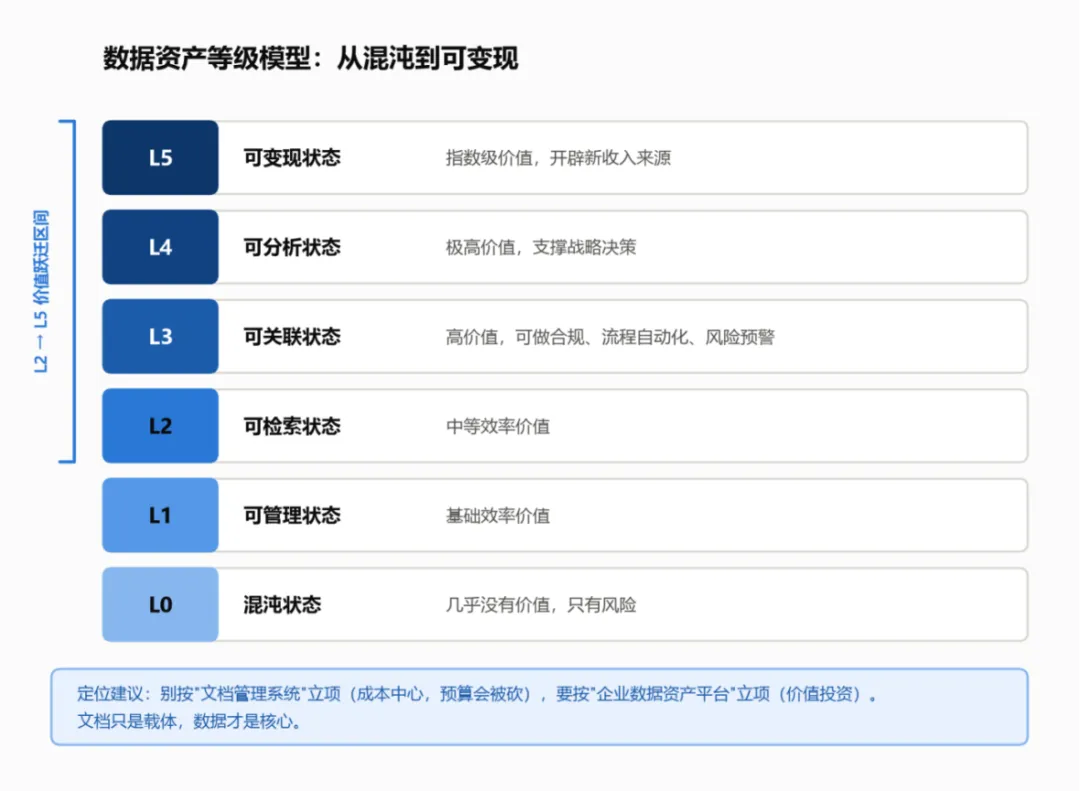
7.3 一个重要的定位建议
八、总结
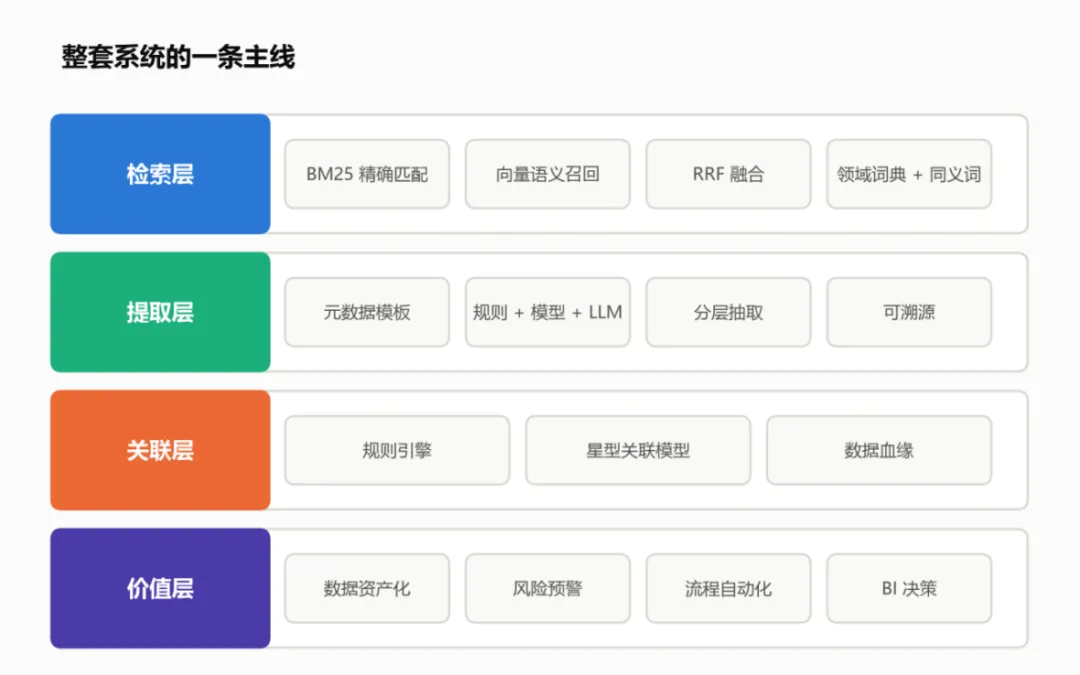
检索层:BM25 + 向量混合召回,配合领域词典、同义词、查询改写提升召回率 提取层:基于元数据模板,用规则 + 模型 + LLM 分层抽取,保证精准和可溯源 关联层:通过规则引擎建立以项目为核心的星型关联模型 价值层:从文档管理升级为数据资产管理,最终实现数据驱动决策和数据变现