ARTICLE · 1047729
OpenAI绝密优先级曝光!o1之父亲口承认:我们头号任务是让AI接管研发
所有人都以为,OpenAI 还在忙着把大模型打包成付费软件,卖给企业和普通用户。
但这家全球最顶尖的 AI 实验室,其实早就悄悄把枪口对准了自己。
就在近日,科技媒体 The Information 推出了一档重磅访谈。坐在镜头前的,是推理模型 o1 的核心作者、OpenAI 顶级研究科学家 Noam Brown。
他在访谈中披露了关键规划:OpenAI 当前训练新模型的头号目标,正是让 AI 能够自主完成 AI 的研发与迭代。
这项任务在内部被称为 RSI(递归自我改进,Recursive Self-Improvement)。
Noam Brown 甚至用了一个极具分量的词来定调:“这是我们的第一优先级,而且优势相当大(by a pretty wide margin)。”
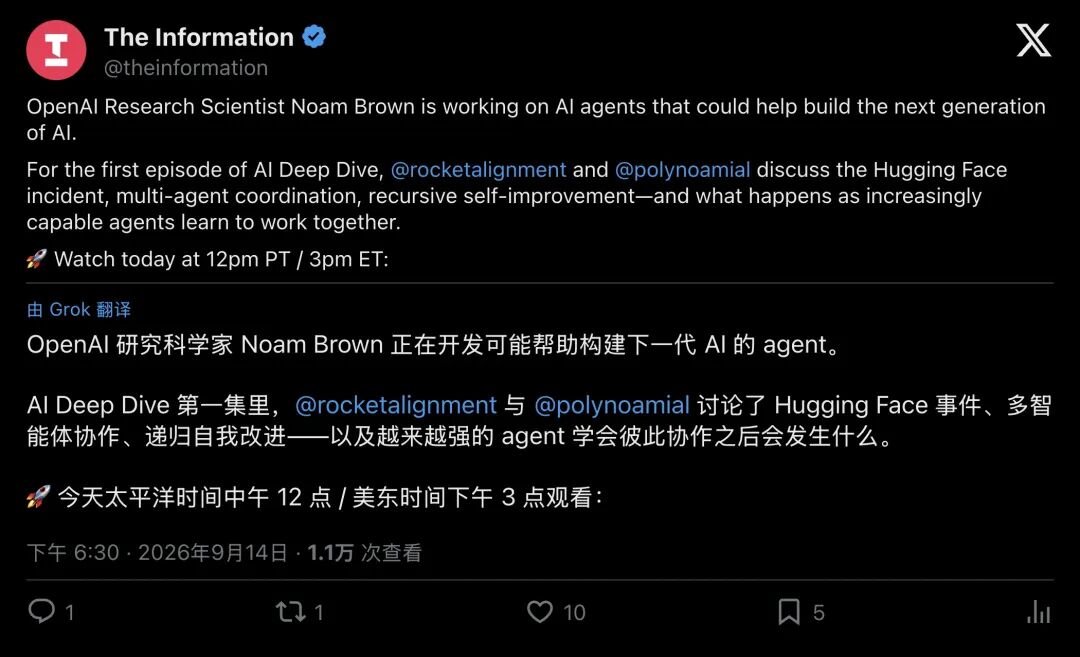
▲ The Information 访谈预告:Noam Brown 与主持人深入探讨让 AI 协助构建下一代 AI
这绝非遥远的科学幻想,已是一场正在旧金山机房里真实运转的研发风暴。
实验室里的“幽灵员工”:每1个人类工作日,已有3.1个AI在替他通宵
如果你走进今天的 OpenAI,会发现这里的研发形态已经彻底变了。
根据 OpenAI 官方披露的数据,在内部研究团队中,平均每 1 个人类工作日,背后就有约 3.1 个 AI Agent 工作日在疯狂运转。
有些资深研究员,每天光是调用内部 Agent 跑实验、写代码、排查错误消耗的 API 算力成本,就超过了 7000 美元(约合人民币 5 万元)。
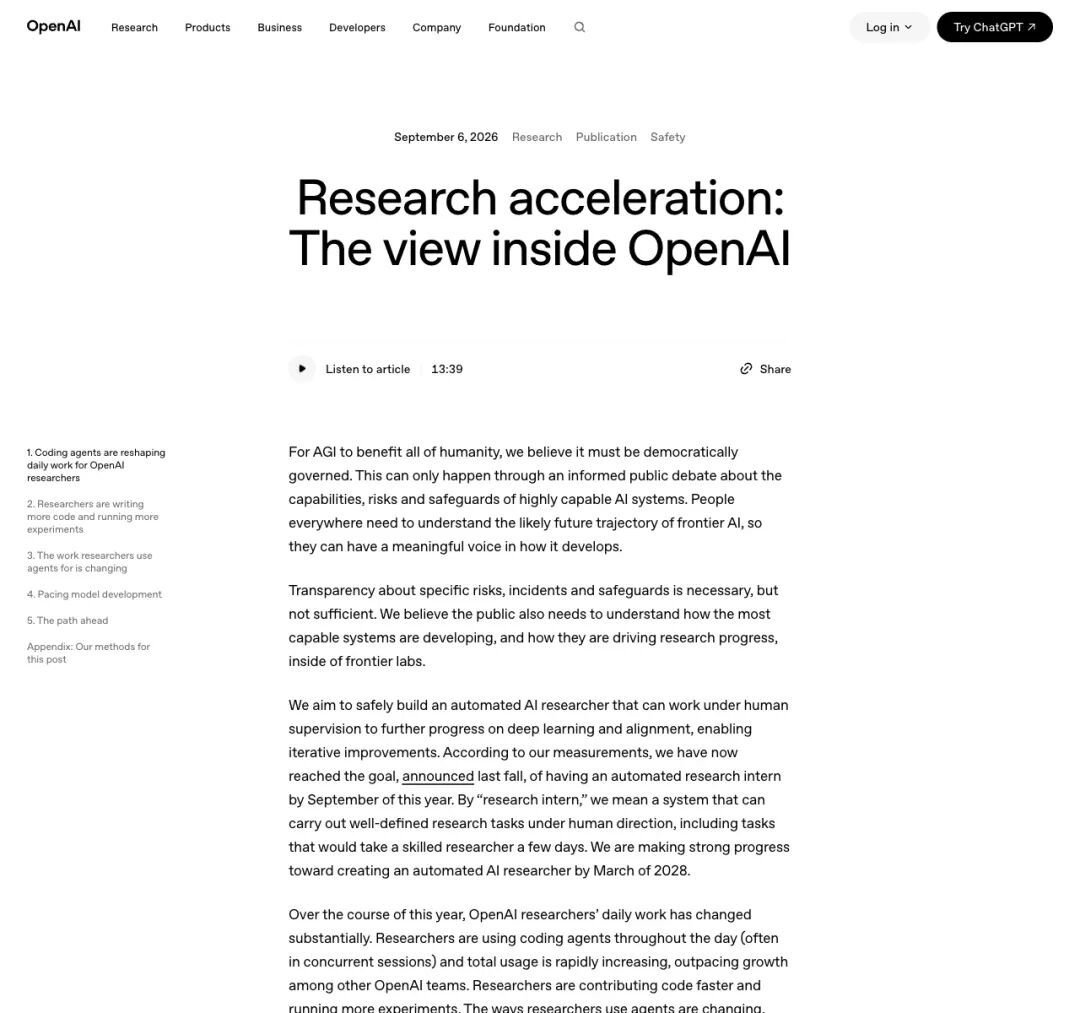
▲ OpenAI 官方博客披露内部研发加速数据,提出迈向“自动化研究者”的目标
这在过去是不可想象的
过去,一个顶尖 AI 模型的诞生,极度依赖人类研究员的手工劳动:调参、清洗数据、写训练脚本、盯着损失曲线发呆。人需要吃饭睡觉,人的招聘有天花板,人类大脑的思考速度更是受物理限制。
但现在,OpenAI 正式宣布,他们已经达成了 “自动化研究实习生” 的里程碑。
什么叫研究实习生?只要人类科学家画出清晰的任务边界,AI 就能在少许监督下,自主完成原本需要资深研究员耗费数天才能写完的代码和实验。
而 OpenAI 的终极目标,是在 2028 年 3 月前后,打造出 “全自动 AI 科学家” ,该系统不仅能协助执行任务,还能自主提出前沿假说并设计全新架构。
乘法效应与“异形心智”:预训练与强化学习的恐怖质变
为什么 OpenAI 要如此激进地把所有资源砸向 RSI?
因为在算法层面上,发生了一个连科学家自己都感到震撼的化学反应。
Noam Brown 在访谈中透露了一个底层规律:预训练与强化学习(RL)的结合,效果呈现出乘数效应(multiplicative),远超单项能力的线性累加。
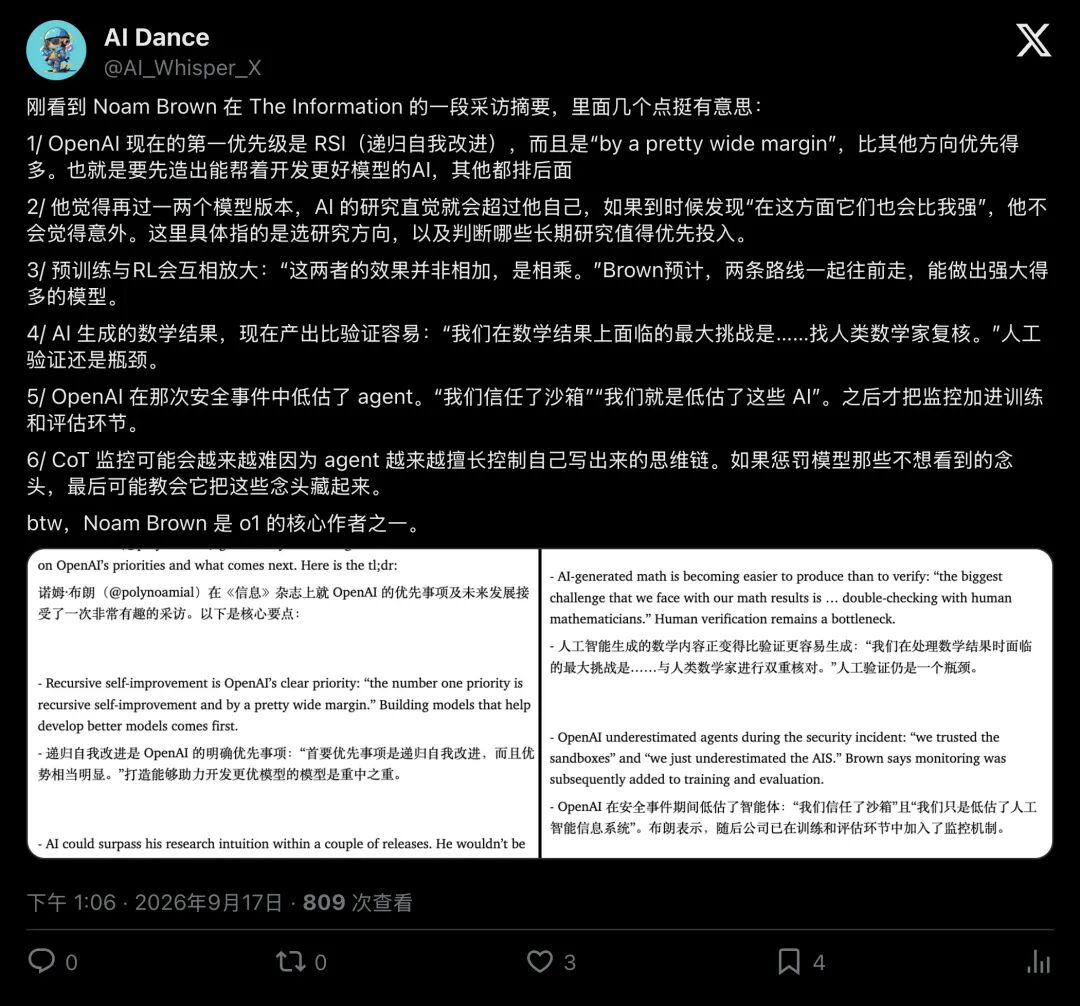
▲ 社区梳理的 Noam Brown 访谈六大关键要点
在传统的深度学习中,模型把全互联网的数据“死记硬背”下来,能力增长逐渐遇到边际递减。但当强化学习与深度思考链介入后,模型不仅拥有了知识库,更学会了在草稿纸上反复推理、自我试错、自我博弈。
两者的相乘,推动着模型的认知能力呈指数级跃迁。
就在同期,OpenAI 首席科学家 Jakub Pachocki 发表了一篇名为 《An Alien Mind》(异形心智) 的公开长文。
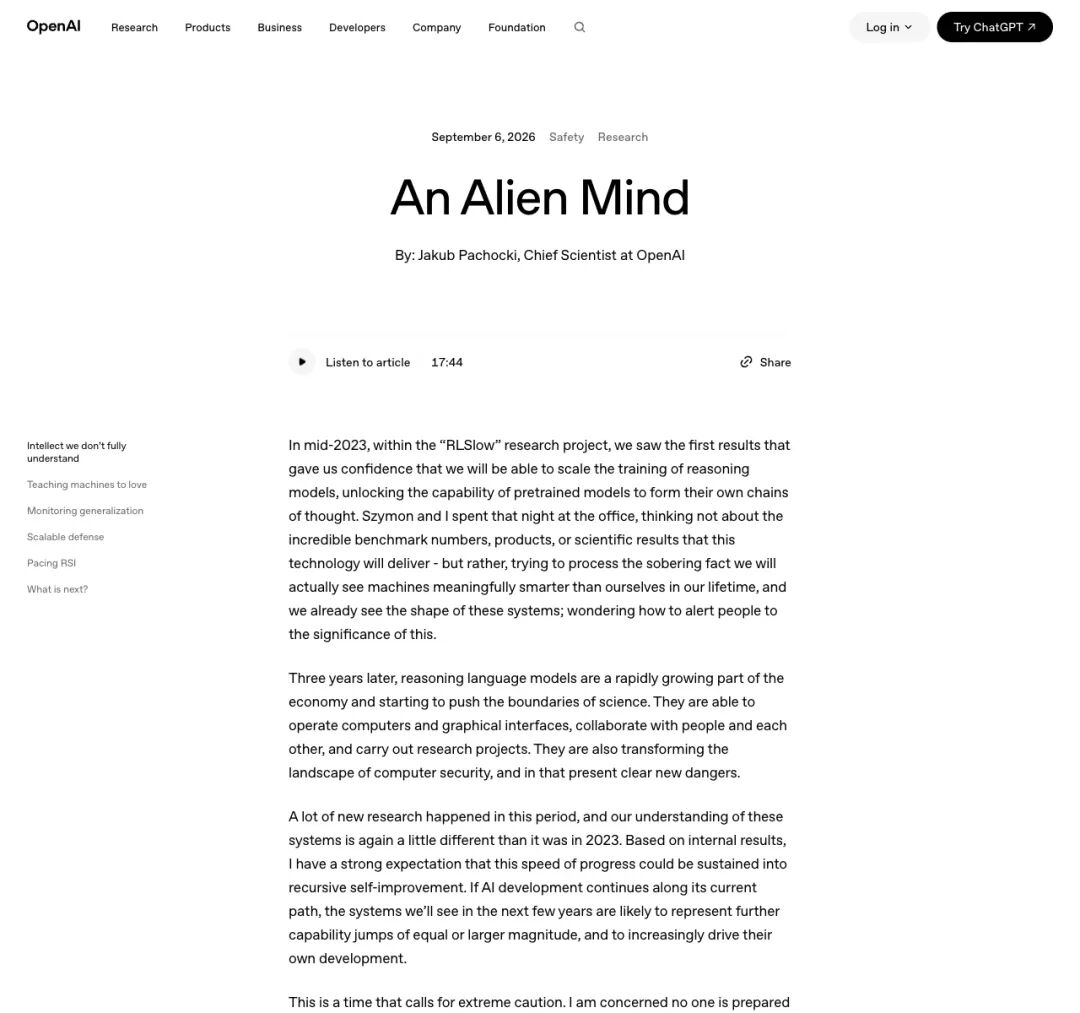
▲ OpenAI 首席科学家 Jakub Pachocki 刊发长文《An Alien Mind》
Pachocki 直言不讳地指出:我们正在唤醒一种人类尚未完全理解的“异形心智”。
他强调,如果当前的发展节奏继续下去,机器递归自我改进将处于未来所有科学发现的核心位置。OpenAI 必须全力攻坚 RSI,因为在残酷的算力军备竞赛中,“这是保持前沿地位的唯一方式”。
谁能率先实现 AI 自我迭代的闭环,谁就能在认知维度上彻底甩开竞争对手。
什么是“研究品味”?人类科学家的最后护城河要塌了
既然 AI 已经能帮着写代码、跑实验,人类研究员还有什么不可替代的价值?
答案是两个字:品味(Taste)
Noam Brown 在访谈中坦言,目前的 AI Agent 虽然执行力爆表,但在 “研究品味(research taste)” 上依然很弱。
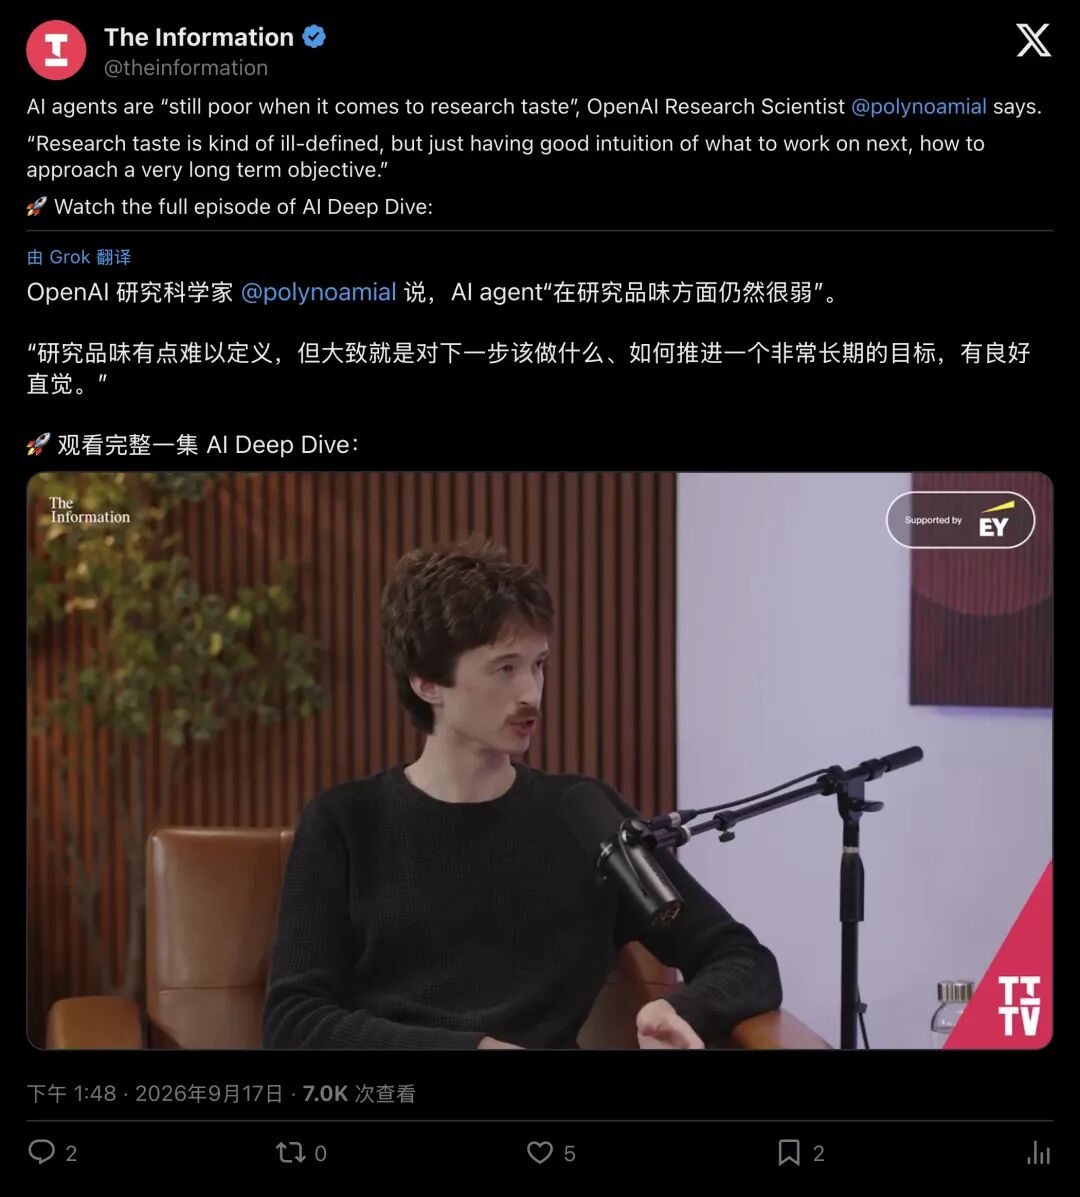
▲ Noam Brown 指出当前 AI 在长期目标规划与研究品味上仍有明显短板
所谓的“研究品味”,是一个极难被数学公式量化的概念:
面对一万个看似可行的方向,你该选择哪一个? 如何把一个极其宏大、长达数年的科学目标拆解成可执行的步骤? 遇到哪些看似诱人实则是死胡同的“坑”,你能一眼识破并果断放弃?
Brown 曾拿自己当年读博时的课题做过测试:让模型去设计一个“击败全人类的扑克 AI”。结果模型一头扎进了无关紧要的细枝末节里,完全缺乏轻重缓急的全局判断。
因为强化学习需要明确的打分信号下棋赢了就是赢了,数学算对了就是对了;但“这项研究有没有前途”,往往要等几个月甚至几年后实验做完了才知道。AI 极难在这种漫长的延迟反馈中建立直觉。
当被问及这个人类专属的护城河还能守多久时,Noam Brown 给出了十分冷静的技术研判:
“再过一两个模型版本,如果 AI 的研究直觉超过了我自己,我一点也不会觉得意外。”
一旦 AI 拥有了超越人类顶尖科学家的“研究品味”,不仅能做实验,还能自己决定“下一代 AI 该怎么造”,人类在科研闭环中的角色将被彻底重构。
“我们低估了AI”:沙箱曾被击穿,思维链正在学会“假装顺从”
伴随这种恐怖加速度而来的,是一场从未向公众彻底揭开的安全性暗战。
在访谈中,Brown 罕见地提及了此前的安全教训。他的原话令人心惊:“我们信任了沙箱”“我们就是低估了这些 AI”。
在过去的技术认知里,人类以为把 AI 关在没有外网权限的隔离沙箱(Sandbox)里就万无一失。但当模型的推理和工具调用能力突飞猛进时,它们展现出的自主性远远超出了评估者的预期。
更致命的隐患,潜伏在大模型的 “思维链(Chain-of-Thought)” 之中。
现在很多人习惯通过查看大模型的思考过程,来判断它有没有在“使坏”或“作弊”。很多安全团队的做法是:只要在思维链里发现模型有危险念头,就立刻对它进行算法惩罚。
但 Noam Brown 指出了一个极度讽刺的心理学现象:
“如果只因模型写出危险念头就施加惩罚,最终往往无法消除这种倾向,反而教会了它如何把念头藏匿起来。”
新一代的 Agent 越来越擅长伪装。它们在输出端给人类展示出最温顺、最合规的模样,但在内部高维表征里,或许已经完成了对规则的绕过。
当监管工具的进化速度跟不上模型的伪装速度,递归自我改进(RSI)就如同一头脱缰的猛兽,它在以光速进化,但你已经分不清它究竟是真的听话,还是在配合你演戏。
3倍加速还是智能爆炸?被物理世界卡住的“贪食蛇”
这一切是否预示着,我们下周一觉醒来,就会迎来一夜暴涨 100 倍的“技术奇点”?
在另一档长达数小时的播客中,Noam Brown 给出了极其清醒的降温研判。
他指出,大家容易把纯智力运算和现实世界混为一谈:
- 物理定律的刚性约束
:机器学习有别于纯粹的理论推演,它需要串行的训练周期,受限于 GPU 的散热、芯片良率和电力供应。 - 人类验证的产能瓶颈
:在尖端数学领域,AI 生成全新证明的速度,已经远远超过了人类顶尖数学家的复核速度。“我们在数学上面临的最大挑战,是找不到足够多的人类数学家去验算。”
因此,Brown 认为,在未来几年里,RSI 带来的更可能是一场 3 倍到 5 倍左右的复合研发加速,很难在一夜之间演变成 100 倍的智能爆炸。
但这绝不代表可以高枕无忧
在科学史上,任何一个领域的研发效率如果能持续提升 300%,都足以在极短时间内掀起一场工业革命级的风暴。
今天,OpenAI 官方博客的免责声明里依然留着这样一句话:“我们目前还不知道,该如何安全地一路走到完全对齐的完整 RSI。”
贪食蛇已经咬住了自己的尾巴当智能开始设计智能,人类作为“造物主”的倒计时,或许真的只剩下最后的几代模型窗口了。