ARTICLE · 1055454
一套能直接抄的 RAG 架构模板:从文档到可回答的助手
一套能直接抄的 RAG 架构模板:从文档到可回答的助手📌 本期速览 RAG(检索增强生成)是企业落地大模型最稳的架构:不让模型凭记忆编,先去知识库检索再生成。标准链路就五段——切分 → 嵌入 → 检索 → 重排 → 生成。本文给一张可抄的架构图 + 关键参数(chunk 大小、overlap、top-k、重排)+ 一段精简可运行的 Python 模板,并说清"什么时候 RAG 反而不如微调/长上下文"。 术语卡 · RAG(Retrieval-Augmented Generation) 检索增强生成:生成前先从外部知识库检索相关片段,拼进提示词,再由大模型生成答案。核心是把"参数记忆"换成"检索证据",从根上压幻觉、补时效。 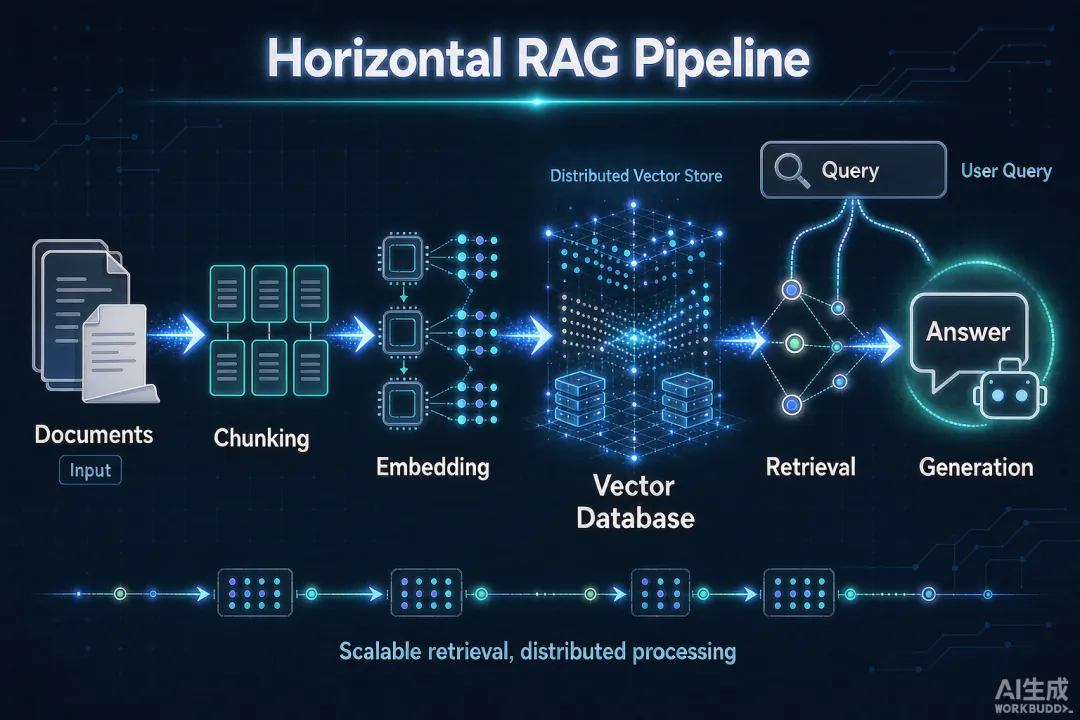
# RAG 标准链路(精简骨架) def build_index(docs): chunks = [c for d in docs for c in split(d, size=400, overlap=50)] vecs = embed(chunks) # ② 嵌入 return store.upsert(chunks, vecs) # 入库 def answer(query): cands = store.search(embed(query), top_k=20) # ③ 召回 top = rerank(query, cands, top_n=6) # ④ 重排 prompt = f"基于以下资料回答:\n{top}\n\n问题:{query}" return llm(prompt, cite=top) # ⑤ 生成(带引用) 📚 信源 Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, arXiv:2005.11401, NeurIPS 2020(RAG 原论文)。 工程实践参考:LangChain / LlamaIndex 的 RAG 模块,以及向量库 Milvus、pgvector 官方文档。
💬 互动 关注后回复关键词「RAG」领这份架构图的高清版 + 可运行代码仓库。你家公司落地 RAG 卡在切分、检索还是重排?评论区说,下期挑痛点细拆。
01 为什么是 RAG,而不是猛堆模型
大模型两个问题绕不开:幻觉(编你没说过的话)和知识时效(训练截止后发生的事它不知道)。
微调能补领域风格,但补不了"昨天的工单""你们公司的内部文档"这类私有、易变的知识,且每次更新都要重训,成本高。
RAG 的思路更直接:把知识外挂成一个可检索的库,回答时先把相关问题"查出来"塞进上下文,再让模型基于证据生成。知识更新只需"重新入库",不动模型。
02 标准五段架构
03 关键参数与坑(决定效果的不是模型,是这儿)
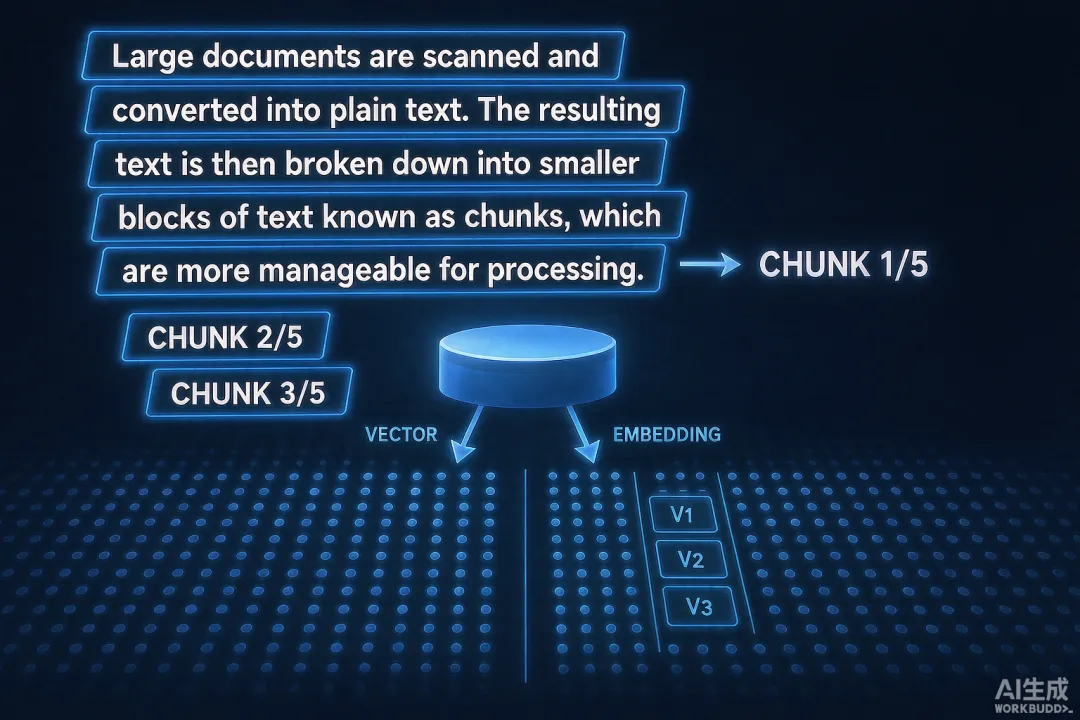
**切分(Chunking)**是第一道关,切错后面全废。
chunk 大小:中文建议 300–500 字一段,太小丢上下文、太大噪声多。 overlap(重叠):相邻块重叠 10–15%,避免一句话被切断导致检索不到。 按标题/段落切,别按固定字数硬切——语义边界比字数重要。
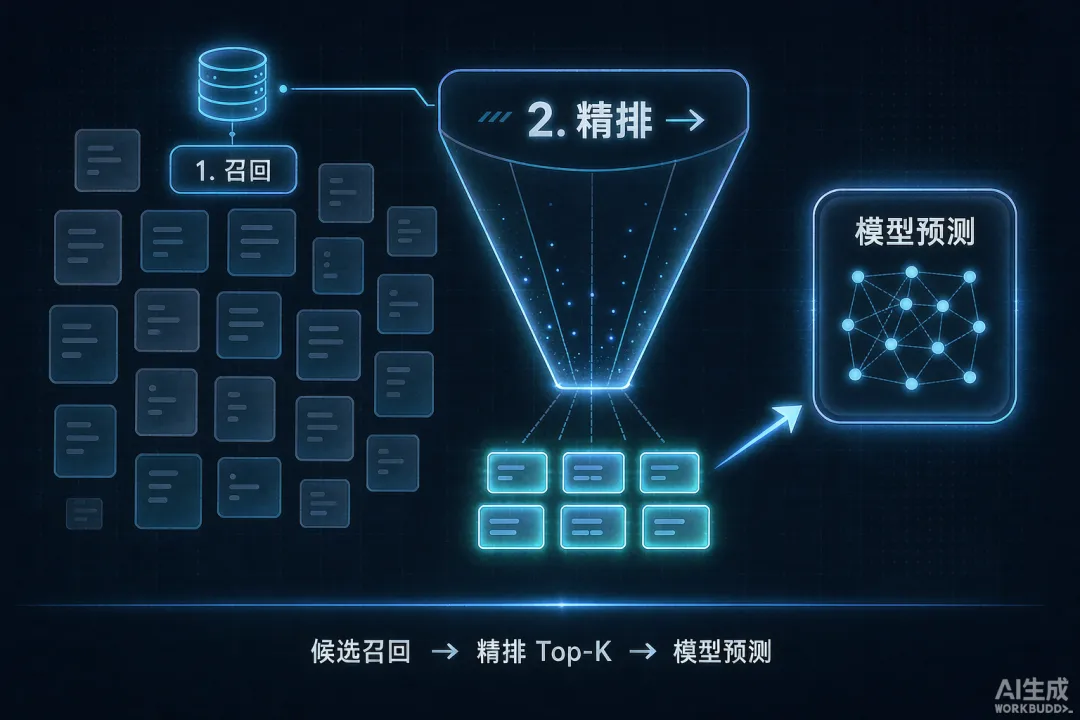
检索与重排:
召回用稠密向量(Embedding)已是基线;**加一层 Rerank(交叉编码器)**往往比单纯提 top-k 更显著提升答案相关度。 top-k 不是越大越好,5–8 通常够;塞太多噪声反而带偏生成。
04 可抄的精简模板(Python 伪代码)
下面是一段可直接照着补全的骨架,生产里把占位换成你的向量库(如 Milvus / pgvector)和 Embedding 服务即可:
05 什么时候 RAG 反而不合适
架构模板不是万金油,三个边界要清楚:
知识高度稳定且要"内化风格"(如特定文风客服)→ 微调更贴。 上下文本来就能塞进窗口且量小(如单篇 PDF 问答)→ 直接长上下文(上篇 StreamingLLM 解决的是"塞不下"的问题,这里相反)。 强推理、多跳(答案要跨多文档推理)→ 纯 RAG 不够,需加 Agent 多步检索(后续架构模板会展开)。