ARTICLE · 1056670
给 AI 配工具,多数人只做了「怎么调」,漏了「怎么找到」
一个 Agent 系统的工具数量,会走这样一条曲线:前 3 个工具写死在代码里;到第 10 个,开始有人问「我们明明有这个接口,为什么 AI 不知道」;到第 30 个,问题就变了——不再是「有没有」,而是「AI 还找不找得到」。
我们把工具从代码里搬了出来,变成数据库里的一行行数据。这一步不难,难的是它带出的连锁问题。其中最关键的一个是:
这份数据,会由谁、在什么时候读?
答案有两个:对话运行时的 Agent,和对外提供能力的那层协议网关。而这两个读者,需求几乎是相反的。
一、工具住在哪
一条工具记录大致包含:功能名称与说明、请求方法与地址、一棵递归的参数树(每个节点有名称、类型、说明、是否必填、在请求里的位置)、响应格式树、归属业务域、风险等级(读 / 写 / 敏感),以及一个启用开关。
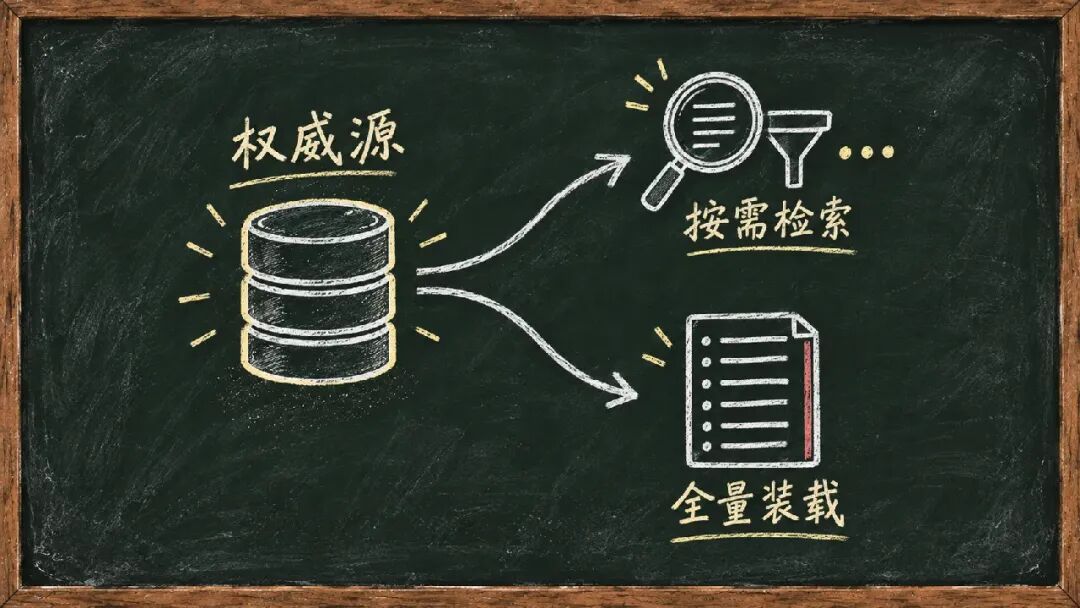
外面套一层管理面:增删改查、从 OpenAPI 文档批量导入、全量重建索引。这些都落在关系库里——工具真正意义上的权威源,就是这张表。
为什么不写死在代码里?热插拔(新接口上线不用发版)、归属可见(哪个业务域有哪些工具是数据问题,不是代码问题)、可审计。
但分水岭不在这里。分水岭在于:这份数据要被两个需求相反的消费者读取。
二、路径一:写入时建索引,调用时按需召回
第一个消费者是对话运行时。它的约束很硬:上下文是有预算的。模型单次能看到的工具清单有限,而且清单越长、选错的概率越高——不是它看不到某个工具,是整个清单被稀释了。
所以运行时需要的不是「全部工具」,而是「这一轮最可能用上的那几个」。
写入时,把工具向量化存进向量库。三个设计选择:
- 向量化的文本
是「功能名称 | 详细说明 | 接口标识」拼接。参数树没有进去——参数解决的是「怎么调」,检索解决的是「调不调它」。 - 主键
直接复用关系库的主键,显式指定、不让向量库自增。两边天然对得上,后面的 upsert 幂等也成立。 - 不只存向量
:还有一份可供关键词检索的文本、由它派生的稀疏向量,以及一个记录业务域的标量字段。最后这个是伏笔。
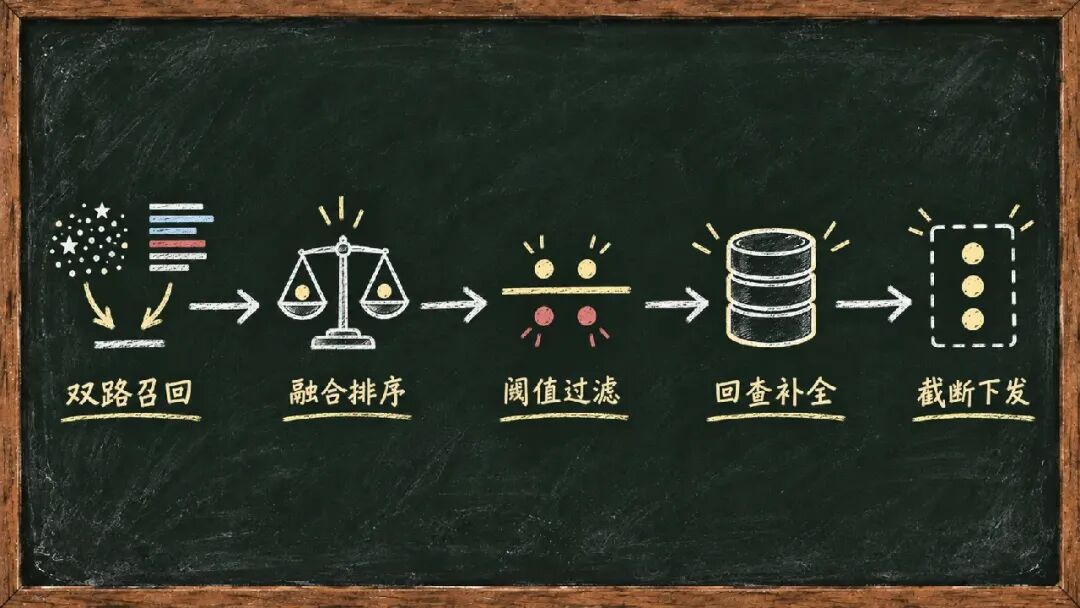
调用时,一次用户消息走一遍五步检索:
- 双路召回
——稠密向量做语义相似度,稀疏向量做关键词字面匹配,各取一批候选。 - 融合排序
——用 RRF(倒数排名融合)合并两路结果。RRF 只看排名不看分数,正好绕开「余弦相似度和 BM25 分数不可比」这个麻烦。 - 阈值过滤
——阈值卡在稠密向量的余弦得分上,RRF 分只用来排序。因为 RRF 分是排名导出的相对值,当绝对阈值没有意义:一个工具哪怕排第一,也可能跟意图毫不相干。 - 回权威源补全
——用命中的主键回关系库捞完整记录,并在这一步过滤掉已禁用的工具。这一点后面还要回来算账。 - 截断下发
——召回深度(比如 20)和最终下发的数量(比如 5)是两个独立参数。
还有一个细节:业务域预过滤。带业务域上下文的请求会先按域过滤,但如果过滤后一个都没剩,就自动退回全域检索。
这个取舍很重要:召回一个不相关的工具,模型最多不选它;漏掉一个真正需要的工具,任务就废了。假阴性远比假阳性致命,宁可多召回。
最后,检索出的这几个工具不会以「原生函数调用」传给模型,而是渲染成一段文本清单塞进提示词。这是刻意的——它让「模型说要调哪个工具」完全落在一个可控的文本协议里。
三、路径二:MCP 网关启动即全量装载
第二个消费者是对外那层协议网关(我们用的是 MCP)。它的需求恰好相反:它不要「最可能用上的几个」,它要一份完整、稳定、可枚举的清单。因为它的客户是外部的、异构的客户端——人家问的是「你这儿到底有哪些能力」,不是「你猜我此刻想干嘛」。
所以实现几乎是反着来的。进程启动时全表加载,没有过滤条件、没有分页、没有 top-k。 每一行都要过一遍防御性校验:参数树深度、配置字节上限、地址协议、请求方法白名单、路径穿越风险。不合格的跳过并告警,而不是让进程起不来——一条坏数据不该拖垮全站。
通过校验的工具被动态注册:工具名按一套清洗规则规范化,参数树转成 JSON Schema 作为入参声明。
三个决策值得单独说。
只做差量重注册。 刷新时逐个比对:新增的装上、删除的卸下、没变的跳过。刷新成本取决于「变化的工具数」而不是「工具总数」——工具上千之后,这是数量级差别。
刷新用「手动 + 轮询」双通道。 一个管理端点手动触发,一个后台任务按固定间隔做差量重注册。为什么不用消息通知?因为网关会重启,重启后它需要一份不依赖任何外部状态就能重建的视图。轮询笨,但它对「进程生命周期」这个变量不敏感。
它装载的包含已禁用的工具。 规范里有明确决策:启用开关是检索层的全局开关,跟执行层的风险管控是正交的两件事,过滤职责在检索侧。
换句话说,网关故意装了一批永远不会被 Agent 调用的工具。因为如果网关也按启用状态过滤,「启用」这个开关就有了两处实现,而两处实现意味着两种失效方式。与其让两个系统各自猜哪条该过滤,不如把过滤收敛到唯一那个知道上下文的地方。
四、为什么两套都必须存在
看到这里一个自然的怀疑:这不是重复建设吗?
因为这两个需求,各自有一个无法互相妥协的下限:
运行时按需检索 | 网关全量装载 | |
读取时机 | 每轮对话 | 启动 + 周期刷新 |
粒度 | Top-K 动态子集 | 全集 |
匹配 | 语义 + 关键词混合 | 不匹配,客户端自选 |
主要代价 | 召回不确定性 | 规模天花板 |
典型失效 | 该召的没召到 | 上下文膨胀 |
运行时必须检索——上下文预算是物理约束。工具上百之后,把全量清单塞给模型,效果明显下滑。
网关必须给全量——因为它是协议出口。一个「取决于你问什么、才告诉你有什么能力」的能力清单,对客户端来说是无法编程的。
所以正确的理解不是「两套方案选一个」,而是职责切分:
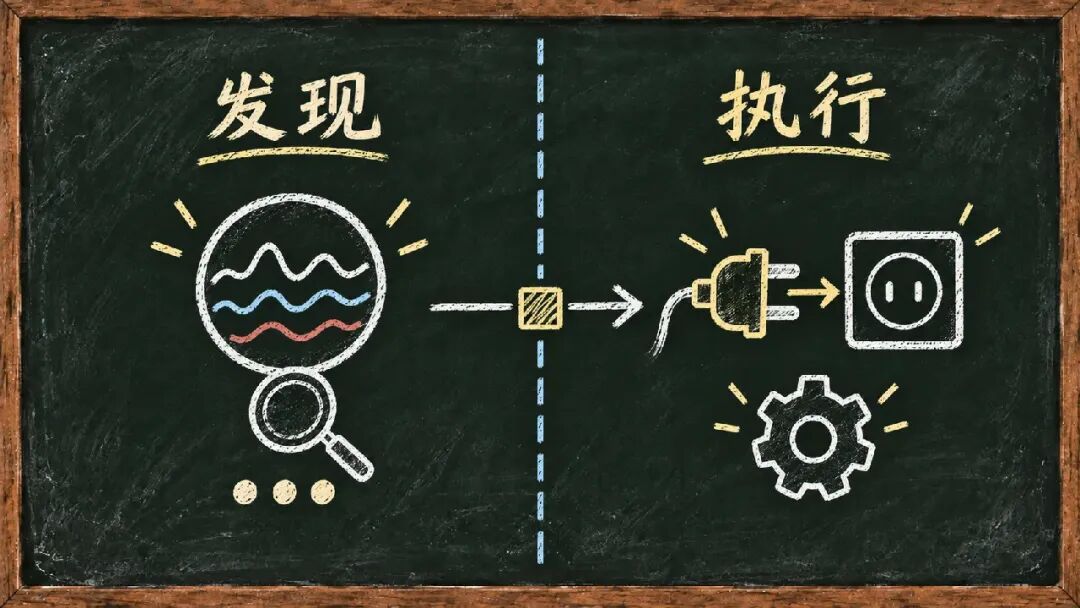
发现和执行是两件事。发现走检索:谁需要工具,谁自己按语义去找。执行走协议:工具被选中之后,把参数交给一个确定的执行通道。
我们的规范把这条写成了硬约束:工具发现不得依赖 MCP 的工具列表能力,MCP 侧只承担执行职责。 这条看着像技术细节,实际上把架构上最容易混淆的一处边界钉死了。
五、真正难的地方,都在「两份数据」之间
关系库是权威源,向量库是派生副本。这套系统的复杂度,基本都从「派生」这个词里长出来。
派生副本会漂移,而且漂移是静默的。 最典型的例子是启用开关:切换启用状态不触发向量重算(向量文本里根本不含启用状态),于是向量库里长期躺着一批已禁用的工具,靠检索时回查权威源过滤掉。这个设计是对的,但它立了一个前提——回查那一步不能省。省掉它不会有任何报错,只会出现「这个工具明明禁用了,AI 还在用」。
更隐蔽的一种在写入侧:描述改了、但向量没重算。系统一切正常,只是这个工具永远检索不到了。这类 bug 的共同点是它们不报错,只表现为「AI 好像不太聪明」。
所以同步必须配一组兜底:写入后异步派发不阻塞响应、按主键 upsert 保证幂等、批量失败降级为逐条重试,再加一个全量重建接口兜底。代价是这套机制异常全吞、没有重试——这是一个清醒的取舍,但前提是它必须可观测,否则你手里会攥着一批「沉默地检索不到」的工具,而且毫不知情。
同一份参数模式,要服务两个转换器。 运行时把它渲染成给模型看的文本清单,网关把它转成 JSON Schema。危险在于两边的规则必须完全同构——树怎么递归、必填怎么判定、可空怎么表达。任何一处不一致,症状都是「通过网关调得通、Agent 调不通」。我们的做法是两侧各写一份、但对写明同步义务,再用漂移检测定期比对快照——这是应对「物理上无法共享代码」的次优解,不优雅,但比让不一致悄悄存在要强。
同理,工具名的清洗规则也必须两侧一致,否则症状是「模型说要调某个工具,执行侧回答:没有这个工具」,而且只在名字带特殊字符时才复现。
而权限过滤不在检索层。 这一条容易和前面「启用状态在检索层过滤」混淆。实际分工是:启用状态是全局开关,跟「谁在问」无关,所以在检索层过滤;权限取决于当前是谁,而且把「你看不到这个工具」泄露成「这个工具不存在」,本身就是一次信息泄露,所以在执行前判定。
也就是:能看见什么,和能做什么,是两个判定,发生在两个时刻。 把它们混在一起,你会得到一个「权限越高、检索结果越多」的诡异系统。
六、回到那个问题
工具管理的本质,是把工具当数据,而不是当代码。而一旦它成了数据,你就必须回答那个问题:这份数据,谁会在什么时候读?
我们的答案是两个读者、两条路:运行时按语义检索出一个极小的子集,网关在启动时装载一份完整的清单。共享同一个权威源,却刻意给出不同的视图。
这不是冗余,是发现与执行的分离。
而那些琐碎的工程细节——幂等、漂移、阈值、回退、清洗规则——本质上都在处理同一件事:让一份数据分裂成两份之后,依然能对得上。