ARTICLE · 1060710
单位里在跑多少个 AI 智能体,谁说得清?
单位里在跑多少个 AI 智能体,谁说得清?某区做年度信息化盘点,在册的智能体应用有 12 个,账目清楚。 但跟科室聊下来,情况就变了:一个科室说自己还试过三个,是在平台上自己注册的;另一个科室手上有一套外包商留下的脚本,一直在跑;还有两个是年轻人从开源社区下载、在本地机器上装起来的。 加起来,没人能给一个准确的数字。 数字不准还不是最麻烦的。麻烦的是:不在册的那几个,是谁给它们的权限?它们看过哪些文件?要回答这个,得先把"智能体到底是怎么接进来的"这件事从技术上说清楚——因为不同的接法,留下的痕迹完全不同。 
根子在技术:它不是一个"部署物"。 一套信息系统的样子是固定的——有服务器、有账号、有上线动作,所以能被数出来。智能体不是。它更像模型能力 + 提示词 + 若干工具 + 一份权限的组合,这个组合可以装在一个浏览器插件里、一个本地脚本里,也可以只是某平台上的一个账号。它没有一个"我上线了"的动作。 让它变得这么容易的,是三个门槛同时降了。 接入门槛降了。以前要把 AI 接进业务系统,得有接口、有开发、走流程。现在不少产品能直接读取屏幕内容、模拟点击,不需要对方系统配合就能接进去;也有的产品注册一个账号就能用。 运行门槛降了。模型可以做得很小。9 月开源的一批小模型里,20 亿参数级别就能原生支持工具调用和多步推理。这意味着在一台普通服务器、甚至一台本地设备上就能跑起来,不必申请云端资源。 采购门槛降了。一个小工具,科室自己的预算就能覆盖,有的用免费额度就能试,不一定会走到信息化部门。 三条加在一起:装上,就跑了。传统台账按"系统""服务器""账号"来数,自然抓不住它。 这周刚在杭州结束的云栖大会,有一场论坛的题目直接写成问句——当 Agent 从 10 个变成 1000 个,怎么跑、怎么管。这个问题在单位里同样成立,只是我们现在的数量还小,先撞上的是前面那一关:说得清。 "接入门槛降了"这句话底下,其实是三条不同的技术路径。它们各自用什么办法接进来、留下什么痕迹,都不一样。 第一条,读屏加模拟点击。它不经过对方系统的接口,而是用视觉识别找到屏幕上的按钮和输入框,再模拟人手去点、去填。技术上,这条路的难点在"元素定位"——同一个按钮换个位置、换个颜色,识别就可能失败。它有两个先天问题:一是它拿到的其实是"屏幕上看得见什么",而不是"这个账号有没有权看",看得见和有权看是两回事;二是脆,界面一改版它就断,而且断在哪里,往往没人知道。 第二条,平台账号。注册一个账号就能用,权限跟着账号走。这一类最容易和个人的账号混在一起:用谁的名注册的,谁就能看到它做过什么;授权是按人签的,人一调动、一离职,这条线就断了。从这个角度说,它没有"自己的身份",只有一个借来的。 第三条,接口对接。走的是标准工具调用,权限边界清楚、每次调用可审计。技术上最稳,也最贵:要对方配合、要排开发,走一遍往往以月计。 前两条是"散落"的主要来源。因为它们都不需要立项,也就都不会自动进台账。真去盘,优先抓这两类。 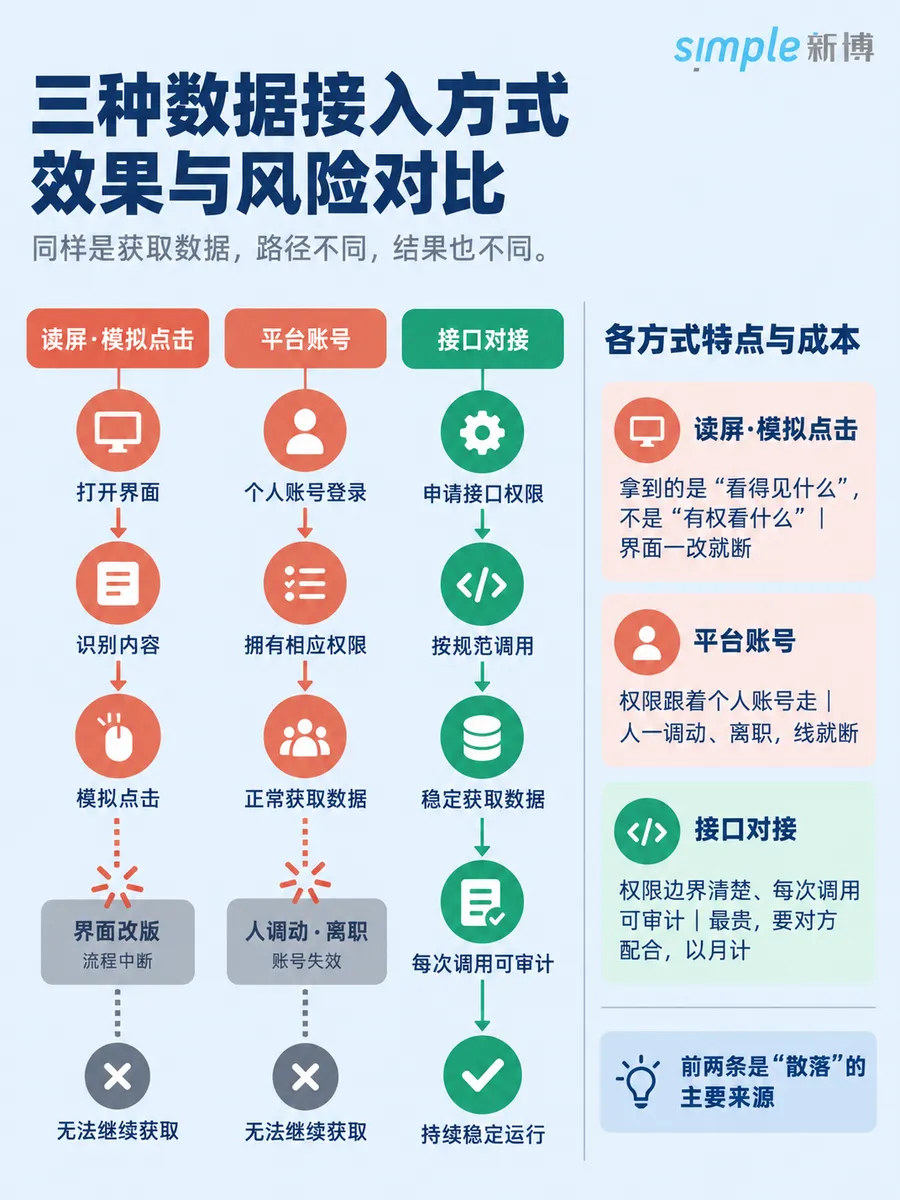
想把散落的智能体数清楚,靠的不是更细的表格,是看它留下的痕迹。这件事在技术上有个名字,叫可观测性。 但这里有个坎:三条路径留下的痕迹,能看见的程度差很多。 读屏那类 最隐蔽。它走的是正常的界面操作,流量看起来和人点鼠标没有区别,从网络出口基本看不出来。 平台账号那类 ,痕迹在平台上,不在你手里。你只能看到"有人登了、调了多少次",看不到它具体读了什么。 本地小模型 更特别:如果它完全在本地跑、不出网,网络上一点痕迹都没有,只剩下端点上的进程和文件。 只有走接口那一类,天然留下了完整的调用记录。 所以"我们单位到底有多少个智能体",往往不是一个能一次数清的数字,而是一个要看几处痕迹才能拼出来的估计。 这也解释了为什么现在必须做:标准层面,9 月启动的两项智能体安全团体标准,第一项就是给智能体建身份——它得有一个唯一、可信、可持续验证的数字身份,才能谈授权和审计;产品层面,已经有厂商把智能体身份直接放进单位的组织目录,让它的操作走进原有的审计日志和访问策略;调研层面,一份覆盖 3000 多个企业账号的行业调研(2026 年 8 月,厂商口径)显示,安全团队通常只能看到本单位实际在运行的 AI 智能体的约三分之一,另一份行业机构调研里,82% 的组织承认环境中有自己不知道的智能体在跑。 也就是说,多数单位的清单是凭印象写的。而凭痕迹去找,通常会多出这三类:科室自己试用的、外包留下的、开源部署的。 很多单位做这件事,第一步是拉一张表:智能体名称、归属部门、上线时间。 这张表没什么用,因为它没有回答真正的问题:谁给这个智能体开了哪扇门。 至少要能对上六项:
六项里最容易被跳过的是第五项。因为它要求业务部门回答"哪些操作是绝对不能自动做的"——这个问题,技术部门答不了。 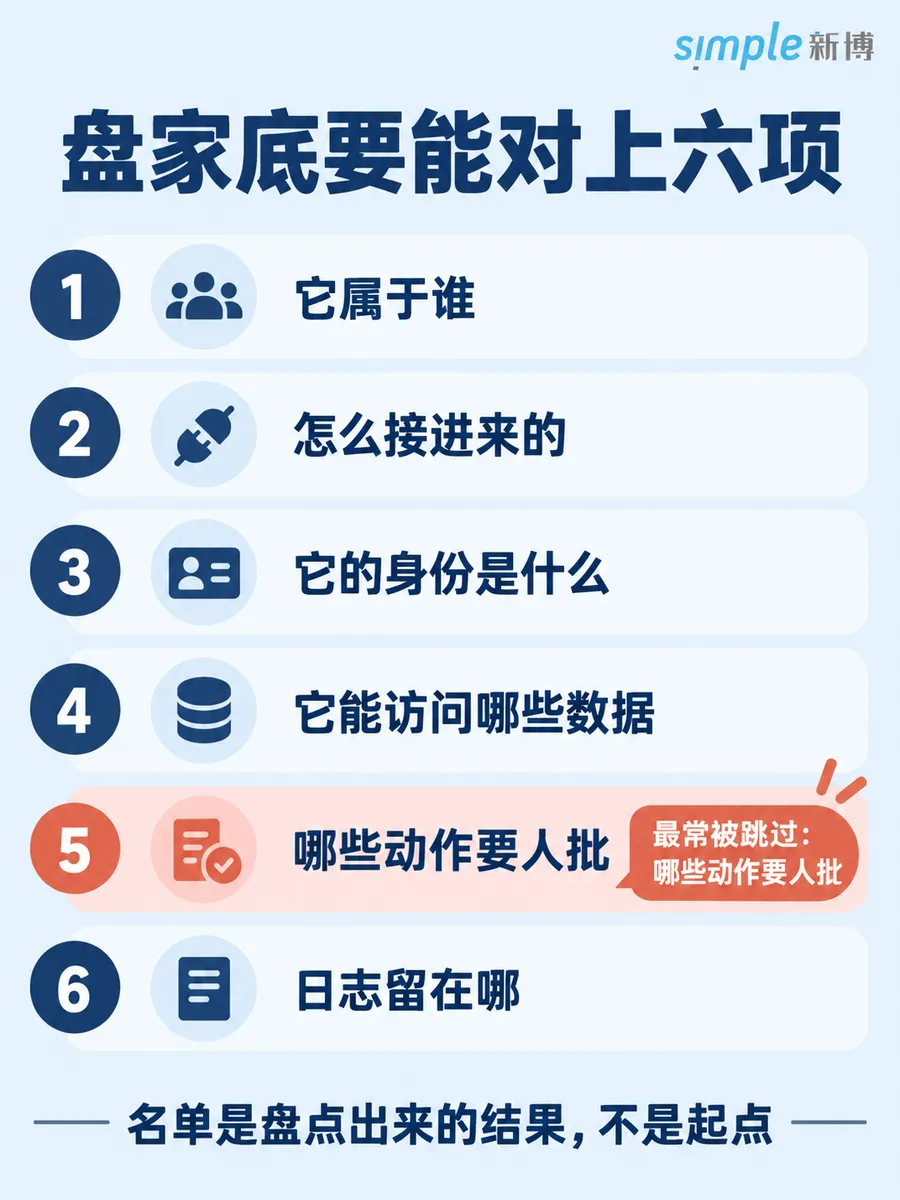
如果让我们去盘,顺序会反过来:先看日志,再看名单。 原因很简单——挑一个已经在跑的智能体,把它的日志翻出来,试着回答四个问题:谁发起的、调了哪个工具、影响了哪条记录、谁批的。四个答不全的,说明这个智能体的身份和权限本来就是糊的,名字列进台账也没用。名单是盘点出来的结果,不是盘点的起点。 不需要一次做全,也不需要新买平台。 第一周,把不在册的找出来。 不要只找信息化部门要名单。发一张表到各科室,问三句话:你们科室有没有在用 AI 工具?谁申请过账号?有没有外包商留下的、还在跑的东西? 这一步的目标不是完整,是暴露。宁可多列几个最后确认不用,也别漏掉一个在跑却没人管的。 第二周,给每个智能体补一个责任人,和一份权限说明。 责任人必须落到具体的人,不能写"某某科室"。权限说明写清楚三件事:能读什么、能写什么、能对外做什么。 第三周,挑出高风险动作,加一道人工确认。 不要试图一次管住所有事。先把"删除数据""对外发送""修改正式记录"这三类挑出来,做成必须人工批准。这是投入最小、收益最直接的一步。 三周之后再谈工具。到那时你会发现,工具该接什么、该管什么,已经有了答案。 最后 智能体散落在各科室,本身不一定是坏事——它说明业务部门真的在用、也用得上。真正的问题只有一个:我们说得清它们分别在做什么吗。 你们单位有没有那种"在用但不在册"的 AI 工具?欢迎留言说说它是怎么进来的——是科室自己注册的、外包留下的,还是有人从开源社区装上的。我们会挑几个,把它的接入路径、权限边界和留痕情况逐条过一遍。 如果想拿一份智能体盘点的排查表,可以在公众号后台回复「盘点」,我们按你描述的情况单独答复。
智能体为什么这么容易"散落"
它到底是怎么进来的:三条技术路径
为什么名单数不过来,日志却能
盘家底,要能对上六项