ARTICLE · 1061324
AI资讯|7B 小模型拿下开源生图第一:Qwen-Image-2.1 开源,抠图、改字、拼素材这三件烦事一次解决
7B 小模型,拿下开源生图第一
Qwen-Image-2.1 开源:抠图、改字、拼素材这三件烦事,一次解决
2026 年 9 月 21 日核验 · 7B 主干 / 60.28 分 / 原生透明图
大家好,我是小智。
你有没有过这种体验:让 AI 生成一张图,图确实挺好看,但离能交稿还差三步——人得抠出来、字得改掉、商品得重新摆一遍。
这三步,正是设计师、电商运营、还有每天给公众号找封面的小编们,最烦、也最费时间的地方。
9 月 20 日,阿里千问开源了新图像模型 Qwen-Image-2.1,官方对它的定位是“千问图像系列当前最平衡、性价比最高的开源生图模型”。
视觉生成部分只有 7B 参数;
文生图和改图,塞进了同一个模型;
原生支持透明图——它可以一步生成“背景已经被抠干净”的素材。
在千问自己的公开评测 Qwen-Image-Bench 上,它拿到60.28 分,超过闭源的 Nano Banana 2.0(59.82)和 GPT Image 1.5(59.65)。
QWEN-IMAGE-2.1
60.28
开源 · 7B 主干
NANO BANANA 2.0
59.82
闭源
GPT IMAGE 1.5
59.65
闭源
参数更小、分数更高、还顺手解决了抠图这件事——这期咱们就聊三件事:它到底强在哪、你能拿它干嘛,以及“开源”这两个字背后,有个坑你得先看清楚。
📌 本文看点
从 20B 缩到 7B:小了,怎么反而更强了?
三个最实用的能力:透明图直接出、最多 10 张参考图、圈哪改哪
四类人该怎么用它(设计师 / 电商 / 自媒体 / 开发者)
想上手怎么办:普通人和有显卡的人,两条不同的路
三个冷思考:开源 ≠ 能免费商用、7B ≠ 小显存、60.28 分该怎么看
最后给三条今天就能做的准备
说明:请以官方公告为准
文中信息为 2026 年 9 月 21 日的公开口径(模型于 9 月 20 日开源)。截至目前,官方只放出了模型权重与技术报告,尚未公告线上体验入口;文中涉及许可证、显存门槛的内容来自第三方仓库与社区拆解,请以 GitHub / Hugging Face 仓库中的 LICENSE 文件与官方后续公告为准。
这次到底发布了什么
RELEASE · 7B 是怎么算出来的
先把参数这件事说清楚,因为它最容易被误读。
官方口径:Qwen-Image-2.1 的“视觉生成部分”包含 32 层 Single-Stream DiT,参数量为 7B。
注意“视觉生成部分”这几个字——7B 指的是图像生成这块主干,文本编码器等组件另算。所以看到“7B 打败 20B”这类说法,别理解成整个模型只有 7B。
对比一下它的上一代就好懂了:
主干从 20B 砍到 7B,能力反而更全了,这背后有两个工程上的关键动作:
一是换了“注意力”的算账方式
模型用的是混合粒度注意力结构:文本部分(系统前缀、编辑指令)按Token 级因果掩码逐词算,保证语义理解连贯;图像生成部分按Chunk 级掩码分块算。
二是 KV Cache 复用
在一次改图任务里,你给的参考图和编辑指令其实从头到尾没变——每一步去噪都重新算一遍纯属浪费。所以模型把这些“静态内容”在第一步就预计算并缓存下来,后面每一步直接复用。
打个比方:以前的模型像每画一笔,都把参考照片从头看一遍;现在的模型是先看懂、记下来,再动笔。参考图越多(这次最多能给 10 张),这个优化省下的时间和显存就越明显。
输出方面,它原生支持2048×2048(2K),并支持多种宽高比。
三个最实用的能力
CAPABILITY · 透明图 / 多参考图 / 圈哪改哪
发布稿里写了四个亮点,但站在“用得上”的角度,真正改变工作方式的是这三个。
① 原生透明图:直接给你“能贴的素材”
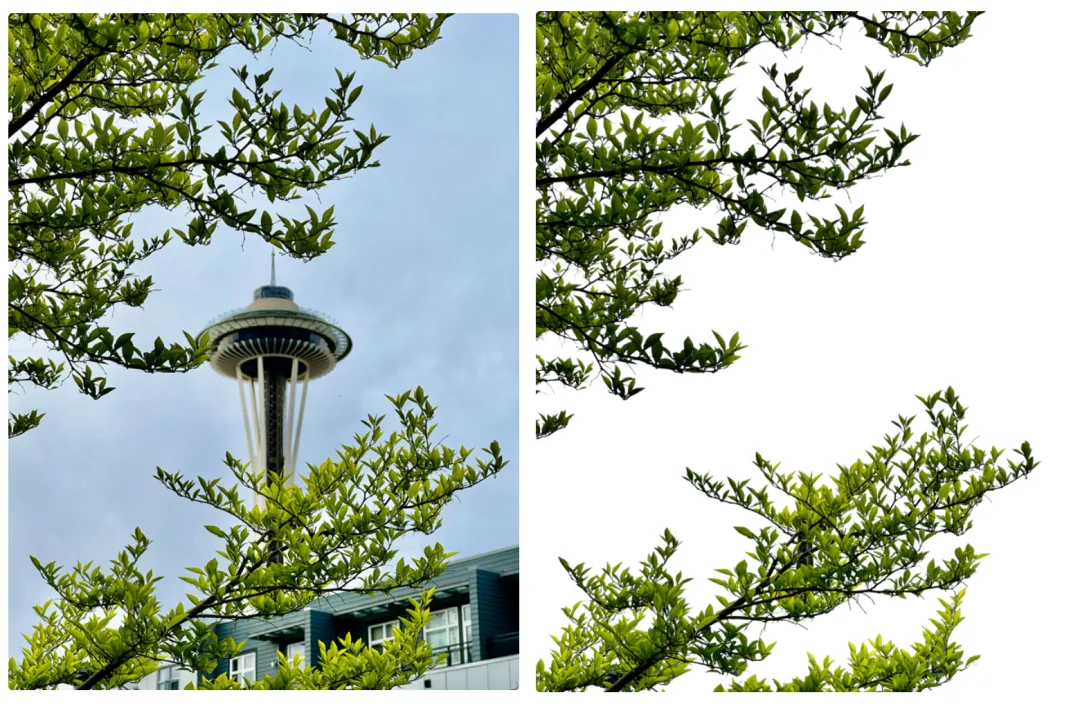
我们平时说的图片,基本都是带背景的。想把一个主体贴到海报或详情页上,得先抠图——处理轮廓、发丝、缝隙,边缘还常常留一圈白边。
透明图多了一个“透明度通道”,能记录画面每一处的透明程度,背景自然就透出来了,叠放到任何底图上都干净。
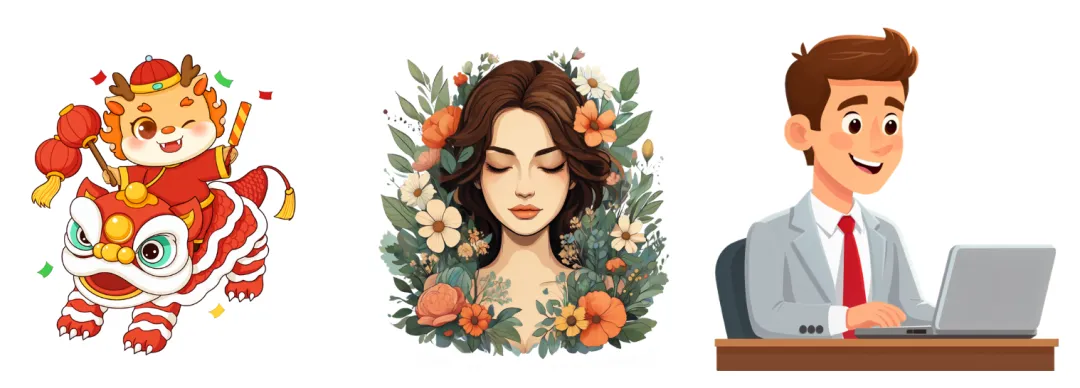
Qwen-Image-2.1 的做法更省事:它根据提示词自动决定输出普通图还是透明图。你只要在描述里说清楚,就能直接拿到带透明通道的素材——贴纸、节庆插画、装饰元素、人物素材,甚至由多个对象组成的复杂组合。
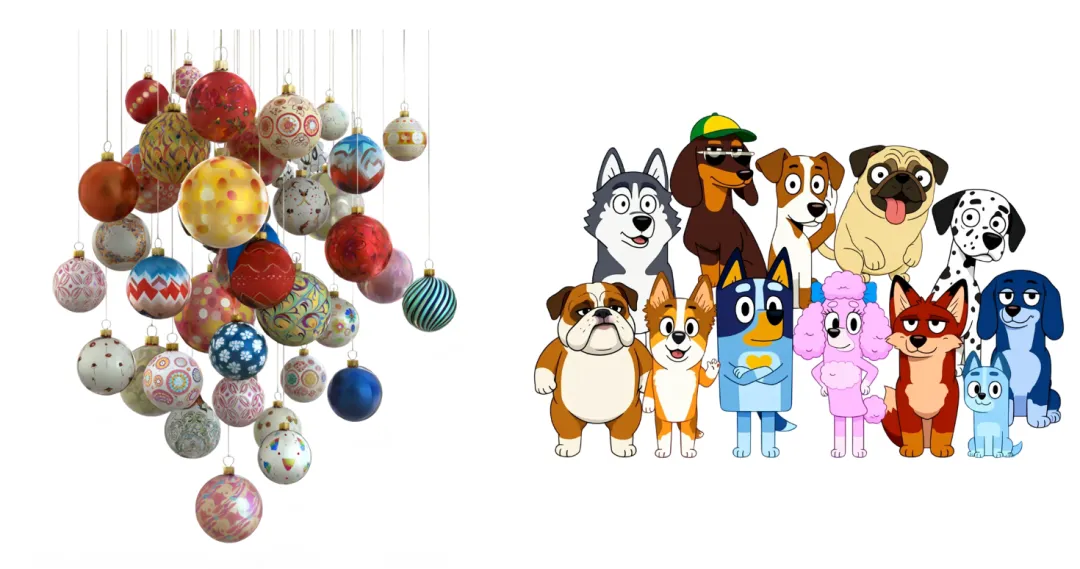
而且这些透明素材还能接着改。同一个插画人物可以改表情;素材里的文字可以直接改内容(官方示例是把 “BLOOM” 改成 “Qwen-Image”)。这非常贴近真实需求——活动名称换了,图案得留着;表情要轻松点,人还得是那个人。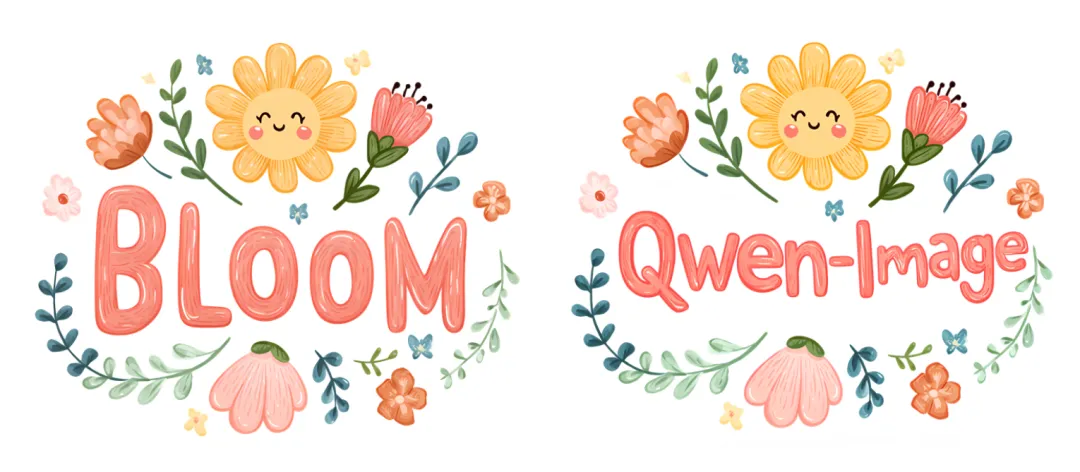
它甚至能处理真实照片:输入一张普通照片,让模型提取你要的主体,直接输出带透明通道的图层。老照片、库存图,都能变成可复用的素材。
② 最多 10 张参考图:从“拼凑”到“调度”
以前的改图,大多是“一张图 + 一句话”。现在最多能塞进去 10 张参考图,难度完全不一样——模型得区分哪个是人、哪个是商品,把它们摆到合理的位置,还得各自保留特征。
官方给了几个很直观的例子:
6 张人像 → 一张合照(把分散的单人照拼成一张自然的合影);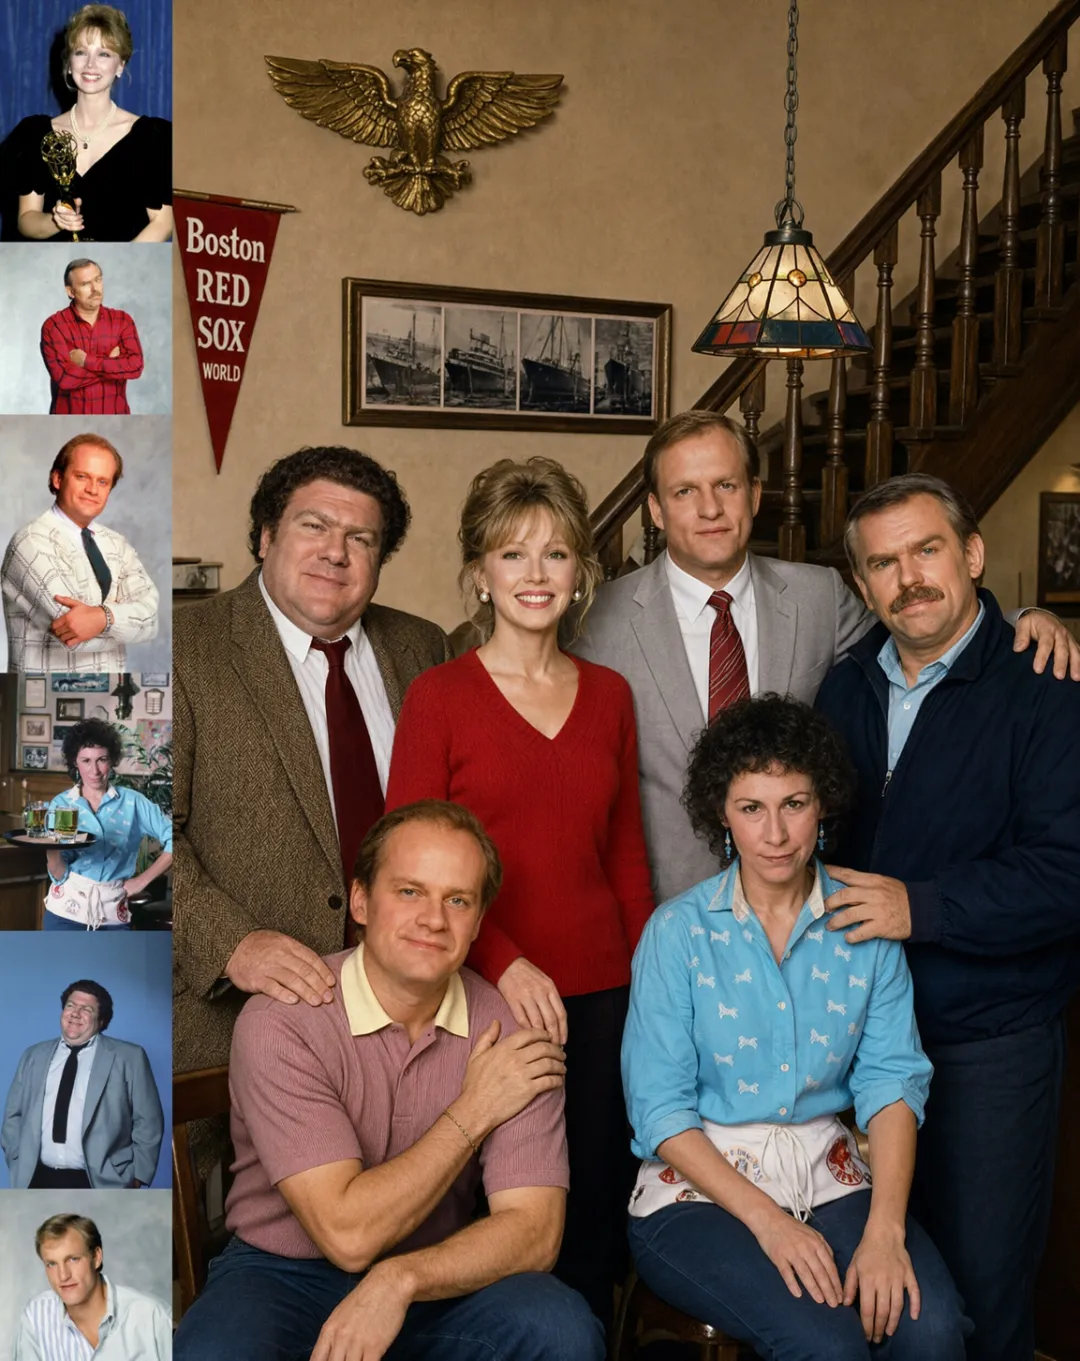
模特 + 衣服 + 鞋子 + 包包 + 帽子共 5 张 → 一套完整穿搭(比“衣服上身”更难,因为它要同时保住人和物的特征);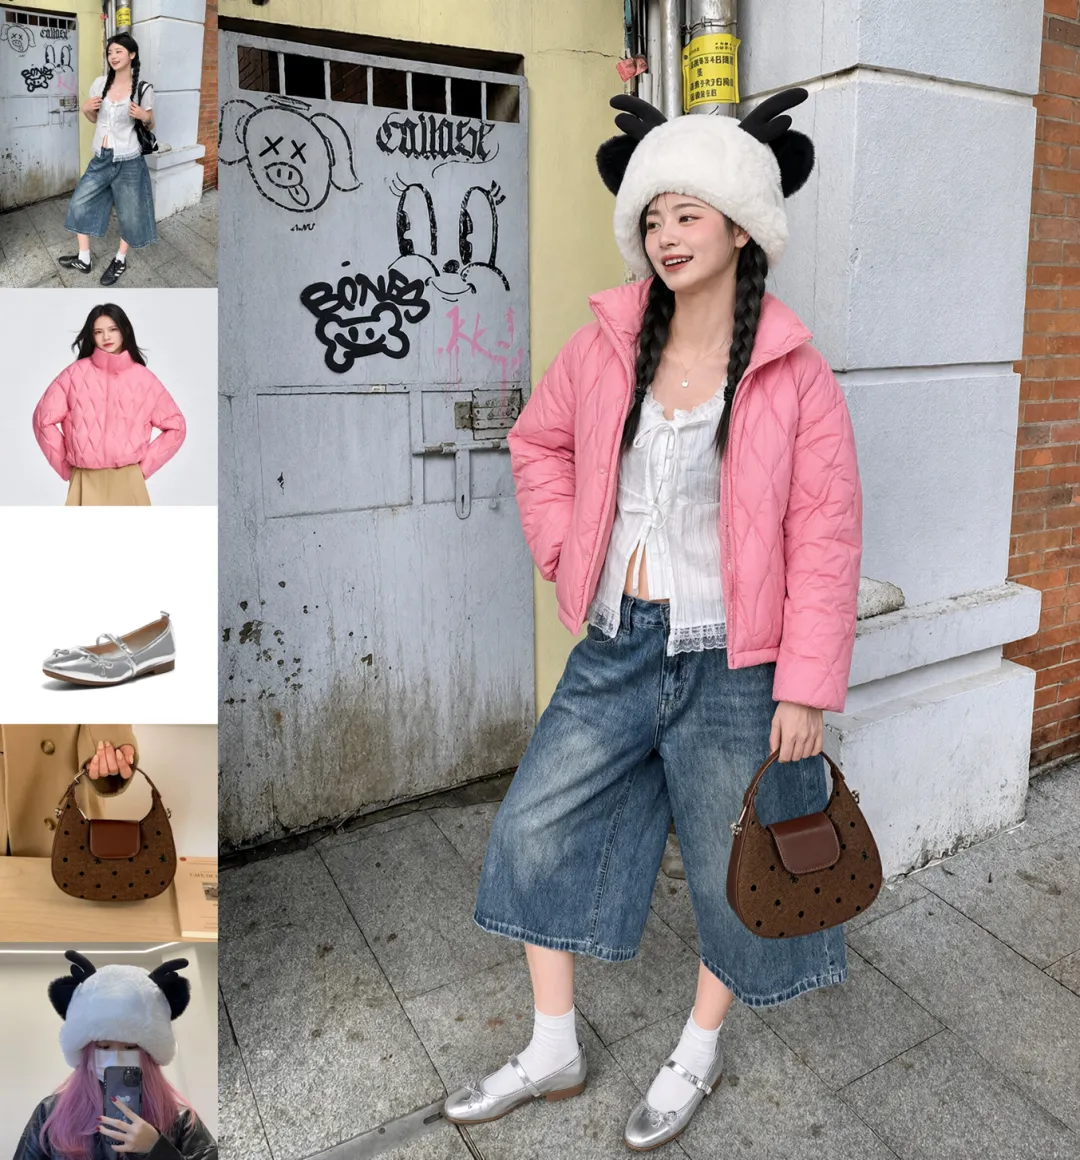
10 张家居图 → 一整套室内布置。
机器之心的实测更夸张:他们用7 张参考图(两个人对峙的照片、背景房间、单人沙发、咖啡杯、落地灯、电壁炉、矮桌)生成了一张完整的场景图。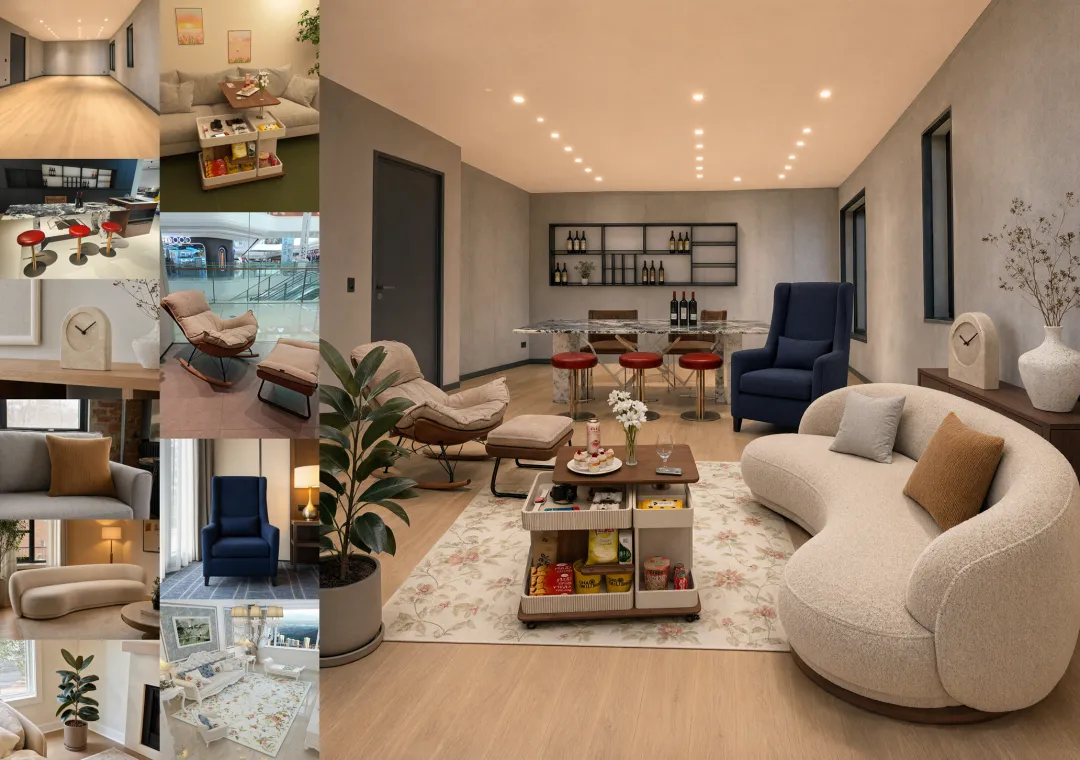
③ 圈哪改哪:三种指定修改位置的方式
改图最怕的是“我说东它改西”。这次给了三种把位置说清楚的办法:
圈选:用不同颜色的圆圈同时标出多个区域,一句话下达多个指令。官方示例是:去掉蓝圈里的金属手表、把红圈里的头发改成黑色、把绿圈换成灰色短袖亚麻睡衣——三个区域一次改完。
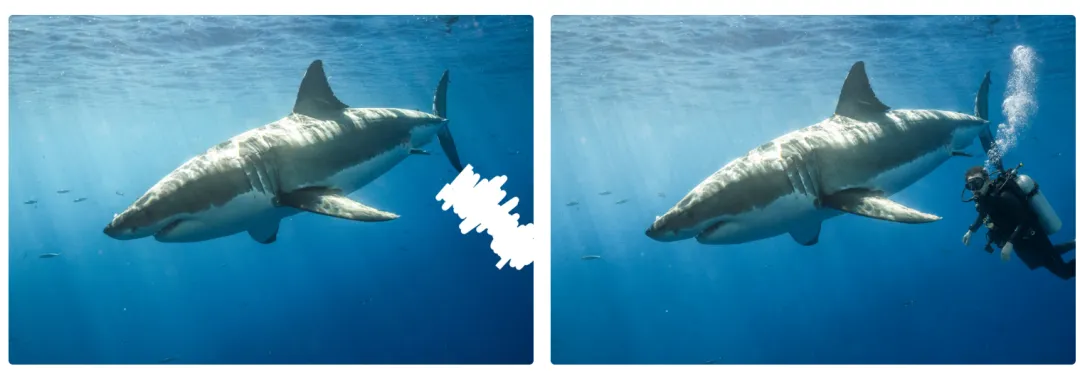
涂抹:直接在想加东西的位置刷一笔白色,模型就在这块区域里补内容(示例是在鲨鱼右侧加一名潜水员)。
独立掩码:圈选和涂抹都会遮住一部分原图。想保留完整原图信息,就把原图和一张单独的掩码图一起喂进去,模型按掩码指定的区域改,原图信息一点不丢。
对人像和商品来说,“不丢”是最关键的——换了发型和场景,人还得是那个人;商品换了摆放环境,包装上的字、纹理和形状不能跟着变。这次官方专门强化了这两类的一致性。
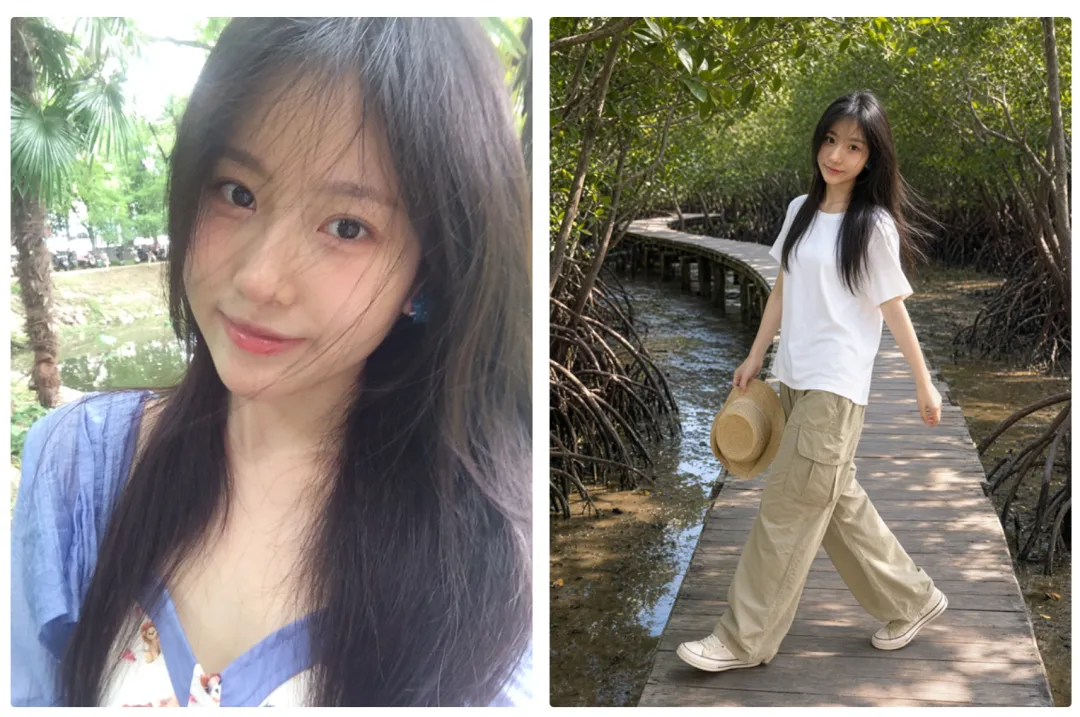
另外它还支持全景图、信息图、三视图转分镜等任务,等于把静态图像的生产链条又拉长了一截。
四类人,该怎么用它
WHO · 看你是哪一类
能力很热闹,但落到你身上,得看你是哪一类。
① 设计师 / 美工
最大的变化是少工序。透明素材直接出,意味着“生成 → 抠图 → 修边 → 合成”能压缩成“生成 → 合成”。真正省时间的是那句“改字不改图”——活动名、Slogan、价格标签变了,不用重画整张。
② 电商运营
商品一致性是直接对口的。同一个商品换场景、换摆放、换搭配,包装文字和纹理能保住,这才是能上架的图。多参考图组合也很适合做“搭配效果”和“场景图”。
③ 自媒体 / 内容创作者
封面图、信息图、分镜图这条线最实用。尤其是公众号封面、小红书图文这类“字比画多”的场景,文字渲染一直是开源模型的弱项,这次是官方重点提升的方向之一。
④ 开发者 / 有显卡的玩家
这次的生态配套相当完整——ComfyUI 发布当天就支持(Comfy-Org 提供了权重)、Diffusers 已合并对应支持、SGLang 与 vLLM-Omni 也在首日可用,适合做服务化部署和批量生成。
想上手怎么办:两条不同的路
GETTING STARTED · 没显卡 / 有显卡
如果你是普通人(没显卡、不写代码):先别急
目前官方放出的是模型权重和技术报告(GitHub、Hugging Face、魔搭),尚未公告线上体验入口。按以往节奏,权重开源到平台接入通常还要几天到几周。这期间你可以:
关注千问官方渠道(千问 App、通义万相、Qwen Chat)的上线公告;
留意 ComfyUI 社区和第三方平台(如国内的在线生图站点)的接入消息;
先用已有的在线生图工具把需求跑通,等接入后直接换模型。
如果你有显卡、想本地跑:先看清门槛
这是本次最容易被“7B”两个字骗到的地方。据第三方实测(Mushroom Research Blog,2026-09-21),官方 H100 基准下:
56.5 GB 意味着什么?A100/H100(80GB)可以全精度跑;RTX 4090(24GB)只能靠 CPU offload,把峰值压到约 12–14 GB,代价是速度大幅下降,基本不实用。而且首日没有官方量化版本(无 GGUF / FP8 / INT8)。
7B 不等于小显存
给本地玩家的建议很直白:要么等社区量化版(大概率会有 GGUF / FP8),要么先在有大卡的云环境上体验。
顺带一提:别拿旧经验硬套
CFG 默认就是 1.0,玩惯了 FLUX 那套调 CFG 的手感在这里不适用。
三个冷思考
CAUTION · 热度之下,先看清
热度之下,有三件事我觉得必须说清楚。
第一,也是最重要的:开源 ≠ 可以免费商用
多个第三方仓库与社区信息显示,Qwen-Image-2.1 的许可证是Qwen Research License(研究用途),与上一代 Qwen-Image 的 Apache 2.0 不同,商用需要单独向阿里云获取授权。
开源了两个字,不等于授权了两个字
你可以拿它学习、研究、做实验;但想把它塞进自己的商业产品、或者用它给客户做交付型服务,得先拿到授权。如果你现在就需要一个能商用的开源生图底座,FLUX.1 Dev / Schnell(Apache 2.0)这类仍是更稳的选择。
再次强调:具体条款请以 GitHub / Hugging Face 仓库中的 LICENSE 文件为准,别只看新闻标题里的“开源”两个字。
第二,“7B”说的是主干,不是显存
前面说过,7B 是视觉生成部分;把文本编码器等算上,整体规模要大得多。再叠加56.5 GB 的峰值显存,结论很清楚:小模型不等于小门槛。对绝大多数个人用户来说,本地跑这件事短期内不现实——这跟“模型多强”是两回事,得分开看。
第三,60.28 分该怎么看
这个分数来自千问自己的 Qwen-Image-Bench,不是第三方独立榜单;官方目前也未公布 FID、CLIP score 这类可复核的量化指标。所以更稳妥的读法是:它在自家口径下超过了 Nano Banana 2.0 和 GPT Image 1.5,说明开源模型第一次在这个量级上摸到了闭源模型的后背,但别把它当成“碾压闭源”的结论。
社区早期反馈里还有两个值得留意的点:
参考图超过 3 张后,一致性会有下滑——10 张是接口上限,不是质量承诺;
人物解剖偶有错误,密集人群场景里小人物的细节容易丢。
另外,首日没有任何社区 LoRA 或 ControlNet可用,微调生态也还是空白。这些都会随时间改善,但今天就是这个状态。
小智说两句
THOUGHTS · 三个我自己的判断
聊完技术,说三个我自己的判断。
第一,AI 生图的竞争,正在从“能不能生成”转向“能不能改到能用”
过去两年大家比的是“第一眼惊艳度”;现在比的是“第七稿能不能改对”。透明图、多参考图、圈哪改哪——这三件事指向同一个方向:让 AI 的产物能直接进工作流,而不是只能发朋友圈。
这才是“生产力工具”和“玩具”的分界线。
—— 小智的判断
第二,对普通人来说,“等”是最省力的策略
模型权重已经开源了,但离你在手机上随手用上,中间还隔着“量化”和“平台接入”两步。这两步通常由社区和平台在几周内补齐。你要做的不是抢着装环境,而是先把自己的需求想清楚。
第三,给你三条今天就能做的准备
建一个“参考图库”:把你常用的产品图、人物形象、风格样张整理好。多参考图是新能力的核心,素材质量直接决定出图效果。
练习“说清位置和边界”:别再说“把这里改一下”,试着说“去掉左腕的金属手表、把头发改成黑色、把上衣换成灰色亚麻短袖”。会描述修改范围,正在变成一项硬技能。
养成看许可证的习惯:尤其是你打算把 AI 生成的图用在商业交付里的时候。开源了两个字,不等于授权了两个字。
技术的进步从来不是先问你愿不愿意,而是先悄悄出现在你同事的电脑上。
你平时做图最烦的是哪一步——抠图、改字,还是拼素材?如果这些都能一句话解决,你最想先交给 AI 哪件活?评论区聊聊。
资料来源(核验日期 2026-09-21)
千问大模型公众号《Qwen-Image-2.1 开源:轻量高能,创作编辑一体化》(2026-09-20)
千问官方 Blog:qwen.ai/blog?id=qwen-image-2.1
GitHub:github.com/QwenLM/Qwen-Image-2.1
Hugging Face:huggingface.co/Qwen/Qwen-Image-2.1
ModelScope(魔搭):modelscope.cn/models/Qwen/Qwen-Image-2.1
机器之心《拿下开源生图第一,千问 Qwen-Image-2.1 把生图卷出新高度》(2026-09-20)
IT之家《阿里千问开源 Qwen-Image-2.1 图像模型:可生成、编辑透明图像,支持最多 10 张参考图》(2026-09-20)
快科技《7B 小模型超越闭源!千问 Qwen-Image-2.1 开源》(2026-09-21)
Mushroom Research Blog《Qwen-Image-2.1 工程实践:7B DiT + 原生 RGBA,阿里开源图像生成模型本地部署指南》(2026-09-21,显存门槛与许可证部分)
SUMMARY
7B 主干拿下开源第一,靠的不是堆参数,而是把“能用”这件事做进了模型里。
透明图、多参考图、圈哪改哪,指向同一件事:让 AI 的图能直接进工作流。但请记住三件事——开源 ≠ 能免费商用、7B ≠ 小显存、60.28 分是自家口径。普通人最好的策略是等平台接入,先把参考图库和“说清位置”的本事准备好。
你最想把哪件活交给 AI?
抠图、改字,还是拼素材?评论区聊聊,我攒一攒下次做个实战篇。
评论区见
小智科技
分享 AI 观察与干货,用得上、看得懂
长按识别二维码 · 关注不迷路
小智
热衷于分享 AI 观察与干货,每周更新。
小智科技 · 每周更新 AI 观察与干货