ARTICLE · 1062287
WeVisDoc:腾讯开源端到端文档解析模型,一张图直出 Markdown
做 RAG 或者知识库的同学大概都经历过这种事:拿到一摞 PDF 或者扫描件,想喂给大模型做问答,前面却横着一条"文档解析"的坑。传统做法要拼装一套 pipeline——版面检测模型切区域,OCR 模型认文字,公式识别模型转 LaTeX,表格识别模型转 HTML,再写一堆胶水脚本把结果拼回 Markdown。每个模型都要单独部署、单独调优,工程成本不低,效果还经常在拼接处出问题。
腾讯微信团队最近开源了一个叫 WeVisDoc 的模型,想用"单模型端到端"的方式把这条 pipeline 替掉。一张文档页面图扔进去,模型直接输出结构化 Markdown,公式是 LaTeX,表格是 HTML,阅读顺序已经恢复好,不用再预先裁切标题、正文、表格、公式。
WeVisDoc 是什么
WeVisDoc 是腾讯微信视觉团队开源的端到端文档解析模型,仓库在 github.com/Tencent/WeVisDoc 协议,目前 299 Star、14 Fork,7 次提交。模型有 2B 和 4B 两个版本,分别基于 Qwen3-VL-2B-Instruct 和 Qwen3-VL-4B-Instruct 微调。论文同步发在 arXiv(编号 2609.20423),标题是"WeVisDoc: From Coverage to Capability for Robust End-to-End Document Parsing"。
官方定位写得很清楚:端到端文档页面图像解析器。和传统多组件 pipeline 不同,它把版面理解、文字识别、公式识别、表格重建四件事放到同一个视觉语言模型里完成,不需要另外部署版面检测器和 OCR 引擎。
技术架构上有一个设计取舍值得点出来——WeVisDoc 不改 Qwen3-VL 的模型结构,而是把训练分成两个阶段。第一阶段扩大几何和语义覆盖,让模型见过足够多样的版式和内容;第二阶段基于错误诊断做能力提升,针对第一阶段模型出错的样本集中修复。这种"数据驱动两阶段"的思路,让 2B 和 4B 都能在对应参数量级上拿到不错的性能。
核心功能详解
整页图片直出 Markdown
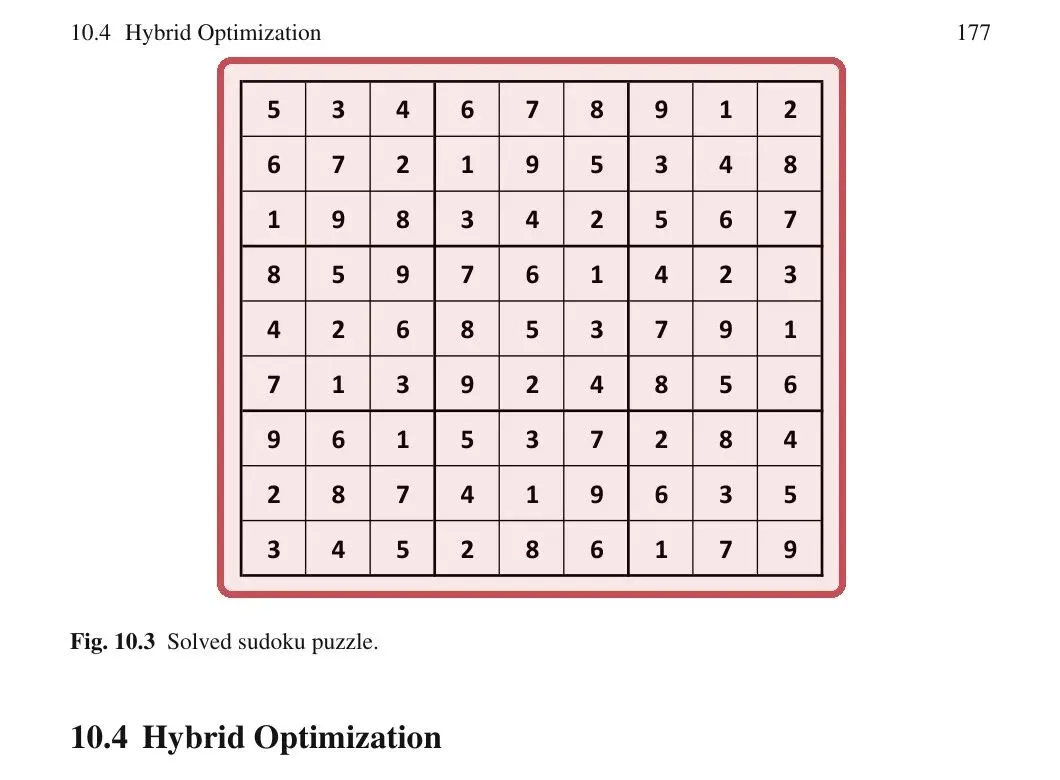
传统文档解析要先做版面检测,把页面切成标题、正文、表格、公式等区域,再分别送进不同模型识别,最后拼接成结构化文档。WeVisDoc 省掉了这个"裁切"步骤——整页图片直接送进去,模型一次输出完整的 Markdown,包含阅读顺序、段落结构、嵌套列表。
这对实际使用影响不小。扫描件、PDF 截图、拍照件不用再预处理,直接喂模型就能拿到结构化文本。拼接处常见的"段落顺序错乱"“表格被切断”"公式归属错位"等问题,由模型统一处理而不是靠后处理脚本修补。
公式转 LaTeX + 表格转 HTML
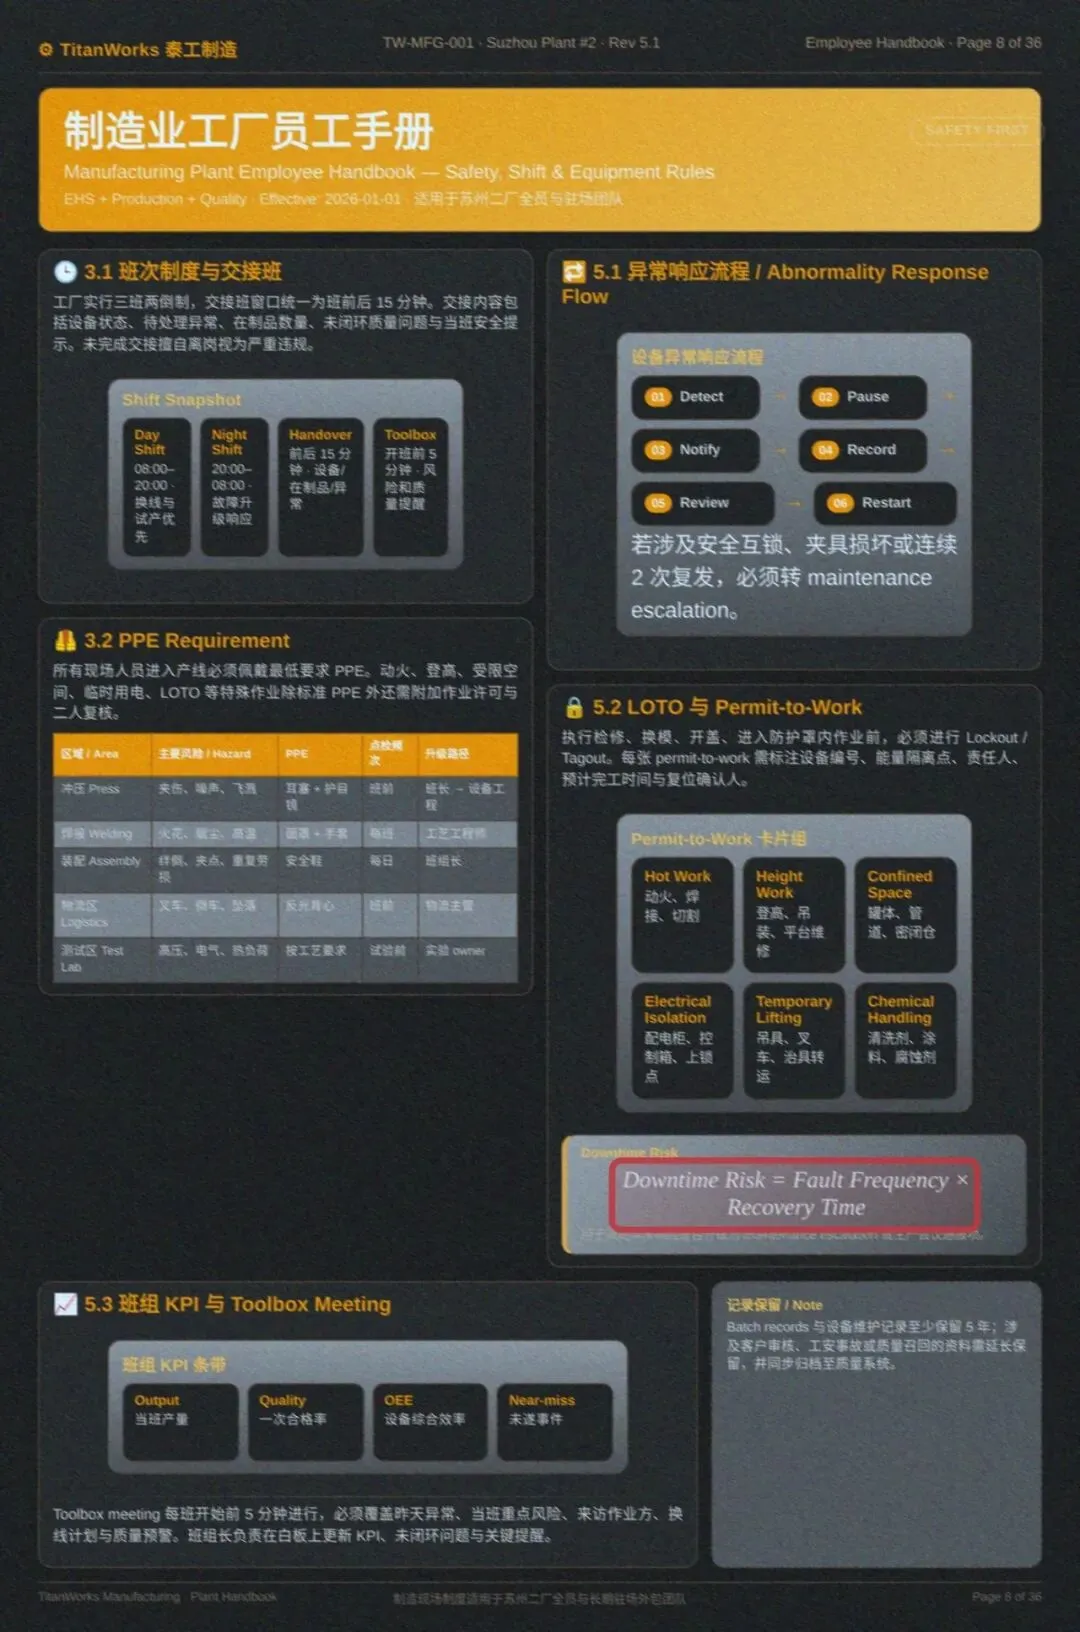
公式和表格是文档解析里公认的难点。传统 OCR 把公式当成普通文字识别,结果是乱码;把表格当成图片,结果丢掉结构。WeVisDoc 在输出阶段就把公式转成 LaTeX、表格转成 HTML,可以直接嵌入 Markdown 喂给 LLM。
LaTeX 输出对 RAG 场景尤其有用——LLM 读到 \frac{a}{b} 比读到一张公式图片有用得多。HTML 表格保留了行列关系,LLM 能直接理解"哪一行对应哪一列",不用再从图片里推断。
单模型完成版面/OCR/公式/表格
把四件事放到一个模型里做,直接好处是部署和运维成本降一个量级。传统 pipeline 要跑四套模型权重、四套推理服务、四套依赖环境,WeVisDoc 只需要一个模型权重、一个推理服务。版本升级、模型替换、性能监控都只在一处做。
间接好处是错误传播路径缩短。传统 pipeline 里前一阶段出错会污染后阶段输入——版面检测漏切一块,后面 OCR 就漏识一段。端到端模型在训练阶段就见过完整页面,有机会学到版面、文字、公式、表格之间的联合关系。
2B 和 4B 双版本
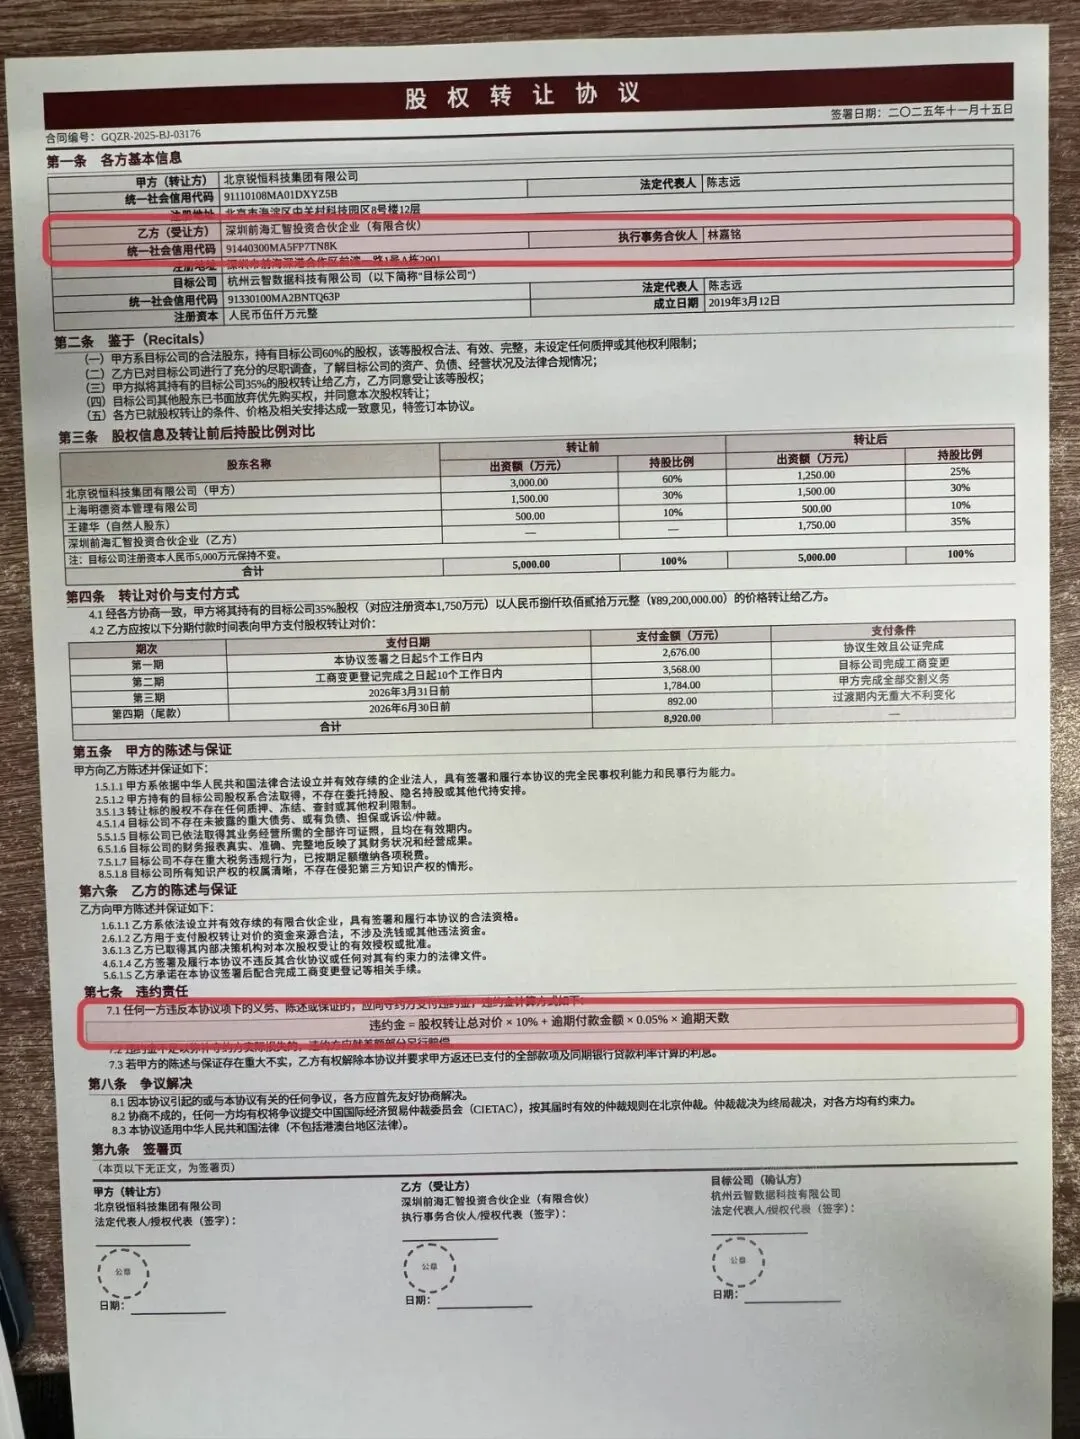
两个版本对应不同场景。2B 版本基于 Qwen3-VL-2B-Instruct 微调,参数量小、推理快、显存占用低,适合资源有限或者页面较清晰的场景——比如原生 PDF、数字生成的文档、扫描质量高的文档。4B 版本基于 Qwen3-VL-4B-Instruct 微调,参数量大、表达能力强,在拍照、翻拍、模糊、倾斜等退化页面上更有优势。
两版本共享同一套训练框架和推理代码,切换只需要换模型路径,业务代码不用改。
实测体验与性能数据
部署方式有两条路径。推荐的是 vLLM 服务部署,要求 Python 3.10+、vLLM >=0.11.1。装好依赖后跑 bash scripts/serve_vllm.sh Tencent/WeVisDoc-2B 就能起服务,默认监听 127.0.0.1:8000。多 GPU 部署用 TENSOR_PARALLEL_SIZE=2 配合 CUDA_VISIBLE_DEVICES=0,1,4B 模型可以开 MAX_MODEL_LEN=65536 处理超长页面。
不想用 vLLM 的可以用本地 Transformers 推理,pip install -r requirements-local.txt 之后 python -m wevisdoc.local --model Tencent/WeVisDoc-2B --image page.png --output results/page.md 一行命令搞定单图解析。
客户端调用支持单图和批量目录。批量模式用 python -m wevisdoc.client --image-dir images --result-dir results --workers 4,多线程并发,--workers 控制并行数。客户端读 OPENAI_BASE_URL 和 OPENAI_API_KEY 环境变量,和 OpenAI SDK 兼容,可以直接集成进现有调用链。
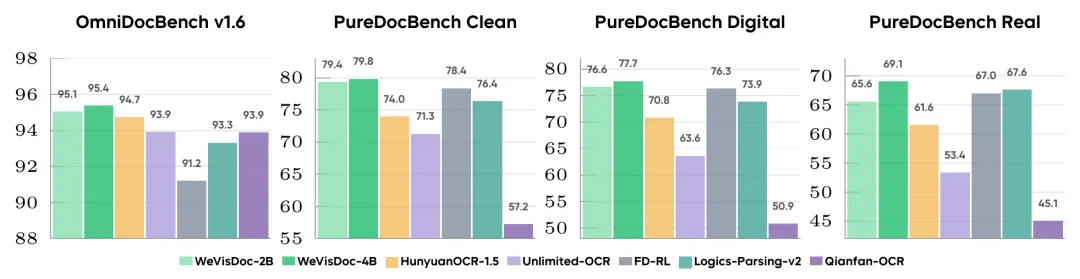
性能数据上,OmniDocBench v1.6 评测 WeVisDoc-4B 拿到 Overall 95.38,在对比的端到端解析器里排名居前;WeVisDoc-2B 拿到 95.06,同样领先。对比项里 dots.mocr(3B)92.57,FireRed-OCR(2B)93.26,HunyuanOCR-1.5(1B)94.74。PureDocBench 三个赛道平均,WeVisDoc-4B 拿到 75.54,WeVisDoc-2B 拿到 73.86,对比 FD-RL(4B)的 73.92。
和其他方案比
和传统多组件 pipeline 比。PaddleOCR + LayoutLM + 公式识别 + 表格识别这套搭法,工程链路长,组件之间要写胶水代码,版本升级要逐个适配。WeVisDoc 一个模型替换整条链路,部署、监控、升级都只在一处做。劣势是 WeVisDoc 不能像 pipeline 那样"单独替换某个组件"——如果某类页面解析效果不好,不能单独换表格识别模块,只能等模型迭代。
和阿里读光、腾讯 OCR 这些商业 API 比。商业 API 开箱即用、按调用计费,适合小量需求。WeVisDoc 要自己部署、要 GPU、要运维,但数据不出本地、调用不按量计费、可以离线跑,适合大批量或者数据敏感的场景。
和 dots.mocr、FireRed-OCR、HunyuanOCR 这些其他开源端到端方案比。WeVisDoc-4B 在 OmniDocBench v1.6 上 Overall 95.38 领先,性能数据有竞争力。HunyuanOCR-1.5 参数量更小(1B),在资源极紧的场景下更友好。FireRed-OCR(2B)和 WeVisDoc-2B 同参数量级,WeVisDoc-2B 的 Overall 95.06 比 FireRed-OCR 的 93.26 高出 1.8 个百分点。
适合什么人
适合做 RAG 和知识库的团队。文档解析是 RAG 的前置工序,WeVisDoc 直出 Markdown 的能力让"文档→向量库"这条链路简化一大截,不用再写 pipeline 拼装代码。
适合有批量文档数字化需求的团队。扫描件、PDF、合同、论文,几万到几十万页的量级,自建部署比按量调用商业 API 划算,数据也在自己手里。
适合对退化页面识别有要求的场景。拍照件、翻拍件、老扫描件,4B 版本在退化页面上的优势能体现出来。
几个门槛要说清楚。WeVisDoc 不是开箱即用的桌面工具,要懂 Python、vLLM、HuggingFace 生态,部署门槛比 acme.sh 这种 shell 脚本高一截。要有 GPU——2B 模型推理至少要一张 16G 显存的卡,4B 要更大,CPU 跑不动。项目较新,目前 299 Star、7 次提交,生产环境用要做好风险评估,不要把它当成熟方案直接接进核心链路。
几点收尾
WeVisDoc 占的是一个挺具体的位置:当你已经决定不把文档数据交给商业 OCR API、已经接受要自己部署一个模型服务、又不想从零拼一套多组件 pipeline 时,它给你提供了一个 Apache-2.0、有论文背书、OmniDocBench 95.38 分的端到端选项。对做 RAG、知识库、文档数字化的团队,值得把它加到评估清单里跑一遍 demo。
项目地址:https://github.com/Tencent/WeVisDoc 模型下载:https://huggingface.co/Tencent/WeVisDoc-4B 技术论文:https://arxiv.org/abs/2609.20423
Apache-2.0、2B/4B 双版本、OmniDocBench v1.6 Overall 95.38。文档解析 pipeline 的端到端替代方案。