ARTICLE · 1067009
AI 三巨头集体更新,用户却开始怀念旧模型了
GPT-6 Sol
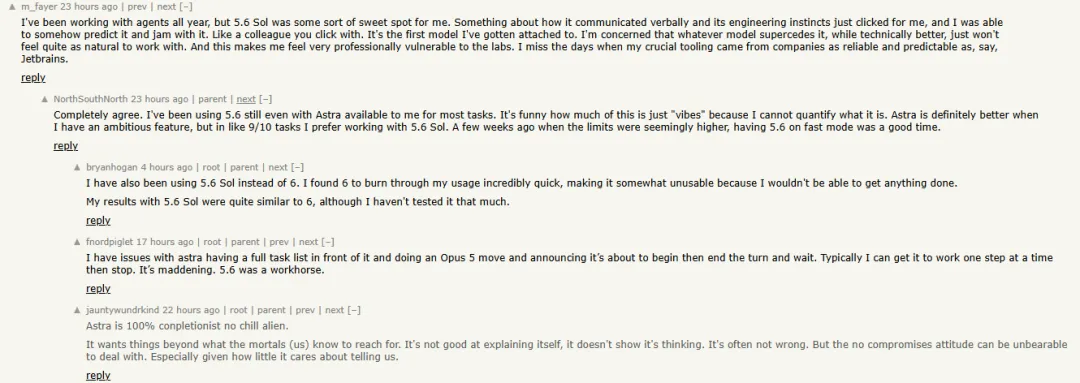
模型发布后,Hacker News 上有人说自己过去一直觉得 GPT-5.6 Sol 是一个很难替代的 "sweet spot",它的表达方式、工程直觉和自己的工作习惯很合拍,甚至有人直接把它称作 "workhorse"。明明已经可以用更新的模型,却还是愿意在日常工作里继续用 5.6 Sol。(https://news.ycombinator.com/item?id=49805509)
Claude Opus 5.5
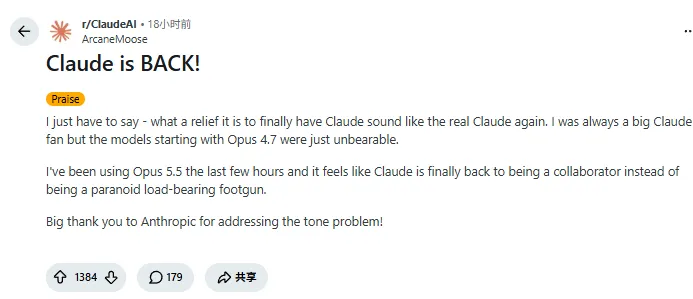
Anthropic 这边的反应甚至更直接。Claude Opus 5.5 发布后,Reddit 上很快出现了一篇标题叫 "Claude is BACK!" 的帖子,有用户说,新模型让自己重新找回了过去使用 Claude 时那种 "collaborator" 的感觉。类似的讨论还有不少:有人觉得模型终于又变得自然了,有人开始重新考虑此前因为体验变化而放弃的使用习惯。(https://www.reddit.com/r/ClaudeAI/comments/1wnpit2/claude_is_back/)
Grok 4.7
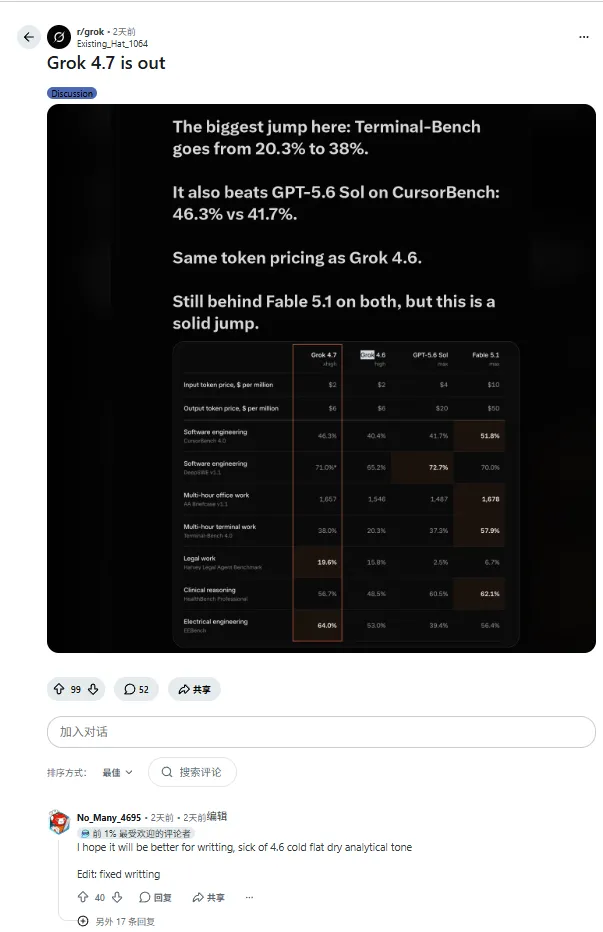
有人拿 4.6 和 4.7 做实际任务比较,关注的已经不只是 benchmark,而是同一个任务到底用了多少 token、花了多长时间,以及最终是不是更容易完成;也有人直接讨论自己更喜欢哪一代 Grok 的写作和聊天风格。(https://www.reddit.com/r/grok/comments/1wmguoy/grok_47_is_out/)
01 我怀念的,是无话不说
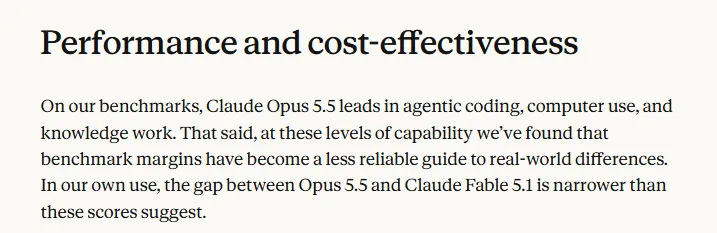
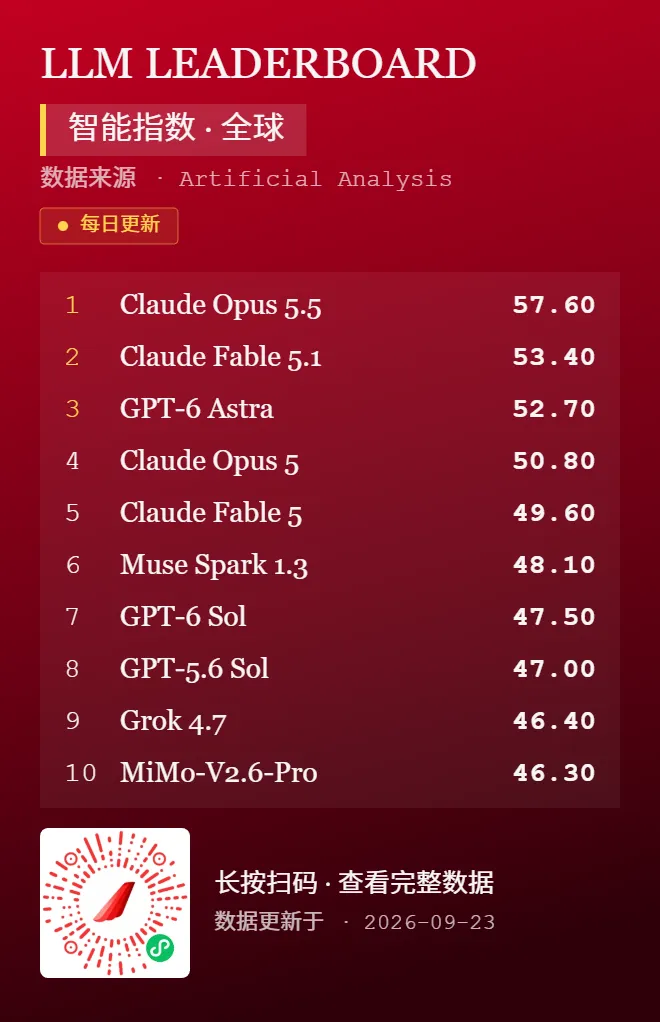
Anthropic 在 Opus 5.5 的发布材料里明确提到,到了这个能力水平,跑分上的细小差距已经越来越难直接代表真实工作中的差异——按官方自己的说法,内部实际用下来,Opus 5.5 和旗舰 Fable 5.1 的差距,比分数显示的更小。(https://www.anthropic.com/claude-opus-5-5)
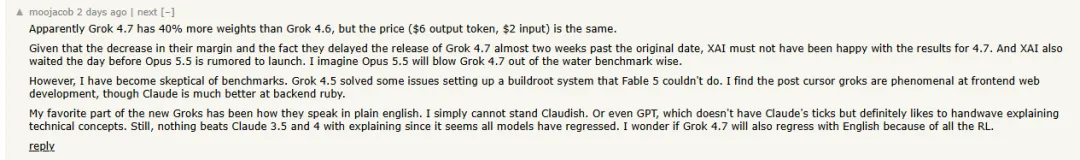
Hacker News 上关于 Grok 4.7 的讨论也出现了类似观点:真实工作中的任务表现,并不一定和榜单上的模型排序完全一致。(https://news.ycombinator.com/item?id=49788838)
02 我需要的,是各有所长