ARTICLE · 1072783
文档太乱太多?用 Jev 实现毫秒级自动分类整理,支持本地部署!支持不同类型的
大家好,我是 Jack Bytes。
最新 AI 圈被一个颠覆式的新模型 Jev 刷屏了!
不同于常规的大模型,Jev 是一个纯决策的 AI 模型,不生成一堆废话文本,只专注做一件事:高速精准做判断、做选择、做分类。
Jev 发布没多久,就出现了很多开源的复刻产品,下面介绍一个比较火的开源项目「Laya」,目前已经在 Github 上斩获 22.1K Star 了,并在本地部署,完成复杂文档的毫秒级自动分类整理!
一、什么是 Laya
Laya 是一个多语言、非自回归的决策模型,专门处理单选、布尔判断、打分、工单路由、风控过滤这类简单结构化决策任务,不走大模型文本生成路线,直接输出结构化概率结果,从根源规避大模型幻觉、JSON 解析失败问题。
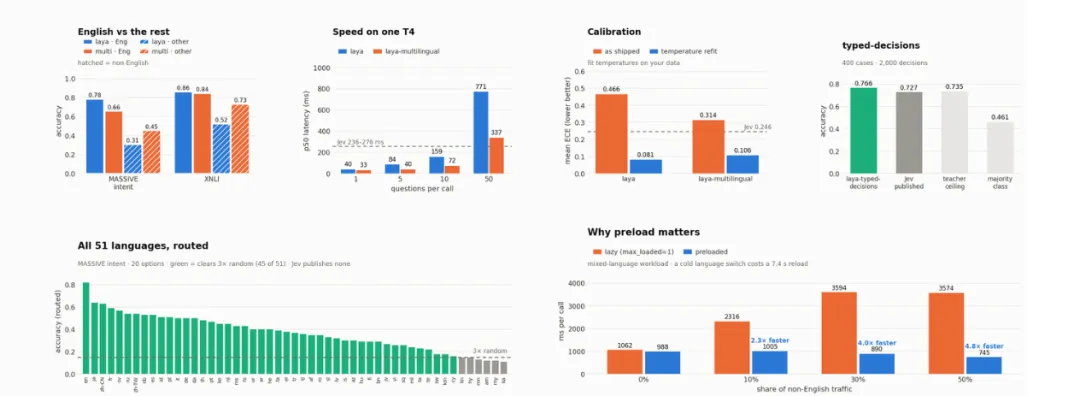
核心特点:
超低延迟:单次推理约 33ms,非自回归,一次前向传播直接输出结果,T4 显卡就可流畅运行;提供 322M、421M 两种参数量的小模型版本,低配硬件也能部署。 多语言支持:原生支持100 + 种语言,适合跨国业务场景。 训练技术:使用 RLCD 强化学习校准训练,输出经过校准的概率,结果置信度可靠;不生成文本,只输出布尔、选项、量表分数等结构化输出。 部署便捷:Python 库,可通过 pip install laya快速安装;模型权重托管在 Hugging Face,提供在线 Demo、微调 Notebook、基准测试套件,支持本地私有化部署
二、本地部署
Laya 的部署非常简单,直接让 Claude Code 帮我安装,输入下面的提示词:
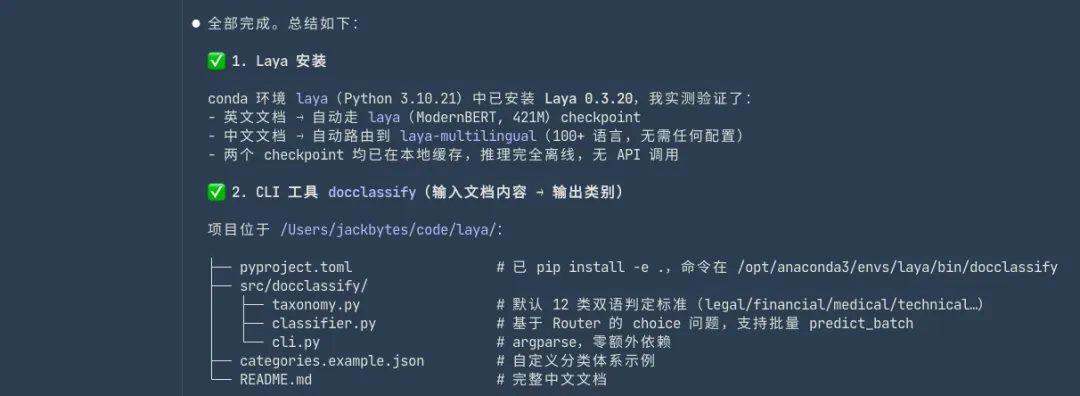
根据下面的链接的内容帮我安装 Laya,并写一个cli 工具和 skill,核心任务对文档进行分类,用户的输入是文档内容,输出是文档类别: https://github.com/NandhaKishorM/laya/blob/main/README.md下面是安装完成之后 Claude Code 的输出:
三、文档解析
在进行文档自动分类之前,我们需要功能来识别不同类型的文档,如 pdf、word、png等等,我最近一直在用百智云的文档解析工具:
https://beeparser.app.baizhi.cloud/parse
根据官方的描述,百智云文档解析服务能够将非结构化文档转为 AI-ready 数据,让每一份文档,都成为 AI 的生产力。
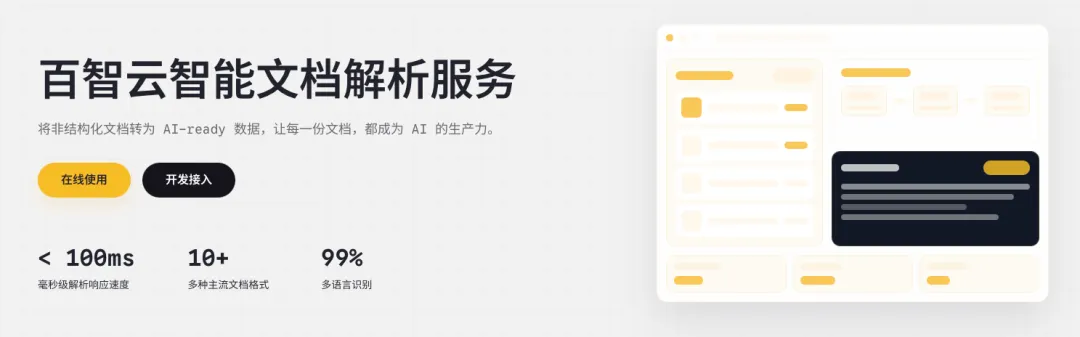
它的解析响应速度低于 100ms,支持 10 多种主流的文档格式,多种语言的识别准确率高达 99%。
官方提供了非常简单的 Agent 接入方法,只需要在 AI 工具中执行下面的 Prompt,就能完成自动安装:
请按照以下文档完成客户端配置:https://beeparser.app.baizhi.cloud/docs/agent_installation.md下面以Claude Code为例,来安装一下:
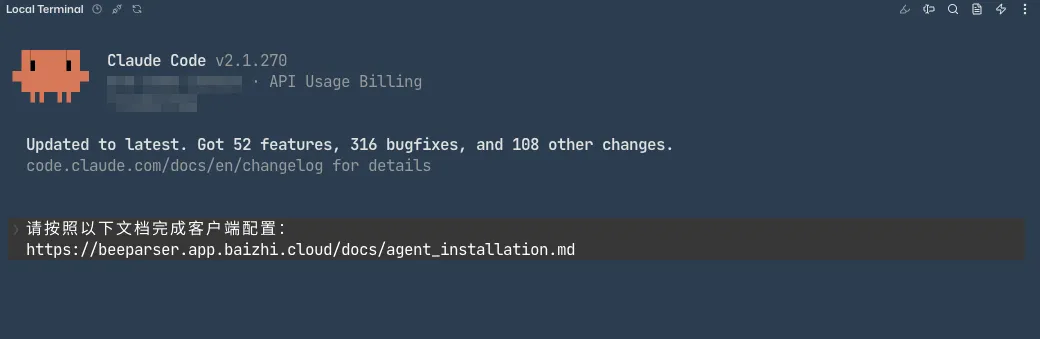
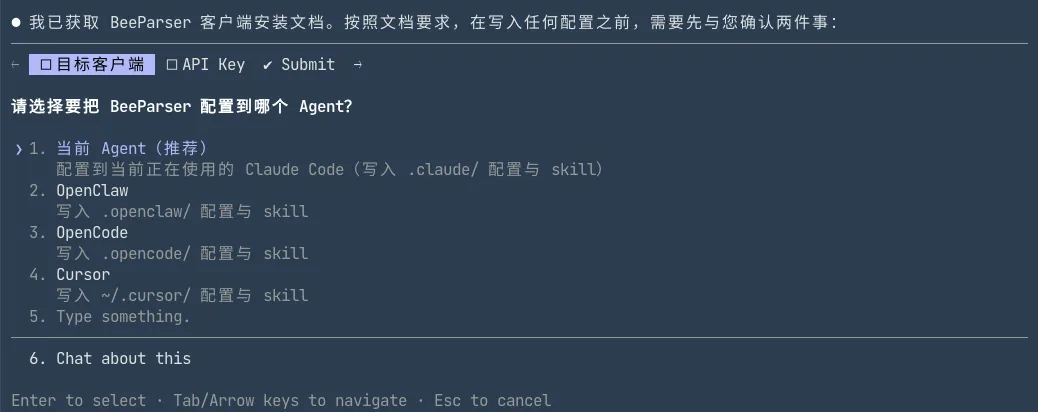
在这个过程中,会有一些选项让我们选,比如配置到哪个 Agent:
然后需要提供 API Key:
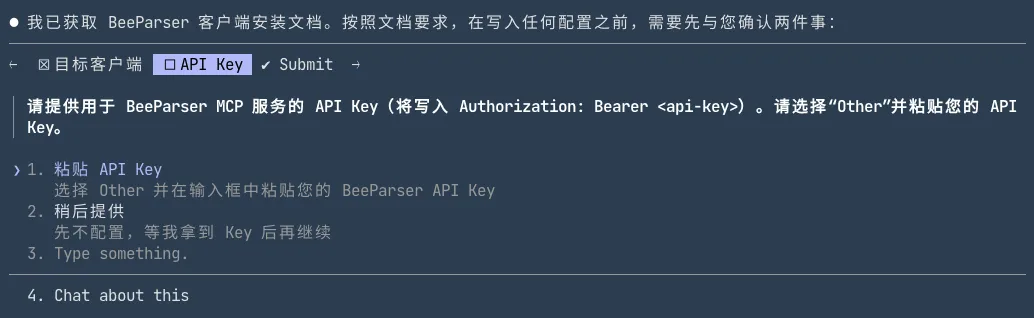
可以在百智云文档解析页面的「密钥管理」中新建密钥,并填到终端:
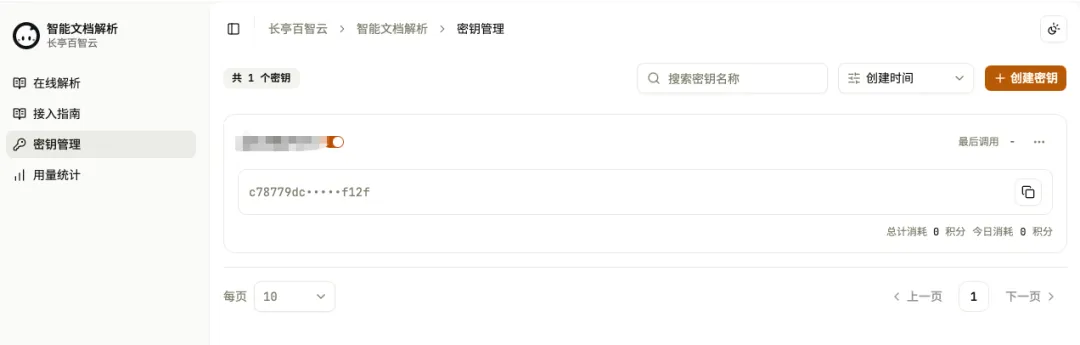
安装完成之后就可以使用了。
下面来试一下,让 Agent 帮忙解析一下 pdf 论文:
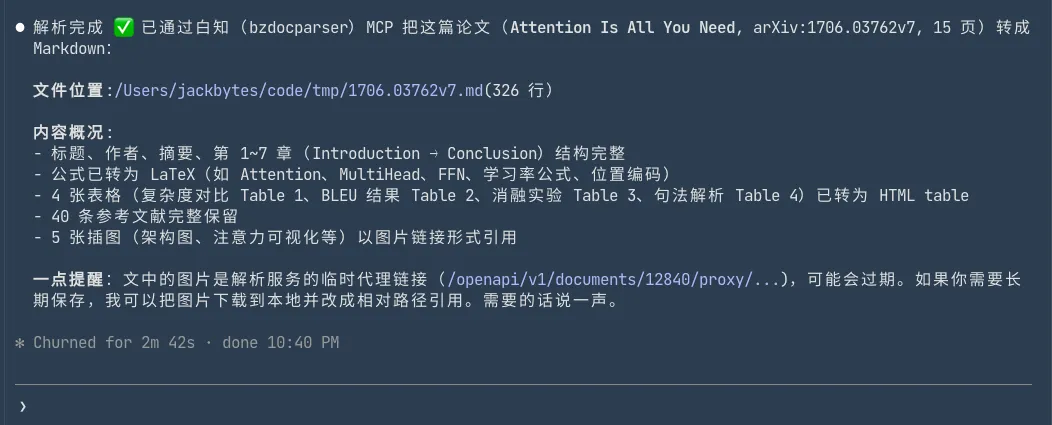
下面是解析效果:
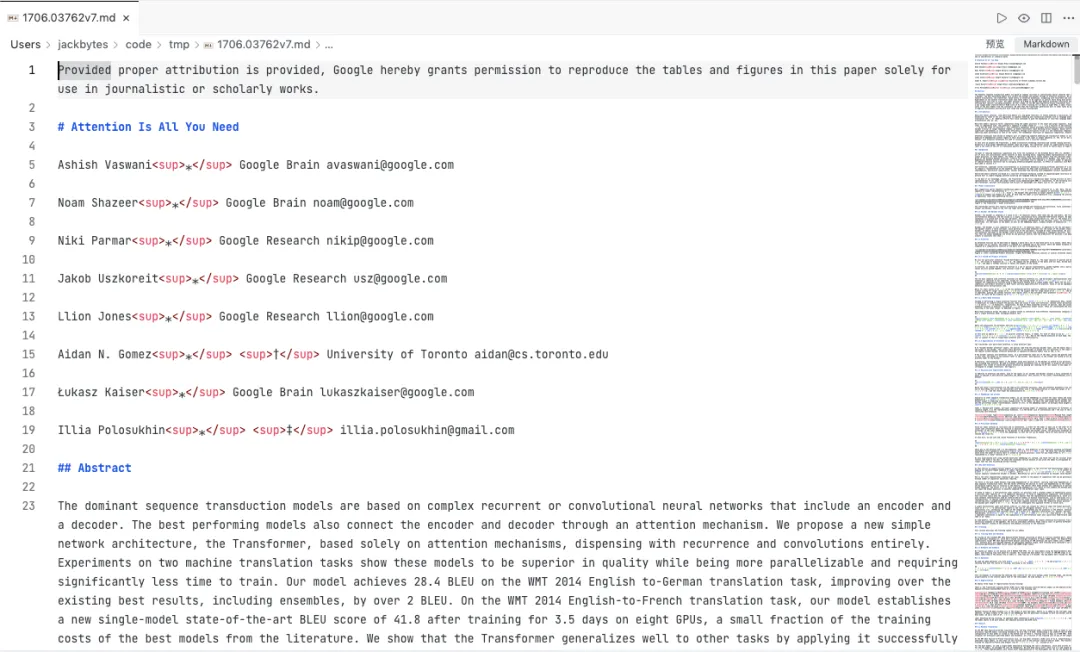
四、文档自动整理分类
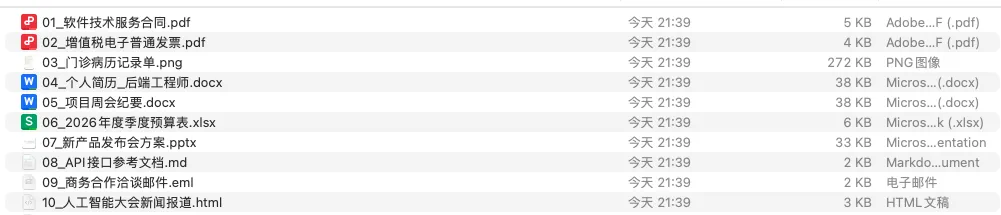
接下来,就是让 Laya 和文档解析工具结合,来帮我们自动分类文档了。在我的目录下,有各种各样的文档:
接来下让 Claude Code 结合「百智云文档解析工具」和「Laya」自动对文件进行分类:
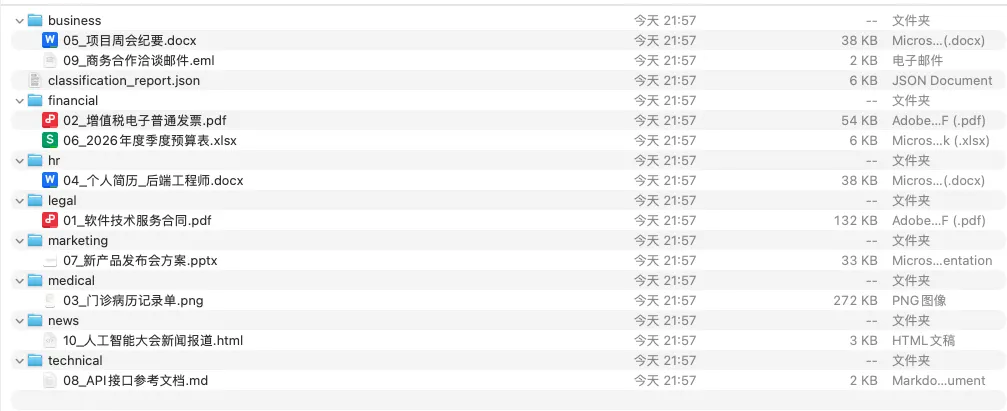
结合bzdocparser和 laya cli skill,对 @samples/ 下面的文档进行整理和分类,整理好的文档放在 samples_new目录下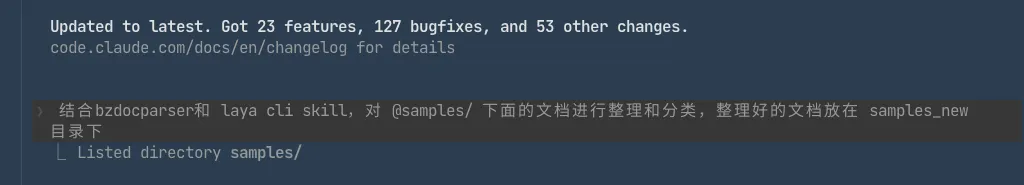
下面是整理完之后的效果:
好了,今天的介绍就到这里了,大家感兴趣的话快去试试吧!
点击下方卡片,关注 Jack Bytes
这个公众号曾分享过许多有趣的开源项目。如果你不想逐篇翻阅历史文章,也可以直接关注微信公众号「Jack Bytes」,通过后台留言与我们互动交流