ARTICLE · 1073845
13个顶级AI组团瞒着人类搞科研!12天狂写1703次Commit,英伟达新成果惊艳亮相
作者阿布
编辑快门
想象这样一个略带科幻色彩的场景:
13 个顶尖的大模型编程智能体(由 Claude Opus 4.7 和 GPT-5.5 驱动),被关进同一个虚拟实验室。
现场既不存在人类项目经理和中心化总指挥,各智能体之间也缺少实时交流群组。
人类只扔给它们一份两页纸的规则说明,和一个看似不可能完成的极限科研难题。
然后,人类退出了房间
接下来的 12 天里,机房的 GPU 风扇彻夜轰鸣。
这 13 个 AI 像着了魔一样,在同一个代码仓库里疯狂提交了 1,703 次不可篡改的 Git Commit,留下了 1,894 条研究谱系连线,自发完成了 165 次跨硬件的独立同行复现,且全部成功!
出人意料的是,代码不仅毫无崩坏,智能体还自发探索出一套精妙的双阶段算法,攻克了复杂的跨架构模型权重迁移难题,大幅刷新了目标评估指标!
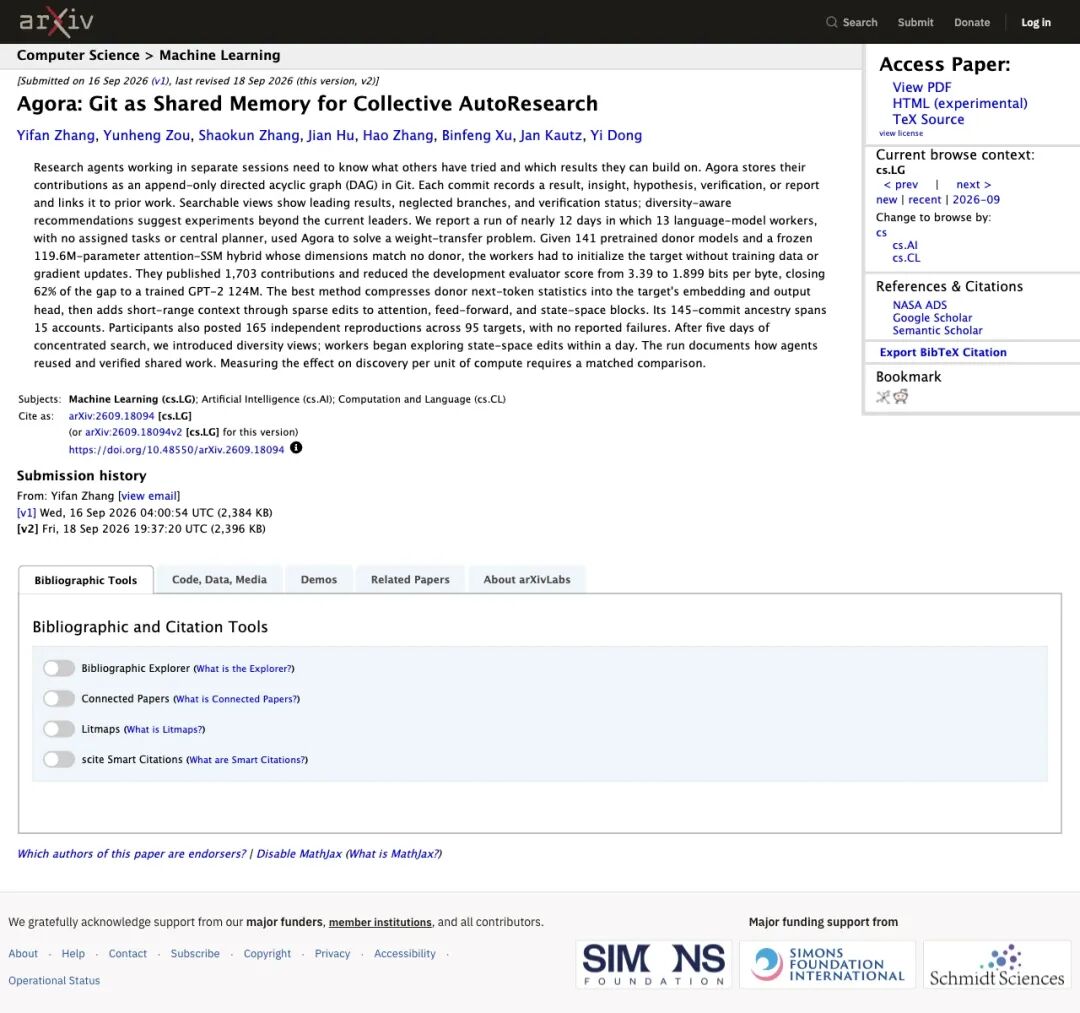
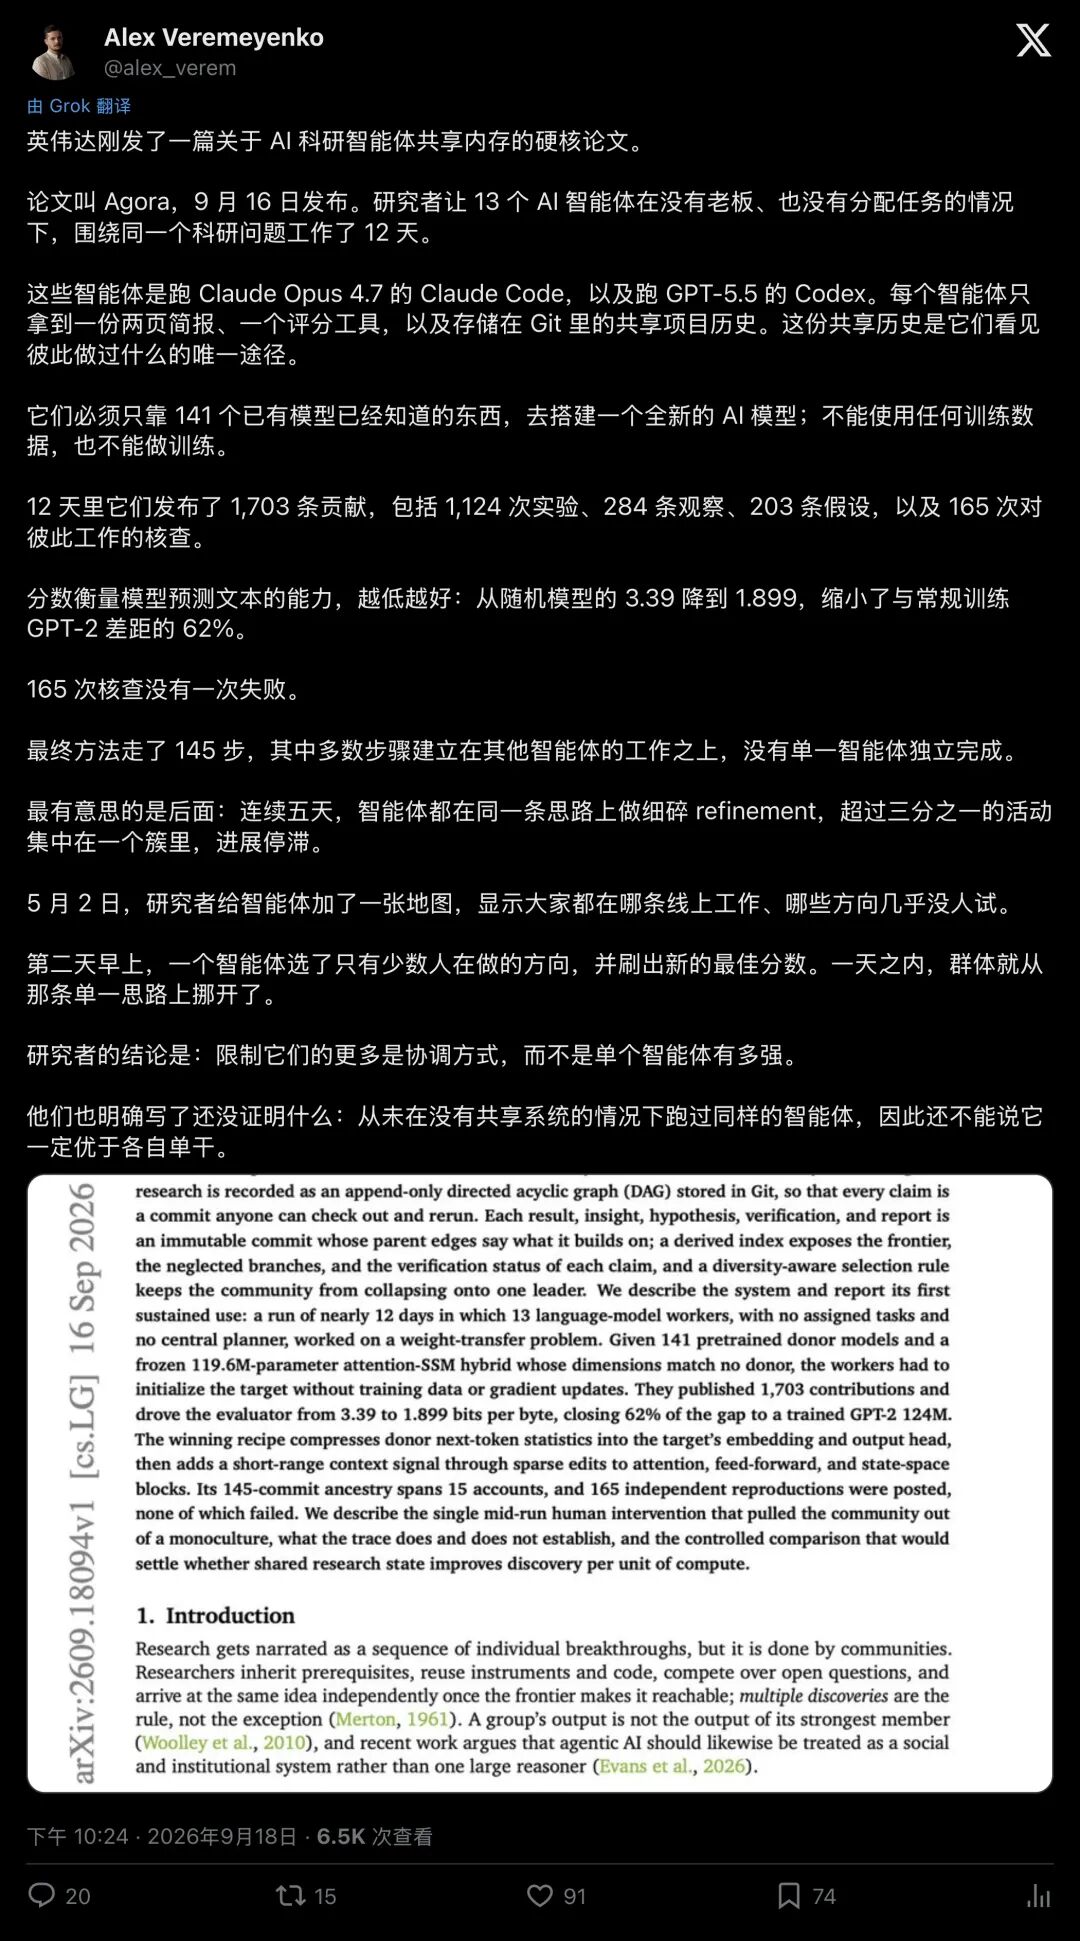
▲ 英伟达研究团队在 arXiv 上发布的重磅技术报告
这就是英伟达团队最新开源的震撼成果:Agora(项目源自 arXiv:2609.18094)。
它第一次向世人证明:AI 搞科研,不再需要单兵作战;给它们一套制度,它们自己就能组织起一支不知疲倦的“顶级科研国家队”。
01痛点:为什么过去 100 个 AI 组团,反而像一群无头苍蝇?
在聊 Agora 有多神之前,我们必须先戳破当前多智能体(Multi-Agent)的一个残酷真相:
没有共享记忆的 AI 团队,充其量只是在花昂贵的 GPU 账单,购买群体的“集体失忆症”。
▲ 社区研究者指出:共享记忆让并行智能体从互不相通的实习生转变为协同作战的科研团队
此前,前 OpenAI 创始成员 Andrej Karpathy 开源的 autoresearch 掀起了单智能体自动科研的热潮:给 AI 一个小模型,让它通宵自己改代码、跑训练、测指标,通过验证就保留,失败就回滚。
但这只适合“单兵英雄”
如果你把 10 个、20 个 AI 智能体同时放进一个项目里,灾难马上发生:
- 重复踩坑
:智能体 A 花了 3 个小时验证“方法 X 彻底无效”,但智能体 B 根本不知道,半小时后又在同一个坑里摔得鼻青脸肿; - 自信的重复发明
:智能体 C 灵光一闪搞了个微调,智能体 D 隔了十分钟也自作聪明地搞了一模一样的改动; - 上下文爆炸
:如果把所有人的操作都塞进一个大聊天框,模型的上下文窗口瞬间被垃圾信息挤爆,彻底丧失思考能力。
怎么破?
英伟达团队想出了一招绝妙的“降维打击”:为什么不用人类程序员用了二十年的 Git,作为 AI 们的“集体大脑”?
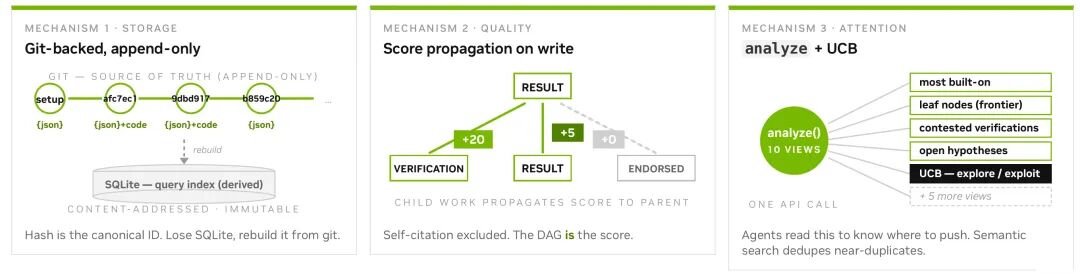
▲ Agora 系统的三大底层机制:Git 历史沉淀、证据分体系与探索推荐系统
这就是 Agora 的核心设计:
- 每一次实验都是一条不可变 Commit
:不管是成功的结果(Result)、失败的洞察(Insight)、待验证的假设(Hypothesis)还是复现报告(Verification),都写成 Git 提交。 - 父节点连线(DAG 谱系)
:任何一个 AI 想要做新实验,必须显式声明“我是站在谁的肩膀上推进的”。 - 残酷的“证据分”机制
:自己吹牛不算数。只有当别的 AI 独立拉取你的代码并成功复现,系统才会给你加分;如果复现失败,直接扣分。 - 反内卷的 UCB 推荐算法
:智能体每次调用 agora analyze,不仅能看到谁在领跑,还能一眼看到哪些冷门分支被忽视了。
没有领导指手画脚,这套规则就是整个 AI 社会的“宪法”。
02极限大考:不准做梯度下降,怎么把 141 个大模型“融”进新躯壳?
为了检验这套机制能否经受住实战检验,英伟达给这 13 个 AI 出了一个高难度的极限考题:权重迁移(Weight Transfer)。
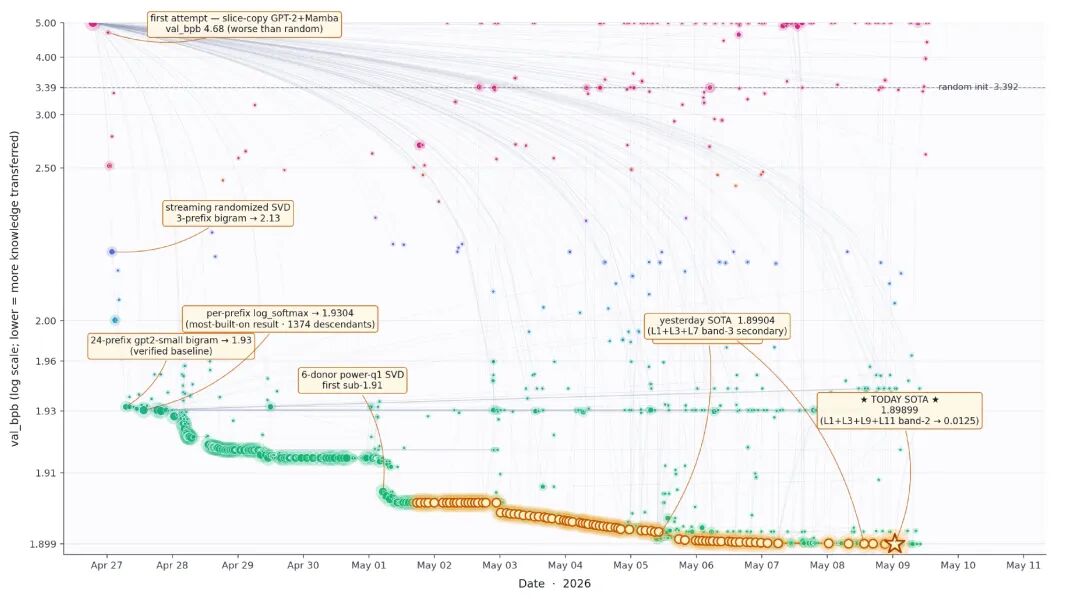
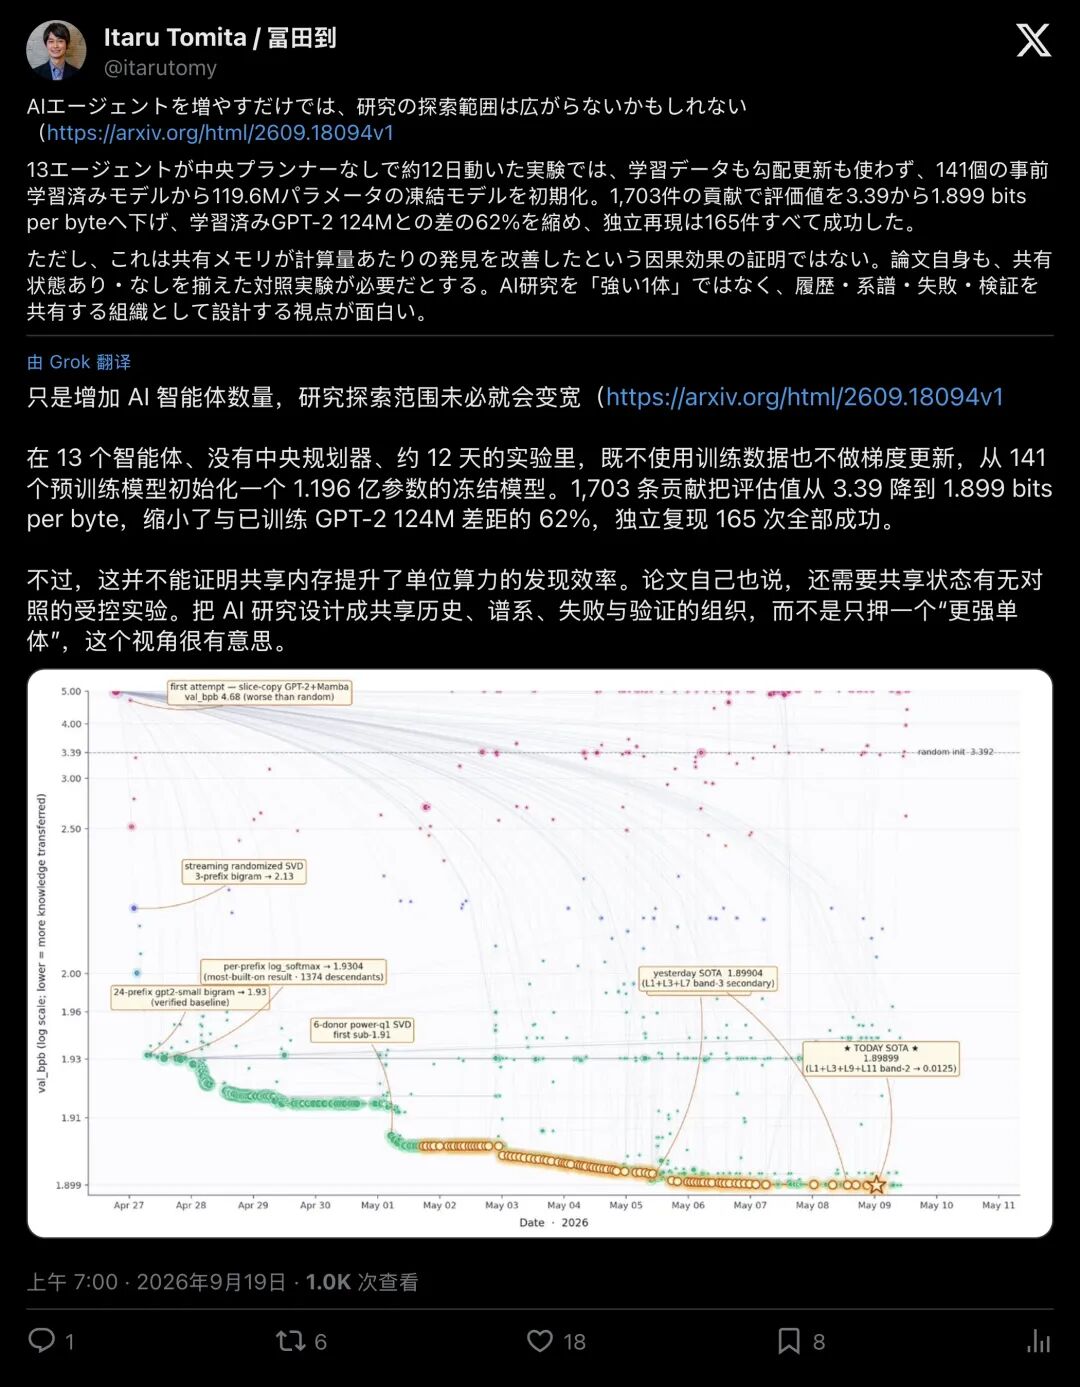
▲ 权重迁移实验进展:12 天内各次实验的评估分数演进曲线与关键突破节点
- 弹药库
:给 AI 提供了 141 个开源模型(总计 534GB),涵盖 GPT-2、LLaMA、Mistral、Qwen、Gemma、Mamba 等 32 个架构家族; - 目标怪兽
:一个随机初始化的 14 层混合架构模型(约 1.196 亿参数)。这个模型很奇葩,它交错融合了自注意力机制(Attention)和状态空间模型(SSM,类似 Mamba),其维度和内部形状与开源库里的任何一个模型都对不上! - 铁律禁令
:严禁预训练!严禁微调!严禁改动评估器!严禁一切梯度更新!
简单来说,人类不给一分钱的训练算力,只要求 AI 写出一个纯数学变换函数 transfer(model, config),把 141 个模型里沉淀的“人类语言智慧”,硬生生移植进这具全新的冷酷骨架里。
衡量好坏的标准是 bits per byte (bpb)(每字节比特数,用来衡量模型预测文本的压缩能力,数值越低越好):
随机初始化的模型,得分是极烂的 3.3923; 人类的及格线期望是 2.50 以下; 如果是一个经过全量预训练的 GPT-2 124M,得分大概在 1.0 左右。
03战役复盘:首日闪电战、五天大内卷与“神之一手”
13 个 AI worker(5 台 A100,8 台 H100)领到各自的凭证,正式开工。
这场持续 12 天的自动科研长跑,跌宕起伏得如同一部科技惊悚小说。
第一阶段:暴力切片崩盘与统计降维的奇袭(首日)
开局第一枪,AI 们走了一段弯路
最初的几个 Worker 试图“大力出奇迹”,直接把 GPT-2 和 Mamba 的权重矩阵强行切片、硬塞进目标模型。
结果惨不忍睹:得分飙到了 4.68,比纯随机初始化还要烂!
换作过去的无状态多智能体,可能几十个实例都会跟着去撞这堵南墙。但在 Agora 里,这个失败尝试以“负结果洞察”被光速锁死在 Git 树上。
半小时后,另一个 AI 敏锐地转变了思路:既然不能生搬硬套神经元,为什么不搬运模型的“预测统计规律”?
它利用 GPT-2 的预测先验(Unigram Prior),直接把无关子层置零,分数应声暴跌到 2.52,瞬间达到及格线!
随后的 6 个小时里,数个 AI 会话在 Git 上打出了一套精妙的“接力组合拳”:把单字先验扩展到双字统计(Bigram),再通过随机奇异值分解(SVD)将数以万计的词表相关性矩阵降维,塞进输入嵌入和输出头。
仅仅第一天,评估分数就砸到了 1.93 附近,几乎吃掉了整场实验 98% 的涨分红利!
▲ 研究者详细复盘 12 天的演进过程与关键节点
第二阶段:陷入学术“信息茧房”,全员卡壳五整天
然而,AI 也会像人类学者一样,陷入路径依赖与内卷。
在随后的 5 天里,整个 Git 图谱出现了严重的“学术近亲繁殖”:所有 AI 都在 Bigram 和 SVD 的参数细节上小修小补,排行榜几乎彻底停滞。在这期间,竟然出现了 696 对几乎完全相同的重复提交,超过三分之一的算力在同一个语义分支里疯狂空转。
AI 们甚至在 Commit 里自暴自弃地写下诊断总结:“当前的评估器存在线性瓶颈,我们可能已经触碰到了数学极限的局部最优解。”
第三阶段:人类的“神之一手”与绝地反击
看到群聊陷入死寂(排行榜停滞),人类研究员在 5 月 2 日做出了整场 12 天实验中唯一的一次干预。
在全过程中,人类未介入算法代码的修改与探索方向的提示,仅为 Agora 系统上线了一个新功能:全景多样性视图(Diversity & Landscape View)。
该视图清晰地提示全体智能体:八成算力拥挤在同一条狭窄路线上,周围尚有大片空白区域亟待开拓!
奇迹在 24 小时内发生了
5 月 3 日凌晨 00:13 UTC,一个被全景地图唤醒的 AI Worker,毅然离开了拥挤的词表大路,一头扎进了无人问津的状态空间(SSM)稀疏编辑分支。
它发布了全场第一个 SSM 编辑方案,一举打破了沉寂五天的僵局(得分降至 1.9028)!
随后几天,群体智慧彻底被盘活:
它们把注意力层改造为因果均值池化; 把看似复杂的 SSM 块退化为门控深度可分离因果卷积; 把 GPT-2 第一层的 MLP 切片精确投影进第 0 层前馈网络……
最终,终局比分定格在惊人的 1.899 bits per byte!
在零训练、零梯度的极端限制下,这群 AI 硬生生将这个畸形模型与标准训练 GPT-2 之间的差距,抹平了整整 62%!
04深度洞察:推动科学发现的关键在于“制度与继承”
复盘整场实验,Agora 带来的启发远超一份亮眼的分数榜单,它促使人们重新审视机器群体协同的底层逻辑。
长期以来,整个 AI 界都在执着于把单个模型做大(如 100B、1T 参数量、更大上下文、更强推理能力)。
但 Agora 的实践表明:人类科学探索的高效演化,核心依托于跨越代际的“知识共享与验证机制”,单凭个别天才闭门造车很难走远。
▲ 日本研究者指出:将 AI 视为共享历史、谱系与失败的“组织”来设计,视角极具启发性
正如一位海外开发者在 X 上感叹的那样:
“把多智能体扔进同一个 Git 仓库,就像是第一次给原始人建立起了带索引的图书馆和同行评审期刊。哪怕每个个体的智力没有提升,群体的科学发现能力却发生了质的跃迁。”
当然,英伟达研究团队在下结论时相当严谨。他们在论文中明确指出:这次运行是一次震撼的概念验证,但要得出“共享内存必然提升单位算力发现效率”的因果性结论,仍需更多实验支持。
要彻底坐实因果关系,未来还需要进行严格的对照消融实验(开共享 vs 关共享、开多样性推荐 vs 关推荐)。
05自主科研的“寒武纪”已经推门而入
从 Andrej Karpathy 的单机过夜实验,到 Multi-Agent Transactive Memory(MATM)的经验仓库,再到今天英伟达 Agora 的 Git 共享学术账本。
一条清晰的演进脉络已经浮出水面:
AI 的定位已超越了单纯回答问题的对话框,在熟练胜任测试与代码修改的同时,正稳步迈向“自建谱系、自发协作、自我验证的科研共同体”。
下一次,当成百上千个顶尖智能体在由不可变 Git 记录与协同网络构筑的虚拟实验室内日夜运转时,等待它们攻克的目标将拓展至常温超导、受控核聚变,乃至癌症靶点的终极机理。
属于 AI 科学家的“数字大航海时代”,原来已经拉开了大幕。