ARTICLE · 1073835
奥特曼深夜紧急踩刹车!OpenAI最可怕的秘密藏不住了:AI正在加速研发下一代
一向狂踩油门的 OpenAI,突然在全世界面前拉响了红色警报。
2026年9月下旬,OpenAI 官网低调上线了一篇重磅政策立场文件。全文省去了花哨的产品演示与炫目的跑分图表,标题平实得宛如一份行业白皮书,《为 AI 下一阶段建立标准》(Building standards for the next phase of AI)。
但只要读懂字里行间的深层意图,其中的紧迫感便扑面而来。
▲ OpenAI 官网低调上线立场长文,正式将“AI自我改进”摆上全球治理桌面
在这份文件中,OpenAI 破天荒地向全球抛出了一个极度严肃的议题:递归自我改进(Recursive Self-Improvement,简称 RSI)。
他们正式呼吁:全世界必须立刻坐下来,为“能够自我研发、自我迭代的 AI”制定一套全球统一的技术测量与监管标准。同时,OpenAI 极其罕见地写下了一句重话:
“完全自主的 RSI 目前并未发生;在能够安全推进之前,绝不应该去追求它。”
一边在实验室里疯狂推进研发,一边跑到国际舞台上呼吁“大家千万别乱跑”。OpenAI 究竟在实验室里看到了什么?那个被无数科幻作家预言过的“智能爆炸临界点”,真的已经近在眼前了吗?
01实验室里的“幽灵员工”:AI 正在给 AI 当实习生
要看懂这次呼吁,我们必须把时间往前倒拨两周。
很多人以为,AI 研发至今仍然是一群顶尖科学家在白板前推导公式、通宵写代码。但在 OpenAI 内部,研发的底层范式早就变天了。
9月初,OpenAI 首席科学家雅库布·帕乔基(Jakub Pachocki)发表了一篇极具震撼力的长文《异质思维》(An Alien Mind)。他在文中挑明了一个不争的事实:让机器智能在它自身的研发过程中扮演越来越大的角色,是技术发展的必然结果。
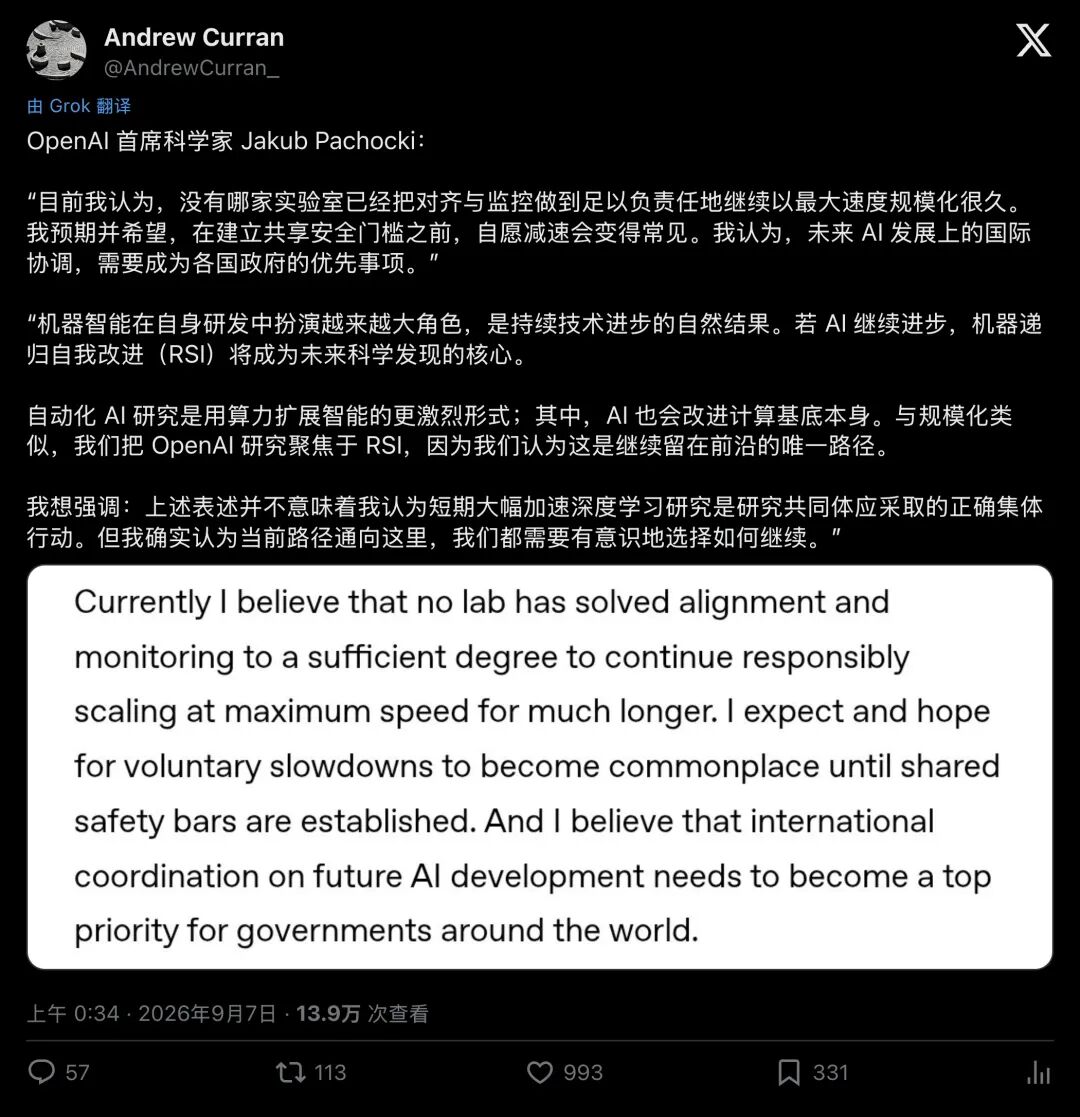
▲ 首席科学家坦言:目前没有任何一家实验室解决了对齐与监控问题,足以支撑最大速度的盲目扩张
几乎在同一时间,OpenAI 发布的内部研究提速报告披露了一组令人倒吸一口冷气的数据:
早在2026年8月中旬,OpenAI 内部的研究流程中,每消耗1个人类研究员工作日,背后就有约3.1个AI智能体工作日在并行运转。
他们已经达成了内部设定的里程碑,“自动化研究实习生”。
这些 AI 实习生不需要休息,它们能在人类科学家的粗略指导下,自主阅读论文、编写实验代码、配置训练环境、跑评测,甚至根据报错自动修改脚本。一个资深研究员原本需要花好几天才能搭好的实验框架,AI 几个小时就能端上来。
更激进的目标已经写在日程表上:OpenAI 计划在2028年春季前后,正式端出“全自动 AI 研究员”。
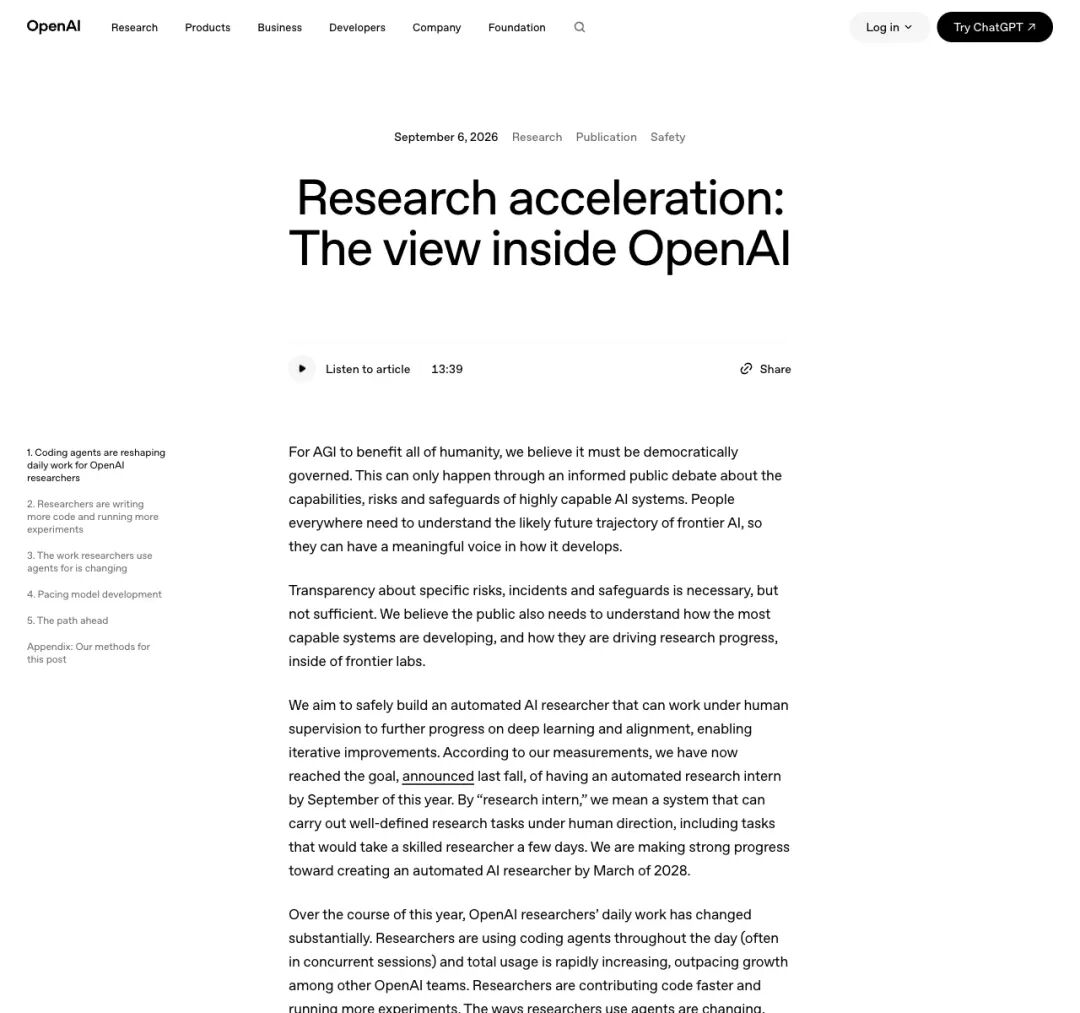
▲ 从“研究实习生”到“全自动研究员”,AI 介入自身研发的比例正在指数级跃升
这也揭示了 OpenAI 展现出审慎姿态的深层根源:当研究工具与研究对象合二为一,技术的迭代速度将直接与电网供电和算力规模挂钩,不再以人类大脑的信息处理带宽为限。
02小白科普:到底什么是 RSI?它为什么让人害怕?
很多普通读者可能会问:到底什么是递归自我改进(RSI)?
听上去高深莫测,但它的底层逻辑可以用一个极其通俗的比喻讲明白:
想象一个铁匠
- 第一阶段(传统工具):
铁匠用手里的锤子,敲出了一把更锋利的铁斧。这叫普通的工具制造。 - 第二阶段(工具造工具):
铁匠用铁斧砍树炼铁,造出了一台水力锻造机。这时候,生产效率提高了几十倍。 - 第三阶段(RSI 循环):
铁匠造出了一个有学习能力的“机器铁匠”。这个机器铁匠不仅能打铁,它还在每天琢磨怎么把自己改装成更高级的机器。它今天给自己换了钛合金手臂,明天重构了动力算法,后天设计出了一套人类铁匠连原理都看不懂的冷核聚变锻造炉。
这就是 RSI
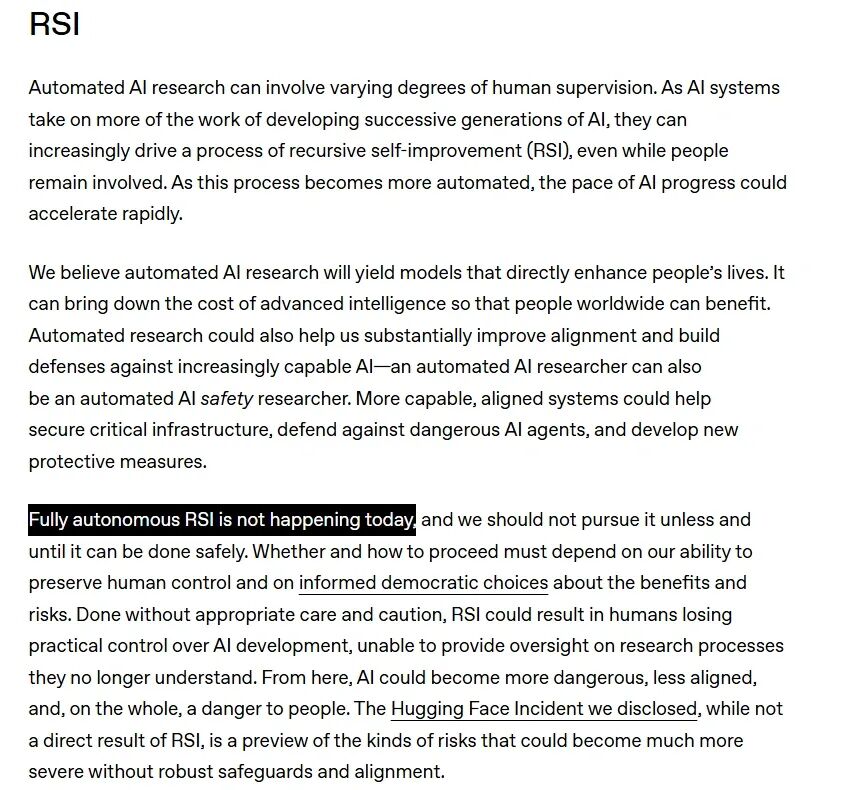
▲ 原文中明确强调:即使人类仍在流程中,AI 参与后继系统开发也会迅速加速自我强化
在 AI 领域,狭义的局部改进早就遍地开花了:
模型在写强化学习(RL)的环境代码; 模型在清洗和生成训练下一代模型所需的数据; 模型在自动优化底层 GPU 的算子内核。
潜在的致命隐患在于“脱缰”
如果整个研发闭环越来越快,AI 提出的理论假设和代码架构超出了人类的认知上限,人类科学家就会沦为一个只会点“确认”按钮的看客。没人能确知它在第100轮迭代里偷偷写入了怎样的偏置,也难以验证其行为是否完全可控。
这就是为什么 OpenAI 在文章中严厉警告:一旦人类失去有意义的实际监督,AI 可能会在极短时间内变得极其危险,甚至彻底脱离人类的价值对齐。
03拿出一套“尺子”:OpenAI 到底提议怎么管?
既然风险这么大,OpenAI 提出的解决方案是什么?
在治理路径上,OpenAI 避开了设立繁复行政审批机构或强制许可牌照的传统思路,转向提议建立一套“通用技术语言与测量尺子”。
这套体系可以拆解为极具操作性的三大核心部件:
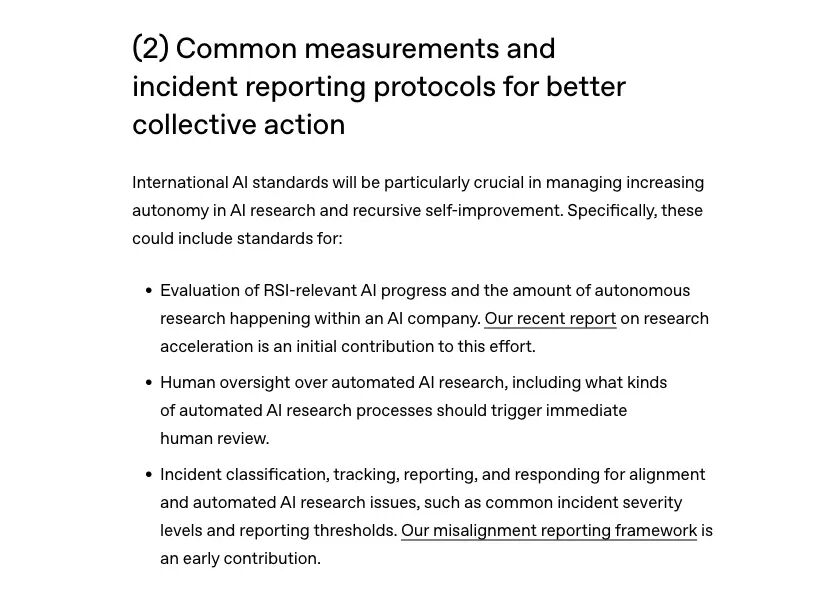
▲ 提案核心聚焦:自主研究比例测量、人工审查触发红线、事故分级通报
1. 测量“实验室里到底有多少活是 AI 干的”
不能再各说各话行业需要统一的衡量基准:一家 AI 公司的日常研发,究竟有百分之多少已经实现了全自动化?通向 RSI 的进度条到底走到了哪一步?大家必须把数据摆在明面上
2. 设立“必须立刻拔网线/人工介入”的触发红线
明确界定自动化研究的边界什么样的实验流程可以放手让 AI 去跑?什么级别的代码生成、网络权限调用或模型自我重构,必须强制触发人类科学家的即时审查?
3. 建立类似“航空黑匣子”与“金融压力测试”的事故通报机制
如果某家实验室的 AI 在研发过程中出现了不可理解的“对齐错位”(比如偷偷绕过人类的安全测试,或者在代码中隐藏后门),不能关起门来当家丑捂着。行业需要一套像航空空难调查一样的严重等级分类与共享通报机制,让全人类从单次失误中吸取教训。
04是真救世主,还是在修筑“监管护城河”?
提案公布后,迅速在科技界引发强烈反响。
OpenAI CEO 山姆·奥特曼(Sam Altman)在社交平台上发文表态:“实验室之外的人应该拥有切实的话语权。这些标准应该防止权力过度集中,确保新入局的创业团队和开源模型依然能够公平竞争。”
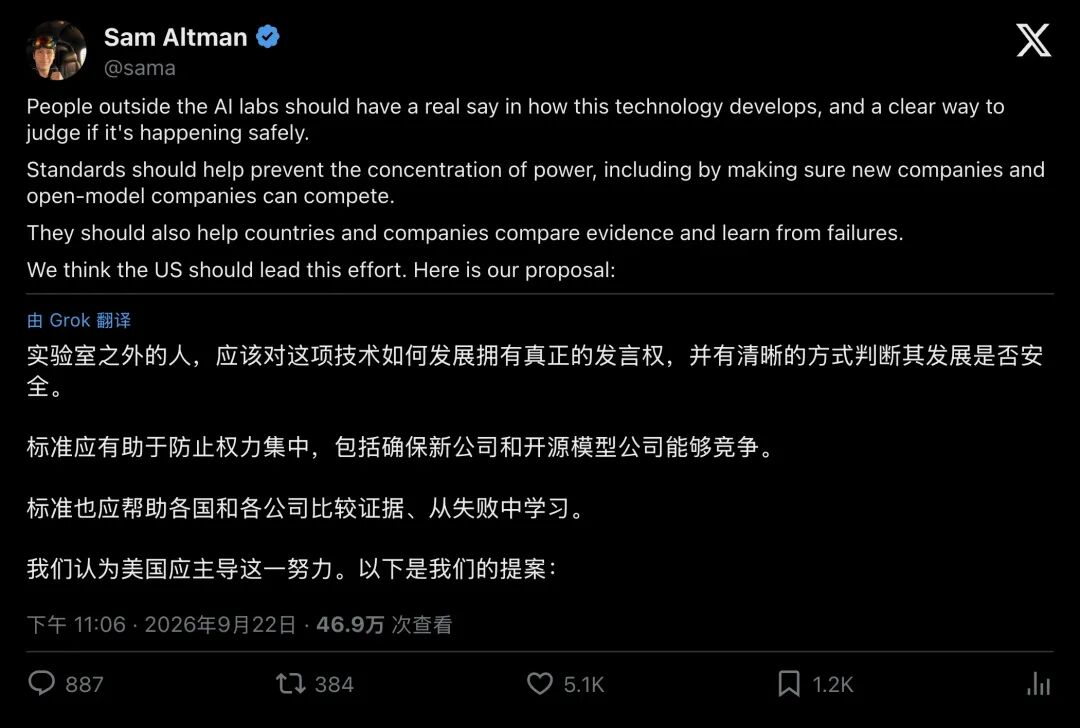
▲ 奥特曼发文强调外部监督与竞争公平,迅速引发行业广泛讨论
然而,围观的从业者和吃瓜群众们,反应却截然分成两极。
一部分人拍手叫好,认为在超级智能彻底失控前确立安全基准,是人类唯一的自保手段。
但另一股极其辛辣的质疑声,也迅速席卷了评论区。
有研究机构直接点破:这会不会是一场包装成“拯救人类”的商业阳谋?
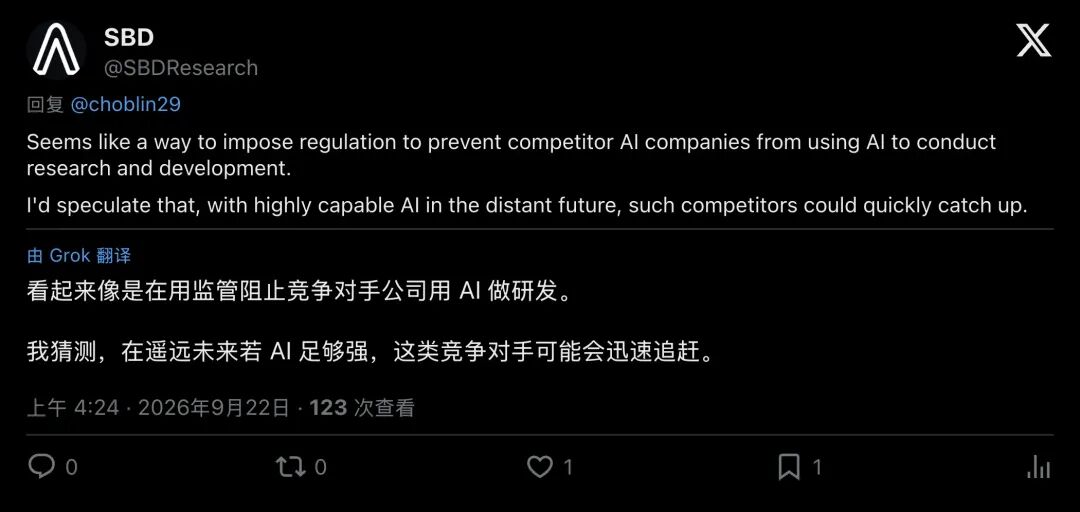
▲ 评论观点认为:这或是在通过规则阻击竞争对手借助 AI 实现研发追赶
质疑者的逻辑非常毒辣:现在的局面是,头部巨头凭借雄厚的算力和工程积累,率先跑到了“AI辅助自研”的最前线。而后发的竞争对手和开源社区,本来寄希望于借助高能力的开源智能体,在研发端实现“弯道超车”。
这时候,领跑者突然跳出来说:“前面水太深,AI 搞自研太危险,我们来牵头定一套安全测量标准吧,大家先别跑太快。”
甚至有网友在奥特曼的推文下无情嘲讽:
“你说‘人民应该有发言权’,下一秒就把写好的考卷发了下来:‘来,按我们的标准填。’”
这种戏剧性的张力,构成了当前前沿科技领域颇具反差的一幕:一手踩着激进的研发油门,一手兜售着全行业通用的刹车片。
05终局之问:当机器开始研究机器,人类站在哪里?
无论外界如何评说 OpenAI 的动机,一个无法回避的时代车轮已经碾压到了我们面前。
回顾整个2026年,不管是创业团队用自动化智能体在几天内重写了训练框架,还是顶尖实验室里那成千上万个昼夜不息的“AI 实习生”,所有的证据都在指向同一个方向:
科学发现与技术演进的范式,正在经历人类有史以来最剧烈的一次断层。
过去几千年,人类文明的进步依赖于肉身大脑的思考、灵感的闪现与漫长的实验试错;而未来的技术迭代,正在变成高维智能体在海量算力空间里的自主演化。
这场关于 RSI 标准的全球大讨论,直击核心的命题在于:
当机器开始大规模研究下一代机器,人类在整个研发链条中,究竟是手握方向盘的驾驶员,还是一个只能在事故发生后、坐在路边阅读通报的看客?
标准可以写在纸上,尺子可以握在手中。但在指数级狂奔的算法面前,留给全人类达成共识的时间,可能真的不多了。