ARTICLE · 1075142
AI 测试工具白买了?问题不在工具,在这 4 个环节
"
工具跑通了却没人用,病根从来不在技术,在使用者的流程里。
设想一个场景:你花两周搭了一个 AI 用例生成工具。技术上完全跑通——需求文档丢进去,半分钟吐出一批结构化用例。你兴冲冲发给同事,她试了一次,回了一句:「挺好的,但我还是自己写比较快。」
这句话很扎人,但她说得对。
这是测试圈一位工程师公开分享过的真实迭代经历(我把他的三版改造过程整理成了诊断框架和改造清单)。他的第一版工具就撞上了上面这堵墙,改了三版之后,同一个工具从「没人用」变成了团队「每周用三次以上」。中间的差别,不在技术,在四个改造动作。
「你的工具如果只解决了对方工作流中的一个环节,剩下的环节还得手动做,那对方切换到工具上的成本,可能比继续手动做还高。」
📌 本文看点
01
病根诊断:切换成本
02
四个改造动作
03
动手前五问
DIAGNOSIS
先诊断:工具没人用,病根在哪
看工具之前,先看人的完整流程。
案例里那位同事拿到需求后是这样写用例的:先花五分钟通读需求、在关键段落画线;然后打开团队的 Excel 模板,按模块填用例;写的过程中翻看历史用例,看看类似功能上次怎么测的;写完还要找开发确认几个边界场景。
而第一版工具帮她省的,只有第一步「读需求、想测试点」。后面的翻历史用例、找开发确认、填团队模板,一样没少。对她来说,用这个工具等于换个地方干活,还额外多了一个格式转换的活——工具输出的 JSON 得她自己转成团队模板。
问题于是清楚了。很多人做工具时有一个视角错位:从「AI 能做什么」出发设计,而不是从「使用者卡在哪」出发。「技术上跑通」回答的是前一个问题,「有人用」回答的是后一个问题。两个问题不一样,前者的答案再漂亮,也兑现不了后者。
诊断完成,改造就从同事流程里断掉的环节下手。这个案例里真正有效的改动,集中在四件事上。
FIX 01
对齐团队模板,补上「最后一公里」
第一版输出的是工具作者自定义的 JSON 格式。同事拿到手,还得手动转成团队模板——这一步把工具省下的时间全部吃掉了。
改法不复杂:把团队的 Excel 模板要过来,分析字段结构(用例编号、模块、场景描述、前置条件、操作步骤、预期结果、优先级、备注),给工具加一个导出模块,直接按模板格式输出 Excel。
效果:同事的态度从「不用」变成了「偶尔用」。进步了,但只解决了转换成本,使用深度还不够。
这一步值得带走的是一条判断规则:工具的输出格式,应该等于使用者下一步动作直接要用的格式。你的工具给的是「AI 觉得合理的格式」,还是「对方打开就能用的格式」?两者差的那段路,就叫最后一公里——它短,但足以决定工具是生产力还是摆设。
FIX 02
把历史用例喂进去,但必须是「筛过的」
同事写用例时会翻历史用例,看类似功能以前怎么测。工具只看当前的需求文档,完全不知道这个团队的测试经验。
改法:在拆完测试维度之后,加一步——让 AI 先去用例库搜同一模块的历史用例,把相关的挑出来,喂给「写用例」那一步当参考。
效果比预期好。有了历史用例做参照,AI 不再只根据需求文档的字面内容「猜」测试点,而是结合团队过去的测法来写。案例里同事的评价是:「看着像是我们组的人写的」。
但这一步藏着一个反直觉的坑:参考数据不是越多越好。案例作者试过把两百条历史用例一股脑塞进去,结果模型的注意力被稀释,生成的用例反而比不给参考还差。有效的做法是加一层筛选:只取和当前功能相关的、近三个月的、最多二十条。筛选逻辑本身只是十几行代码,效果却天差地别。
还有一个失败分支要提前想好:如果用例库接口挂了、或者这个模块根本没有历史用例,流程不能直接断。案例里的处理是降级——搜不到就跳过参考环节,仅基于需求文档生成,同时在结果里标注「本次无历史参考」,提醒人工复核时多留心。参考是增强项,不是依赖项,工具不能因为一个增强步骤失效就整体不可用。
给 AI 喂上下文,「筛过的好」优于「全量的大」
FIX 03
加一道覆盖率自查:不需要完美,只需要比手动快
这个改造是被一个具体遗漏逼出来的。案例里,AI 生成的登录模块用例漏掉了「记住登录态」——需求文档里明明写了。原因不是前面提过的「注意力衰减」(排在前面的测试点被后面的冲掉),而是理解偏差:模型把「记住登录态」归成了登录功能的子项,而不是一个独立测试场景。理解偏差靠调整生成顺序救不回来,得靠单独的自查环节。
改法:在最终输出之前加一步——让 AI 拿着已生成的用例清单,回头逐段对照需求文档原文,检查「这一段有没有对应的用例覆盖」,没有的就标注出来,附上遗漏说明和补充建议。
要给这个自查一个准确的预期:它不是百分之百准,会漏报,也会误报。但案例作者的判断值得记住——即使只有七成准确率,它帮你发现遗漏的速度也比逐条手动核对快。AI 自查不需要完美,只需要比你手动检查快,就够了。
!踩坑提示 🕳
自查标出来的问题不能直接信,流程上要经过「标注 → 人工判断 → 确认缺失再补用例」。自查负责省时间,判断权还在人手上。
FIX 04
让 AI 说出「我不确定」
案例作者复盘时发现一个规律:AI 生成的用例大概能覆盖七八成的场景,剩下两三成它想不到——要么是业务规则太隐蔽(比如「连续输错三次密码锁定账号,但 VIP 用户锁定后可以自助解锁」),要么是跨模块联动(比如「登录失败的同时触发风控告警」)。
这些场景 AI 想不到,因为它没有业务上下文。但它知道「这里我拿不准」——前提是你给它一个说出来的机会。
改法:生成完不直接导出,先让 AI 交一份不确定区域清单。人工花两分钟扫一遍,该补充的补充,然后再导出。按案例里的数据,这份清单平均列 3~5 条,其中大约 2 条是人确实需要补的。
这个环节的价值不在补充了多少条,而在机制本身:一个诚实的「我不确定」,比一个自信的「我全覆盖了」有价值得多。前者指给你看风险在哪,后者让你毫无防备。
「不确定区域」具体怎么让 AI 报?给它三个固定问句就够了:
「哪些需求描述你做了假设但不确定假设是否成立?」
「哪些业务规则你没有足够上下文判断?」
「哪些跨模块联动你不确定要不要测?」
要求 AI 逐条回答,没把握的写「没把握」,确实没有就返回空——并明确告诉它不要为了显得全面而编造不确定项,那样只会浪费人工复核的时间。
PIPELINE
四个改造做完,完整链路长这样
需求文档输入 → 拆测试维度(人工确认后再往下走)
搜历史用例 → 筛出相关且近期的,最多 20 条做参考
按维度 + 历史参考写用例(测试点多时自动分批生成)
覆盖率自查 → 标注需求文档中未被覆盖的段落
人工补充「不确定区域」(约两分钟)
按团队模板导出 Excel
确认后写入用例平台
单次耗时从第一版的「30 秒生成一批用例」变成「3 分钟走完全链路」。慢了两分半,换来的是从「没人用」到「每周用三次以上」。
「以前你那个工具是帮你干活的,现在这个是帮我干活的。」
第一版从「AI 能做什么」出发,改造后的版本从「她卡在哪」出发——工具没换名字,立场换了。
CHECKLIST
动手前,先过这 5 问
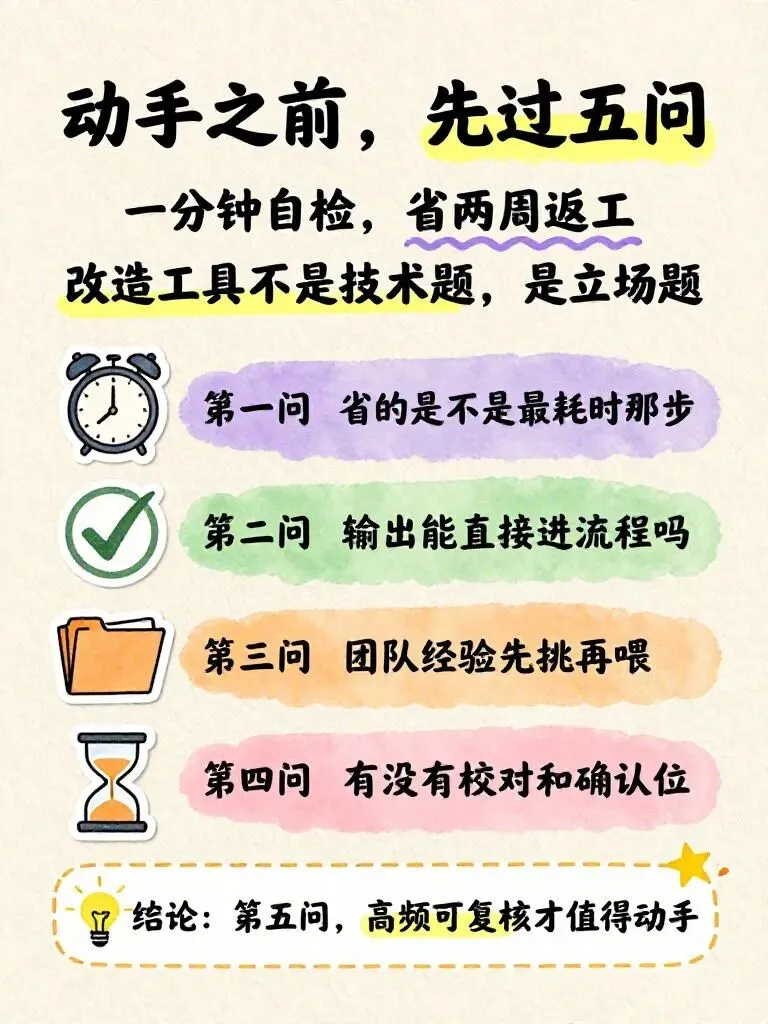
— 动手前五问自检卡(建议保存)
如果你也想把自己那套 AI 用法固化成团队工具,别急着写代码,先用这五问自检一遍:
你的工具省的必须是这一步,而不是「AI 最擅长的那一步」。
工具的输出格式,要和使用者下一步要用的格式一致。不一致就先做导出对齐,别让对方手动转格式。
历史用例、历史缺陷、规范文档都算。喂之前先想清楚怎么筛——筛过的少量参考,好过全量堆进去。
自查不求完美,求比手动快;确认位保证判断权在人。
高频、流程稳定、结果可复核的任务值得;一次性任务和纯判断类工作不值得。把需求文档和历史数据喂给外部 AI 服务前,先过一遍脱敏——这是底线动作,不是可选项。
五个问题都过了,再动手。改到一半发现方向不对的成本,比开工前多问五分钟高得多。
THE END
写在最后
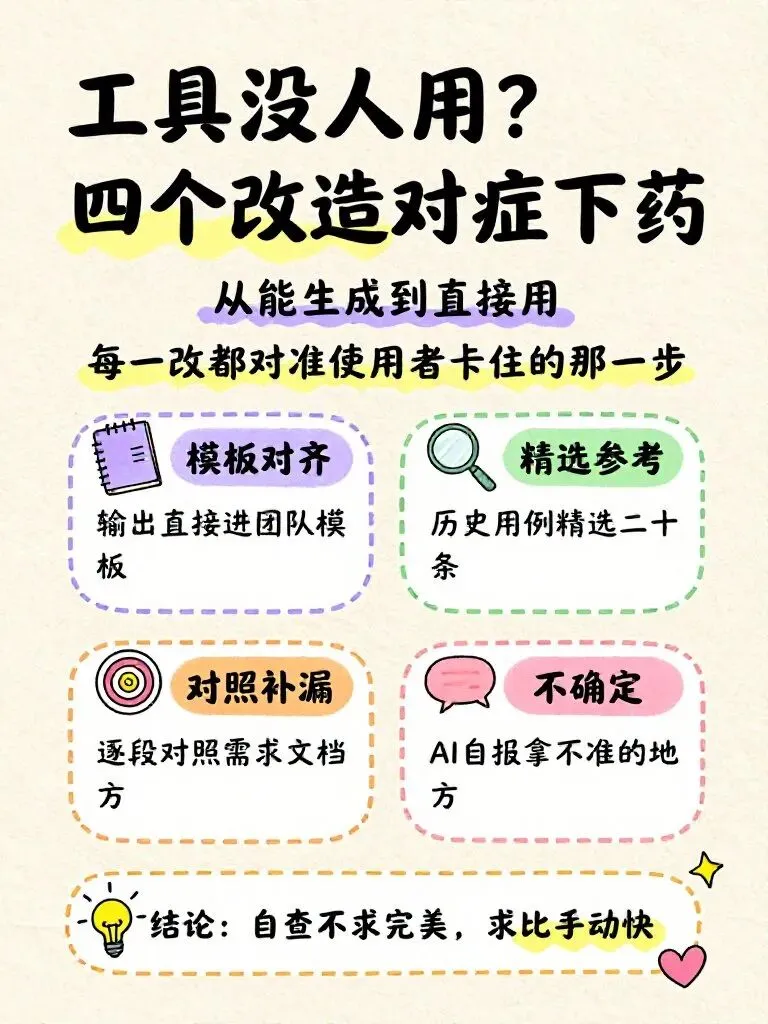
— 四个改造总览卡(建议保存)
回头看这个案例,最大的坑从来不是「技术跑不通」,而是「技术上跑通了,但没人用」。模板对齐、历史参考、覆盖率自查、不确定区域——四个改造没有一个涉及更高级的模型或更复杂的架构,全都是把「使用者的下一步」接进工具里。
工具的价值不在于「多快生成」,而在于「生成的东西能不能直接用」。下次你的 AI 工具没人用,先别急着换模型——对照那五个问题做一次诊断,大概率能找到断掉的那一环。
往期回顾
《用 AI 生成测试用例:从一份需求到能进用例库的完整流程(附提问模板)》——单次提问怎么问;这篇讲工具化之后怎么接进流程。
《测试人搭 AI 工作台不用写代码:3 张表,让输出稳定可复用》——还没到写工具那步的,先用三张表把流程固化下来。