ARTICLE · 1075204
上手阿里开源的 AI 代码审查工具 ocr:装起来、跑起来、接进 CI
我敲的第一条命令,是习惯性先装:
npm install -g @alibaba-group/open-code-review二十八秒,装完。命令行里多出来一个 ocr。ocr version 显示 v1.8.0,linux/amd64,构建于两天前——这东西还在挺快更新。
我没急着让它审代码,而是先跑了一句 ocr review --preview。
Preview: 2 file(s) changed | +5 -0Will review (2): [M] main.go +1 -0 [A] util.go +4 -0[M] 是改动文件,[A] 是新增。它先告诉你「我打算审哪些文件」,一个 token 都不花。这一步很关键——AI 审查最大的顾虑就是成本不可控,preview 相当于先看一眼电表。
项目卡片
项目:Open Code Review[1] 状态:Go / Apache-2.0 / 约 16k Star,2026-05-18 起步,最新 v1.8.0(7 月底仍在发版) 一句话判断:阿里内部用了两年、数万人用过的官方 AI 代码审查助手开源版,门槛低,关键是接进自己的工作流。
它本来是阿里集团内部的官方 AI 代码审查助手,用了两年,服务数万开发者,找出过数百万个代码缺陷,验证够了才开源。命令名 ocr 是缩写,不是那个文字识别的 OCR。
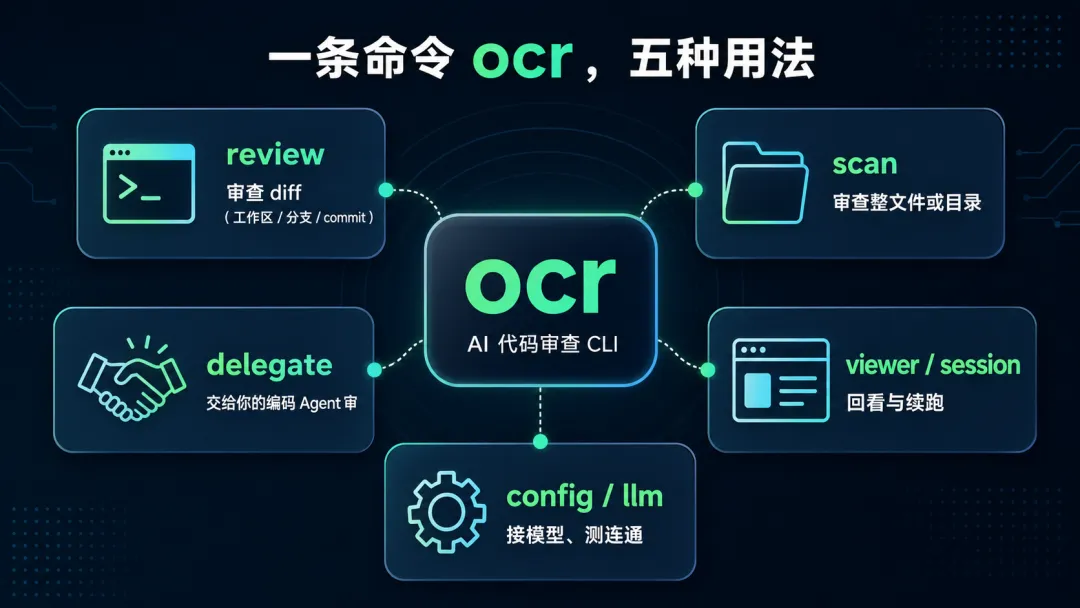
真正上手前,我先踩了个小坑。官方要求 Git ≥ 2.41,我机器上的 git 是 2.25,本来以为得升级,结果试着跑 --preview,文件选择照样正常。不过还是建议按官方说的升到 ≥ 2.41——diff 生成和代码搜索都靠 git,新一点稳一点。
能 preview 了,就能正式审。但审之前,先接一个模型。
两条交互式命令就能配完:
ocr config provider # 选内置 provider,或加自定义ocr config model # 给当前 provider 选模型ocr llm test# 测连通性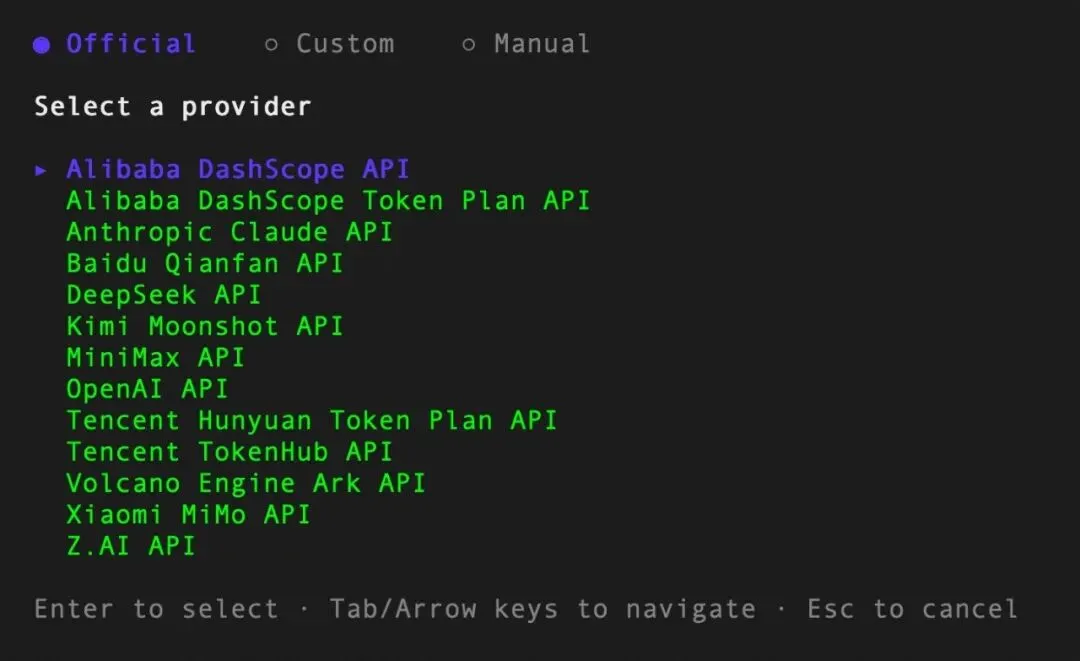
ocr llm providers 能看到内置清单,一共十八个,大多是 OpenAI 兼容协议,国产几乎全在:阿里 DashScope、DeepSeek、Kimi、MiniMax、智谱 GLM、火山引擎、百度千帆、讯飞、腾讯……对国内用户相当友好,基本不用自己搭中继。
懒得交互,也可以直接写环境变量:OCR_LLM_URL、OCR_LLM_TOKEN、OCR_LLM_MODEL,再加一个 OCR_USE_ANTHROPIC 决定走不走 Anthropic 协议。
说实话,我这边模型没连上——手头的中继在这台机器的网络里连不通,所以实测到「安装 + 文件选择」为止。下面的审查玩法来自官方文档和 help 信息,不是我亲手跑出来的输出;想复现,先自己备一个能用的模型 endpoint。
模型接上后,审查有好几种打法,对应不同场景:
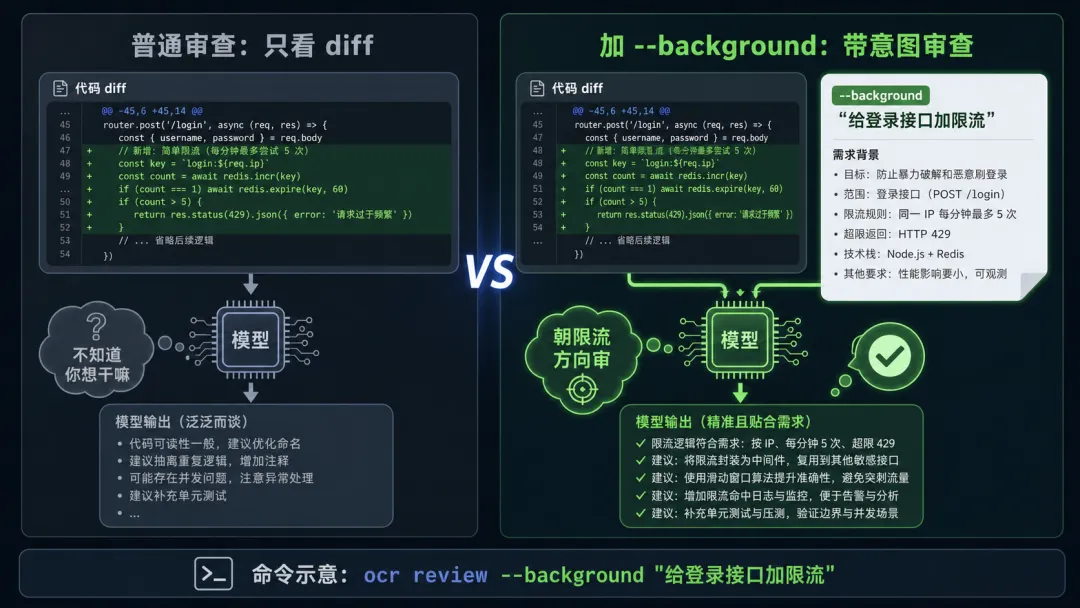
ocr review # 工作区所有改动:staged/unstaged/未跟踪ocr review --from main --to feature # 两个分支之间ocr review --commit abc123 # 单个 commit最让我意外的是 --background:
ocr review --background "给登录接口加限流"ocr review --background-file ./docs/requirements.md它能让你把业务背景喂给模型。通用 Agent 审代码常常只看 diff,不知道你想干嘛;这个能告诉它「这次改动是为了加限流」,它就会朝那个方向审。这点小心思,是「工具」和「玩具」的分界线。
还有两个实用参数:--format json 输出结构化结果,方便塞进脚本或 CI;--audience agent 只给摘要不打进度条,适合再喂给别的 agent。--concurrency 默认并发八个文件,--timeout 默认十分钟。
另外有个 ocr scan——不看 diff,直接审整个文件,适合审一个没有改动历史的陌生代码库;ocr session list 则能把中断的审查捡回来继续。
本地用只是自己爽,真正的价值是接进 CI,让每个 PR 自动过一遍。
GitHub 的方案是一个现成的复合 Action:
-uses:alibaba/open-code-review@mainwith:llm_url:${{secrets.OCR_LLM_URL}}llm_auth_token:${{secrets.OCR_LLM_AUTH_TOKEN}}llm_model:${{vars.OCR_LLM_MODEL}}llm_use_anthropic:${{vars.OCR_LLM_USE_ANTHROPIC}}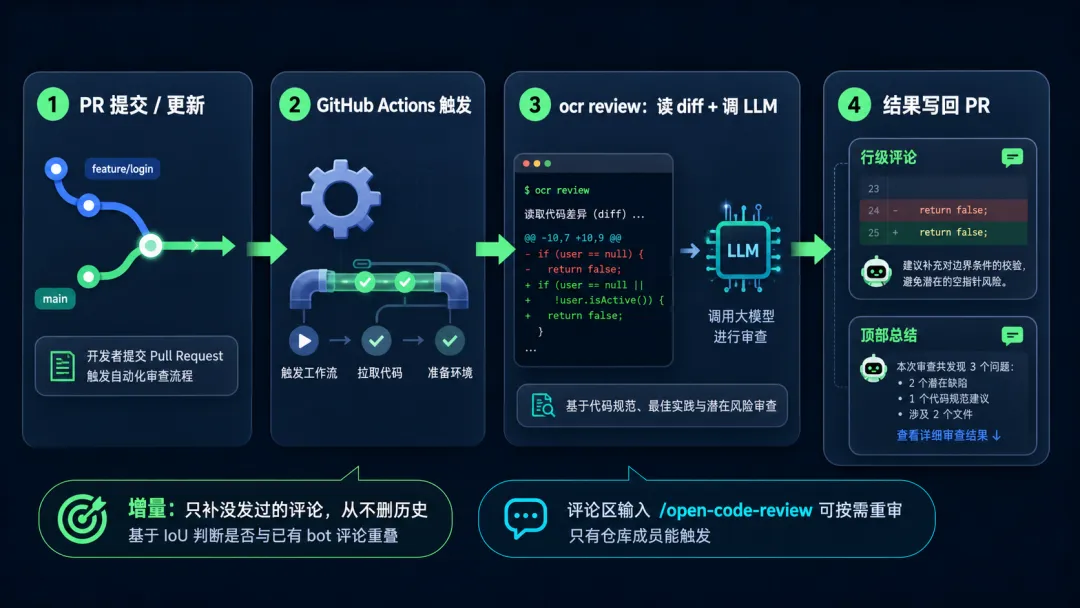
这里有两个细节我很喜欢:
增量模式:只对没发过的行补评论,用 IoU 判断是否和已有 bot 评论重叠,而且从不删历史。意味着评论区不会被重复审查刷爆。 评论触发:在 PR 评论区打 /open-code-review,就能按需重审。它还做了权限约束,只有 MEMBER / OWNER / COLLABORATOR 能触发,路人不能白嫖你的模型额度。
除了 GitHub,仓库 examples 目录里还有 GitLab CI、Gerrit、Bitbucket、阿里云效 Codeup 的现成配置,连发评论的脚本都写好了。
如果你主要泡在 Claude Code 里,两行:
/plugin marketplace add alibaba/open-code-review/plugin install open-code-review@open-code-review装完会得到 /open-code-review:review 这类斜杠命令。Codex、Cursor、OpenCode 也都有对应插件。
还有个更特别的 delegate 模式:OCR 不出模型,只负责选文件和解析规则,审查交给你自己 Agent 里已经接好的 LLM——ocr delegate preview,连 LLM 都不用给 OCR 单独配。对本来就有模型订阅的人,这是最省心的一条路。
它是个打磨得挺成熟的工具:二十八秒装好,preview 不花钱,provider 清单对国产友好,CI 和 Agent 集成都是现成的。上手门槛确实低。
但边界也得说清:
审查要自己接模型 endpoint,没有免费额度这回事; 官方定位是「更准、噪音少」,代价是召回率比通用 Agent 低——它没报的,你还得自己兜着; Git 建议升到 ≥ 2.41。
下次我会怎么用:接进 GitHub Actions、开增量,做日常 PR 自动审查;重要改动用 --background 补上背景。比起让它替人审完一切,拿它当「人工 review 前的第一道筛子」,更现实。
这里会继续拆真实可用的开发者工具:少讲概念,多看入口、成本和坑点。你只需要判断一件事——它值不值得放进自己的工作流。
引用链接
[1]Open Code Review: https://github.com/alibaba/open-code-review