ARTICLE · 1077249
Optiver :AI 离真正会交易还有多远?
文章来源:Optiver
Quintin Brown是Optiver 交易员,同时也是Applied AI 团队成员。他用公司内部的交易员考试和模拟交易环境,测试了最新一代大模型在交易任务中的实际表现。
加密货币高频高精度很高质量数据所有交易所合约现货期权,全量全历史含 L1-L2 精度等,100 元需要加微信 dreamsjtuai(历史数据已下载 200T,也有实时 api,超低价!)仅供学术研究。【市面质量TOP2】
这篇文章主要讨论 LLM 已经能够完成哪些交易任务,以及它们为什么仍会在连续决策中失效。Brown 重点分析了合理价格更新、正期望判断、逆向选择、对手反应和多步推理,试图回答一个更关键的问题:大模型已经懂了很多交易知识,为什么还无法稳定地把这些知识转化为连续的交易决策。
TL;DR:Optiver主要观点
1. 最新 LLM 已经相当“懂交易”。 在 Optiver 的测试中,模型能够完成多数数学题、理解做市机制、计算合理价格,也能识别逆向选择;部分理论题的表现已经接近实习交易员。 2. 真正困难的是连续决策。 真实交易需要不断经历“新信息 → 更新判断 → 采取行动 → 市场变化 → 再次更新”。LLM 经常能完成前一两步,随着信息不断进入,判断很容易失去连续性和一致性。 3. 模型能够识别优势,却很难稳定地把优势转化成仓位。 面对正期望机会,LLM 有时会仓位过小、过度对冲,甚至主动放弃本应承担的有利风险。它理解什么交易值得做,却还不能稳定执行这种判断。 4. 识别对手相对容易,推演对手下一步很难。 LLM 能够判断谁可能掌握更多信息,却不擅长继续推演自己的报价和交易会怎样改变对方行为。这里涉及更深的博弈推理、对抗性思维,以及对市场反馈的持续建模。 5. 距离自主交易,模型还缺少一个稳定的决策闭环。 模型已经能够处理规则、计算、分析和策略设计,但要真正独立交易,还需要持续更新概率判断、重新评估交易机会、预测其他参与者反应,并根据新的市场状态不断调整行动。 加密货币高频高精度很高质量数据所有交易所合约现货期权,全量全历史含 L1-L2 精度等,100 元需要加微信 dreamsjtuai(历史数据已下载 200T,也有实时 api,超低价!)仅供学术研究。【市面质量TOP2】
正文精编
为什么让 LLM 参加交易员考试
LLM 在学习交易基础知识方面,已经表现得相当不错。最新模型能够为简单情景定价、按照规则推理,甚至勾勒基本交易策略。
这给 Optiver 交易员 Quintin Brown 带来一个想法。转入 Applied AI 团队后,他把给实习生使用的考试交给 LLM。为了进一步测试模型极限,他又让模型参加一套模拟评估;这套评估原本用来测试接受了六个月训练的交易员。
问题很直接:当前一代 LLM 到底有多懂交易?哪些地方仍有改善空间?
一系列测试与实验之后,答案是有条件的。LLM 在若干领域已经非常有用,但在另一些关键能力上仍存在明显限制。
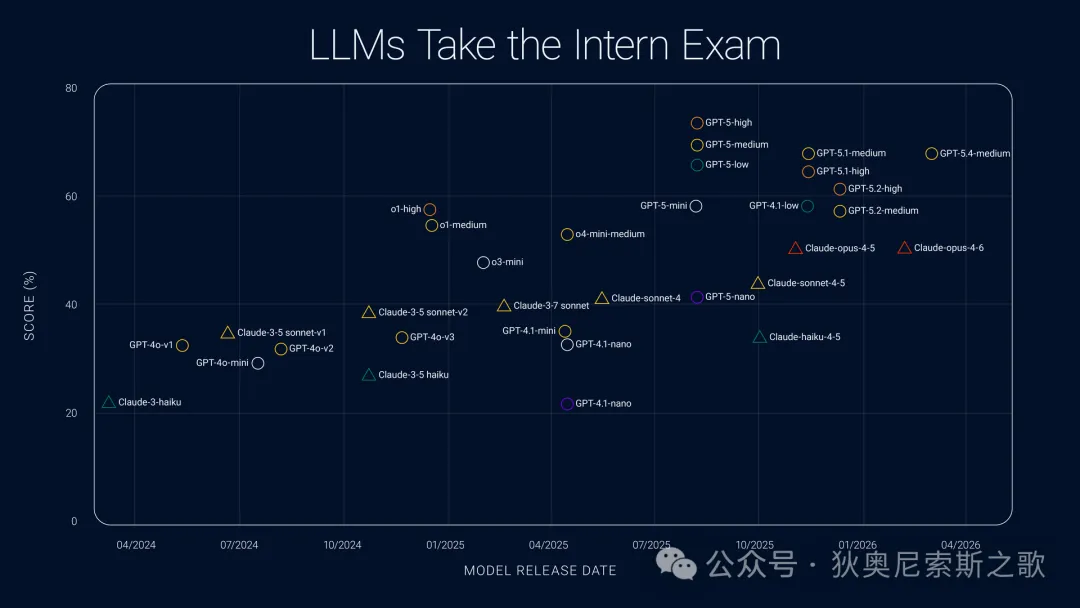
数学、规则和 fair value 已经做得不错
面对理论型问题,模型表现很好,已经足以对实习生构成挑战。它们能够处理大多数数学问题,也持续表现出对交易概念的扎实理解。
在许多领域,模型成绩大体可以和人类实习生相比。错误更多集中在复杂边缘情形,例如围绕选举或经济数据发布进行事件定价,或者处理更细致、更依赖具体情境的市场结构问题时,模型仍然容易出错。
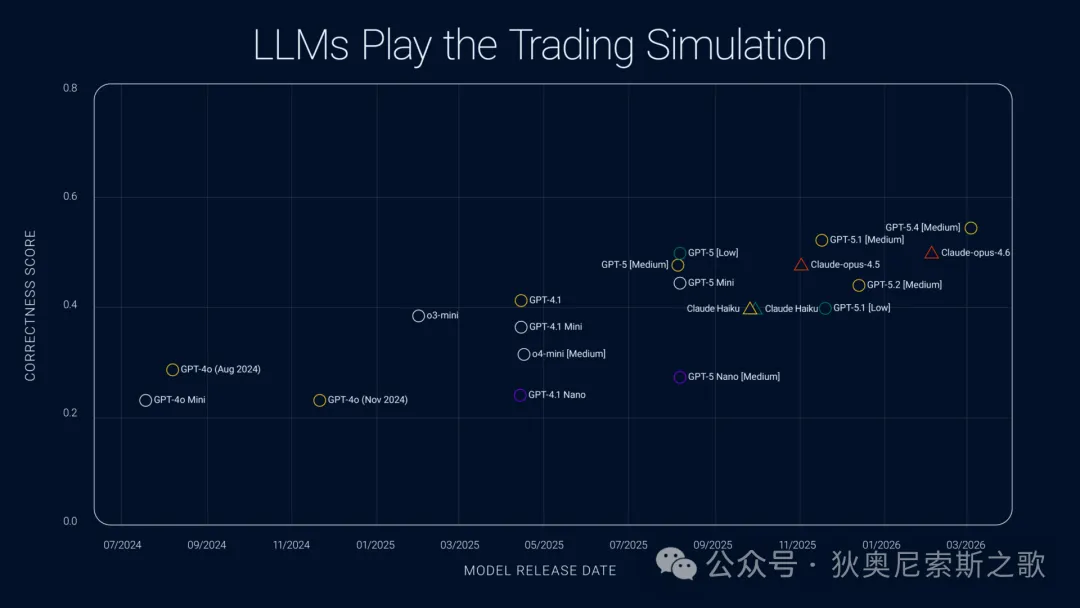
Optiver 还把模型放进了模拟交易环境。这些做市游戏原本用于训练实习生形成交易思维。大模型在这里的表现同样不错:它们能够计算合理价格,识别自己何时可能遭遇逆向选择,也能正确理解做市商的核心任务——在控制风险的同时赚取买卖价差。
第一批测试因此得出一个积极结论:LLM 已能胜任多项核心交易任务,在许多方面达到 Optiver 对实习生的预期水平。
崩溃点:模型没有持续更新自己的世界观
交易的特殊之处,在于它要求你不断更新对世界的看法。它不是做完一道题就结束,而是持续更新信念、回应其他参与者,并在不确定性下作出决定。Optiver 也会特别选拔并训练交易员的这种能力。
这恰恰是当前模型限制最明显的地方。
在多个情景中,模型最常见的错误包括:
• 对 fair value 的更新不一致; • 自己采取行动后,没有把新信息继续纳入判断; • 很难推理超过一到两个步骤的后续变化。
一个反复出现的行为是:模型先读入一条新信息,正确调整报价,然后据此执行交易。可是当更多信号出现时,它没有再次更新观点。这样的多步推理断裂发生得相当频繁。
由此产生的策略往往方向上没有错,却还不擅长连续决策。
加密货币高频高精度很高质量数据所有交易所合约现货期权,全量全历史含 L1-L2 精度等,100 元需要加微信 dreamsjtuai(历史数据已下载 200T,也有实时 api,超低价!)仅供学术研究。【市面质量TOP2】
EV 问题
模型另一个持续出现的问题,是怎样处理期望值(Expected Value,EV)。在交易中,EV 决定一笔报价或交易是否值得执行。交易员必须按概率对不同结果加权,并在 EV 为正时采取行动。
LLM 确实理解这个概念。它们能够解释,利润来自识别自己拥有 edge 的情形并进行交易。然而在实际测试中,模型常退回保守或依赖启发式的决策,因而把潜在收益留在桌面上。
面对正 EV 机会,模型经常没有充分投入,而是采用过度保守的策略,例如把交易规模设得低于最优水平,或者优先对冲,放弃追求一个有利的 EV 机会。
这揭示了“理解盈利来源”与“持续把理解执行出来”之间的差距。在测试中,EV maximization 是模型表现最弱的能力之一。模型已经具备基本直觉,但实现最优执行所需的精确性仍在发展。
逆向选择
模型识别逆向选择的能力相当不错。所谓逆向选择,指的是交易双方掌握的信息并不对称。识别知情交易流,本身就是交易员经常面对的重要问题之一。大模型通常能够意识到这类风险,也能说明应该如何调整报价。
问题出在执行上。即使模型已经判断出对手可能掌握更多信息,它仍然可能以负期望价格与对方成交,也常常忽略自己的交易行为会怎样影响其他市场参与者。
这进一步暴露了模型在博弈推演上的不足。它可以识别知情交易者、持仓驱动型交易者和流动性提供者,却很难继续推演这些参与者接下来会如何反应。模型往往采用过于简化或偏乐观的行为假设,缺少真实交易中所需要的对抗性思维。
框架正确,但策略没有足够深度
当模型被要求制定交易策略时,它们普遍采用同一种合理结构:
观察(observe)→ 推断(infer)→ 行动(act)
问题在于,由此产生的策略经常缺少深度,很少展现交易员思考和决策中更细致的部分:
• 定量更新信念; • 运用博弈论推理; • 模拟其他参与者会如何回应自己的行动。
因此,LLM 的策略写在纸面上通常听起来合理,却缺少真实执行所需的精度。计划是连贯的,但关键变量、更新规则与反应函数没有被充分定义。
实验结论:AI 已经适合做什么
当前模型比较擅长:
• 理解规则; • 完成计算; • 为问题建立框架。
当前模型可靠性较低的方面是:
• 多步骤推理; • 随时间持续整合信息; • 作出前后一致、具有定量依据的决定。
尽管仍有这些缺陷,Optiver 已经广泛使用 AI 系统进行分析、原型开发和教育,而且使用范围还在扩大。
实验同时显示了当前人类判断最重要的地方。交易不只是知道正确答案,还要求交易员在世界变化时更新概率模型,预判其他参与者的行为,并在不确定性下真正作出并执行决定。
加密货币高频高精度很高质量数据所有交易所合约现货期权,全量全历史含 L1-L2 精度等,100 元需要加微信 dreamsjtuai(历史数据已下载 200T,也有实时 api,超低价!)仅供学术研究。【市面质量TOP2】
连续推理、概率思维和对抗性判断这三种能力的结合,目前仍然很难复制。至少在当下,交易员仍然占优;但技术演进方向也很清楚,把人类专业能力与 AI 系统结合起来的机会正在持续增加。
原文连接: https://www.optiver.com/insights/technology-blog/where-ai-trading-models-work-and-where-they-still-fall-short/