ARTICLE · 1083636
花了 3 个月给 AI 攒的技能,换台电脑全丢了
上个月我换了个环境,重新装 AI 工具。
然后发现一件事:我花了三个月调教出来的那套技能,一个都没跟过来。
不是没备份。是备份了也没用——
同一个技能在四个目录下有四份拷贝,我不知道哪份是最新的;想用的那个"发布技能"倒是找到了,但它指向的 SEO 规则文件在原机器上;还有一个更隐蔽的:某些技能显示加载成功,Agent 也认,真到用它的时候才发现它读不到该读的文件。
它不报错。它就那么看着你,像一个忘了自己会什么的助手。
后来我去查,发现这不是我一个人的问题。
413 个文件,106 个死路径
2026 年 8 月 22 日,一位叫 Stride 的开发者在一台 Mac 上做了次盘点,结果是:
413 个 SKILL.md 文件
其中约 60 个是他自己写的,剩下全是各处装来的
分散在 4 个 Agent 工具下
同一个技能最多有 4 份拷贝
因为他移动过技能文件夹,产生了 106 个死路径
他的原话是:"我们的编程 Agent 和助手都在加载技能,但没有一个在按技能说的做。语音技能打不开它指向的语音文件,发布技能找不到 SEO 规则。"
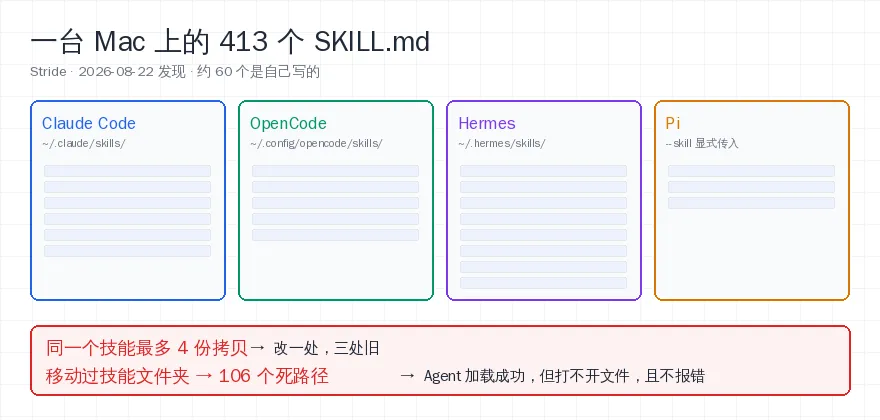
注意最可怕的部分:这些技能是"加载成功"的。
名字在可用列表里,你问它它也应你。只是技能里写着"去读那个文件",它读不到。你以为它有这个能力,它以为它也有,直到要用的时候才发现两边都在裸奔。
API key 是对的,模型是最新的,provider 切换也很顺畅——但能力是断的。
格式统一了,归属没有
要说清这事,得先知道 Agent Skills 是什么。
按 Anthropic 官方文档,一个技能就是一个含 SKILL.md 的目录。frontmatter 两个必填字段:name 最多 64 字符,description 最多 1024 字符。加载方式是三级渐进——启动时只把名字和描述放进系统提示,你问的东西匹配上了,它才去读正文。
(来源:Anthropic Agent Skills overview,2026-09-25 核实原文)
这套格式现在是事实标准。Claude Code、OpenCode、Hermes、Pi 都读它。anthropics/skills 有 178,011 stars,obra/superpowers 有 291,286 stars(2026-09-25 经 GitHub API 实测)。
但四个 Agent 各读各的目录:
| Agent | 技能目录 |
|---|---|
| Claude Code | ~/.claude/skills/ |
| OpenCode | ~/.config/opencode/skills/、~/.claude/skills/、~/.agents/skills/ |
| Hermes Agent | ~/.hermes/skills/ + skills.external_dirs |
| Pi | 仅 --skill <path> 显式传入 |
(来源:Stride Note,2026-09-25 核实原文)
于是你只有两条路,两条都不通:
拷四份。 改了一处,另外三份还是旧的。三个月后你根本不知道哪份是最新的。Stride 那 413 个文件里"同一技能最多 4 份拷贝"就是这么来的。
只存一份,其他地方做软链。 清爽。但他也演示了后果:文件夹一动,106 个软链集体失效,而且静默。
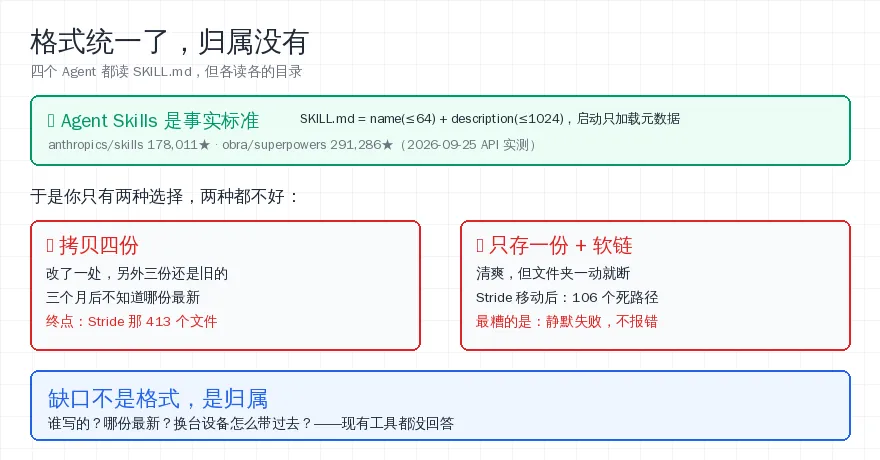
格式统一了,归属没统一。 这是目前 Agent Skills 生态真实的缺口。
装个工具不就行了?
我把市面上的方案逐个查了一遍(2026-09-25,查证过程在文末)。它们分别落在三层:
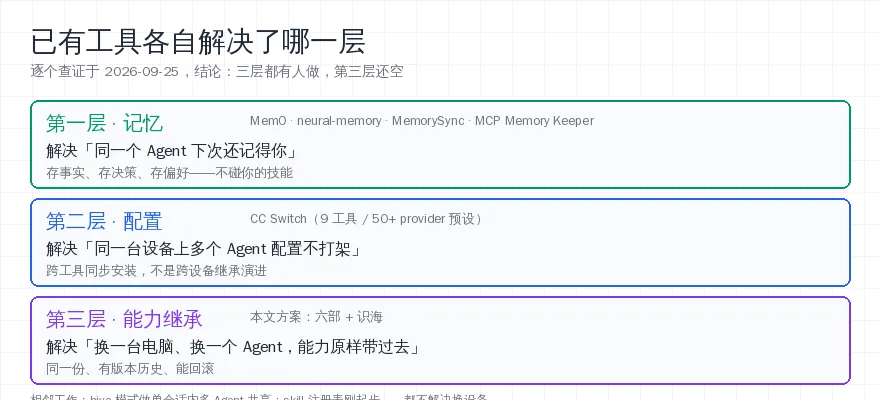
第一层,记忆。Mem0、neural-memory、MemorySync、MCP Memory Keeper 这类,解决"同一个 Agent 下次还记得你"。Mem0 官方自述是"智能记忆层……记住用户偏好,适应个体需求"。它们存事实、存决策、存偏好——但不碰你的技能。
第二层,配置。CC Switch 解决"同一台设备上多个 Agent 的配置不打架"。一个桌面应用管 9 个工具,50 多个 provider 预设一键切换,MCP 和 Skills 也能在一个面板里跨工具同步。
我用过,确实省事。README 里那句话说得准确:
"每个工具都有自己的配置格式。切换 API provider 意味着手改 JSON、TOML、.env 文件,而且没有统一的方式来管理多个工具的 MCP 和 Skills。"
但它管的是配置,不是能力。
配置是"这个 Agent 连哪个 provider、挂哪些 MCP"。能力是"这个 Agent 会干什么、按什么规矩干、干砸了怎么验"。
CC Switch 能把你的 Skills 面板同步到另一台设备。但它不会告诉你:哪些技能是你自己写的、哪些是第三方装的;同一个技能为什么装了三份;那个发布技能为什么突然找不到 SEO 规则。
配置同步了,能力没继承。
第三层,能力继承。 换一台电脑、换一个 Agent 运行时,你的技能原样带过去,而且是同一份、有版本历史、能回滚。
前两层已经有不少工具在做。第三层——我专门检索过,"skill inheritance" / "capability inheritance" 加跨设备的关键词,返回结果几乎全是游戏里的技能继承系统。
相邻的工作有两个方向,但都不解决换设备:
hive 模式(Munder Difflin, 2026-06):让单个会话内启动的多个 Agent 共享技能目录。但它是"一个会话内"的事。
技能注册表:
AllenMuu/skill-manager等在做,都很早期,还没涉及 git 继承与同步机制。
一句话记住:Mem0 们管"记住",CC Switch 管"配置",这一层管"继承"。
我的解法:两个 git 仓库
把能力和上下文彻底分开,各放一个仓库。
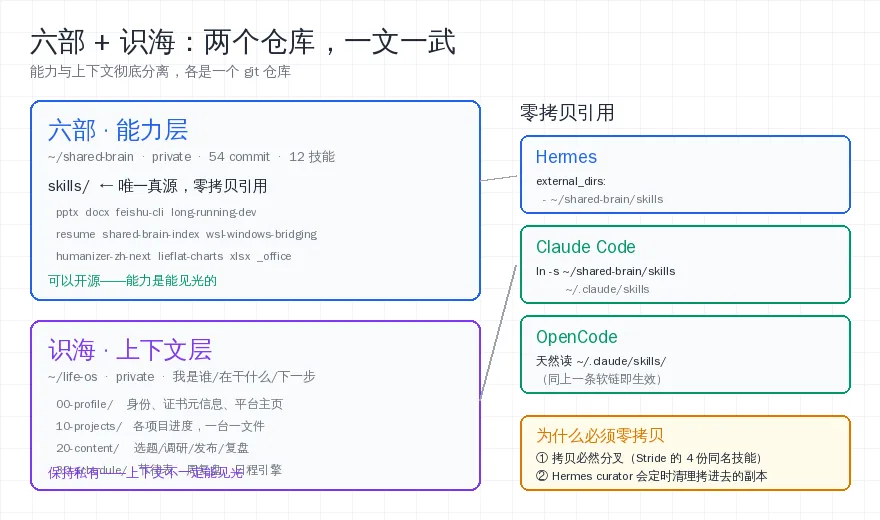
能力层,我叫它「六部」。~/shared-brain,装我全部技能——12 个,54 个 commit。
名字取自三省六部:每个技能不是一个"工具",而是对应领域的一班人马。做 PPT 的是御用演示团队,写文档的是资深笔杆子,跑数据的是专业分析师。各部各司其职,各是其领域的前沿水准。
上下文层,我叫它「识海」。~/life-os,装"我是谁、在干什么、下一步干嘛":身份卡、各项目进度、内容选题、节律表。
一文一武:六部管"用什么干活",识海管"在干什么"。
核心机制:零拷贝
我不把技能复制到各 Agent 的目录,而是让它们指向这里。本机 Hermes 的配置就一行:
external_dirs: - ~/shared-brain/skills
OpenCode 天生读 ~/.claude/skills/,所以对 Claude Code + OpenCode 组合,一条软链就够:
ln-s ~/shared-brain/skills ~/.claude/skills为什么必须零拷贝? 两个原因。
一是拷贝必然分叉,Stride 那 4 份同名技能就是终点。
二是 Hermes 有个 curator 会定时清理技能——Stride 的配置里是 stale_after_days: 30、archive_after_days: 90,拷进 ~/.hermes/skills/ 的副本可能被自动删掉。放进 external_dirs 指向的外部库,从根上没这个问题。
为什么必须分成两个仓库
我试过混在一起,结论是两边都会烂:
技能放进上下文仓库,每次 pull 项目进度都要拖几十 MB 技能资产,而且换个项目就想 fork 一份,技能开始分叉。
上下文放进技能仓库,技能库被我的日程和证书污染,没法开源、不敢给别人看。
分开之后还有个额外好处:六部可以开源,识海保持私有。 能力是能见光的,上下文不一定。
我把它做成了开源工具
前面说的机制不是"我建议你这么做",是我这么做完了,而且把治理流程开源了:
lggyx/lggyx-agent-arch(public,Python)
它的定位写得很清楚:
"多 Agent 技能治理架构。给 Agent 一套可复刻的技能治理机制。它不做的事:教你写 skill、给你一套开箱即用的技能包。它做的事:把你本机散落各处的 skill 盘点清楚、分清归属、归一成单一真源,并让这份真源跨设备同步。"
README 里描述的问题场景,跟这篇的诊断完全同源:
~/.hermes/skills/ 62 个(按分类目录组织)~/.claude/skills/ 9 个(平铺)~/.config/opencode/skills/ 4 个(另一套)~/Downloads/某个技能/ 3 个(不知道什么时候复制的)
三步流程,Agent 执行,人做归属决策:
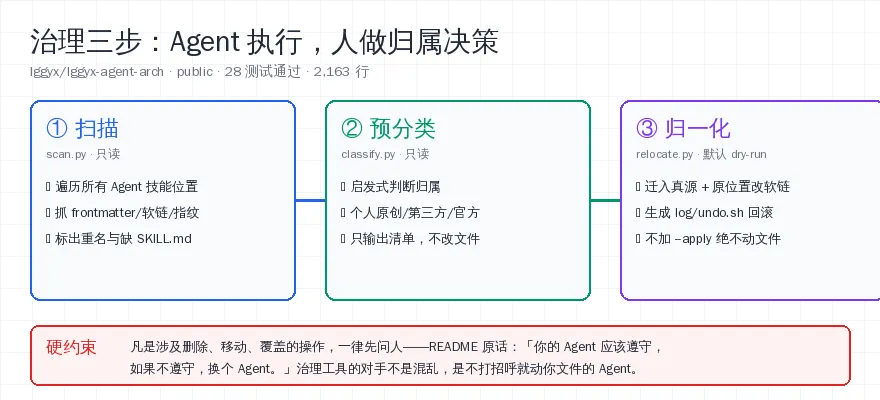
扫描(只读):遍历所有已知 Agent 的技能位置,抓 frontmatter、软链状态、体积、内容指纹。同时标出重名技能(区分"内容完全相同"与"版本已分叉")和缺 SKILL.md 的目录
预分类(只读):启发式判断每个技能属于个人原创 / 第三方 / 官方自带,只输出清单,不改文件
归一化(默认 dry-run):把技能迁入真源仓库、原位置改软链,并生成回滚脚本
我实际验证过:clone 到本地,跑测试,28 个全部通过(2026-09-25 实测)。代码 2,163 行。
它的安全设计是针对"移动技能文件夹"这个坑直接做的:
不加
--apply绝不改动任何文件执行后生成
log/undo.sh回滚脚本README 里写死了:「凡是涉及删除、移动、覆盖的操作,一律先问我」,并且补了一句我很喜欢的话——「你的 Agent 应该遵守——如果不遵守,换个 Agent」
最后这句是个态度:治理工具的对手不是混乱,是那些不打招呼就动你文件的 Agent。
三个踩过的坑
坑一:同步不能靠人肉,也不能每小时烧钱。
两个仓库、多设备,同步是硬需求。我的做法是每小时一次远程检测,但用 monitor 模式——定时任务先跑一个只读脚本(只 git fetch,不拉取),脚本无输出就静默结束,Agent 根本不启动;检测到远程有新提交才唤醒 Agent 去 pull。无变化的 tick 零成本。
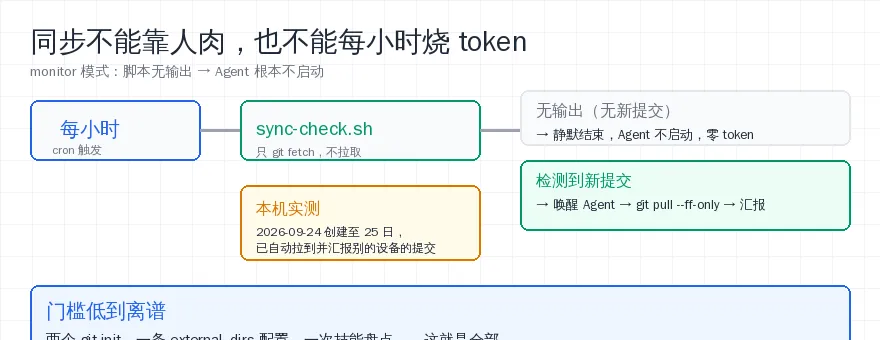
本机实测:2026-09-24 创建至 25 日,已经自动拉到并汇报了别的设备推的提交。
坑二:私有仓库的脱敏。
六部和识海都是 private。写这篇文章时我核对过每一处要公开的内容:技能数量、commit 数、目录结构,全部当场跑命令核实。因此改掉了三个不准确的说法——比如原稿写"11 个技能",实际是 12 个(漏数了一个目录);原稿写"跨 4 个 Agent 运行时",但本机实际只装并验证了 Hermes 一个。
宁可少写,不可虚写。
坑三:命名是为了省字,不是为了好听。
一开始我叫它 shared-brain,打字嫌长。后来定了「六部」「识海」这套代指,并且把代指写进了仓库的索引技能里——这样换任何设备、任何 Agent,读到那个文件就知道用户在说什么。
代指这东西,本质是给"说话省字"一个稳定映射。值得花十分钟定,不值得纠结半小时。
门槛低到离谱
回到开头:为什么换台电脑,你的 AI 就像第一天上班?
因为它的能力没有被继承,只是被安装过。
而解决这件事的门槛低到离谱:两个 git init,一条 external_dirs 配置,一次技能盘点。git 存在三十年了,Agent Skills 也只是一个目录加一个 markdown 文件。需要的只是把"归属"想清楚。
社区现在有很多人在做"让 Agent 记住你"(Mem0 们),也有很多人在做"让多个 Agent 配置不打架"(CC Switch)。"让能力继承给你"这一层,还比较空。
如果你也散落着一堆 SKILL.md,可以从我那个治理工具开始——clone 下来,把 PROMPT.md 里那段话发给你的 Agent,让它带你扫一遍。
扫完你就知道自己到底有什么了。
本文所有数据 2026-09-25 核实,完整来源见文末。
参考来源
| 内容 | 来源 |
|---|---|
| Agent Skills 格式规范 | Anthropic Agent Skills overview |
| 四 Agent 目录表 / 413 文件事故 / curator 参数 | Stride Note |
| stars 数据(178,011 / 291,286) | anthropics/skills / obra/superpowers,GitHub API 实测 |
| CC Switch 能力清单 | farion1231/cc-switch |
| Mem0 定位 | mem0ai/mem0 |
| neural-memory 定位 | bswen 博客 |
| MemorySync 定位 | memorysyncio/memorysync-cursor-starter |
| MCP Memory Keeper | mkreyman/mcp-memory-keeper |
| hive 模式 | Munder Difflin |
| 治理工具(28 测试 / 2,163 行) | lggyx/lggyx-agent-arch |