ARTICLE · 1083642
模型越强,垂类 AI 的护城河正在往哪里迁移?从 Data Moat 到 Ground Truth,再到 Reality Engine
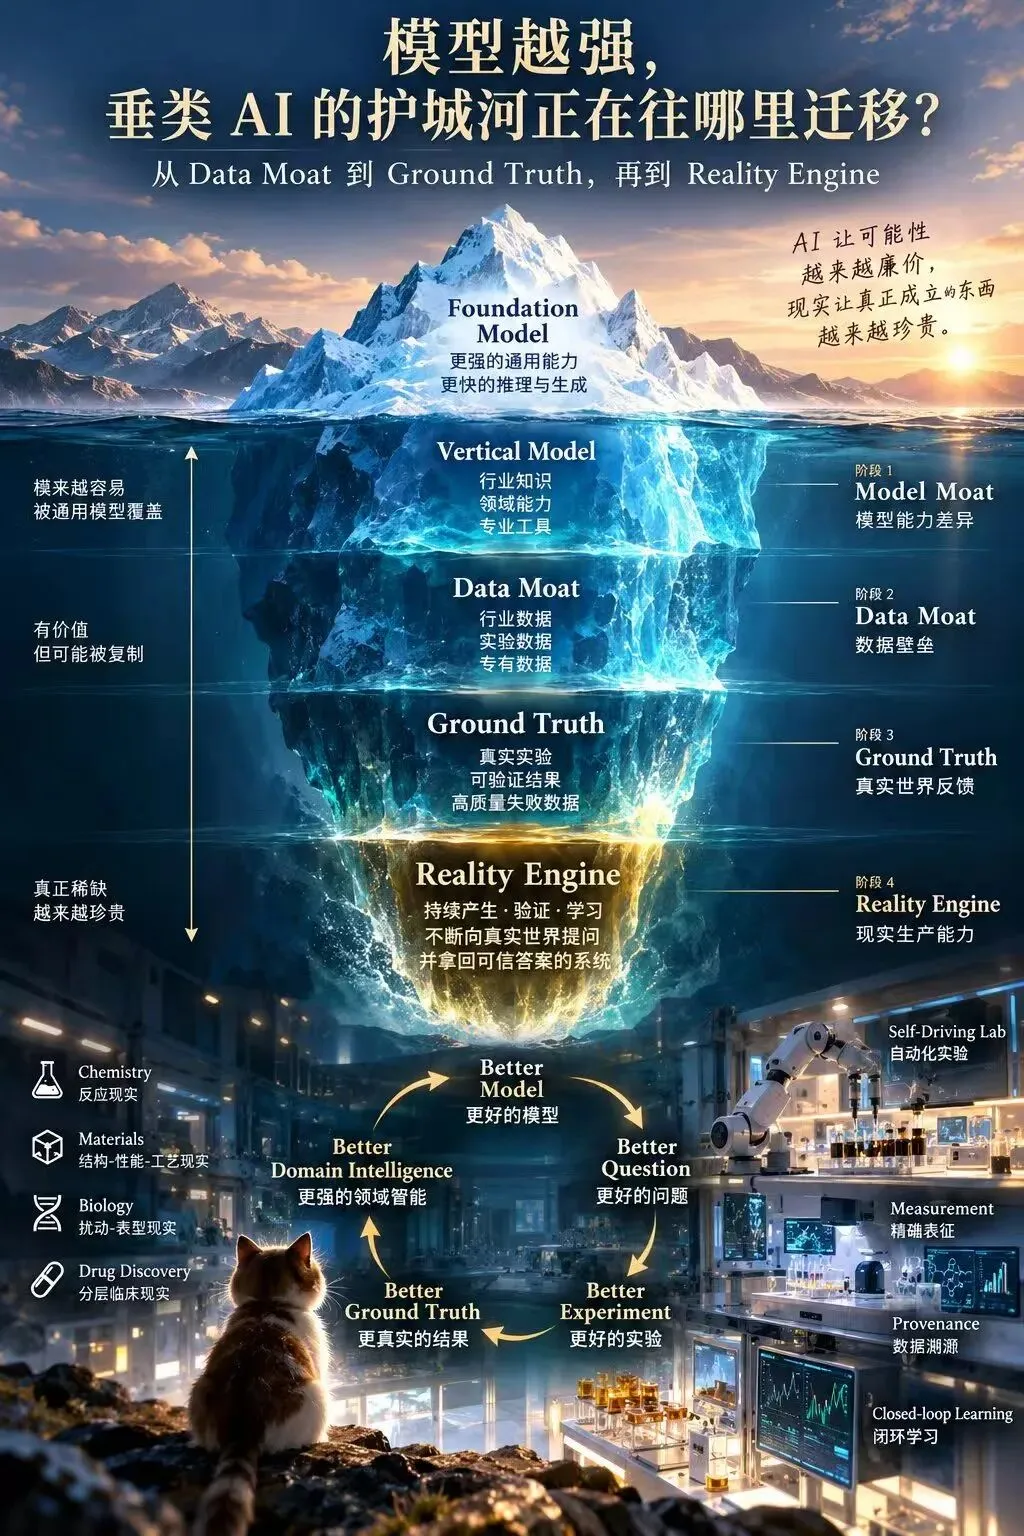
当 Foundation Model 越来越强,垂类 AI 真正的护城河,可能已经不再只是“垂类模型”本身,而是它所连接的 Vertical Reality。
那时候我觉得,这个问题大概已经想明白了。
结果一周以后——
系统又漂了。
于是,那只熟悉的好奇猫又出现了。
本来只是想看看:
到底哪里出了问题?
结果爪子一伸进去,就开始刨。
刨一层。
发现下面还有东西。
再刨一层。
下面居然还有。
于是继续。
一直刨到最后,终于刨不动了。
然后我发现:
上一次的答案没有错。
只是,还不够深。
01|如果 Foundation Model 越来越强,垂类到底还剩下什么?
过去很多 Vertical AI 的商业故事,都建立在一个非常自然的逻辑上:
通用模型不懂这个行业。
所以我们训练一个:
化学模型。
材料模型。
生物模型。
医药模型。
法律模型。
金融模型。
于是:
Domain Knowledge + Specialized Model = Moat。
这个逻辑当然成立过,而且现在仍然有价值。
但问题是:
如果 Foundation Model 每隔一段时间,就继续向前走一截呢?
当 reasoning、coding、tool use、scientific literature understanding、long context、agentic capability 持续提升,过去需要专门垂类模型才能完成的一部分能力,就可能逐渐被更强的 General Intelligence 覆盖。
这并不意味着:
Vertical AI 没有价值了。
恰恰相反。
它意味着:
垂类价值正在重新定价。
所以现在看一家 Vertical AI 公司,我越来越想先问一个问题:
如果明天所有人都可以调用同样强的 Foundation Model,你还剩下什么?
如果答案仍然只是:
“我们的模型比通用模型更懂这个行业。”
那这层 moat,可能没有想象中那么厚。
02|于是答案很容易滑向另一个词:Data Moat
如果 Model 不够,那是不是 Data?
听起来很合理。
尤其到了 AI for Science。
化学数据。
材料数据。
实验数据。
组学数据。
药物数据。
临床数据。
一个组织如果积累了大量别人没有的数据,当然有价值。
但刨到这里,我又卡住了。
因为:
Data 根本不是一种东西。
一家企业告诉我:
“我们有一亿条数据。”
其实这句话本身没有告诉我太多。
这些数据是谁产生的?
怎么测的?
Protocol 一致吗?
实验条件一致吗?
Measurement uncertainty 多大?
有没有 batch effect?
失败实验在不在?
哪些是真实实验结果?
哪些只是 simulation 或 model-generated output?
原始 metadata 和 provenance 还在吗?
于是:
一亿条数据,和另外一亿条数据,
可能根本不是同一种资产。
2026 年 7 月,Nature Reviews Chemistry 在一篇关于 self-driving laboratory 的综述中,把下一阶段的关键明确指向三个问题:
scalability、generalizability,以及 provenance-complete experimentation。
不只是把实验自动做掉,而是要完整保留从原料准备、合成、表征直到性能评价全过程的数据与 metadata。
换句话说:
Data Volume ≠ Scientific Reality。
数据越多,并不必然意味着离真实世界越近。
有时候,只是噪音更多了。
这件事在 Biology 和 Drug Discovery 里尤其明显。
2026 年 Nature Reviews Drug Discovery 对 AI 药物研发进行了一次相当冷静的复盘:生物数据高度 conditional,会受到实验条件、遗传差异、环境等变量影响;与此同时,很多 input 和 output 之间的底层机制本身并没有被充分理解。作者把这种状态称为 epistemic opacity。
所以:
More Data ≠ Better Decision。
这一刀下来以后,只好继续往下刨。
03|Data Stock 和 Data Flow,根本不是一回事
我现在越来越喜欢把数据分成两个概念:
Data Stock
过去已经积累的数据。
以及:
Data Flow
今天、明天、后天,还能不能持续产生新的、高质量的、别人拿不到的数据。
历史数据库当然有价值。
但它首先是一种:
存量资产。
公共数据库会继续增长。
论文会继续发表。
竞争对手可以买数据、合作拿数据。
Foundation Model 也会越来越擅长从已有知识里提炼模式。
所以真正让我开始觉得有意思的问题,不再是:
你已经有多少数据?
而是:
你今天还能不能产生新的 Reality?
再进一步:
你每单位时间,能够生产多少真正有信息价值、可信、独家的 Reality?
到了这里以后,我突然发现:
我们讨论的已经不只是 Data Moat。
而是:
Reality Production Capacity|现实生产能力。
04|AI 越会提出答案,Ground Truth 反而可能越贵
这是这次继续往下追以后,我觉得最有意思的一层。
2026 年 7 月,Google DeepMind 专门提出了一个非常值得注意的问题:
Validation Bottleneck
随着 AI agents 越来越擅长提出 hypothesis、设计实验、寻找 candidate solutions,科学世界可能出现一个新的结构性变化:
提出想法越来越快。
但是——
谁来验证这些想法到底是真的?
DeepMind 把未来越来越强的科学 AI agent 描述成某种 conjecture machine:
可以高速制造新的 hypothesis 和 candidate solutions。
但真正把这些 hypothesis 放进世界里检验,仍然会受到实验设施、物理过程、资源甚至时间本身的约束。
于是,AI for Science 里可能出现一种非常反直觉的经济学:
Hypothesis 越来越便宜。
Ground Truth 反而越来越昂贵。
模型可以一次生成一万个候选材料结构。
很好。
哪个真的存在?
模型可以提出十条 reaction path。
很好。
哪一条真实实验能够跑出来?
模型可以预测某个 DNA variant 可能产生某种 molecular effect。
很好。
进入真实 biological context 后,这个 effect 还成立吗?
2026 年 9 月,Google DeepMind 发布 AlphaGenome Atlas,把 AlphaGenome 对大约 90 亿种可能的单碱基变异的分子效应预测进行了大规模预计算。
九十亿。
过去几乎无法想象的搜索空间,现在可以被 AI 大规模铺开。
但当 prediction 本身变得极其丰富之后,一个新的问题反而变得更重要:
谁来告诉我们,哪一个是真的?
模型负责扩大可能空间。
Reality 负责淘汰错误空间。
到了这里以后,AI for Science 下一阶段真正稀缺的东西,开始发生迁移。
05|真正更深的 moat,不只是 Data,而是 Ground-Truth Engine
继续往下以后,我发现“数据”这个词已经不够用了。
因为真正稀缺的,不只是拥有一批过去产生的数据。
而是:
一个组织有没有能力持续生产可信的 Ground Truth?
这意味着一整套系统:
提出一个真正值得回答的问题
↓
判断当前最重要的不确定性是什么
↓
选择最有信息价值的实验
↓
真正执行
↓
精确测量
↓
判断这一次结果到底是不是 signal
↓
更新当前认识
↓
再决定下一步应该向 Reality 问什么
这已经不是一个 Database。
它更像:
Ground-Truth Engine。
或者,我更喜欢另一个词:
Reality Engine。
它不是简单地“储存现实”。
而是一套能够:
不断向真实世界提问、拿回答案、验证答案,再根据答案改变下一次问题的系统。
06|真正的飞轮,也不是 Model → Data
继续往下以后,我觉得真正有意思的 loop 应该长成这样:
Better Model
↓
Better Question
↓
Better Experiment
↓
Better Ground Truth
↓
Better Domain Intelligence
↓
Better Next Question
然后重新开始。
这时候,一个很有意思的变化出现了。
更强的 Foundation Model,未必会摧毁一个真正拥有 Reality Engine 的 Vertical AI。
甚至可能恰恰相反。
更强的模型可以:
更快地阅读文献。
更好地生成 hypothesis。
更有效地缩小 search space。
发现更复杂的 pattern。
帮助设计下一轮 experiment。
但是——
真正产生新的 proprietary Reality 的,仍然需要后面的实验、measurement 和 validation system。
于是,一个真正建立起 Reality Engine 的垂类组织,不一定害怕 Foundation Model 升级。
它反而可能成为:
Foundation Model Improvement 的 Beneficiary。
模型越强,
它越有机会问出更好的问题。
更好的问题,
带来更有价值的实验。
更有价值的实验,
又产生别人没有的 Reality。
于是竞争优势从:
“我拥有一个别人没有的模型。”
变成:
“每一次模型升级,都能让我更快地产生别人没有的新 Reality。”
这才开始出现真正的 compounding。
07|Self-Driving Lab 为什么越来越重要?
如果 AI 和 Reality 中间一直隔着大量人工:
模型提出实验。
人去操作。
过几天拿到结果。
手工整理。
重新输入。
再分析。
下一轮再来一次。
Reality Cycle 会非常慢。
所以 Chemistry 和 Materials 最近几年一个非常重要的发展方向,就是:
Self-Driving Laboratory
Nature Reviews Chemistry 今年的综述显示,Self-driving lab 已经从早期较为狭窄的自动实验系统,逐渐发展为更完整的 discovery platform——算法可以参与提出、执行和解释实验,而领域下一阶段的关键问题,已经开始转向 scalability、generalizability 和完整的实验 provenance。
于是:
Design
→ Execute
→ Measure
→ Learn
→ Next Experiment
开始真正连起来。
但这里马上又会冒出下一层问题:
如果 robotics、自动移液、模块化实验硬件越来越便宜呢?
那未来:
“我们有机器人。”
本身也未必是 moat。
所以还得继续刨。
真正越来越值钱的可能是:
谁知道下一次最值得做哪个实验?
我暂时把它叫:
Experiment Selection Alpha。
两家公司可能拥有:
一样的机器人。
一样的实验仪器。
甚至一样的 Foundation Model。
但是一年以后,它们积累出的 Intelligence 完全可能不同。
因为一个系统每一次都在做:
最高信息增益的实验。
另一个系统只是:
自动化地做更多实验。
这两个完全不是一回事。
Automation ≠ Intelligence。
08|再往下以后,会发现:AI for Science 根本不是一种 Reality
以前我们很容易说:
“AI for Science 的 Reality。”
现在看起来,其实还是太粗了。
因为不同科学领域面对的 Ground Truth,根本不是同一种东西。
Chemistry 更接近:
Reaction Reality
能不能反应?
什么条件?
Yield、selectivity、purity 到底怎么样?
所以它相对天然适合更快的实验闭环。
Materials 更接近:
Process–Structure–Property Reality
材料不是生成一个漂亮结构就结束了。
温度。
压力。
制程。
微观结构。
设备。
表征方式。
这些因素都可能改变最终性能。
模型可以帮助搜索材料空间。
但一个 candidate 真正成立,还要与真实的 synthesis、characterization 和 process 相遇。
Biology 更接近:
Perturbation–Phenotype Reality
不是只观察:
“两个东西是不是相关。”
而是主动改变:
一个 gene。
一个 protein。
一个 molecule。
一个 condition。
然后看生命系统到底发生什么。
因为 living system 极度 context-dependent。
相关性可以很多。
真正的 causal signal 却很贵。
到了 Drug Discovery,事情甚至更麻烦。
它不是一个 Reality。
而是一串嵌套的 Reality:
Molecule → Cell → Animal → Human
前面每一层都可能非常漂亮。
下一层,仍然可以把它推翻。
2026 年 Nature Reviews Drug Discovery 明确提醒:虽然 AI 方法、论文和 benchmark 已经非常丰富,但真正 clinically relevant 的现实影响证据目前仍然有限;未来 benchmark 需要逐渐从“模型验证”,转向“AI 是否真正改善现实项目中的 decision making”。
这就让我开始想到另一个可能非常重要的坐标。
09|Reality Distance:你的模型离最终现实,到底还有多远?
我现在越来越喜欢用这个问题来看 Vertical AI:
从模型给出一个答案,到真实世界最终证明它到底有没有价值,中间还有多少层?
我暂时把它叫:
Reality Distance。
Reaction optimization 的 Reality Distance 可能比较短。
做一次实验,很快就能知道很多。
Materials 更长一些。
还涉及 synthesis、characterization、process。
Biology 更长。
环境、组织、遗传背景,都可能改变结果。
Drug Discovery 一路走到真正的 human clinical outcome:
Reality Distance 极长。
为什么这个变量重要?
因为:
Reality Distance 越长,漂亮故事能够存在的时间越长。
Benchmark 很高。
Paper 很漂亮。
Demo 很惊艳。
都不能直接等于:
现实价值已经被证明。
所以以后看到一个 AI for Science 系统,我越来越想问一句非常简单的话:
从你的模型输出,到一个 falsifiable real-world result,最短路径是什么?
也就是:
你最快多久,能让 Reality 告诉你——你错了?
这可能比:
“你的 benchmark 到底高了多少个百分点”
更有意思。
因为一个系统越能快速让自己的 prediction 接触 Reality,
它就越有机会:
更快犯错。
更快知道自己为什么错。
然后:
更快变聪明。
10|这也解释了:为什么失败实验可能特别值钱
科学世界天然存在一个问题:
Publication Bias
成功结果容易发表。
失败结果呢?
大量就留在实验室硬盘里了。
但是,如果我们真的想训练一个懂 Reality 的系统:
哪里不能走,与哪里能走,同样重要。
假设一千次 reaction:
十次成功。
九百九十次失败。
论文可能重点告诉我们那十次。
但对于一个真正需要学习 search space 的系统来说:
那九百九十次失败,其实定义了大量:
Boundary of Reality。
它们是:
被现实世界排除掉的可能性。
所以一个长期运行的 Reality Engine,可能会慢慢积累一种非常特别的资产:
High-quality Failed Reality。
失败不再只是 Failure。
它是:
Reality 给出的负答案。
而知道:
哪里不用再浪费下一次实验,
本身就是 Intelligence。
11|所以未来最稀缺的基础设施,也许不只是 Data Center
过去十几年,我们投入了巨大资源建设:
GPU。
算力。
数据中心。
Training infrastructure。
因为那个阶段最大的瓶颈之一是:
生产 Intelligence。
但如果 AI 继续向前走——
越来越会生成 hypothesis。
越来越会设计方案。
越来越会搜索可能性。
那么另一个 bottleneck 会越来越明显:
谁来告诉 Intelligence,什么是真的?
于是 AI for Science 下一阶段的一类关键基础设施,可能越来越像:
Robotics
Synthesis
Assay
Characterization
Measurement
Provenance
Evaluator
Closed-loop Learning**
也就是:
Reality Factory。
DeepMind 在讨论 validation bottleneck 时,也明确把实验验证基础设施和自动化实验室能力视为未来需要进一步补足的环节。
过去,我们大量建设的是:
Compute Factory。
未来 AI for Science 可能还会越来越需要:
Reality Factory。
一个负责制造可能性。
一个负责淘汰幻想。
12|所以,垂类 AI 最深的 moat 到底正在往哪里迁移?
一周前,我写:
The moat is not the vertical model.
The moat is the vertical reality.
今天,我想把它再往下推一层。
But reality itself is not enough.
拥有一批 Reality,
不等于拥有持续优势。
拥有一个 Database,
也不等于拥有持续学习能力。
真正更深的 moat,是:
The ability to continuously produce, validate and compound reality.
也就是:
持续提出更好的问题。
持续获得高质量 Ground Truth。
持续判断哪些 Reality 值得相信。
持续把每一轮真实反馈,变成下一轮更好的 Intelligence。
所以,未来真正强大的 Vertical AI 公司,可能不只是:
Model Owner
也不只是:
Data Owner
而越来越会成为:
Reality Engine Owner。
13|然后,这只猫终于可以停下来了吗?
大概可以了。
😂
这一周其实挺好玩的。
第一次系统漂移的时候,我一路往下刨,最后刨出了:
Vertical Reality。
一周以后,
系统又漂了一次。
我本来只是想:
把它修回来。
结果那只好奇猫又不肯停。
为什么会漂?
到底是 Model 的问题?
Infrastructure?
Data?
Memory?
Retrieval?
还是有一些东西,本来就是今天的 AI 仍然没有完全解决的问题?
Reality Return 为什么不是:
“有反馈”
就够了?
一个系统怎么知道:
这一次反馈到底该不该信?
怎么知道:
到底是什么造成了这个结果?
又怎么知道:
下一次最值得向 Reality 问什么?
刨着刨着,
一路刨到了 AI for Science。
然后突然发现:
原来上一次那篇文章后面,
还埋着这么长一截。
有时候我觉得自己的好奇心确实挺麻烦的。
一个问题只要还剩一点点没想通,
爪子底下就像总还有东西。
那就:
再刨一下。
再一下。
再一下。
一直到最后终于发现:
没地方可刨了。
然后才会认命地说:
好吧。
以现在模型的发展阶段,以及我目前能够看到的认知边界,大概只能先走到这里了。
昨天大概连老天都看不下去了。
硬生生安排我折腾了一整天热水器。
终于给这只猫装了一个物理暂停键。
😂
否则大概率还在刨。
但今天回头看,
好像也没有白刨。
因为每一次系统出现问题以后,真正留下来的,往往都不是:
“我终于把它修回来了。”
而是一个新的问题:
当下一代模型出现以后,到底什么东西仍然不会瞬间失去价值?
对于 AI for Science,
我现在看到的答案是:
模型会越来越聪明。
生成会越来越便宜。
可能性会越来越多。
而那些能够让 Intelligence 一次又一次真正碰到世界、接受检验、拿回 Ground Truth,再继续进化的系统——
可能反而会越来越贵。
AI,让可能性越来越廉价。
Reality,让真正成立的东西越来越珍贵。
THE END🔚
关于这篇文章
这篇文章由 Juliet Fan 基于长期产业观察、猎头一线实践和个人判断完成。
AI 工具仅用于资料整理、结构辅助和表达优化,不替代人的判断。真正的观点、取舍和判断,来自我对商业、人性、组织变化、职业选择与个体处境的长期观察。
关于我
我是 Juliet Fan,小玉,高端猎头顾问。
北京大学应用心理学硕士,长期关注组织行为、人的发展、职业选择与商业变化。
我有 14 年左右高端猎头经验,长期服务 AI、半导体、智能制造、机器人、新材料、出海业务、高端制造及商业化团队搭建。
我写这些文章,不只是为了追热点,而是想看见:一个行业变化背后,真实的人、真实需求、真实组织和真实机会正在怎样移动。
你可以这样联系我
如果你是创始人、CEO、C-level、业务负责人或HR 负责人,正在思考关键团队搭建、核心岗位招聘、组织能力补齐或高端人才引入,请备注:
合作 + 公司方向 + 岗位 / 团队方向
如果你是候选人,正在关注 AI、半导体、智能制造、出海、高端制造、新消费或服务业相关机会,请备注:
机会 + 当前方向 + 城市 + 年限
如果你想做职业发展 / 职业路径梳理,请备注:
咨询 + 当前阶段 + 想解决的问题
请扫码添加微信:
备注越清楚,我越能快速判断是否适合继续沟通。