ARTICLE · 1087223
AI基础知识入门:什么是 MoE? 为什么 DeepSeek 能便宜成这样?
AI基础知识入门:什么是 MoE? 为什么 DeepSeek 能便宜成这样?2025 年 DeepSeek V3 上线时,API 定价是每百万输入字几毛钱——同一个问题问国外某旗舰模型,价格是它的几十分之一。同行看了直跺脚,好几家大厂连夜跟着降价。 是赔本赚吆喝吗?不是,DeepSeek 的成本是真低。 秘密藏在三个字母里:MoE(Mixture of Experts,专家混合模型)。 “又大又便宜”这四个看似矛盾的要求,就是靠这个结构同时成立的。 一 从一个类比开始:全员大会 vs 分诊台 想象一个公司要回答客户问题。 第一种组织方式:全员大会。 不管客户问什么,全公司几百号人都坐进会议室一起讨论。答案质量有保障,但问一句“食堂几点开饭”也得全员出动,纯属浪费。 普通大模型就是这么干活的。这类模型叫“稠密模型”:每一个字进来,几乎所有参数都要参与计算。参数越多越聪明,但也越贵——每一次回答,都是一场全员大会。 第二种组织方式:前台分诊。 客户问题先到前台,前台判断“这是法律问题”,转给法律部的两位专家;财务问题转财务部,其他人继续干自己的活。全公司的知识储备一个不少,但每个问题只占用少数人。 MoE 就是第二种。 模型内部分成许多个“专家”,每个专家是一组参数;问题进来,先由一个叫“路由器”的部件判断该找谁,然后只激活最相关的几个专家干活。 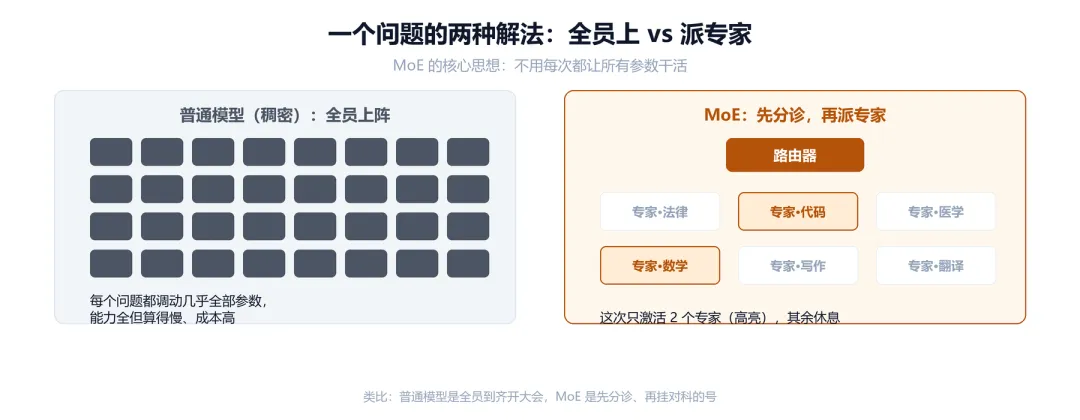
稠密模型全员上阵 vs MoE 分诊派专家 二 流水线走一遍 MoE 处理一次问答,就三步。 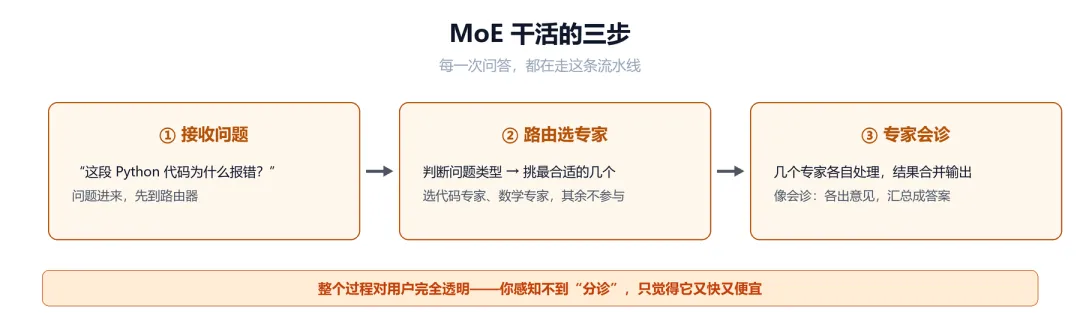
MoE 三步流程:接收、路由、会诊 第一步,问题进来,先交给路由器。 第二步,路由器给这个问题“分科”——问的是代码,就点代码专家和数学专家的名;聊的是菜谱,就换生活经验专家上场。 第三步,被点名的几个专家各自处理,结果汇总合并,给出最终回答。 一个容易误会的地方:“专家”不是“专攻医学的医生”,它没有人类能看懂的分工标签。 分工是训练过程中自己长出来的——不同专家会自然而然对不同类型的文字敏感。这套分诊对你也完全透明,你感知不到,只觉得它回答得又快又便宜。 那路由器会不会挑错人? 会,但影响不大。路由器本身是个很小的神经网络,分诊能力也是训练出来的;而且每次上场的是一组专家共同处理,个别选偏了,同伴能兜住。真正要防的是“所有问题都挤同几个专家”,那会让训练崩掉——后面会讲到这个问题怎么解决。 规模感给一个:DeepSeek-V3 里共有 256 个专家,每个词经过每一层时,路由器从 256 个里挑 8 个上场,另有几个共享专家随时候命。这个挑选每秒发生成千上万次——你一句话还没打完,前台已经做了几百次分诊。 还有一点:分诊不是只做一次。V3 的几十层网络里,每一层都有一套自己的专家团,一个词要连续经过几十次分诊。浅层的专家往往对句法、字词这类表层规律敏感,深层的专家更接近语义和推理——层层加工,才出答案。 三 “又大又便宜”的账本 以 DeepSeek-V3 为例:总参数量约 6710 亿,这是“公司总人数”,决定知识储备的天花板;处理每个词时,实际激活的参数只有约 370 亿,这是“这次真正干活的员工数”,只占总量的约二十分之一。 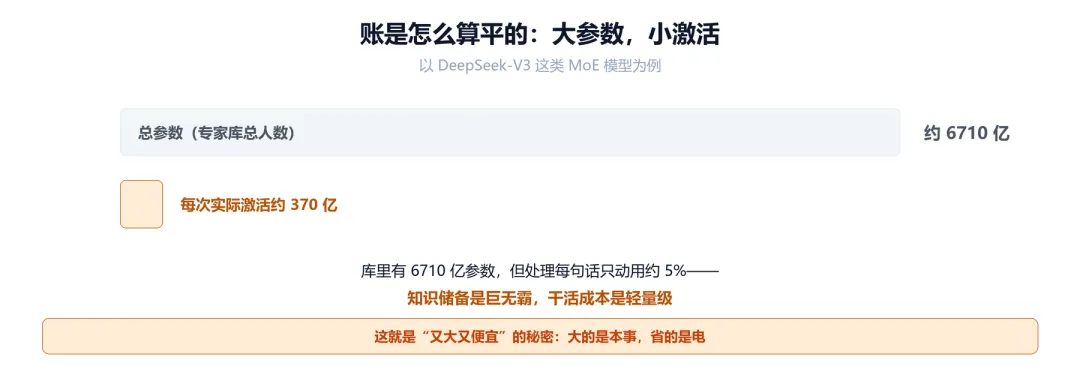
总参数 6710 亿,单次激活约 370 亿(公开技术报告数据) 算力成本跟着激活量走,不跟总参数走。MoE 的思路就在这:把知识储备做大,把单次计算做小。稠密模型想变聪明只能堆参数,堆一点贵一点;MoE 把“聪明”和“每次的计算量”这两件事解绑了。 附带的好处是快。每次回答要算的东西少了,同样的显卡能跑出更多字。便宜和快速,是同一枚硬币的两面。 训练侧也跟着受益。专家在训练时各自专注学一类模式,学得更快更深;同样的算力预算,MoE 能把模型的总知识量堆到稠密模型够不着的高度。大,就是这么“攒”出来的。 省出来的成本是实打实的。DeepSeek 公开的技术报告显示,V3 的完整训练只用两百多万 GPU 小时,折合约 558 万美元——放在动辄上亿美元训练成本的行业里,这个数字当时惊掉一片下巴。省下的钱反映到定价上,就是你看到的几毛钱一百万字。 有人担心便宜没好货。早期廉价模型确实有“便宜但笨”的问题,但 V3 的评测成绩当时冲进了全球前列,数学、代码这些硬指标跟国外旗舰掰手腕不落下风。便宜的模型考出了昂贵的分数,价格战这才变成行业共识,而不是廉价货的代名词。 四 便宜是怎么一层层传到你手上的 MoE 省下的成本不会停在实验室,它沿着一条链一路传导:省算力→训练便宜→推理便宜→定价便宜→免费可用。你在网页上白嫖的每一次对话,都是这条链的终点: 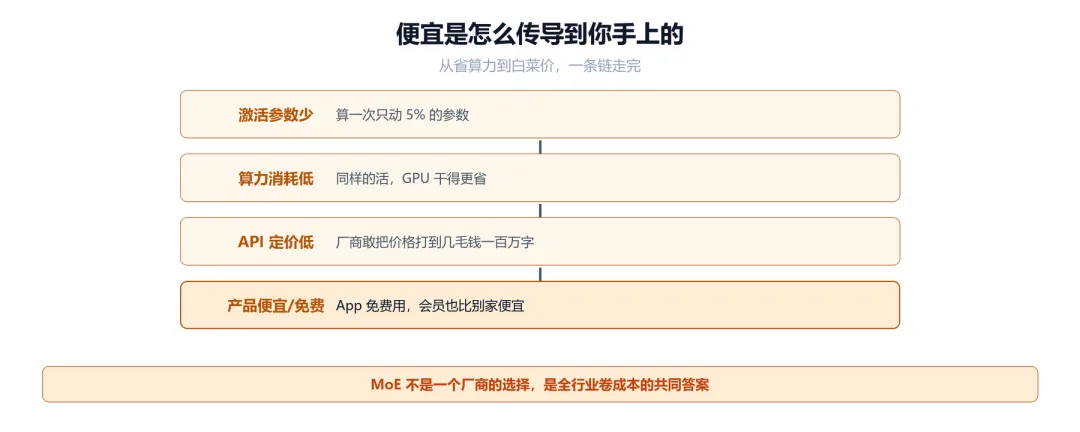
便宜传导链:从省算力到你手上的白菜价 MoE 常被当成 DeepSeek 的独门秘技,其实两样都不是:它不算新发明,思路学术界二十多年前就提出了,2023 年底 Mistral 开源 Mixtral 模型后彻底翻红。今天的国产主流大模型里,DeepSeek、通义千问的多个版本、文心一言等都采用了 MoE 结构——它是大模型行业卷成本的标准答案,不是某家的噱头。 MoE 也不是白赚的便宜。最要命的麻烦是显存:256 个专家都得待在内存里随时待命,哪怕大部分在睡觉,“工位”也得留着。所以 MoE 的部署门槛反而比同能力的稠密模型更高,这也是它主要活在云端、你的笔记本跑不了完整 V3 的原因之一。另一个麻烦是训练不稳定:256 个专家要养活均匀,不能有的忙死有的闲死,各家都有专门的平衡技巧,这才是真正的看家功夫。便宜的背后是更难的工程,不是魔法。 五 普通人懂这个概念有什么用 你不需要会算参数量,但懂 MoE,有三件事会看得更明白。 看价格不再困惑。 为什么有的模型 API 贵有的便宜?为什么免费产品能一直免费?很大程度取决于底层结构。便宜不等于低级——DeepSeek 已经证明了便宜和顶级能力可以共存。 看宣传不再上当。 看到“千亿参数大模型”的宣传语,多留个心眼:参数多不等于每次都用得多,关键看激活量。一家一万人的公司和一家五百人的公司,如果每次干活出的人数差不多,产出未必差多少。 看行业趋势心里有数。 这两年模型价格战越打越狠,根子就在 MoE 这类架构把成本打了下来。DeepSeek 能以挑战者姿态把第一梯队搅得天翻地覆,靠的不是营销,是结构级的成本优势——别人卖十块的活它卖五毛还有得赚,这仗没法打。受益的是所有用户:今天你免费就能用到的模型能力,放在三年前是企业级付费都买不到的。 看完可以做个小实验:同一个问题,分别问一个国产模型和国外旗舰模型,把答案放一起对比。你会得到两个感受:两边差距比想象的小;国产这份便宜,是真的。