ARTICLE · 1089076
跑 AI 视频,先别急着换显卡:一台 M1 Max 的四组实测
跑 AI 视频,先别急着换显卡:一台 M1 Max 的四组实测9 月 25 号晚上十点多,我把第一条视频扔进了 ComfyUI 的队列。 然后就去睡了。 第二天零点零三分,片子出来了。 2.33 秒。 我盯着屏幕上那两秒多的画面,心里其实挺平静的——因为它跑了 75 分 42 秒。 这台机器是三年前的 MacBook Pro,M1 Max 芯片,64G 内存。 跑的东西叫 MiniMax H3,一个能直接出带声音视频的模型。 模型一共 41 个 G,五个文件。 说实话,刚开始我以为这就是"苹果芯片不适合跑 AI"的又一个证据。 后来才发现,我想错了。 我到底跑了什么 先把条件交代清楚,免得看起来像在吹。 同一份工作流,同一个随机种子,同一段提示词。我只动两个东西: ① 分辨率:608p 还是 768p ② 步数:20 步基础模型,还是 6 步配加速模型 这里说的"加速模型"就是 turbo LoRA,一种给大模型挂上去的小补丁,能让它少走几步就出画面。 四组配置跑下来是这样: E1:608p · 20 步 · 不加速 → 75.7 分钟 · 322 KB E2:608p · 6 步 · 加速 → 25.8 分钟 · 638 KB E3:768p · 20 步 · 不加速 → 137.7 分钟 · 414 KB E4:768p · 6 步 · 加速 → 82.9 分钟 · 847 KB 四组的产物规格完全一样:56 帧,24 帧率,2.33 秒,自带一条 AAC 音轨。 也就是说,我拿"时间"和"文件体积"这两个数字就能把它们排个序。 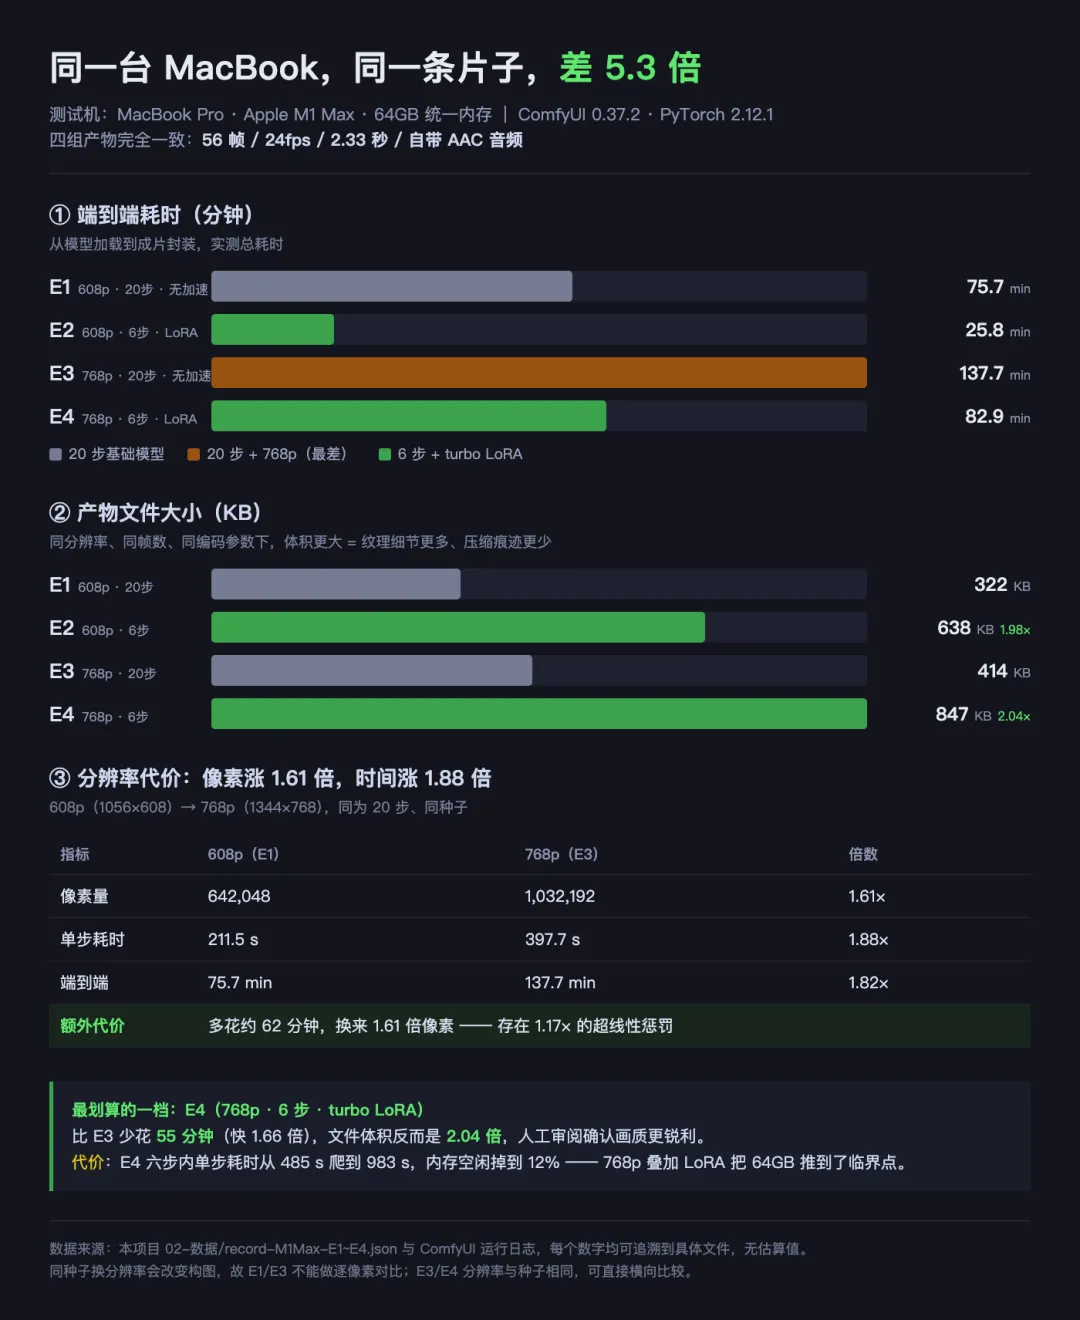
发现一:少走 14 步,画面反而更清楚 E1 和 E2 是同一个分辨率。 E1 跑 20 步,75.7 分钟。 E2 只跑 6 步,加加速模型,25.8 分钟。 快了 2.94 倍,省下大约 50 分钟。 看到这你可能觉得,那画质肯定要掉。 我当时也这么想。 结果文件体积是 638 KB 对 322 KB,将近两倍。 同分辨率、同帧数、同编码参数,体积大意味着什么? 意味着纹理细节更多,压缩痕迹更少。 我不太信,就把两条片子抽帧摆一起看。 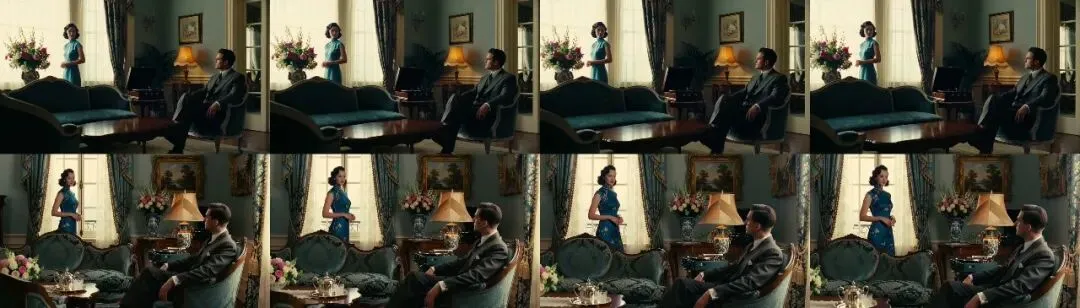
上排是 20 步,下排是 6 步加加速。 灯罩的纹理、花束的层次、茶具的反光、窗帘的褶皱,下排都更清楚。 768p 那两组对比更明显:E4 比 E3 少花 55 分钟,体积反而是 2.04 倍。 这里有个反直觉的地方。 加速模型的原理是让单步变慢——在 768p 下,E4 的单步耗时是 E3 的 2.09 倍。 真正的提速,完全来自步数从 20 降到 6。 所以"少步数加加速模型"这套组合,不是拿画质换时间。 它是换了一条更省事的路子。 省时间,画面还更好。 发现二:慢的原因不是芯片弱 这条是我觉得最值钱的。 我去翻了 ComfyUI 的运行日志,里面有一行: Native ops: , emulated ops: mxfp8, convrot_w4a4, float8_e4m3fn, float8_e5m2, asym_w4a8_int8, nvfp4, int8_tensorwise 前面那个 Native ops: 后面是空的。 后面跟了七种压缩格式的名字。 意思是:这七种量化格式,在这台 M1 Max 上一个都没有硬件加速。 每走一次矩阵乘,都得先做一次软件反量化。 211 秒一步,就是这么来的。 顺便解释一下,nvfp4 是这批格式里最激进的一种,用 4 位来存权重。 不是 M1 Max 算力不行。 是它根本没有对应这些格式的指令。 我又去翻了 ComfyUI 的源码,找到它判定"原生支持"的条件: ① nvfp4 需要 NVIDIA,而且计算能力要 ≥ 10,也就是 50 系 Blackwell 起步 ② mxfp8 还要再叠一个 torch ≥ 2.10 的条件 ③ int8 那几个,需要 NVIDIA,而且不能是苹果的 MPS 后端 苹果的判定直接返回假,永远拿不到。 那 NVIDIA 那边呢? 40 系及以下,在 nvfp4 上同样要走软件模拟。 换句话说,这个模型最大的那份量化红利,只有 50 系能吃到。 如果你正准备为了跑 AI 视频换显卡,这条值得先看清楚。 发现三:分辨率不是免费的,构图还会跟着变 我把 608p 提到 768p,像素量涨了 1.61 倍。 单步耗时涨了 1.88 倍。 多出来的那 0.27,是注意力开销——画面一大,它涨得比像素还快。 落到时间上,就是从 75.7 分钟变成 137.7 分钟。 多花 62 分钟,换 1.61 倍的像素。 还有一个我原本没想到的事。 E1 和 E3 用的是完全相同的随机种子和提示词,我只是把分辨率调高了。 结果构图变了。 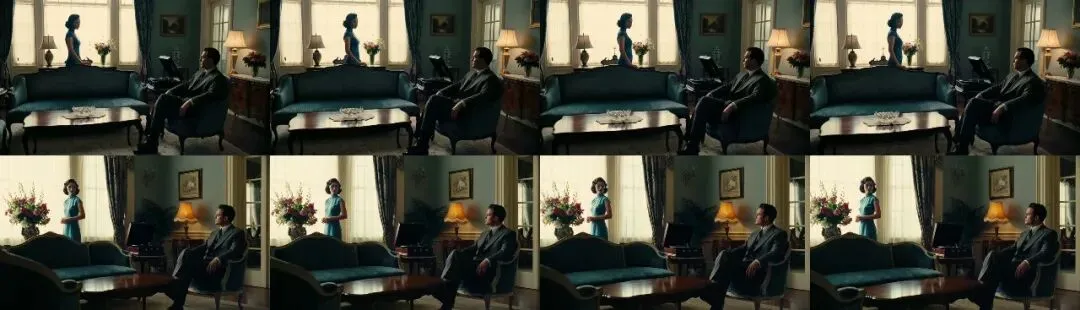
E3 的画面明显更"近",人物和沙发都更大,能看到的房间范围更小。 这是因为画面尺寸一变,同一个种子在潜空间里的映射方式就跟着变了。 实践上的意思是:想靠提高分辨率"把同一个画面变清楚",做不到。 需要特定构图,就得在目标分辨率下重新抽卡。 画质上的实话 既然说到这,不足的地方我也讲清楚。 608p 下,整体偏软。 面部和织物的细节不够,有一点涂抹感。 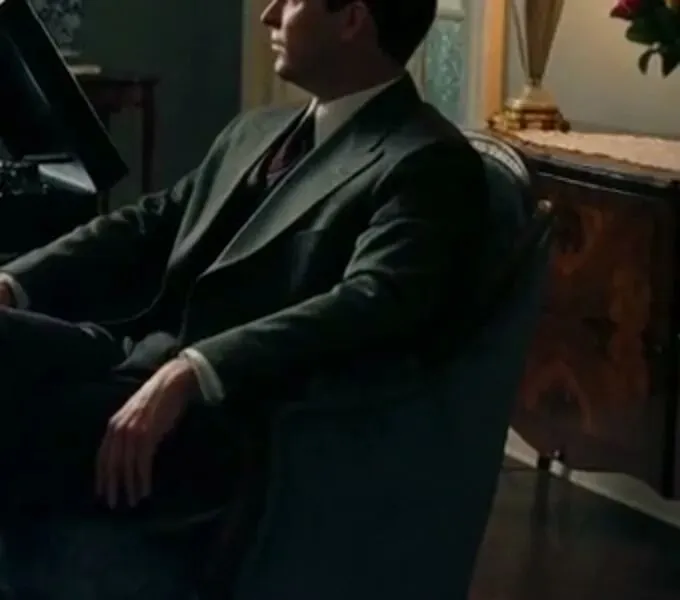
手部结构也不够清晰,指节是含混的——这是视频生成的老毛病了。 不过有一点比我预期好。 六帧抽出来看,人物身份、服装颜色、场景布局从头到尾是一致的。 没有跳脸,没有肢体粘连,也没有画面撕裂。 作为"跑通验证",这条完全达标。 作为能直接发的素材,608p 的细节不够,得上 768p。 真正做成一条能发出去的短片 上面那些都是对照实验,产物只有 2.33 秒。 我想做的其实是一条能发出去的短片。 素材是一张真人照片,一个女生在直播间里的截图。 目标:让她跳起来,跳够十几秒。 这个过程我翻车了一次,成功了三段。 第一个坑,也是最贵的那个:帧数不能省。 我为了省时间,把帧数从 124 降到了 22。 为什么是 124? 因为模型节点的说明里写着,训练范围大约是 124 到 362 帧。 22 帧远在下限之外。 结果片子跑到第 2 到第 4 帧,人就变成了另一个人。 衣服也换了——原图的米白细肩带上衣,变成了背心加袖套,配白色短裙。 场景也换了,变成一个有环形灯的现代房间。 0.92 秒的片子,整条作废。 我原本想着省 58 分钟。 实际付出的代价,是把整条重跑一遍。 说实话,这个坑花得值。 它让我明白这类模型有一条硬边界,边界之外不是"质量差一点",是"完全不是你要的东西"。 改回 124 帧之后,从头到尾都是同一个人。 第二个坑:参考图里没有的信息,必须写死。 我给的是上半身截图。 下半身,图里没有。 那模型怎么办?它只能自己编。 第一次编出来的就是那条白短裙。 解法很直接:把缺的部分明确写出来,让它照着画,别自由发挥。 我在提示词里加了这么一段: 【服装 · 必须全程一致】 上身:米白色细肩带紧身上衣(与输入图片完全一致) 下身:米白色高腰阔腿长裤 脚部:白色平底运动鞋 不得更换任何一件衣物,不得把长裤变成裙子或短裤。 后面出来的就是米白阔腿裤配白鞋,跟要求对上了。 第三个坑:不要一上来就要全身。 单张参考图里,人物占画面越大,身份就越稳。 面部特写最稳,全身最不稳——因为下半身得靠模型补。 我改成了"先近后远":前一段先保持中近景把身份定住,后面几段再慢慢拉远。 比一上来就全身好得多。 第四个坑:提示词别写太长。 我第一版的提示词 2340 个字,写了 9 段完整编舞、17 个章节。 模型在动作转折的地方,直接重新生成了一个人。 后来砍到 760 字左右,只描述一个连续动作。 身份就稳了。 5 秒钟装不下 9 个镜头。 每多一个转折,就多一次把脸丢掉的机会。 怎么把 5 秒变成 17 秒 单段最长 5.17 秒,124 帧,不够发。 我的做法是续接:用上一段的最后一帧,当作下一段的第一帧。 v2 是 124 帧、5.17 秒,首帧用参考图。 v3 是 73 帧、3.04 秒,首帧用 v2 的末帧。 v4 是 90 帧、3.75 秒,首帧用 v3 的末帧。 一段接一段,最后拼成 17 秒。 这个方法为什么可靠?我算了一下拼接处的像素差,平均 2.94 / 255。 基本等于无缝。 原因是图生视频的第一帧是直接拉伸到画布的,输入帧本身已经是目标分辨率,所以输出几乎等于输入。 而且它风险小。 每段三五秒单独验证,出问题只损失一段,不用重跑整条。 我预测错了两次 这部分我犹豫要不要写。 但数据是我自己跑的,错了就是错了,记下来比藏起来有用。 第一次:我预测 768p 的单步耗时会是 608p 的 1.5 到 1.7 倍。 实测 1.88 倍。 我把注意力开销估低了。 第二次:我把 608p 上测出来的加速模型系数 0.961,直接套到 768p 上,预测 E4 端到端大约 44 分钟。 实测 82.9 分钟,低了 1.88 倍。 毛病是一样的:在一个条件下测出的系数,不能搬到另一个条件下用。 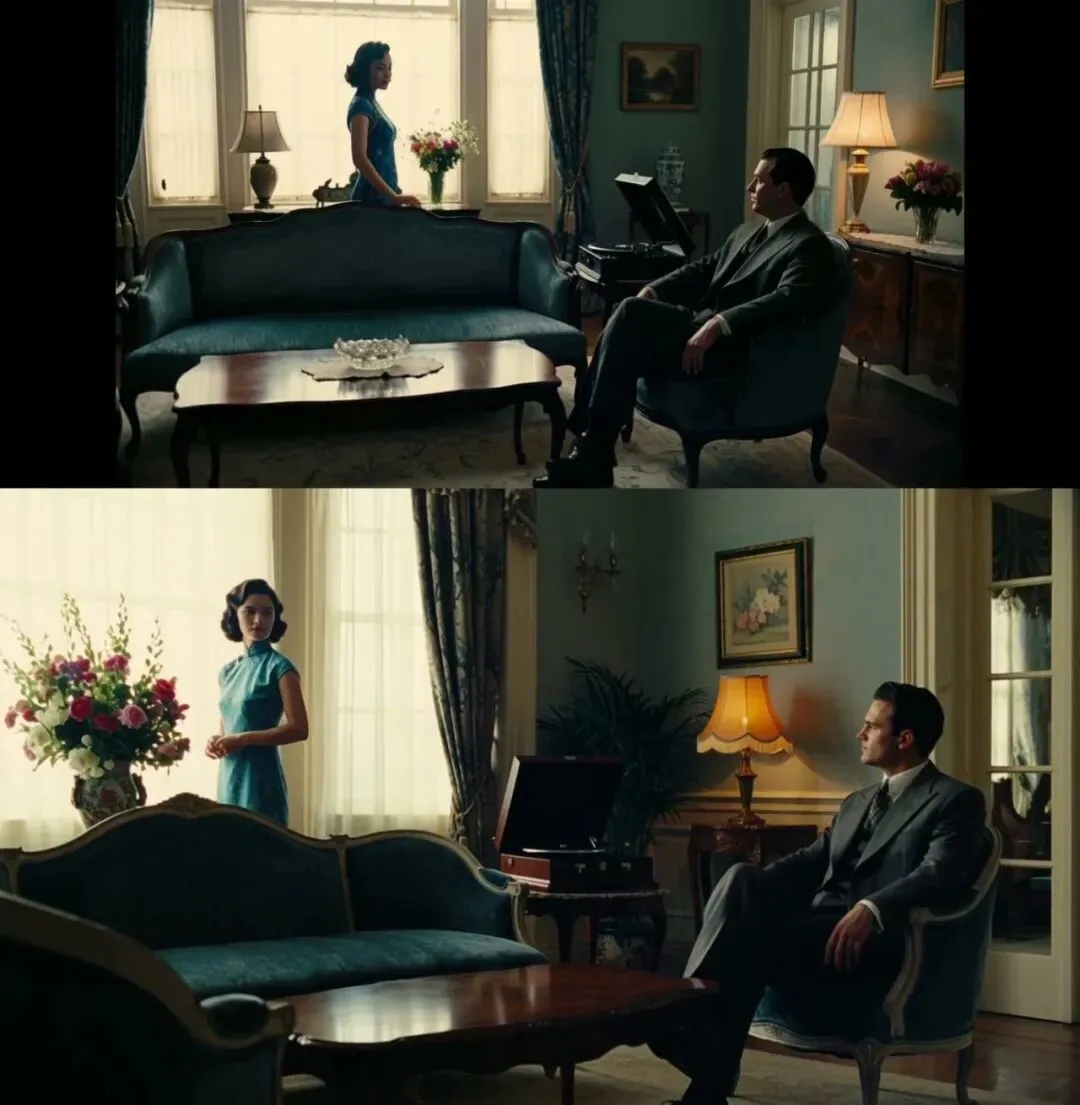
这条教训很朴素,但我确实犯了两次。 还有一个我没搞明白的事 有一次图生视频的任务,单步耗时 11,850 秒。 正常值是 211 秒。 56 倍。 按这个速度跑满 20 步,要 65 个小时。 我当时已经跑了 7.5 小时,手动停了。 我排除了几个可能: ① 不是画面尺寸问题。我读了源码,算过张量尺寸,跟正常任务完全一样。 ② 不是卡死。CPU 时间一直在涨,步数从 1/20 走到了 2/20。 ③ 不是内存不够。后面几个任务在内存余量 25% 到 59% 之间都很正常。 根因没找到。 我只能说"没复现"——后来换了一张图配 2340 字提示词,单步 146 秒,完全正常。 怀疑方向是超长提示词配九宫格图,那次提示词有 4081 字,多模态序列可能太长了。 但没验证,所以不算结论。 现在的做法是:图生视频先用 2 步小规模试跑。 确认单步耗时的量级正常,再放开跑。 不试就直接上 20 步,一次就是几十个小时。 所以到底该怎么配 把结论收一下。 如果机器不用换,先把配置换掉: ① 快速抽卡、试提示词:608p + 6 步 + 加速模型,约 26 分钟 ② 出成片:768p + 6 步 + 加速模型,约 83 分钟 ③ 不推荐:20 步基础模型,多花 55 分钟,画质还更差 如果要买卡: ① 显存别低于 24G。扩散模型 19.53G 加文本编码器 14.61G,加起来 34.5G。8G 和 16G 的卡装不下,必然走分块加载,速度会被拖垮。 ② 想要量化加速,看 50 系。nvfp4 的原生门槛是计算能力 ≥ 10,40 系及以下都要走软件模拟。 ③ 苹果这边,别指望换代解决速度问题。除非它补齐了这些矩阵乘算子,否则还是"装得下,算得慢"。 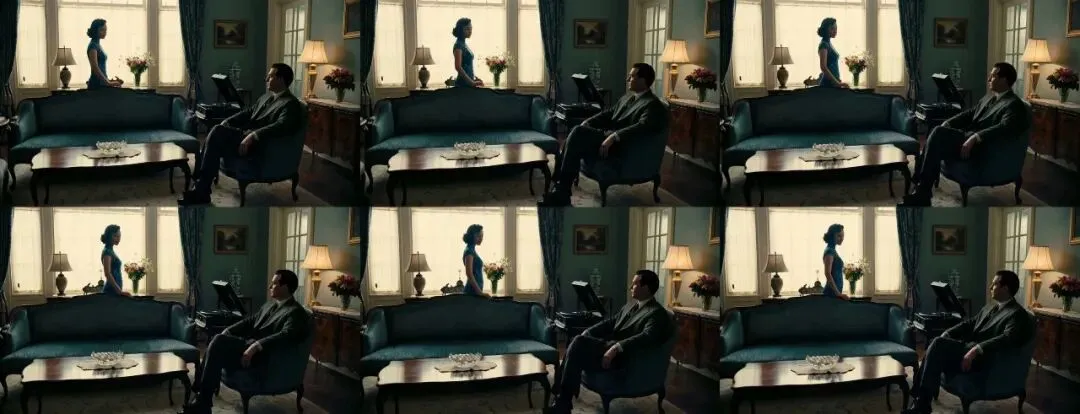
说句实在话 这两天我一共跑了四组对照,加一次翻车,加三段续接。 最有用的一条,不是"该买什么卡"。 是我先去翻了日志里那行 Native ops:。 它直接告诉我,慢在哪里,换什么才有用。 如果那天我没翻日志,可能现在已经下单一块新显卡了。 先把方法调对,再谈硬件。