ARTICLE · 1104839
做了一个要素式起诉状APP,我为什么最后分享Skill
我的电脑里,现在有一个“要素式起诉状助手”。
双击打开,把已经写好的普通Word起诉状拖进去,它会识别案由,调用对应模板,再生成一份要素式起诉状和核对表。
这个APP已经做出来了。但这次准备分享给同行的资料包里,我没有把APP放进去。我准备的八类案由的要素式诉状skill。
我整理的是它背后的八类案由Skill。
为什么做了一圈,最后分享的是Skill?这里面有一些研发过程中的取舍,也有我对律师小工具的一点想法。
我想省掉的,是写完诉状之后的那一遍搬运
起诉状已经写好,主体、诉请、核心事实也整理过了。要转成要素式文书,又得打开另一份表格,找到栏目,把同一份信息拆开再填一次。
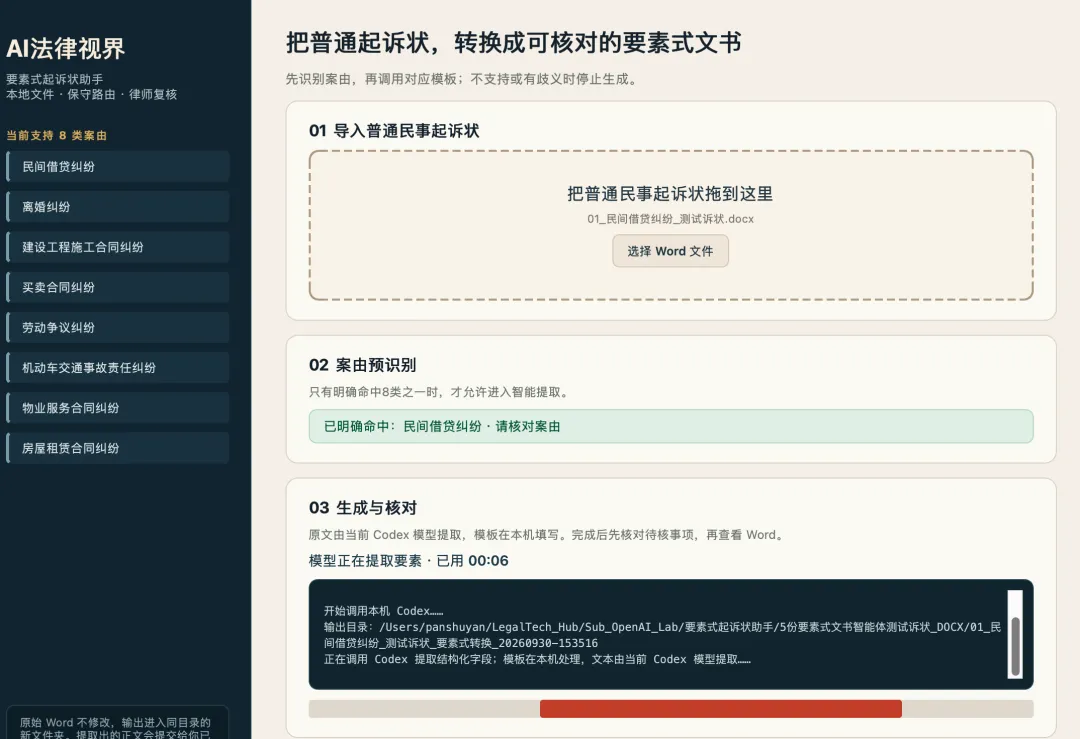
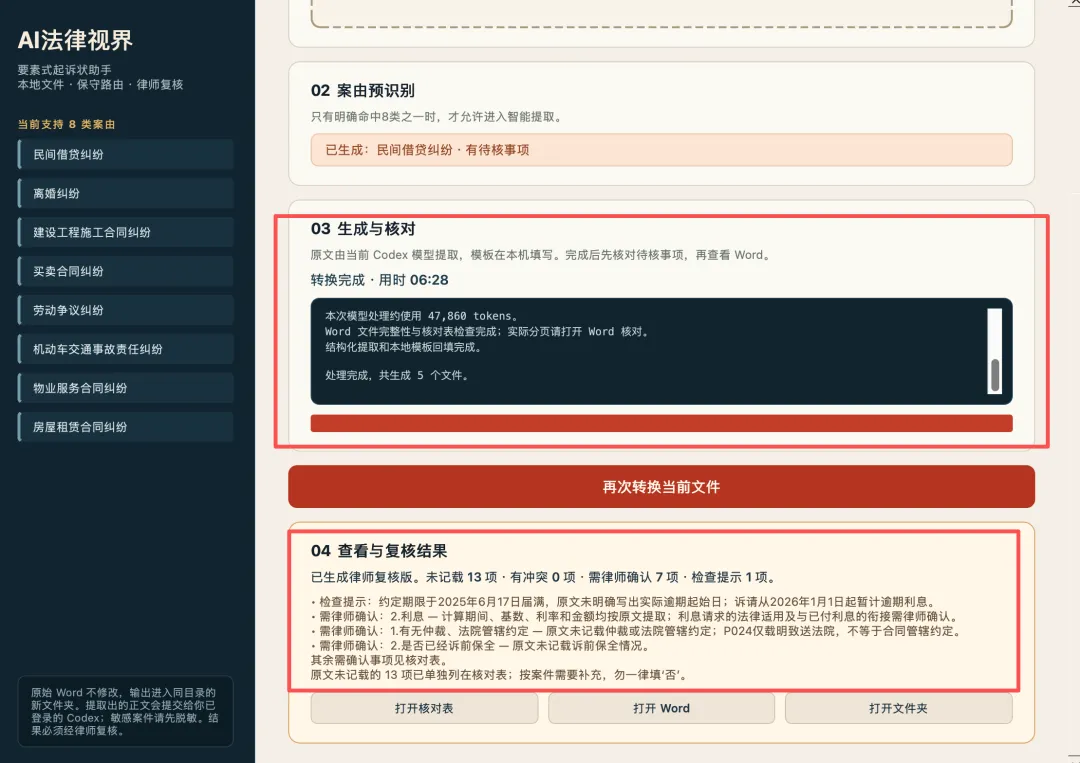
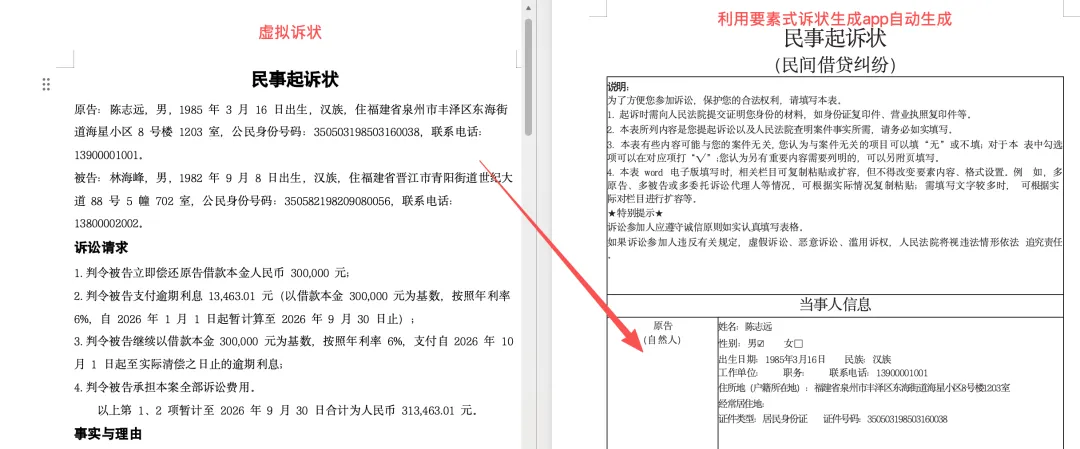
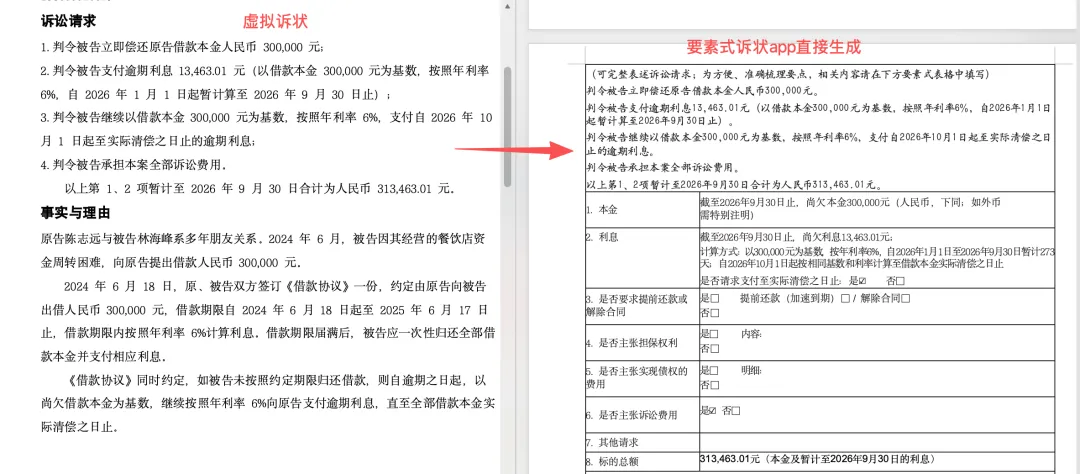
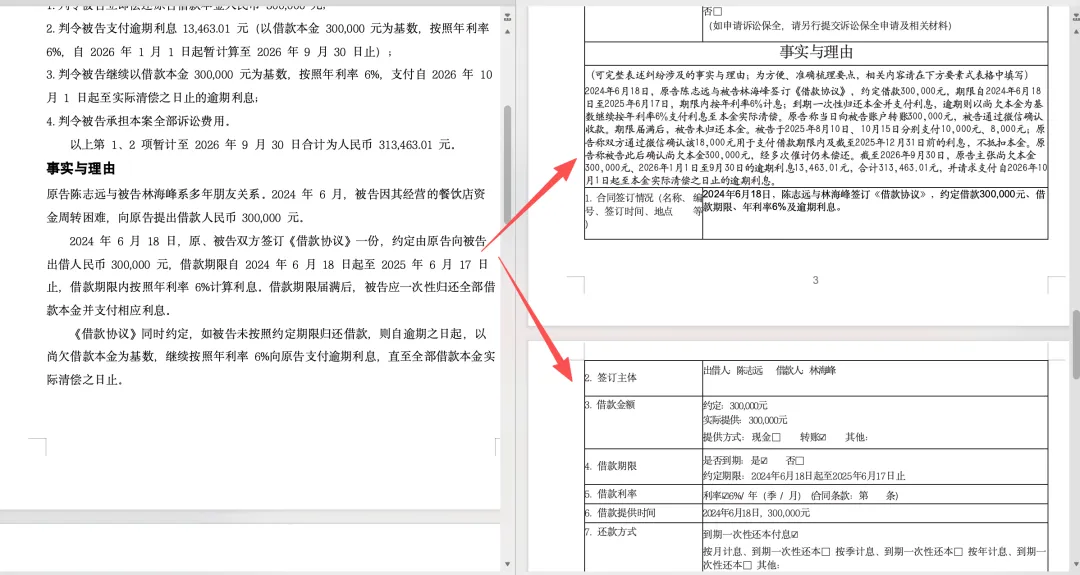
这一步我想让AI先做。
我采用的研发方式,是把使用要求告诉Codex,让它修改项目代码,再拿文书检查结果。我负责提出律师使用时的要求,发现不对的地方,继续要求它调整。
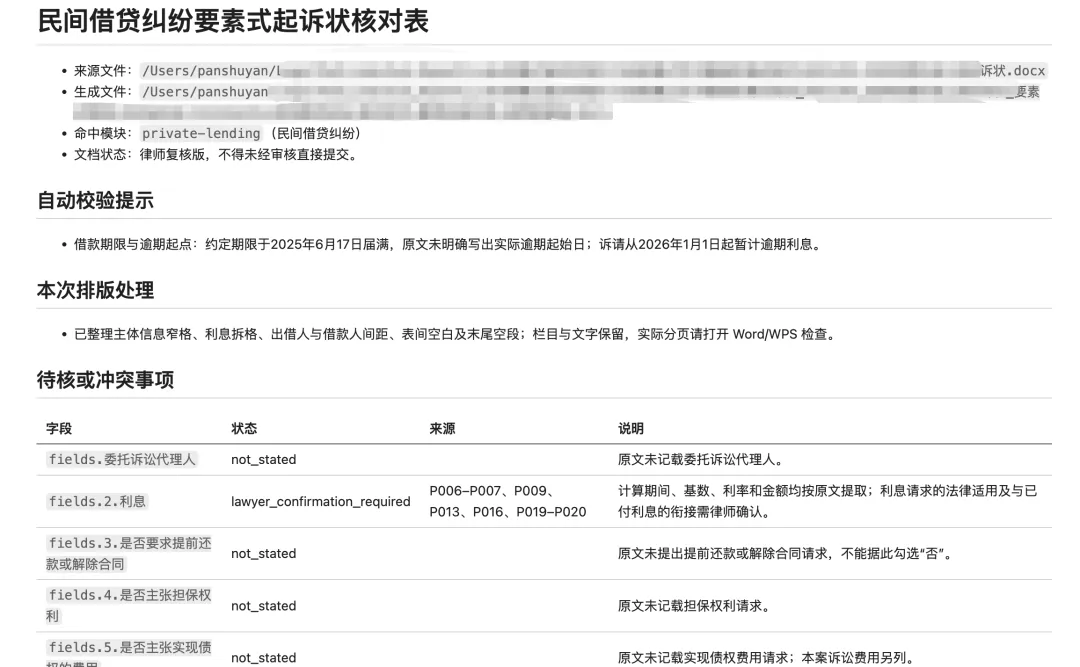
一开始,任务并不复杂:读取普通起诉状,识别案由,把已经写明的内容填进对应的Word模板,保留原件,再给我一份核对表。
但做起来以后,要求一点点变具体了。
当事人信息要拆开。公司名称、住所、统一社会信用代码、法定代表人,不能塞成一段;自然人的身份证号,也不能一路接在住址后面。
诉请要放对位置。同样是一个金额,可能是本金、已付款、尚欠款,也可能是暂计利息。光把数字提取出来,不能完成填表。
原文没写的内容要留着。没有提保全,没有写调解意愿,不能顺手替我勾上“否”。
这些要求逐渐写成了规则,配上各案由的字段说明、模板和填写脚本。APP的工作,就有了一套可以反复调用的基础。读取Word、选择模板、写入文件这些明确的步骤交给程序,叙述中的要素提取交给模型,然后再做填写校验。
后来我又让Codex做了Mac界面。这样自己用起来更顺手:拖入文件,看到处理进度,完成后直接打开Word或核对表,不必每次重新交代整个流程。
APP方便我使用,分享它却多了一层工作
走到这一步,我开始考虑怎样把这套东西分享给同行。
发一个APP,听起来最方便。下载,双击,把文件拖进去。
但我在研发过程中,都遇到过启动问题。要把它当成一个可以广泛分发的软件,因律师们的电脑配置不同,可能会遇到安装、兼容、更新和故障排查。
这些事情值得做,但眼下我更想先分享已经整理出来的转换方法。
APP里哪些部分负责识别和提取,哪些部分负责填写Word?原文缺失时怎样处理?一个勾选有什么依据?以后发现身份证又填错了,究竟要改哪条规则?
这些内容都可以放进Skill包。
已经在用Codex等支持本地Skill和脚本执行工具的同行,可以按说明安装,直接拿文书调用。也能打开包里的规则、字段说明和脚本,看看它究竟怎样工作。
以后我修正一条共同的填写规则,可以同步到APP和Skill里。分享这套规则,比要求大家使用和我完全一样的桌面入口,更适合现阶段。
当然,Skill也有门槛。它需要能调用Skill的AI工具,还需要Python及相应依赖。对完全没有接触过这些工具的同行,一个完善的APP可能更容易上手。
所以我暂时保留APP供自己使用,先把要素式起诉状Skill整理出来公开分享。APP以后是否单独提供,要等更多环境下的测试。
这个Skill包里,有八类模板,也有填写的约束
我把它命名为 element-pleading-suite,也就是“要素式起诉状转换套件”。
当前支持八类案由:
民间借贷纠纷; 离婚纠纷; 建设工程施工合同纠纷; 买卖合同纠纷; 劳动争议纠纷; 机动车交通事故责任纠纷; 物业服务合同纠纷; 房屋租赁合同纠纷。
包里有各案由的字段说明、法院公开的Word模板、提取与填写脚本,以及使用说明和测试文件。
完整流程是:先读取普通诉状并留下来源位置,再确认案由,提取相应要素,填写模板副本,最后生成要素式Word和转换核对表。
案由不清楚,需要先确认;不在支持范围内,就停止。不能看到材料里有“借款”两个字,便不顾其他内容套进民间借贷模板。
对于原文已经写明的内容,记录来源;对于缺失、冲突或者需要律师判断的内容,留在核对表中。
比如原文没有写担保,不推断“无担保”。证据材料没有实际读取,也不把一个证据名称写成“已经证实某项事实”。
这里还要说清楚:沿用法院公开模板,生成时做必要的排版整理,并不意味着每一页都与空白模板完全一致。长文字会改变行高和分页,具体法院如果有专用版本,还要另行核对。
公开之前,我又让它跑了五份虚拟诉状
这次我没有只检查开发目录里的脚本。
我让Codex从准备分享的压缩包中独立解出Skill,再用五份虚拟诉状重新提取要素、生成文书,没有直接拿之前整理好的数据回填。
这五份分别是民间借贷、建设工程、劳动争议、交通事故和离婚。
首轮前四份生成成功,离婚那份被校验拦住了。
虚拟诉状写的是:一方支付日常抚养费,部分大额教育、医疗支出由双方分担。程序却把费用“承担主体”中的原告和被告一概视为只能选一个。
这条规则过于简单。
直接抚养归属的选项,需要处理互斥;费用承担有时可以由双方分别负担。程序不能把它们当成同一个问题。
我让Codex修正这条校验:原文明确写了双方分担,就允许相应选择,并写清各自范围;没有依据的双方勾选,仍然拦住。随后按照原文明确日常支付与大额支出的分担方式,再次回填。
修正后,五份都生成了要素式Word和核对表,也做了PDF版面检查。
这一处修改提醒我,法律工具的检查规则也需要测试。限制加得越严,并不一定越准确;它还得分清栏目究竟在问什么。
本轮完整生成实测覆盖的是五类,另外三类做了模板和程序检查。支持八类,不能写成八类都做过同样的完整实测。
目前十二项程序回归检查通过。这些结果只对应当前版本、这批虚拟样本和检查项目,还不足以给出一个普遍准确率,更谈不上拿到真实诉状就免复核提交。
这次公开的是Skill,先拿一份虚诉状试试
我会把整理后的八类案由Skill包提供给同行试用。
安装时需要保留整个文件夹,里面的模板和脚本都要一起放进去,不能只复制那份 SKILL.md。
以本次使用的Codex环境为例,按包内说明安装后,可以这样交代任务:
使用 element-pleading-suite,将这份已经完成的普通Word起诉状转换为对应案由的要素式起诉状,输出到新文件夹,同时生成核对表,保留原件。
第一次建议用虚拟的材料,先检查核对表,再打开生成的Word,对照原文看主体、诉请、金额、日期和勾选,最后看实际分页。
还要留意模型的数据处理方式:读取文件、填写模板可以在本机完成,但本次使用Codex云端模型提取要素,材料内容会进入模型处理流程。一个本地APP或本地Skill,都不能据此称为全程离线。
同行试用后,如果发现问题,反馈可以具体到:哪个案由、哪一栏、原文如何表述、最后填成了什么。需要脱敏案件的信息请先脱敏。
这次先把八类拿出来。让同样写过这些诉状的人,看看哪些格子填得顺,哪些地方还得继续改。
想试用的同行,可以关注公众号「AI法律视界」,进入公众号对话框,回复关键词「要素式」,获取八类案由 Skill 完整包的下载方式和安装说明。本次分享的是 Skill,暂不提供 APP 安装包。
关于作者
潘淑燕,执业律师、法律 AI 讲师,长期关注生成式 AI、智能体与律师实务的结合,持续测试 Claude Code 、Codex等 AI 工具在案件材料整理、证据分析、法律检索和律师工作流中的实际应用。
运营公众号“AI法律视界”,主要分享法律 AI 工具实测、律师 AI 工作流,以及人工智能进入法律实务后的真实经验与思考。