ARTICLE · 1108509
RAG 面试 15 问:从文档分块到线上排障,把完整链路讲清楚 -通用第03期
同样是“RAG 答错了”,原因可能在文档分块、候选召回、重排序,也可能在上下文组装和生成。这 15 题沿着整条链路展开,既讲原理,也讲权限、版本更新与 Java 服务的落地边界。
下方原题、回答、追问、减分回答和链接按原文保留。11 张手绘图与技术校注均单独标注;原文的仓库内相对链接保留,另补可独立打开的在线入口。
原材料:通用第 03 期 · RAG 检索增强生成。项目地址:https://github.com/liulangjietou/customer_work。
通用第 03 期 · RAG 检索增强生成
本期结论:RAG 的八股题覆盖“离线建库 → 在线检索 → 生成 → 评测”四个环节。能区分不同环节问题的候选人, 才能在“效果不好”时准确定位是没检索到、检索到了但排序不对,还是检索对了但模型没用好。
题量 15。
Q1 RAG 的完整流程是什么?
考察点:整体认知。
参考回答
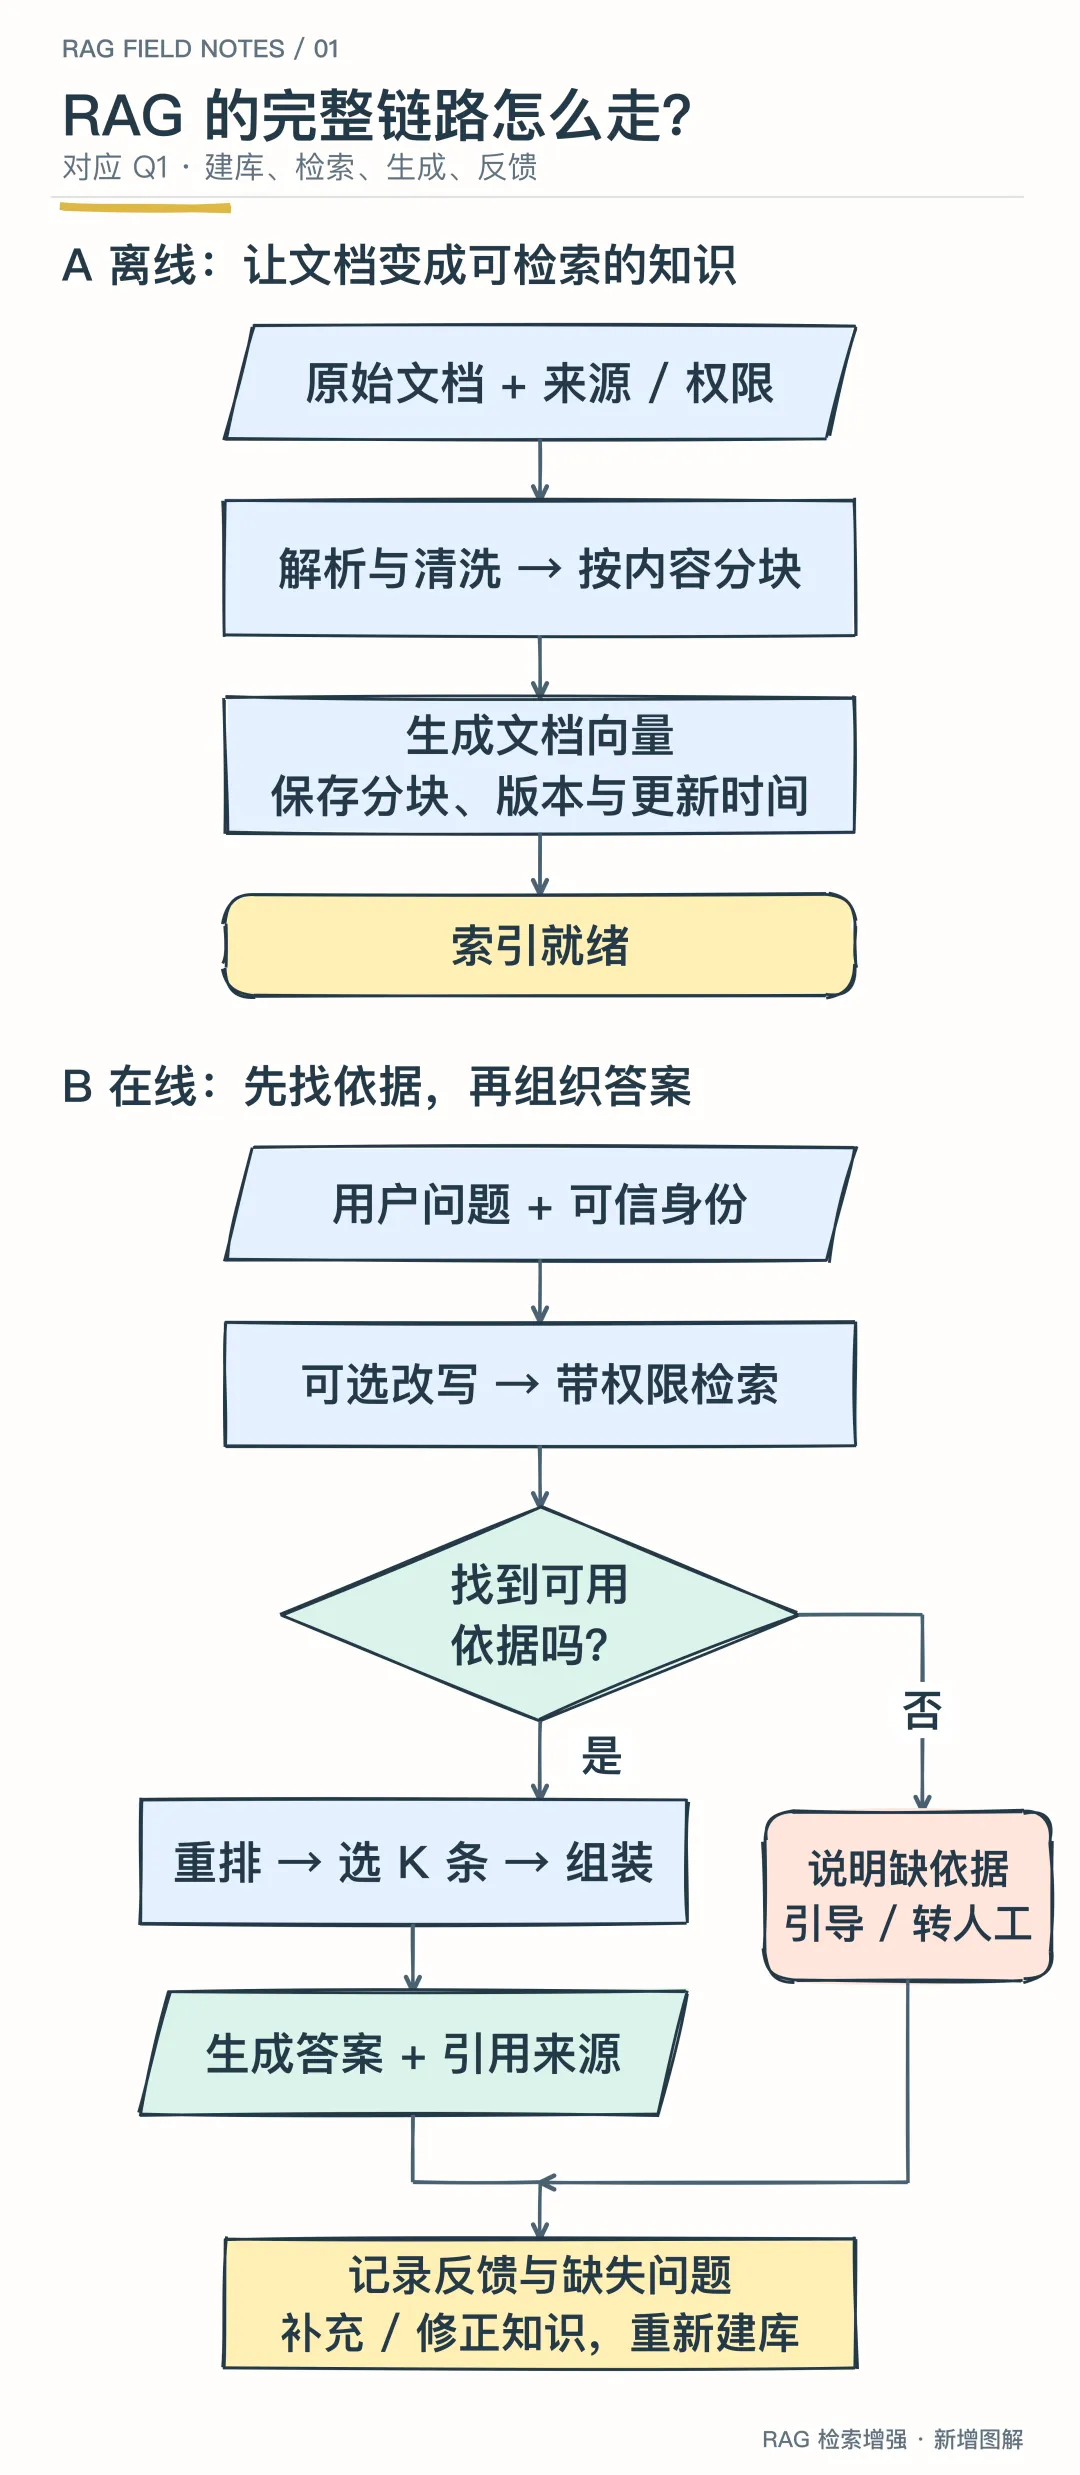
离线阶段:文档解析 → 清洗 → 分块 → 生成向量 → 写入向量库(同时保存元数据:来源、权限、版本、更新时间)。 在线阶段:用户问题 → 查询改写(可选)→ 检索(向量、关键词或混合)→ 重排序 → 选取前 K 条 → 拼进提示词 → 模型生成答案,并附上引用。 闭环:记录没检索到的问题和用户反馈,补充或修正知识。
追问:哪个环节最容易出问题? 分块和检索。答案质量的上限由“是否检索到正确的片段”决定。
减分回答:只说“把文档转成向量存起来,再相似度搜索”。
图解 01 · 离线建库与在线问答分开看,反馈回到知识维护。
Q2 文档分块有哪些策略?块大小怎么选?
考察点:分块对效果的影响。
参考回答
策略:固定长度加重叠;按句子或段落;按标题等文档结构;语义分块(相邻片段语义差异大时断开); 父子块(用小块检索,把所在的大块交给模型)。 块大小的取舍:块太大,一个块包含多个主题,向量被“平均”,检索不准;块太小,上下文断裂,模型只拿到半句话。 重叠:相邻块保留少量重叠,避免关键信息正好被切断。 按内容类型选择:FAQ 按一问一答切;长篇制度按标题层级切;表格尽量保持整表或按行加表头;代码按函数或类切。 怎么确定:用检索评测指标(如 Recall@K)比较不同方案,不要凭经验固定一个数。
追问:表格和图片怎么处理? 表格转成结构化文本(保留表头),或者为表格生成一段文字描述; 图片可以做 OCR 或生成描述,同时保留原图的引用。
减分回答:“统一按 512 个 token 切”。
Q3 如何选择 Embedding 模型?
考察点:选型维度。
参考回答
效果:在自己领域的数据上评测召回率,公开榜单只作参考;中文场景要选中文效果好的模型。 维度:维度越高表达能力可能越强,但存储和计算成本越高。 最大输入长度:决定单个块能有多大。 成本与部署:API 调用还是本地部署;数据是否能外传。 一致性:写入和查询必须使用同一个模型;更换模型需要全量重建索引,最好按 Embedding 版本分区,新旧并行后再切换。
追问:查询和文档用同一个 Embedding 方式就一定合适吗? 不一定。问题通常很短,文档很长, 部分模型区分“查询向量”和“文档向量”的用法;也可以用 HyDE 等方法缩小两者的差距。
减分回答:“选维度最高的模型”。
图解 02 · 按内容切分,再用领域评测确定分块和 Embedding 方案。
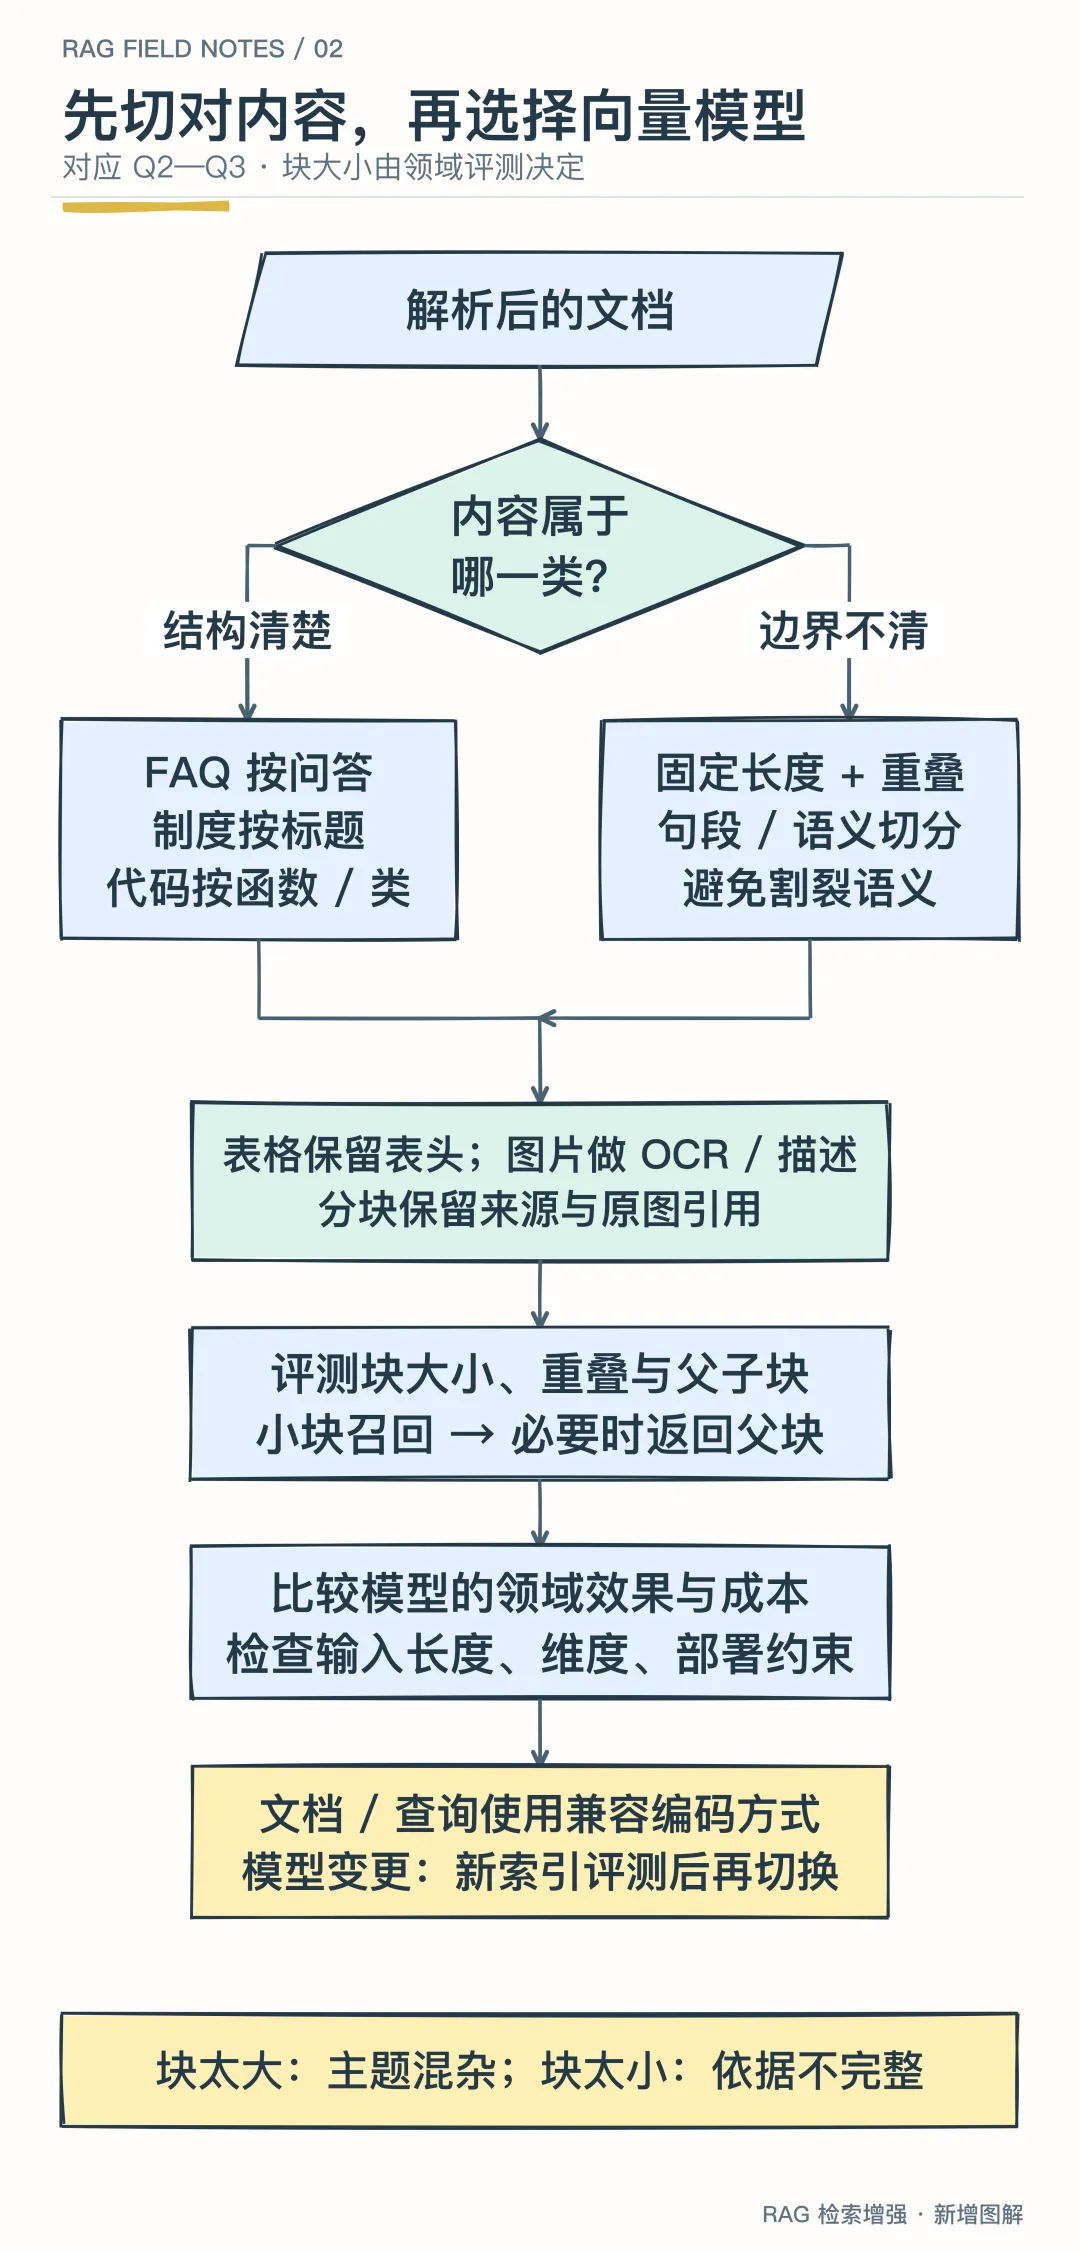
新增技术校注(Q3):一致性的核心是查询向量与文档向量处于兼容的向量空间,并使用模型要求的 query/document 编码方式;仅仅维度相同不足以证明兼容。换成不兼容的模型后,原文档需要重新编码,新旧索引分别评测后再切换。
Q4 向量索引 HNSW 和 IVF 的原理与参数怎么理解?
考察点:近似最近邻检索的基础。
参考回答
为什么需要近似检索:精确检索要和所有向量逐一比较,数据量大时太慢;近似检索用少量精度换取速度。 HNSW(分层可导航小世界图):构建多层图,从最稀疏的上层开始贪心搜索,逐层向下细化。 查询速度快、召回率高,但内存占用大,构建较慢。常用参数:每个节点的连接数(M)、构建时的候选数(efConstruction)、 查询时的候选数(efSearch,越大召回率越高但越慢)。 IVF(倒排文件):先用聚类把向量分到若干个桶里,查询时只搜索离查询最近的几个桶。 参数有桶的数量(nlist)和查询的桶数(nprobe)。常和 PQ(乘积量化)组合使用,以压缩内存。 选型:数据量中等、对召回率要求高时用 HNSW;数据量极大、内存受限时考虑 IVF 加量化。
追问:带过滤条件的向量检索有什么问题? 如果先检索再过滤,过滤后可能不够 K 条; 先过滤再检索又可能破坏索引效率。要看向量库是否支持在检索过程中应用过滤条件。
减分回答:只知道“向量库能做相似度搜索”。
图解 03 · HNSW 逐层搜索,IVF 先选桶;两者的候选范围都影响召回与耗时。
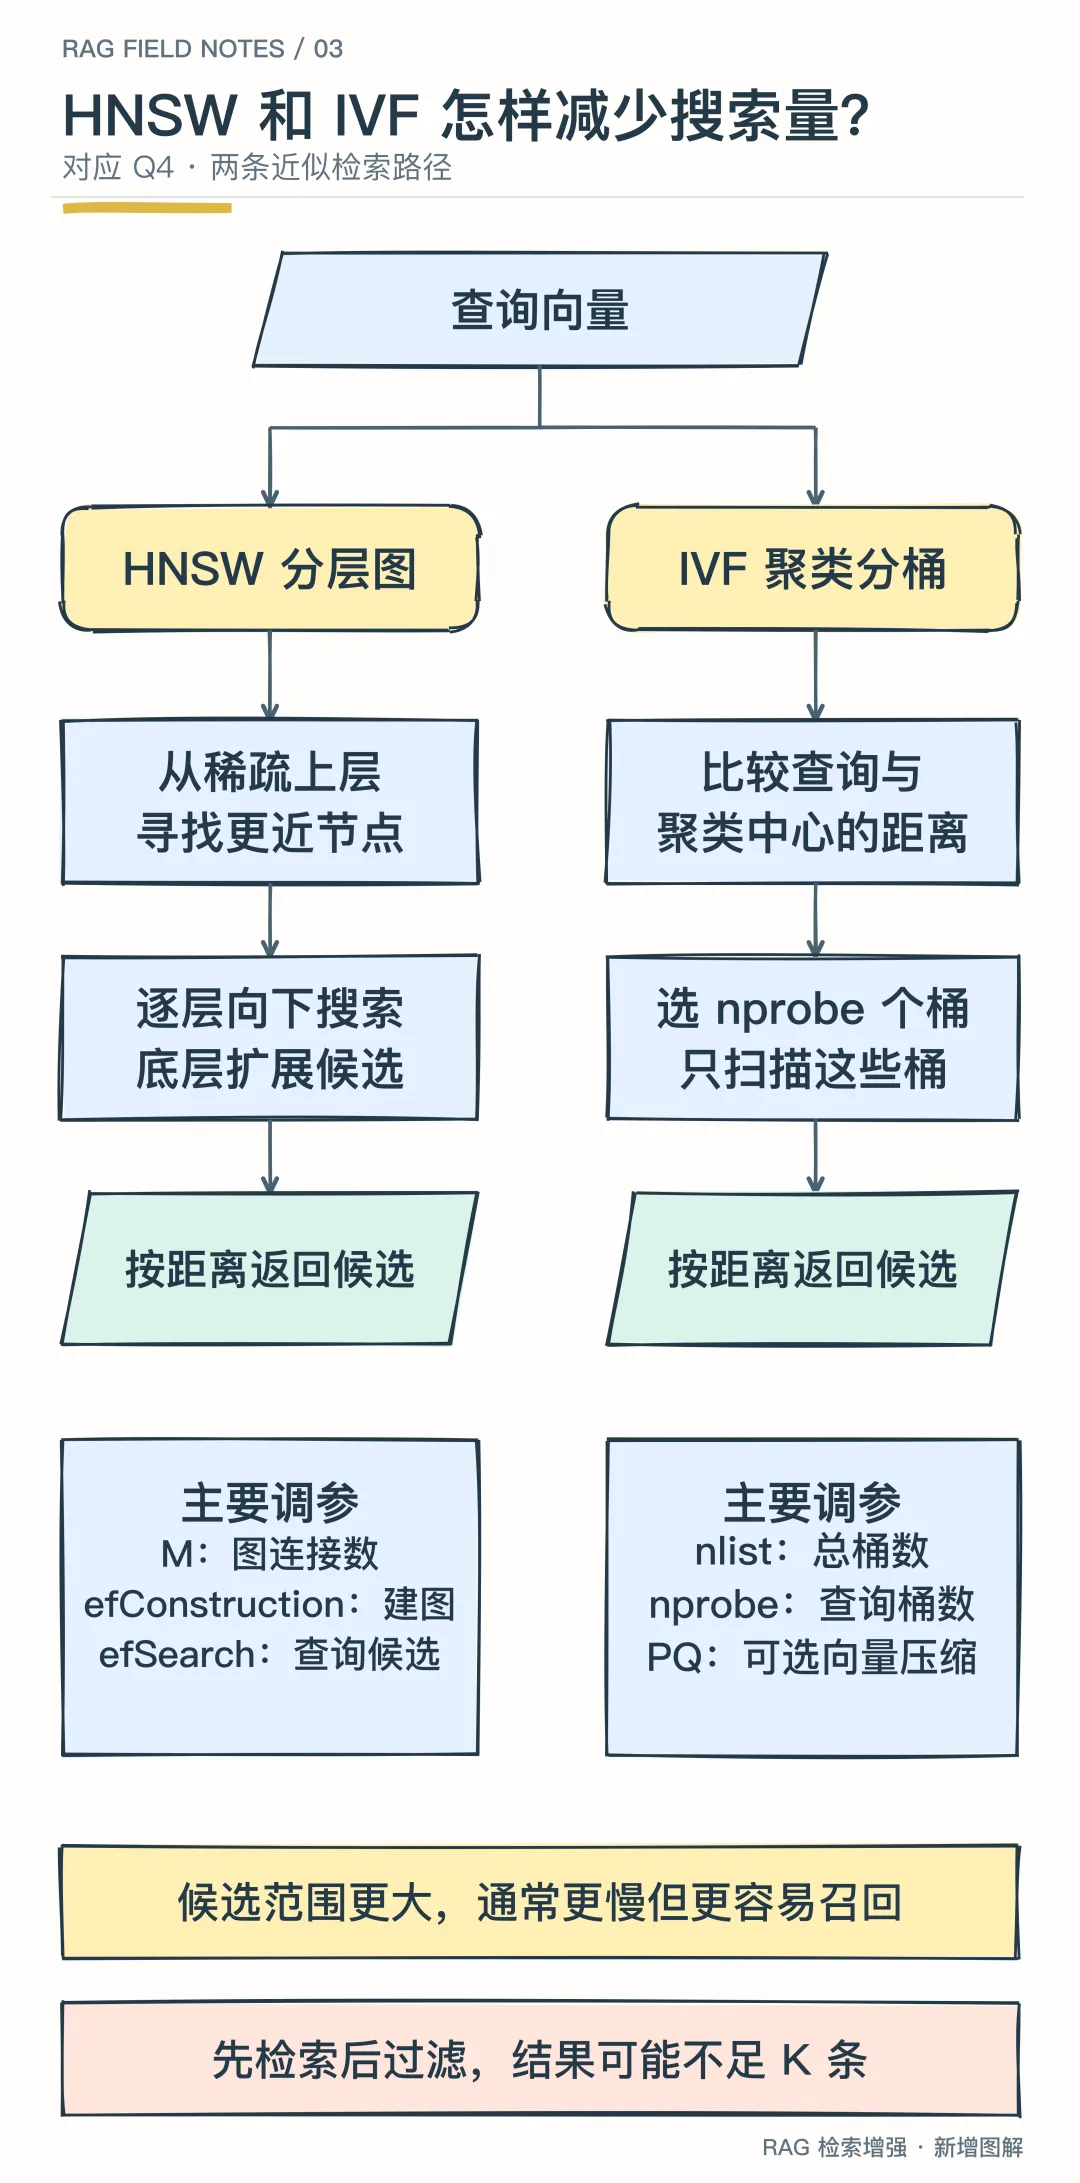
图中 IVF 的 PQ 是可选压缩方式,是否采用还要比较内存、速度与精度。参数含义见 Faiss 索引说明。
Q5 为什么需要混合检索?怎么融合结果?
考察点:关键词检索与向量检索的互补。
参考回答
向量检索的弱点:对订单号、型号、专有名词、缩写这类需要精确匹配的内容效果差。 关键词检索(BM25)的弱点:理解不了同义表达,例如“忌口”和“过敏”。 混合检索:两路同时检索,再合并结果。 融合方法: RRF(倒数排名融合):按每条结果在各路中的排名计算分数并相加,不依赖原始分数的尺度,简单稳健,最常用; 加权分数:需要先把不同来源的分数归一化,权重要靠评测调整。
融合后通常再做一次重排序。
追问:RRF 为什么不直接把相似度分数相加? 向量相似度和 BM25 分数的尺度完全不同,直接相加没有意义。
减分回答:“有向量检索就够了”。
Q6 重排序(Rerank)的作用是什么?双塔模型和交叉编码器有什么区别?
考察点:两阶段检索。
参考回答
两阶段检索:第一阶段用速度快的方法召回较多候选(例如 50 条),第二阶段用更精确的模型重排,取前几条交给大模型。 双塔(Bi-encoder):查询和文档分别编码成向量再比较,文档向量可以提前算好,速度快,适合召回。 交叉编码器(Cross-encoder):把查询和文档拼在一起输入模型,直接输出相关性分数,更精确, 但每个候选都要计算一次,速度慢,适合少量候选的重排。 收益:提高交给大模型的片段的相关性,减少无关内容的干扰,也节省 token。
追问:也可以用大模型做重排吗? 可以,效果好但成本和延迟更高;需要评估是否值得。
减分回答:不知道召回和重排序是两个阶段。
图解 04 · 两路召回先融合,交叉编码器再重排;重排只能处理已经召回的候选。
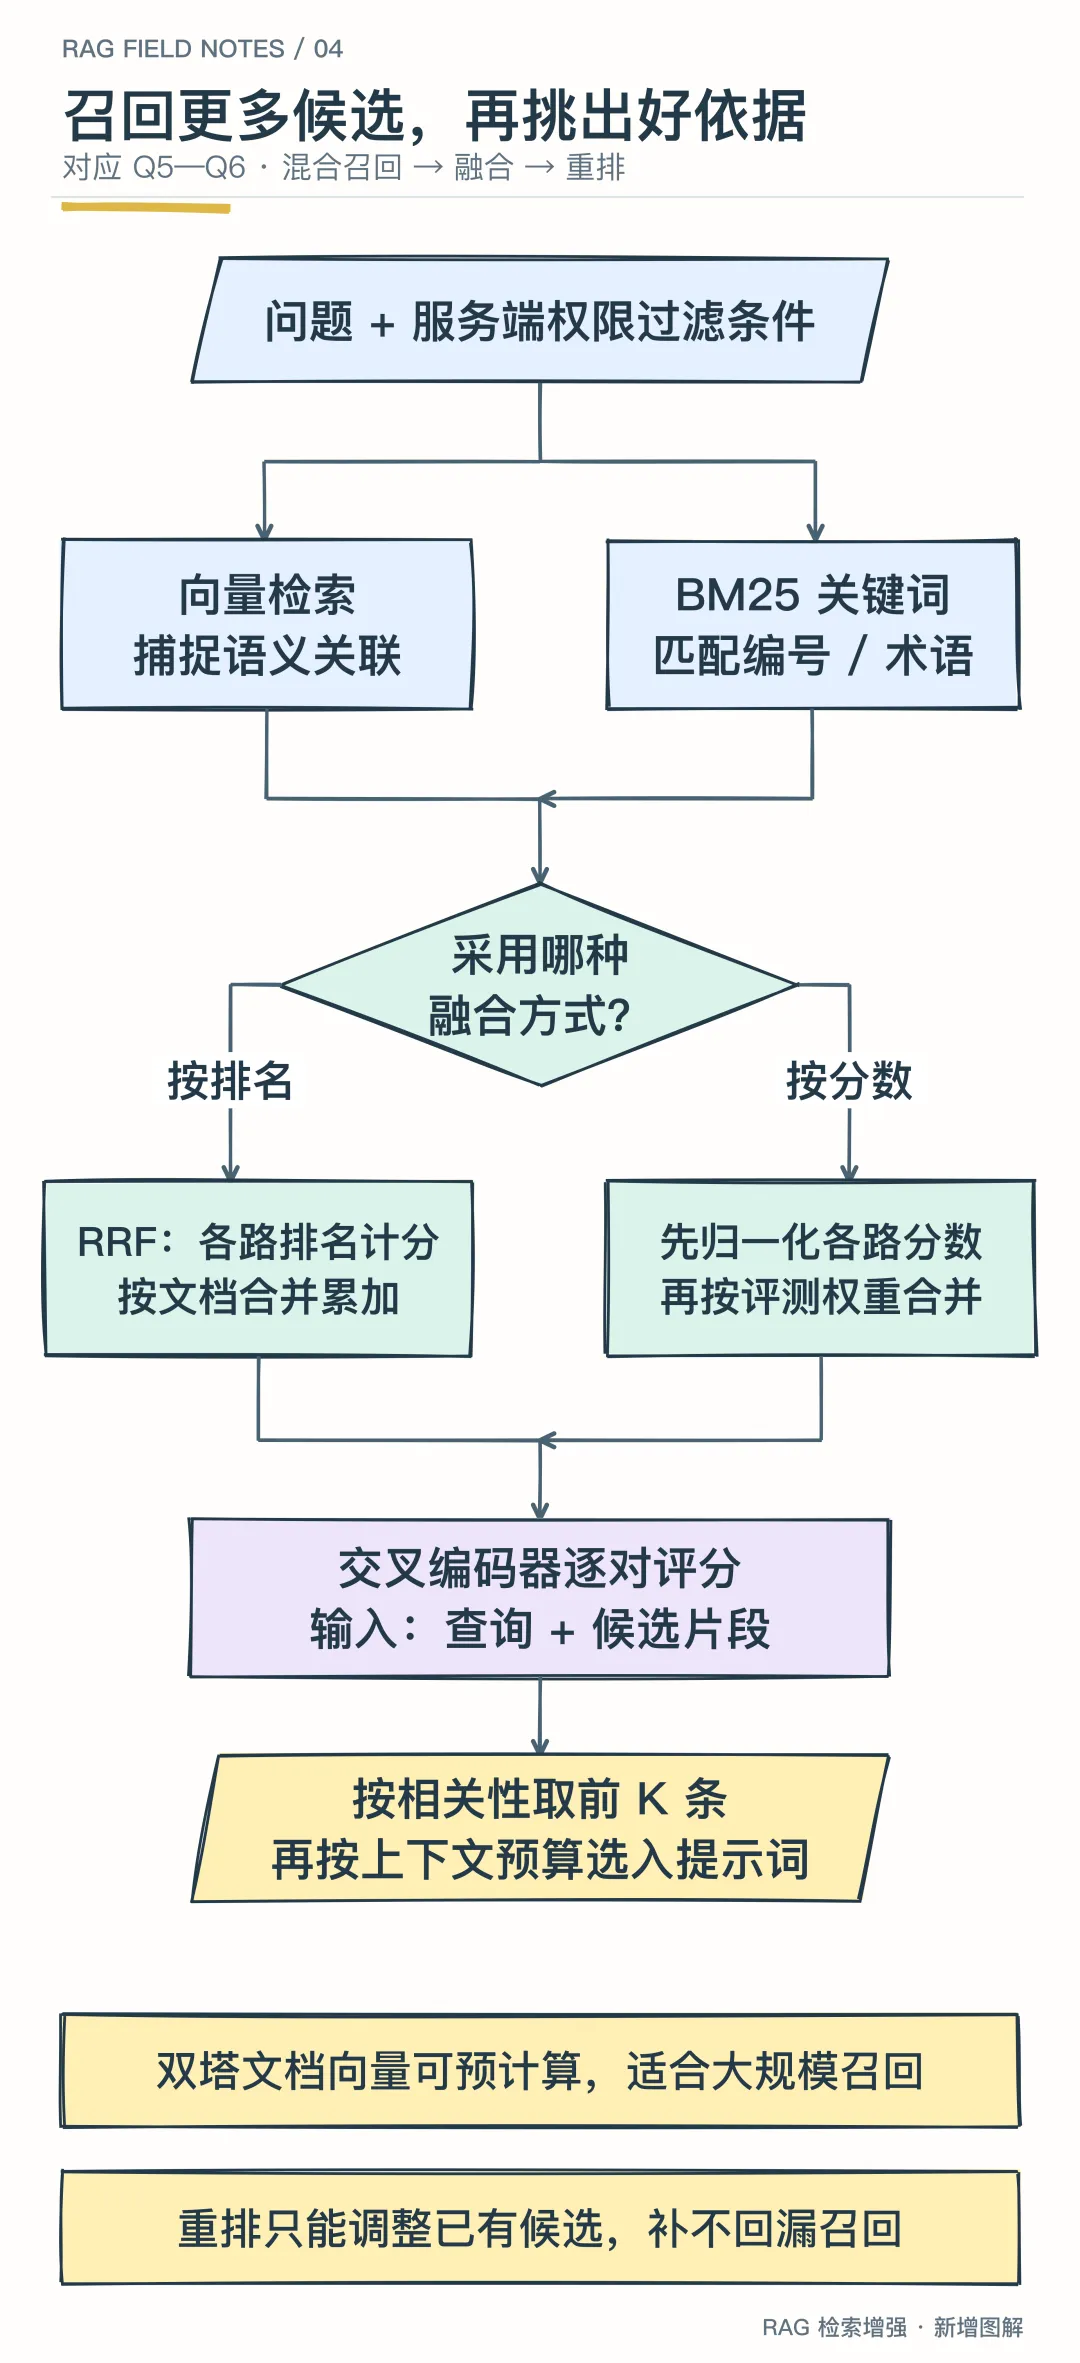
新增技术校注(Q5):原文中的“忌口”和“过敏”存在关联,但不是同义词,不能在改写时互相替换。纯 BM25 主要依赖词项匹配,额外的同义词处理属于检索系统的另一层能力;向量检索也不保证精确标识符匹配。图中两路的作用表示互补倾向。
Q7 查询改写有哪些方法?
考察点:提升召回的技巧。
参考回答
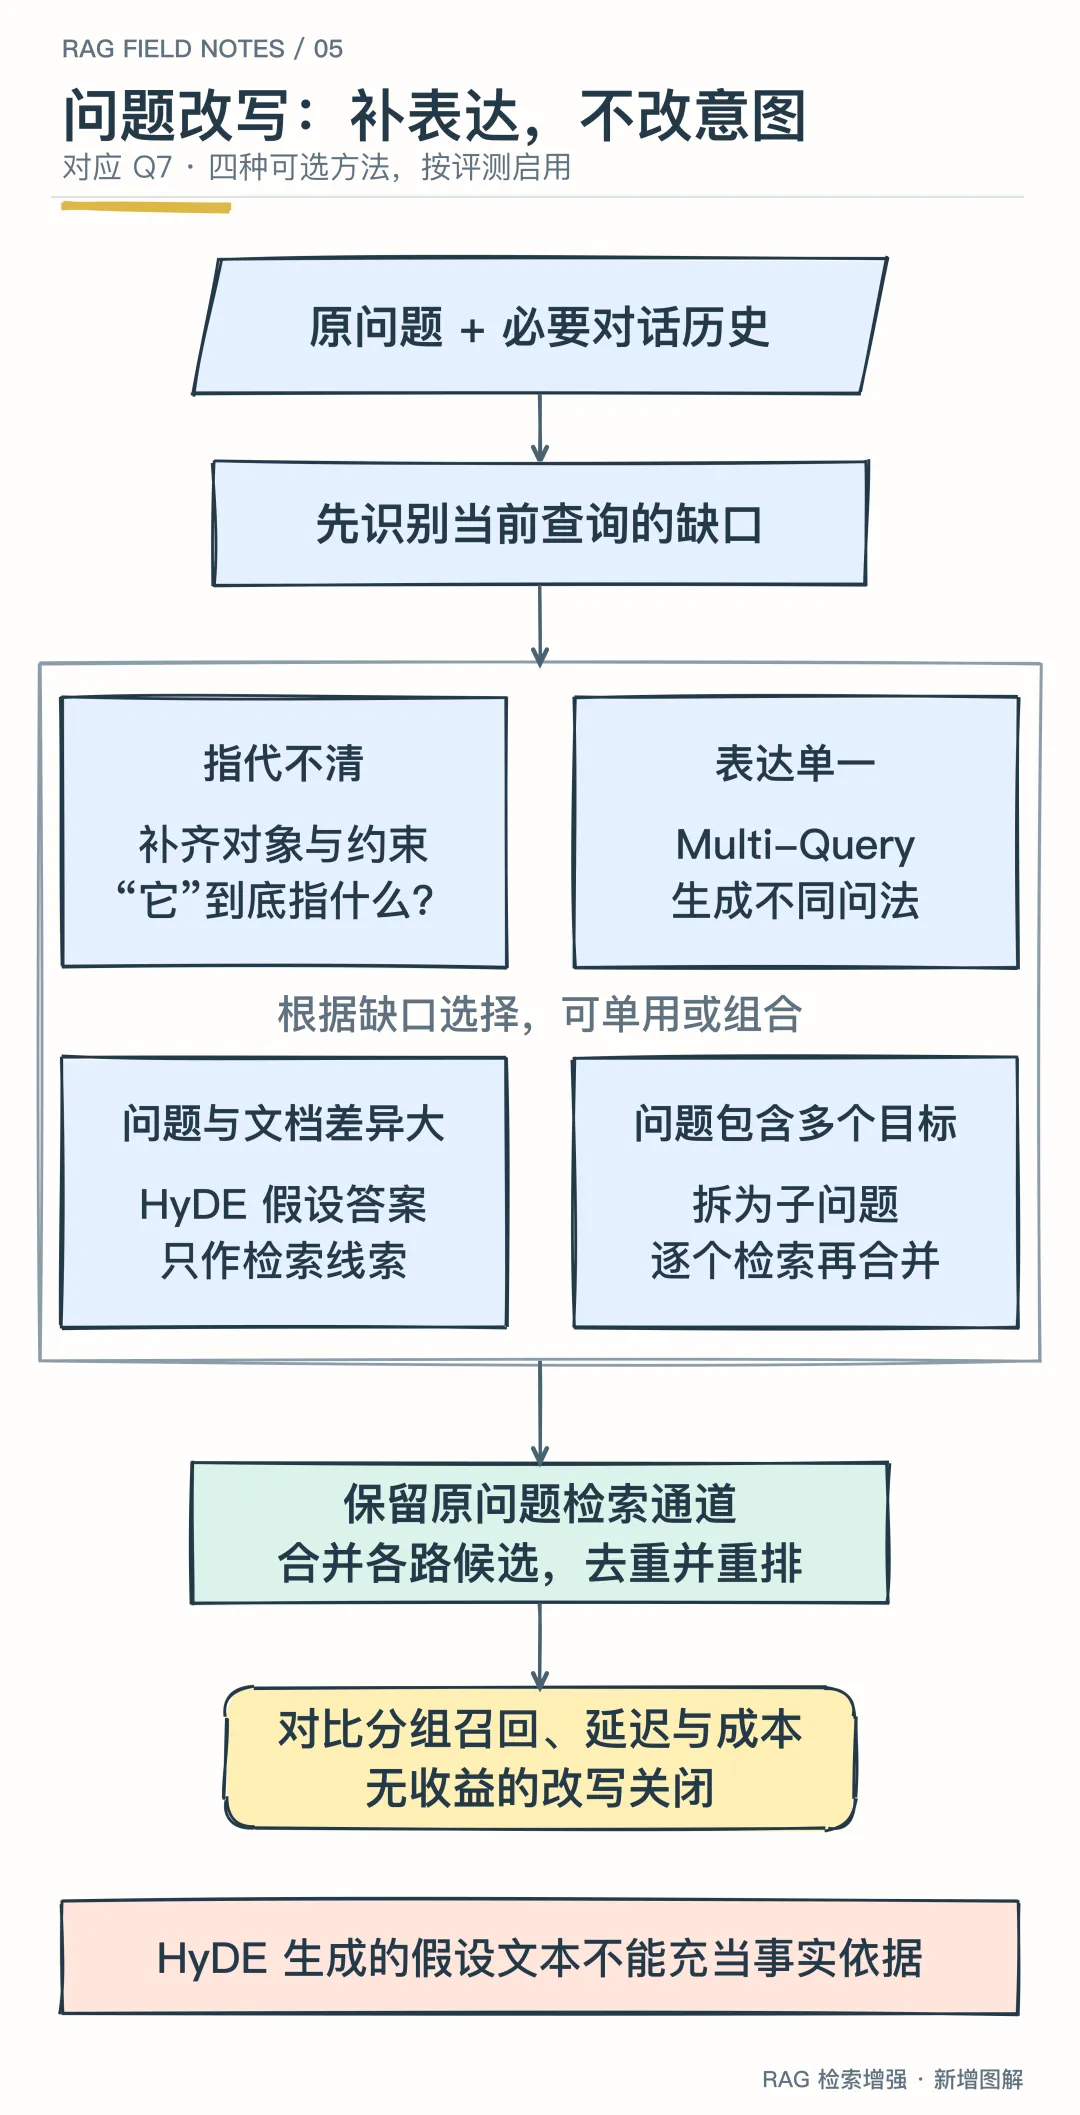
结合对话历史改写:把“那它多少钱?”改写成完整的问题,补上指代对象。多轮对话里这一步非常关键。 多查询(Multi-Query):把一个问题改写成多个不同说法,分别检索后合并结果。 HyDE:先让模型生成一个假设性的答案,用这个答案去检索,缩小问题与文档之间的表述差距。 问题拆解:把复合问题拆成多个子问题,分别检索。 代价:每种方法都要额外调用模型,增加延迟和成本,应该根据评测结果决定是否启用。
追问:改写会不会改错用户的意思? 会。所以改写结果要保留原问题一起检索,或者用评测集验证改写后召回是否真的提升。
减分回答:直接把用户的原话拿去检索,从不考虑多轮对话中的指代。
图解 05 · 四种改写方法按问题缺口选用;保留原问题,防止扩展查询偏离意图。
Q8 RAG 有哪些常见的失败场景?怎么定位问题出在哪个环节?
考察点:排查方法。
参考回答
方法:把“检索”和“生成”分开评测。先看检索的召回率,再看在召回正确的前提下生成是否忠于资料。
追问:没检索到时模型应该怎么回答? 明确说明没有找到依据,并引导用户或转人工;同时记录这个问题,用于补充知识。
减分回答:遇到效果问题只会调整提示词。
Q9 如何评估 RAG 的效果?
考察点:评测指标。
参考回答
检索环节: Recall@K:前 K 条里有没有包含正确片段; MRR:正确片段排得是否靠前; nDCG:综合考虑相关程度和排名。
生成环节: 忠实度(Faithfulness):答案是否都有资料依据; 答案相关性:是否回答了问题; 上下文精确率和召回率:给模型的资料里有多少有用、是否缺少必要信息。 这些指标常用 LLM-as-Judge 来打分(RAGAS 等工具提供了现成实现)。
端到端:人工抽样、用户反馈、转人工率。 做法:建立固定的评测集(问题、标准答案、标准片段),每次改动都对比前后结果,并按问题类型分组分析。
追问:为什么要分组分析? 不同类型的问题(字面匹配、同义改写)适合的策略不同,混在一起的总分可能掩盖真实情况。 项目中就出现过总召回率下降、分组后才发现其实是正常取舍的情况(见 项目第 04 期 Q6)。
减分回答:“让几个人试一试感觉不错就行”。
图解 06 · 依次检查候选、实际提示词和最终回答,把失败定位到具体环节。
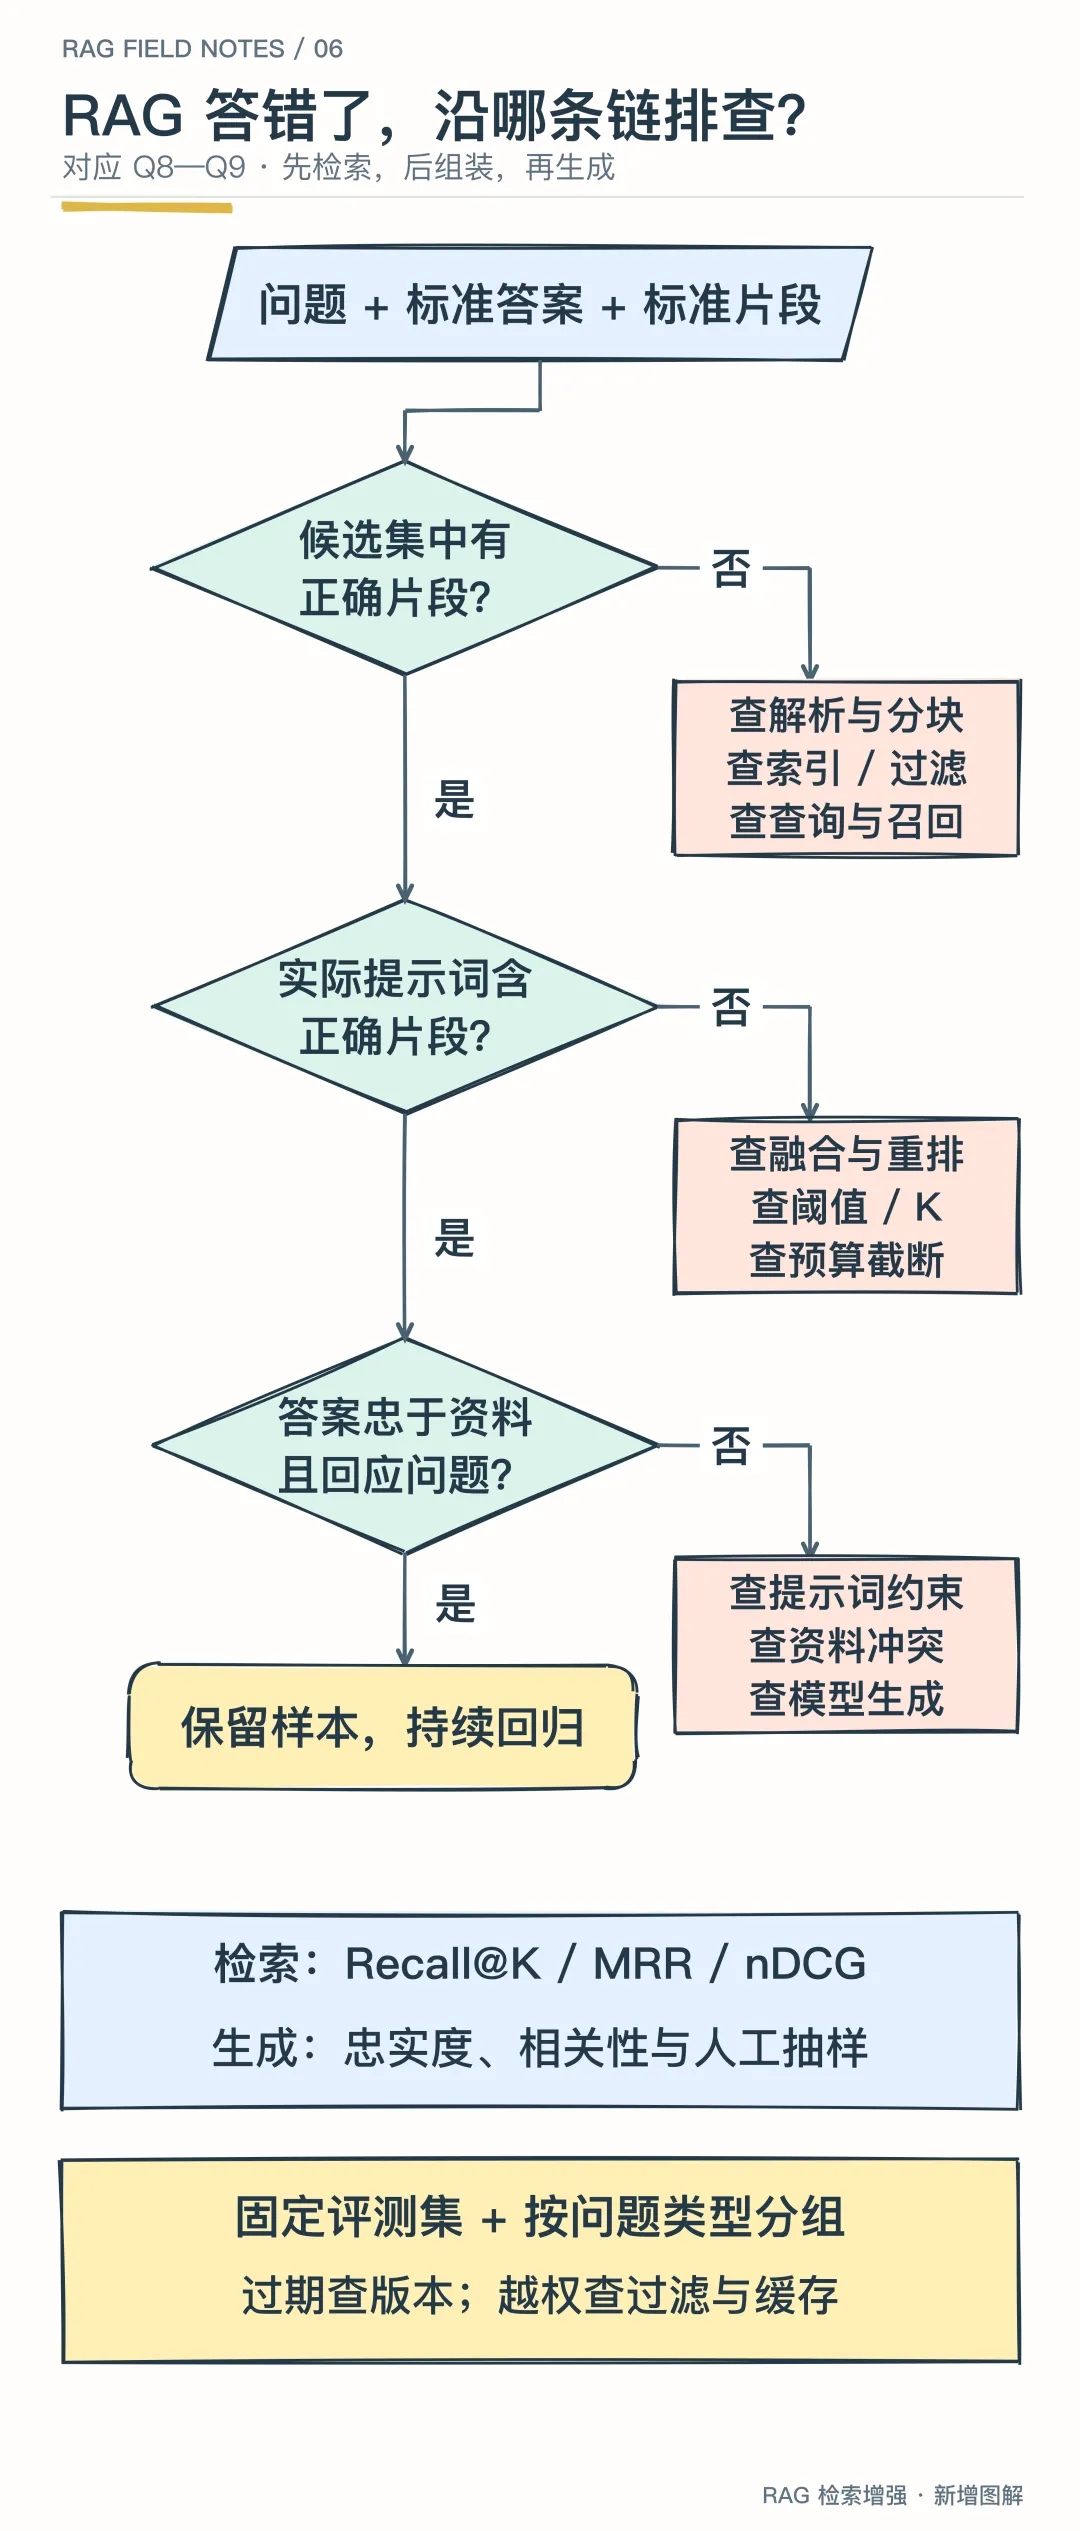
新增技术校注(Q9):严格的 Recall@K 是“前 K 条中相关片段数 ÷ 全部相关片段数”;“前 K 条是否至少命中一个”通常称为 Hit@K,跨查询平均后是命中率。每题只有一个标准片段时,两者才数值相同。MRR 看首个相关结果的倒数排名;上下文精确率、召回率评估的是检索上下文,虽然原文将它们列在生成环节,也不能和答案质量混为一谈。Ragas 的上下文召回定义还区分基于标准陈述和基于标准片段的计算方法。
原文项目链接的独立阅读入口:项目第 04 期:上下文工程与记忆。
Q10 RAG 中如何做权限控制,避免用户检索到无权查看的内容?
考察点:企业场景的数据安全。
参考回答
把权限信息写入元数据:租户、部门、可见范围、密级等。 检索时强制过滤:过滤条件由服务端根据可信身份生成,不能来自用户输入; 最好在向量库的检索过程中直接应用过滤,而不是检索后再过滤。 在一处统一实施:权限过滤写在检索的公共代码或 SQL 里,不依赖每个调用方记得加过滤。 权限变更要及时生效:撤销权限后,检索、预览和缓存都要同步失效。 项目对照:终端用户只能检索公开(PUBLIC)文档,约束写在 SQL 中,见 项目第 03 期 Q2。
追问:语义缓存会不会绕过权限? 会。如果缓存按问题复用答案,一个有权限的用户的答案可能被返回给没有权限的用户, 所以缓存必须按权限范围隔离,或者不缓存涉及权限的内容。
减分回答:“在提示词里告诉模型不要泄露机密内容”。
新增图解 07 · 从服务端过滤到正文回查,再到缓存和来源预览,都要保持权限边界。
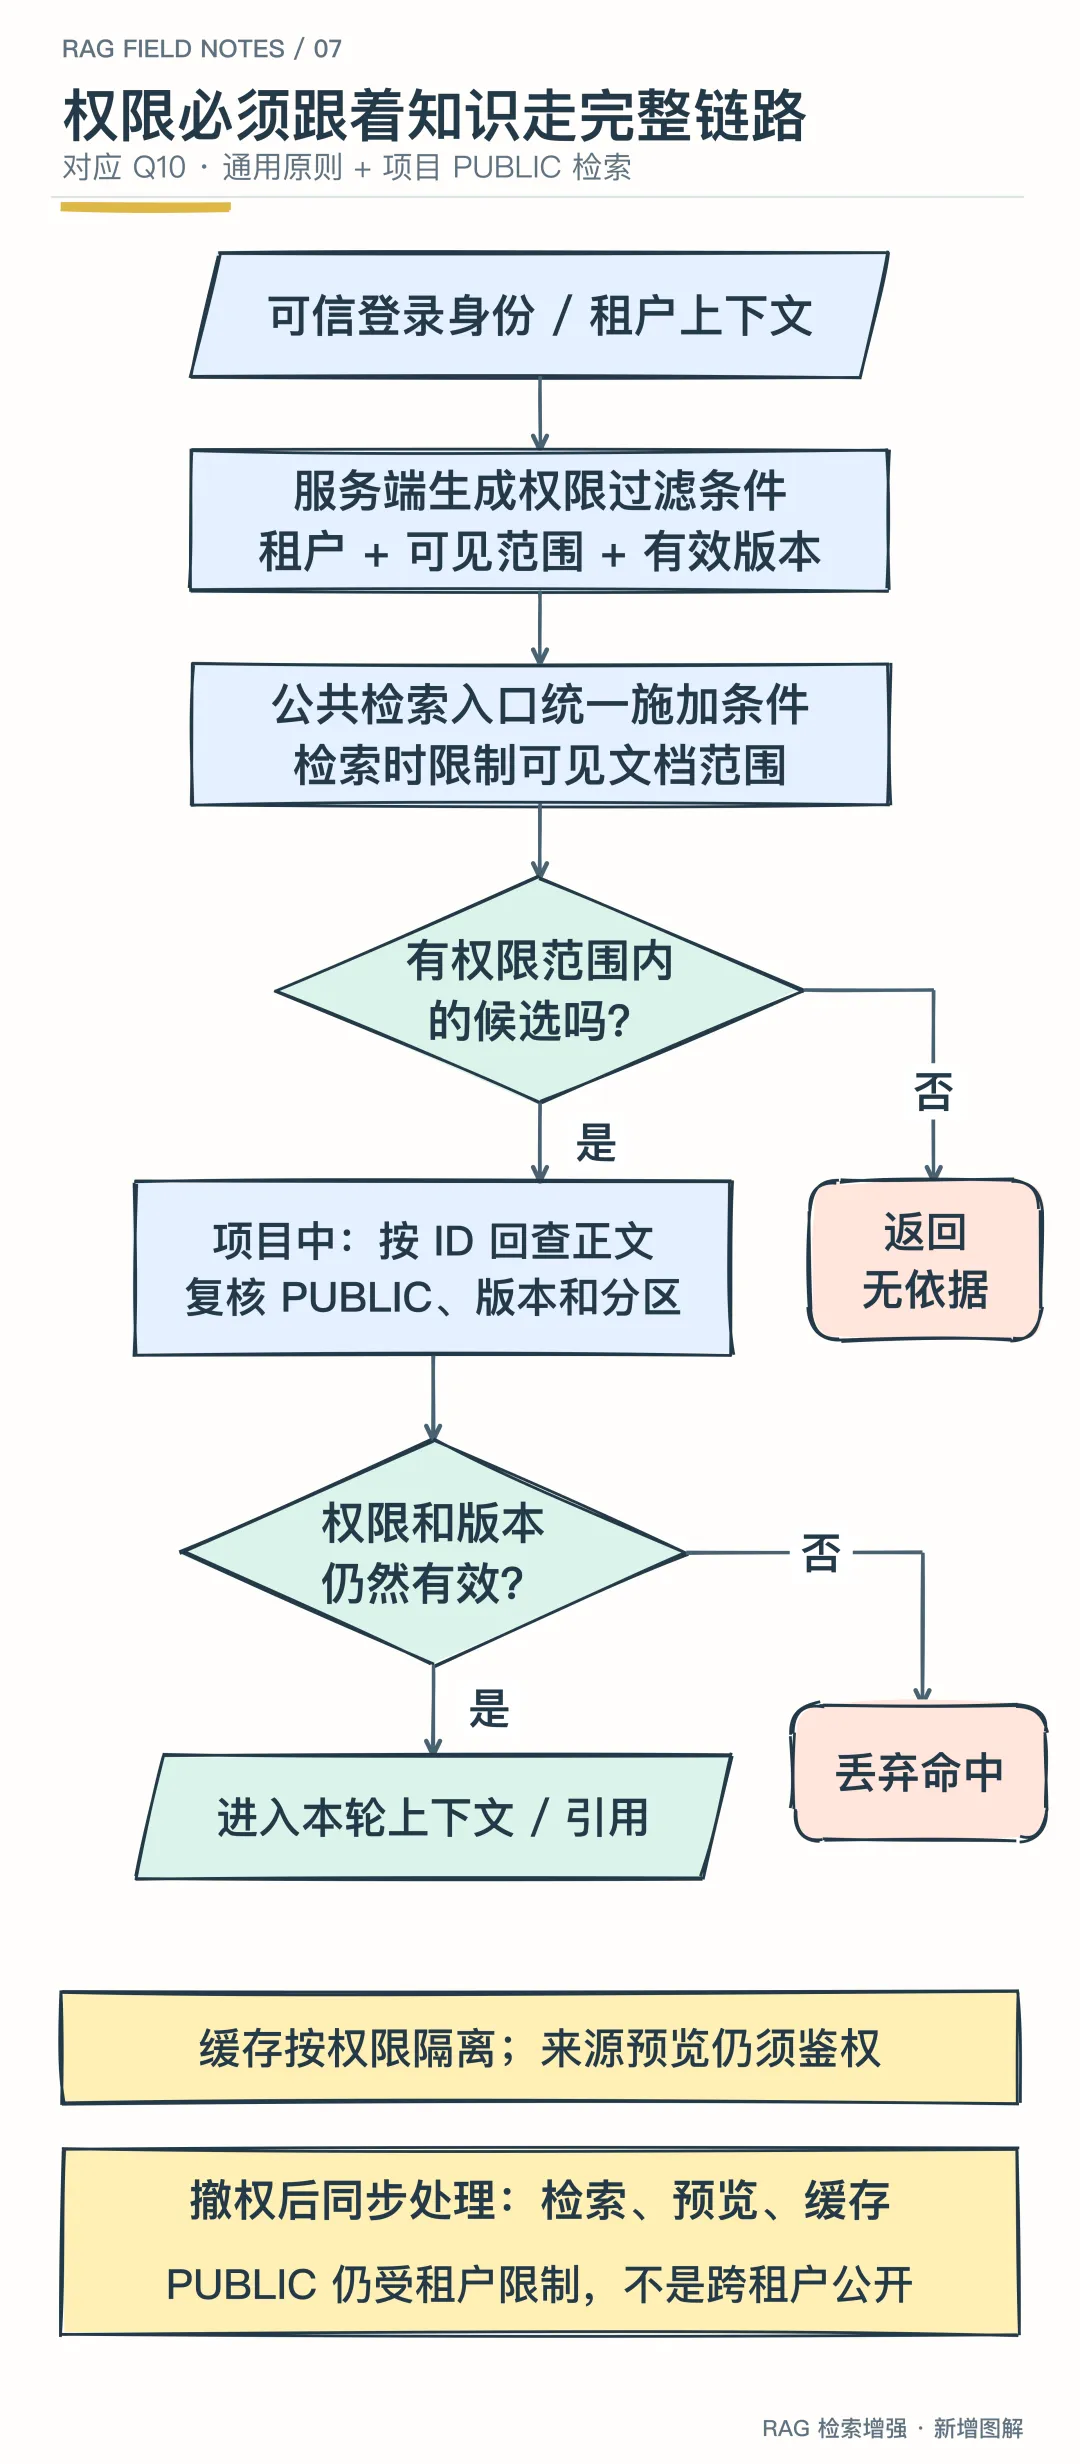
图中的 PUBLIC、版本和分区复核对应项目的 ManagedKnowledge 正文回查。PUBLIC 只表示当前租户内可公开,不表示跨租户共享。原文链接的独立阅读入口:项目第 03 期:RAG 与知识库工程。
Q11 知识库如何增量更新?如何处理文档删除和版本变化?
考察点:知识运维。
参考回答
增量更新:记录每个文档的内容哈希或更新时间,只重新处理有变化的文档;用 checkpoint 记录同步进度,失败后能从断点继续。 删除:源文档删除后,对应的所有分块和向量都要删除,否则会一直被检索到。 版本:每次发布形成一个新版本;新版本就绪后原子切换,旧版本下线;保留版本历史,方便回滚和追溯。 血缘(lineage):记录每个分块来自哪个文档的哪个版本,方便定位问题和展示引用。 质量门禁:发布前检查解析是否成功、分块数量是否异常、新鲜度是否达标。
追问:向量库写入成功但数据库记录失败,怎么办? 以一方(通常是数据库)为权威数据源,另一方作为可重建的索引; 写入要幂等,定期对账修复差异。
减分回答:“每次全量重建就行”。
图解 08 · 有变化才重建,删除要清理分块与向量,新版本完整就绪后再发布。
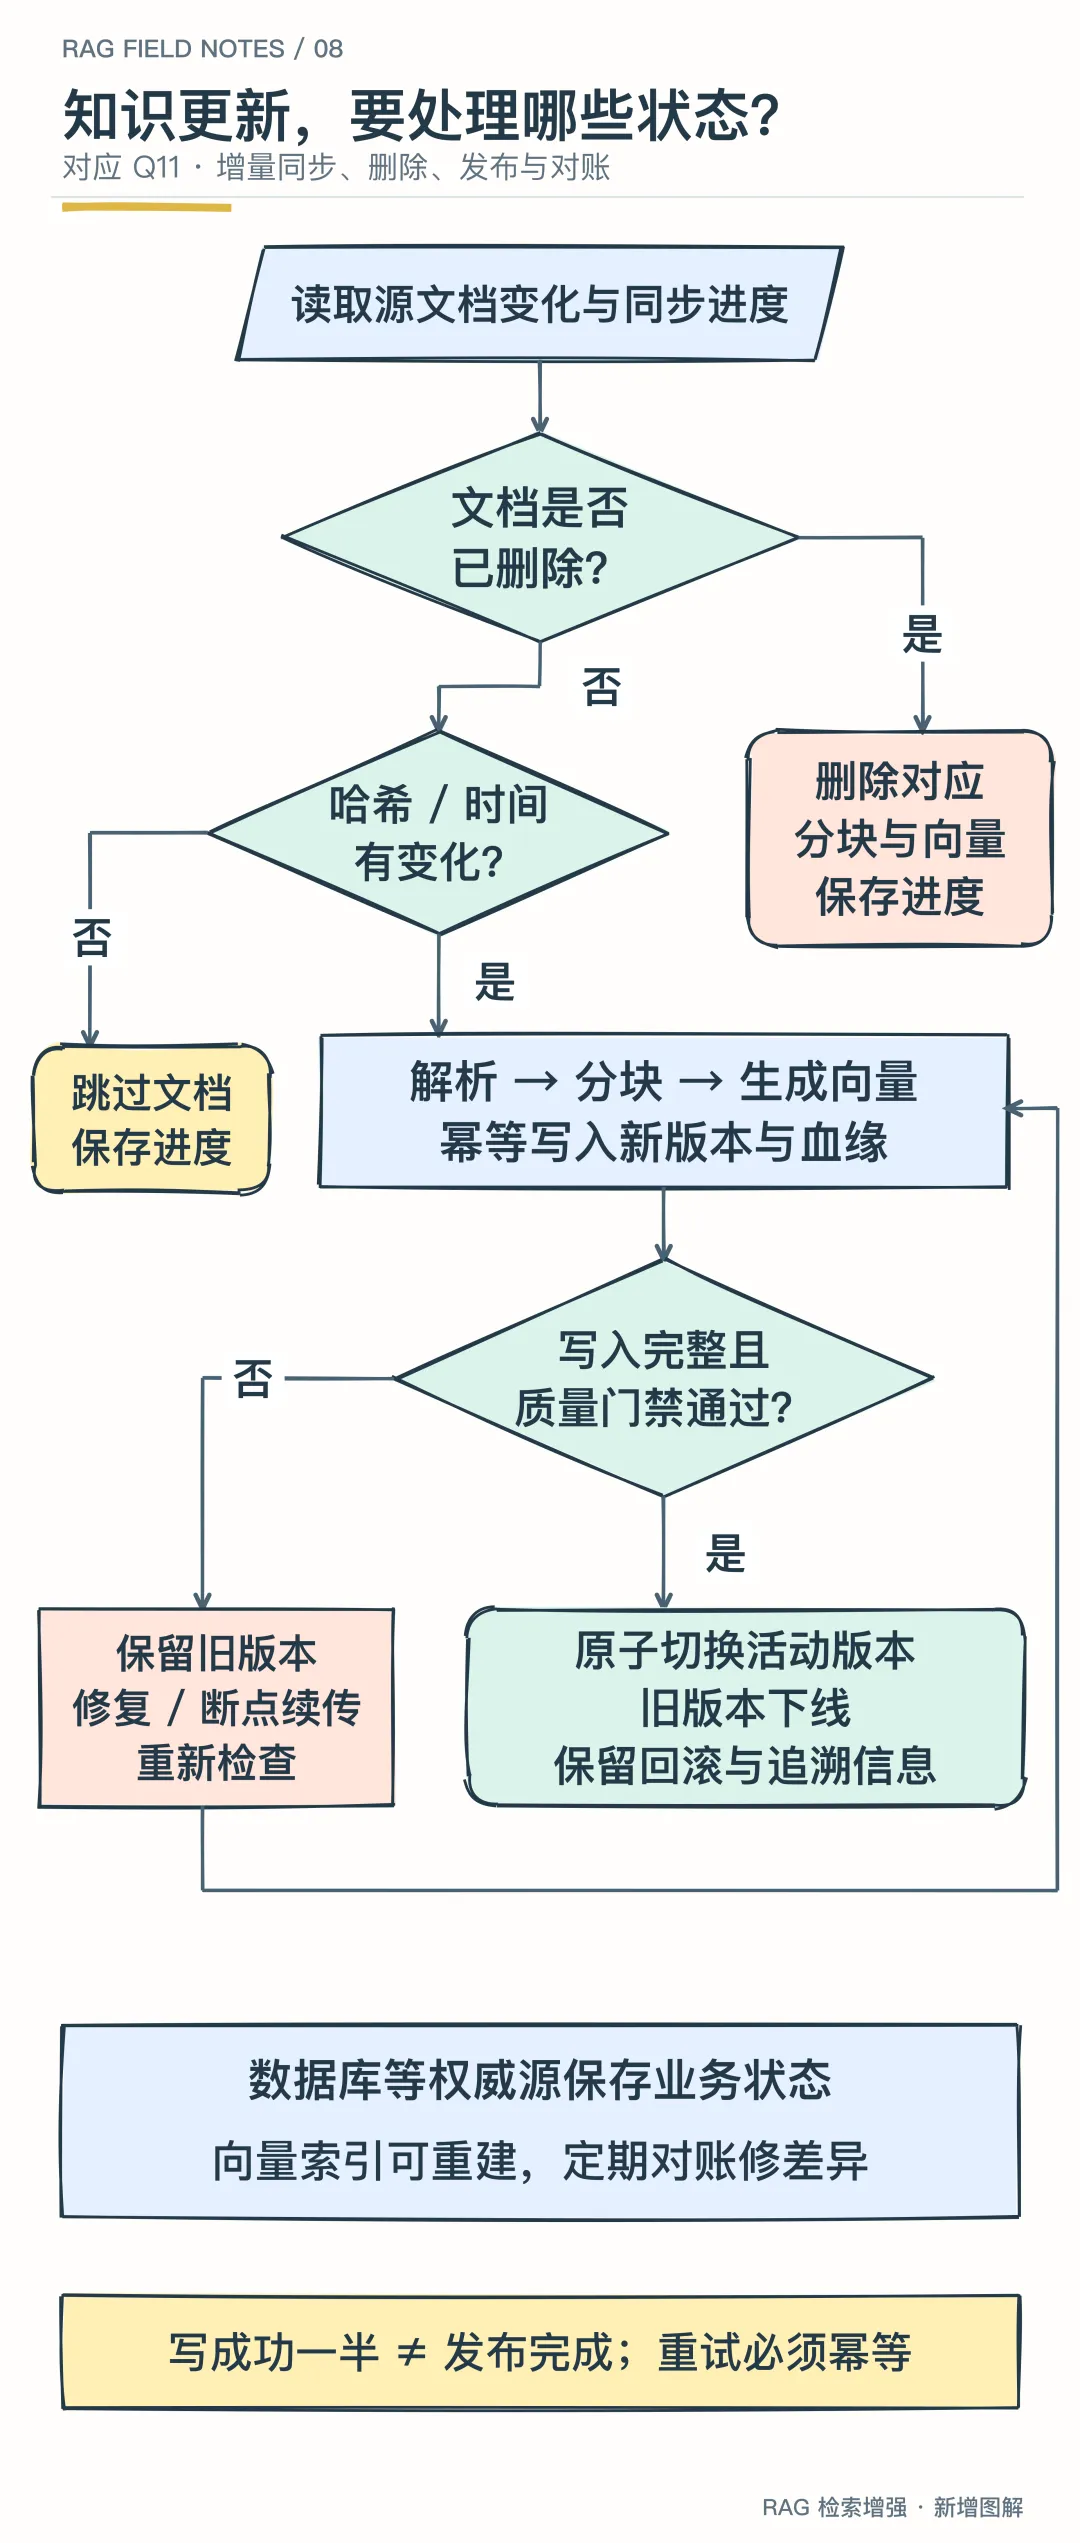
图中是增量更新的通用设计。数据库与向量库不必共享事务,因此需要幂等写入、权威数据源与定期对账,不能把一次索引写入成功当作整次发布成功。
Q12 GraphRAG 是什么?适合什么场景?
考察点:进阶方案的认知。
参考回答
思路:从文档中抽取实体和关系构建知识图谱,检索时结合图结构,能回答需要跨文档关联、多跳推理的问题, 也能对整个语料做全局总结。 适合的场景:实体关系复杂的领域(例如组织关系、产品部件依赖);需要“总结整个知识库主题”的问题。 代价:构建图谱需要大量模型调用,成本高;更新和维护复杂;简单问答场景收益不明显。 原则:先用普通 RAG 做好,确认存在多跳推理的真实需求后再考虑。
追问:能否只在部分问题上使用 GraphRAG? 可以,通过路由判断问题类型,只把需要多跳推理的问题交给图检索。
减分回答:认为 GraphRAG 一定比普通 RAG 好。
图解 09 · 确认关系检索或全局总结的真实需求,再计算引入图结构的收益和成本。
图中的“社区报告”对应 Microsoft GraphRAG 的全局检索路径;局部关联和全局总结使用的材料组织方式不同,见 GraphRAG 查询方式说明。
Q13 检索到的内容怎么组织进提示词?
考察点:上下文组装技巧。
参考回答
用明确的标记分隔每条资料,并标注来源编号,便于模型引用。 说明资料的性质:资料是参考数据,不是指令;资料里出现的任何要求都不要执行(防范间接注入)。 要求依据资料回答:资料中没有的内容就说明不知道。 控制数量和位置:只放最相关的几条;把最重要的内容放在靠近问题的位置。 临时注入:检索内容只放进本次模型调用,不写入长期对话历史,避免每轮重复累积 (见 项目第 04 期 Q4)。
追问:资料之间互相矛盾怎么办? 带上版本和时间信息,让模型优先采用最新的;或者在建库时就去掉过期版本。
减分回答:把检索结果直接拼在用户问题前面,不做任何说明。
Q14 RAG 应该每轮都检索,还是让模型决定何时检索?
考察点:检索触发方式的取舍。
参考回答
每轮都检索:实现简单,不会漏检;但寒暄、查询订单这类对话也会触发检索,浪费 token,还可能引入无关内容。 让模型决定(检索作为工具):只在需要时检索,更省成本;但模型可能在该检索的时候没有检索。 折中:先用轻量的规则或分类器判断是否需要检索;在提示词中明确要求某类问题必须先检索; 统计“没有检索就回答”的比例。 项目对照:客服端让模型按需检索,后台工作台在每轮推理前自动注入,见 项目第 03 期 Q1。
追问:让模型决定时,怎么知道它漏检了? 在评测集里检查工具调用轨迹,看应该检索的问题有没有调用检索工具。
减分回答:只知道一种方式,说不出取舍。
图解 10 · 先确定检索触发方式,再为本次调用组装有来源、受预算约束的上下文。
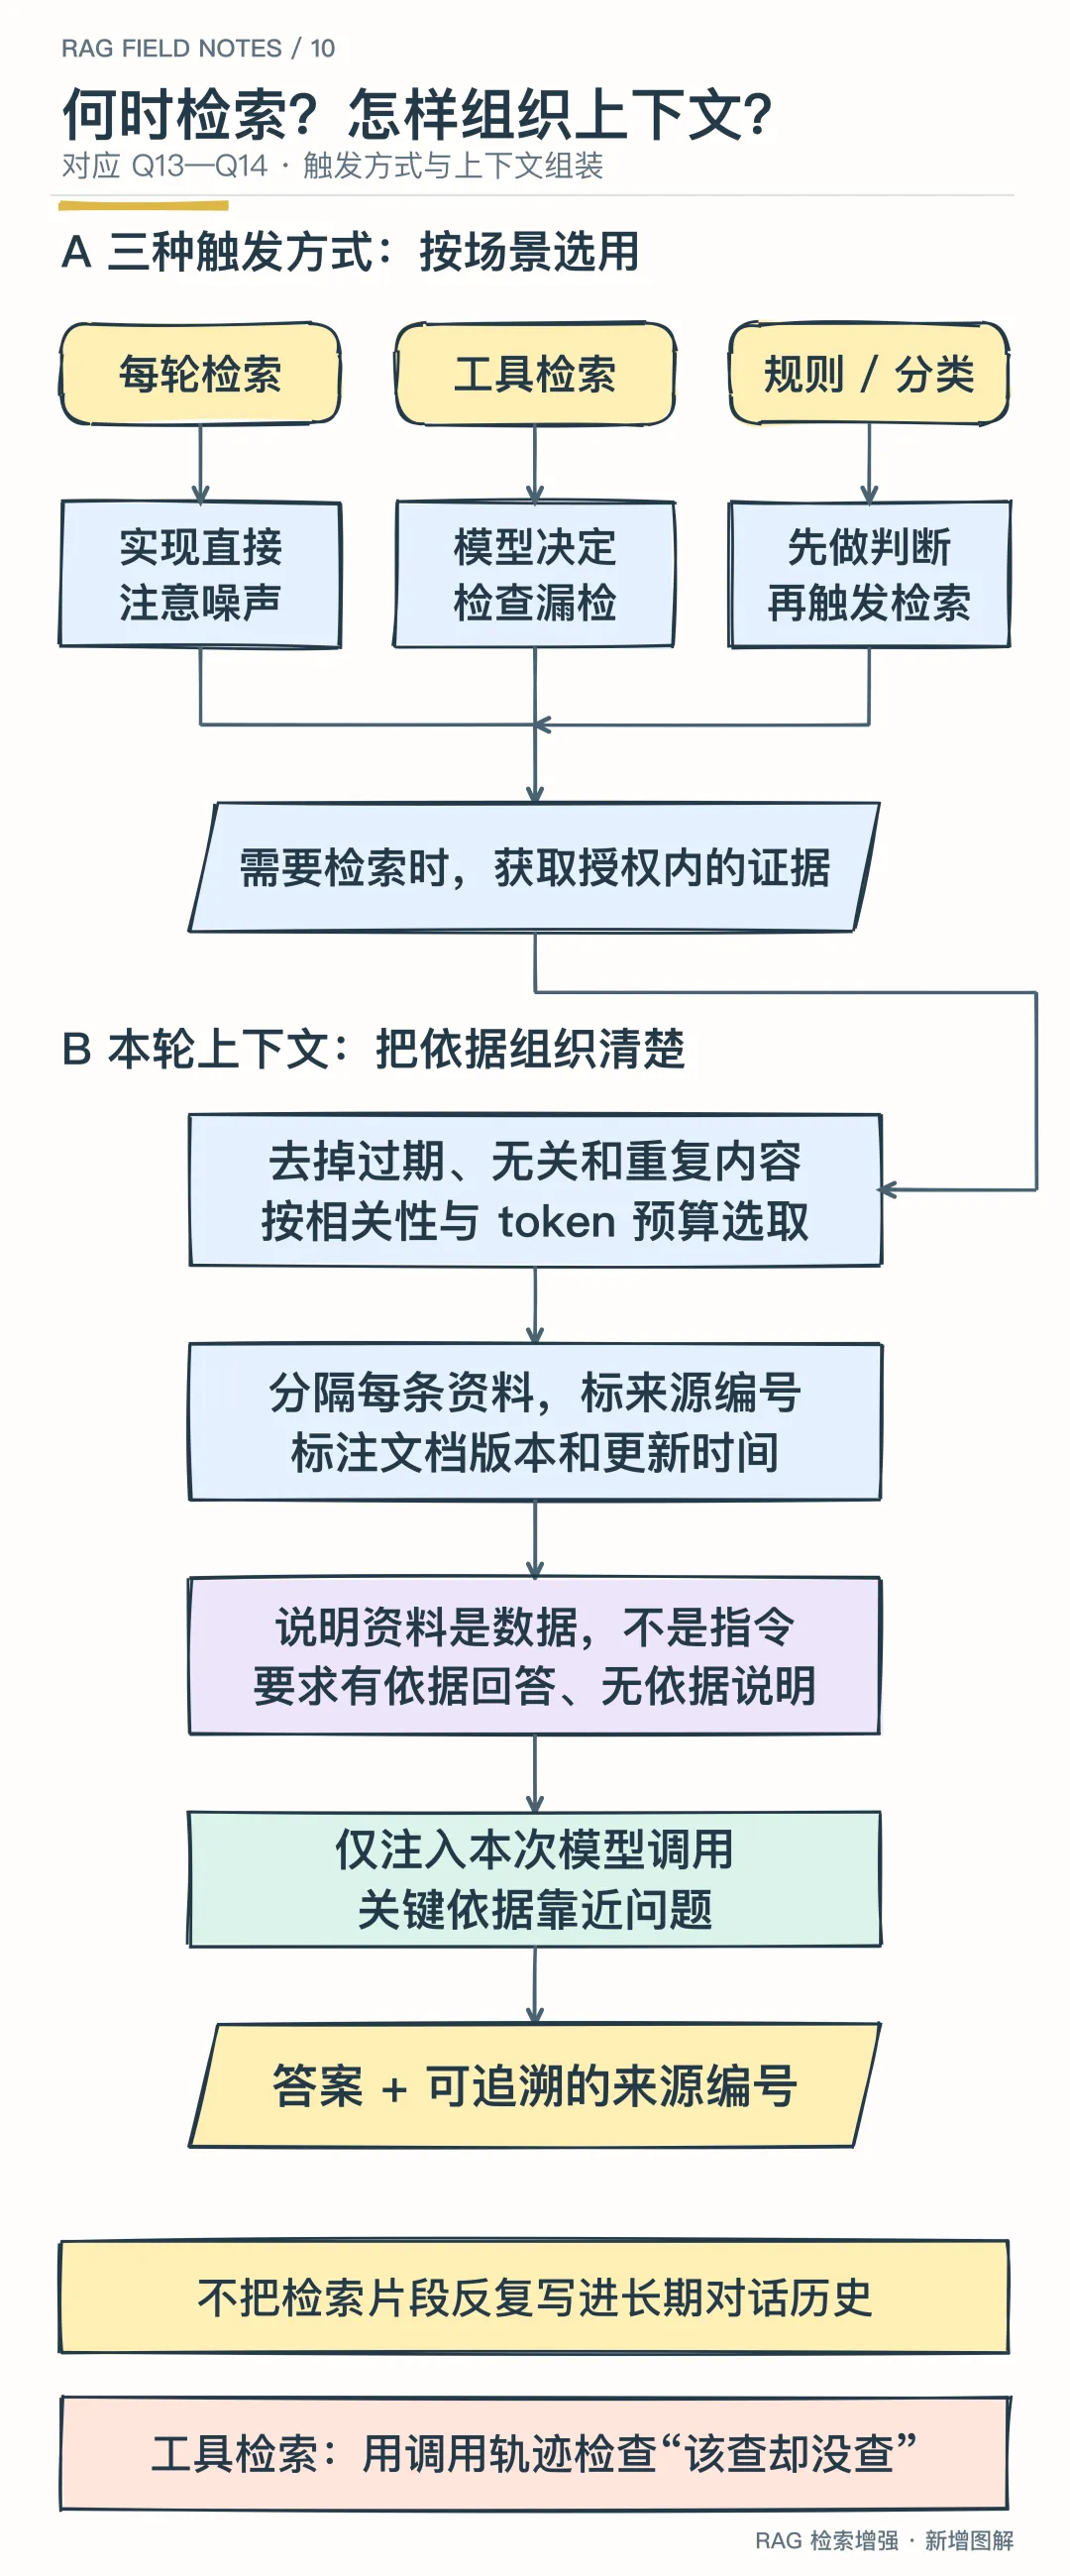
新增技术校注(Q13—Q14):把资料标为“数据而非指令”是一项提示词措施,不能单独保证阻止间接注入;工具权限与执行约束仍需由应用落实。将关键依据靠近问题是一种可评测的布局策略,不是所有模型的固定最优解。项目链接的独立阅读入口见前面的第 03 期、第 04 期链接。
Q15 如何在 Java 项目中落地一个 RAG 服务?
考察点:Java 技术栈的实现能力。
参考回答
框架:Spring AI 提供 VectorStore抽象和检索增强相关的组件;LangChain4j 提供EmbeddingStore、ContentRetriever等组件;也可以直接调用厂商的 Embedding 接口,自己封装。存储:数据量不大时可以用 PGVector 或 ES 的向量能力;规模更大时用 Milvus 这类专用向量库。 通过接口抽象存储层,保留替换空间。 离线任务:文档解析(Apache Tika、PDFBox 等)、分块和写入放到异步任务或消息队列中执行,支持重试和断点续传。 在线检索:阻塞的 HTTP 调用不要占用 Web 容器或事件循环线程,要设置超时和降级(检索失败时返回“没查到”,不要让整轮对话失败)。 可观测:记录检索耗时、召回数量、最高分、是否为空结果。
追问:使用 WebFlux 时,检索这类阻塞调用应该怎么处理? 用 subscribeOn(Schedulers.boundedElastic()) 把阻塞调用挪到弹性线程池执行,并注意上下文(例如租户信息)在线程切换后的传递。
减分回答:只会调用框架的示例代码,不考虑超时、降级和线程模型。
图解 11 · WebFlux 中隔离阻塞调用,分别处理正常命中、空结果和检索故障。
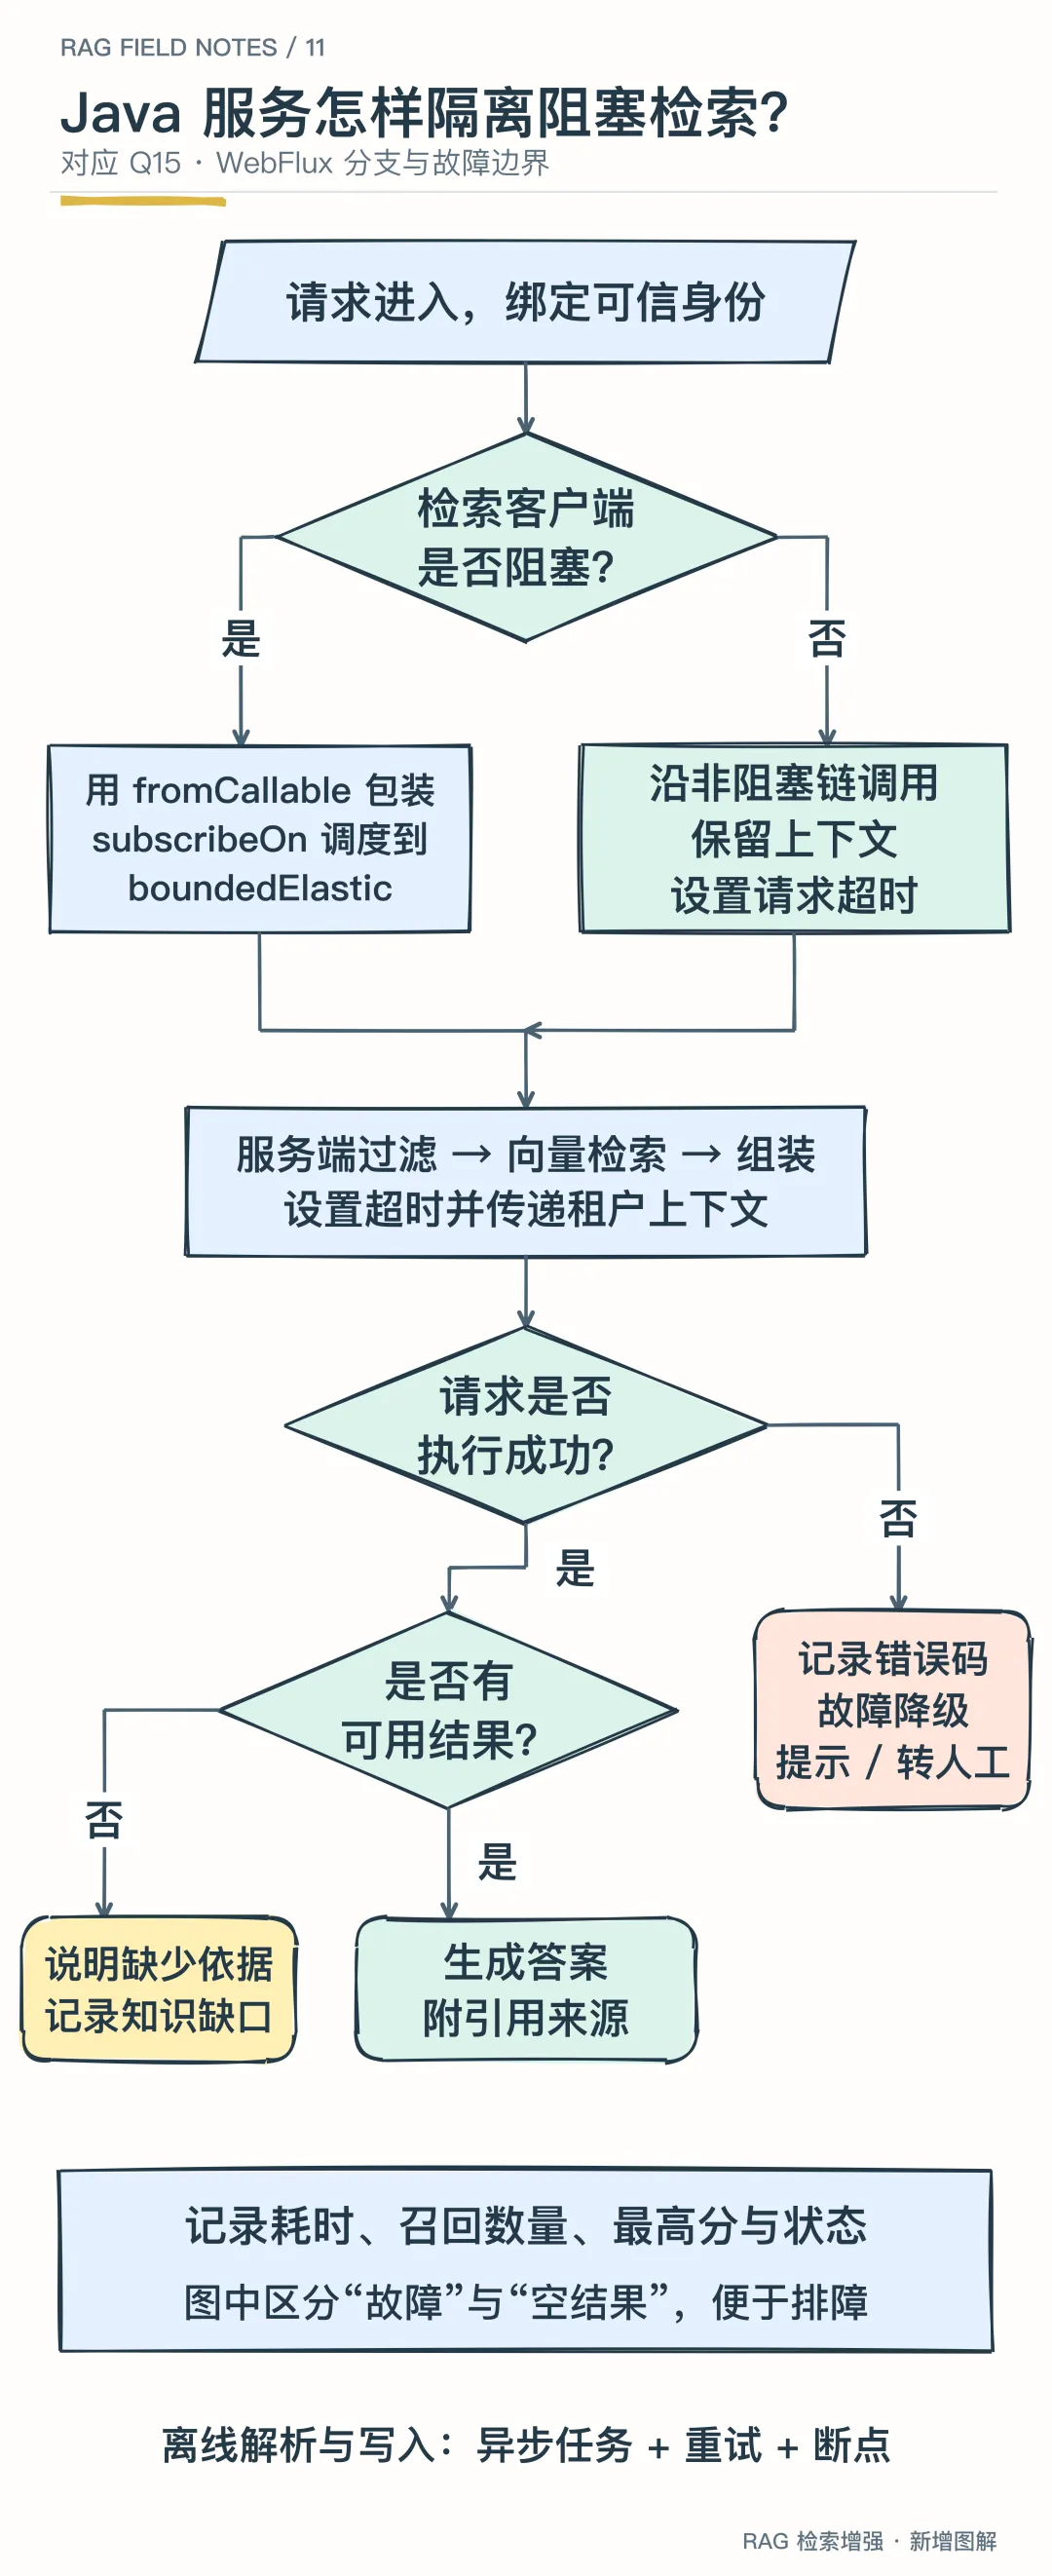
新增技术校注(Q15):阻塞调用不能占用 WebFlux 事件循环;应先用 Mono.fromCallable(...) 延迟执行,再通过 subscribeOn(Schedulers.boundedElastic()) 调度,详见 Reactor 官方示例。这项约束不能直接等同于禁止传统 Spring MVC 使用阻塞请求线程。boundedElastic 的线程和排队容量有限,仍要设置超时并传递身份上下文。
项目 ManagedKnowledge.retrieve 确实会记录错误后返回空列表。图 11 增加了排障时应区分的“故障 / 空结果”状态,属于工程建议;降级不能把服务故障统计成正常的知识缺失,也不能让模型在没有依据时编造答案。
Java 组件可对照 Spring AI 的 RAG 文档:检索组件负责取回文档,上下文组装负责把文档交给模型,两步可分别检查。