ARTICLE · 1110086
红网鸿鹄-AI增强型全域多模态数据底座| 以全栈数据能力,树立全域多模态智能底座标杆
文中人物、姓名、金额与编号为演示数据,仅用于说明业务闭环,不代表任何真实客户与真实业务。
红
网
江苏红网自研的鸿鹄企业级数据基座(下文简称“鸿鹄”),是一款面向全行业的 AI 增强型全域多模态数据基座,而非单一的数据治理工具。它覆盖"接入—治理—质控—资产化—开发—合规—多模态"的数据全层面,以 DataOps 一体化流水线贯通全链路,将分散沉睡的结构化与非结构化数据转化为可信、合规、可复用的高质量数据资产,为业务分析与大模型应用筑牢底座。
一、简介
数据不缺,缺的是把数据"管起来、用起来"的能力。这正是鸿鹄要解决的问题。
鸿鹄定位为AI增强型全域多模态数据基座。它要做的,不是某一块单点工具,而是覆盖数据全层面的基座型产品:从底层的数据接入与汇聚,到中层的治理、质控与资产化,再到上层的开发、合规与多模态服务,形成一条贯通的数据价值链。数据治理是其中贯穿始终的核心能力,却不是全部。鸿鹄的视野,始终落在"数据从产生到价值释放"的完整链路之上。
鸿鹄以DataOps一体化流水线为核心,打通结构化数据与文本、图像、音视频、文档等多模态非结构化数据的接入、治理、质量管控与资产运营全链路,将零散沉睡的数据转化为可信、合规、高质量的数据资产,为业务分析、智能决策与AI大模型应用提供坚实的数据基座能力。
在AI与大模型加速落地的当下,这条"把数据变成资产"的路径,比以往任何时候都更关键。大模型能力的上限,往往取决于喂给它的数据质量——脏数据进,脏结论出;不可溯源的数据,再聪明也无法通过监管与合规审视。鸿鹄所做的,正是把"高质量、可治理、可审计"的数据底座提前建好。
二、鸿鹄解决什么:数据全层面五个绕不开的痛点
理解一款数据基座产品,先看它直面哪些真实难题。红网鸿鹄瞄准的,是各行业企业在数据建设全过程中普遍遇到的五个痛点——它们横跨数据的采集、治理、应用各个层面:
数据孤岛严重:跨业务域数据难以打通,系统之间"各管一摊",底层汇聚层面就断了;
指标口径混乱:同一指标多种算法,数据可信度低,治理与开发层面缺乏统一标准;
多模态难治理:文本、图像、音视频等非结构化数据量大却"用不上",资产化层面缺手段;
合规审计压力大:数据合规与安全管理要求高,全链路的溯源与审计成本高;
缺 AI 数据底座:大模型应用缺乏高质量、可治理的数据供给,价值释放层面卡脖子。
这五个问题,单独看是技术债,合起来就是"有数据、无资产"。对应的产品价值同样清晰,且覆盖数据全层面:数据汇聚与多模态统一纳管,打通数据全形态;AI 增强治理,内置 OCR、语音转写、图像理解能力;全栈信创适配,满足国产化安全要求;数据资产化运营,为大模型提供高质量数据集;轻量化可落地,分阶段建设见效快。
三、七大核心能力:一条 DataOps 流水线贯穿数据全层面
红网鸿鹄的能力体系围绕"全域、多模态、AI 增强"展开,具体落在七项核心能力上——它们恰好对应数据从汇聚到服务的完整层面。
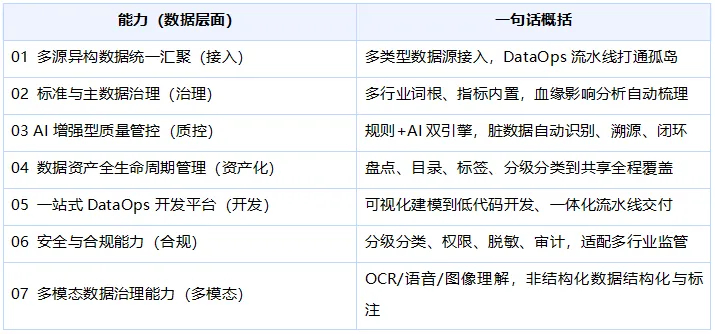
01 多源异构数据统一汇聚(数据接入层)
支持数据库、文件、接口、日志、业务系统等多类型数据源接入,适配国产数据库与传统混合架构;基于DataOps流水线实现采集、同步、清洗、流转自动化,打通跨业务域数据孤岛。
02 标准与主数据治理(数据治理层)
内置多行业标准词根、指标体系与主数据模型,支持自定义数据标准、代码字典与业务口径;统一元数据采集、血缘分析与影响分析,自动梳理数据链路,适配各行业监管报送与合规要求。
03 AI 增强型质量管控(数据质控层)
传统规则校验与轻量化 AI 算法结合,自动识别脏数据、异常值与重复数据;质量规则可配置、报告自动生成,问题数据自动溯源、告警与整改闭环,降低人工治理成本。
04 数据资产全生命周期管理(资产化层)
自动资产盘点、目录、标签与分级分类;资产门户、权限管控、数据脱敏与安全审计;实现原始数据向可复用资产转化,支持资产检索、申请与共享。
05 一站式 DataOps 开发平台(开发服务层)
可视化建模、数据开发、任务调度、版本管理与运维监控;低代码开发降低门槛,开发、测试、发布、运维一体化流水线,提升数据交付效率。
06 安全与合规能力(合规层)
数据分级分类、细粒度权限管控、数据脱敏与操作审计;适配金融、政务、能源、医疗、交通等多行业监管合规要求,满足穿透式监管与数据安全审计需求。
07 多模态数据治理能力(多模态层)
支持文本、图像、音视频、PDF 文档等多模态非结构化数据统一接入、解析与治理;内置 OCR 文字识别、语音转写、图像内容理解等 AI 能力,实现非结构化数据结构化提取与标签化;多模态元数据统一管理,支持跨模态检索与关联分析,面向大模型训练场景提供高质量多模态数据集治理与标注能力。
为便于速览,七项能力可概括为下表:
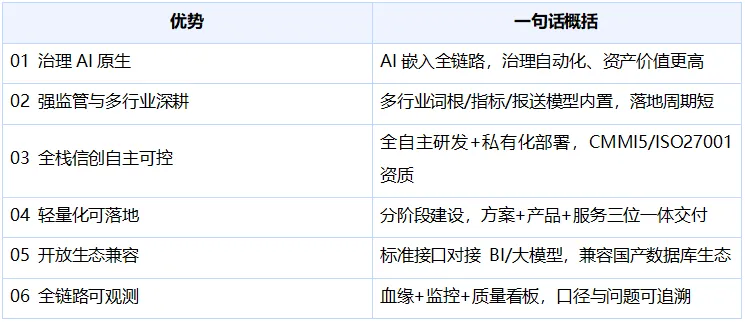
四、六大核心优势:为什么是鸿鹄
五、鸿鹄适合谁
鸿鹄面向金融、交通、制造、能源、政务、医疗、教育、零售等其他行业,尤其适配对数据安全、合规与可追溯要求高,且正推进AI与大模型应用的机构。对于正经历数字化转型、数据建设从"零散工具"走向"统一底座"的各类机构而言,鸿鹄提供的是一条可分阶段、可验证、可审计的落地路径。不必一步到位,也能每一步都见到实效。作为江苏红网"数据基座+智能决策基座"双基座体系中的数据一环,鸿鹄与上层智能决策能力形成衔接:先把数据治理干净、管明白,再让分析与决策站上可信的地基。
结语:让数据从"沉淀"走向"资产"
数据体系建设不是一次性的项目,而是一种长期能力。鸿鹄企业级数据基座的价值,不在于堆砌了多少功能,而在于它把"汇聚—治理—质控—资产化—开发—合规—多模态"这条全链路真正打通,并用AI把其中大量重复、依赖人工的环节自动化。对各类机构而言,这意味着监管报送与合规审计更从容、业务模型有更干净的数据、大模型应用有可信的数据供给。
如果把企业的数据体系比作一座城市,鸿鹄做的不是某一栋楼,而是地基、管网与电力系统——看不见,却决定了整座城市能建多高、跑多快。当数据真正成为可信、合规、可复用的资产,业务分析与智能决策才有坚实的落脚点。
数据体系建设的投入,表面看是建系统,实质上是为企业换取一种确定性:监管来时不怕查、模型来时有好数据、业务扩展时底座撑得住。这种确定性,正是鸿鹄数据基座希望与每一家机构长期共建的东西。
如您所在机构正规划数据治理体系建设,或希望了解鸿鹄数据基座在各行业场景的落地方案与行业模板,欢迎与江苏红网联系。
微信号丨江苏红网
合作联系丨025-52301555
红 网
红网依托鸿鹄-企业级数据基座、鲲鹏-企业级智能决策基座两大核心产品体系,搭建企业级数据智能决策大脑。在监控监测、风控合规、客户运营、情报分析等业务领域提供专业服务。
秉持“让数据可信赖,让 AI 真落地”理念,以“数据筑基、决策智能”推动企业新质生产力跃升。
官网|www.hongwangweb.com
公司地址|南京市雨花台区安德门大街55号
洁源金融城6号楼6层