ARTICLE · 1110084
AI 都能直接查库了,我为什么还写一个用 TypeScript 查数据的工具
让 AI 直接连上数据库问问题,现在不算新鲜事了。装个 MCP,或者随便找个带数据库插件的聊天工具,问一句「单价高于 0.99 的曲目里,每个艺人最长的三首是哪几首」,几秒钟后答案就出来了。
我也这么用。用了一阵子发现,拿到答案之后我总要接着追问,而追问的东西它都答得不太好:
- 这个数是怎么算出来的?
它会给你一段 SQL,或者一段解释,你得读懂了才敢信。 - 条件改一下呢?
「贵一点的」改成「贵很多的」,它得重新理解整句话,说不定把别的地方也一起改了。 - 下周再问一遍呢?
那条对话早沉下去了,得重新描述一遍问题,再指望它这回理解得跟上回一样。
问题出在哪?我觉得不在模型。自然语言这个接口,天生就不太适合核对、微调和重复这几件事。
Stack Overflow 2025 年开发者调查里,46% 的受访者不信任 AI 输出的准确性,66% 把「答案差一点就对」列为最大的困扰(调查原文)。「差一点就对」是最耗人的那种:不能直接用,又舍不得扔,只能一行行核。
为什么我还是想用代码查
先说清楚,我不反对 AI 查库。我只是觉得有些需求用代码表达,比用自然语言更快也更准,尤其是探索式的需求。
还拿上面那个问题说。「最长」是按时长还是按文件大小?「每个艺人」算不算合作艺人?「贵一点」是贵多少?每个词 AI 都得替你猜一次。换成代码,就没什么可猜的:
tracks .where(t => t.unit_price > 0.99) .groupBy(t => t.album.artist.name) .map(g => ({ artist: g.key, top3: g.orderByDesc(t => t.milliseconds).take(3), })) .dump();想看前五首,take(3) 改成 take(5);想按文件大小排,milliseconds 改成 bytes。改完 ⌘↵,看一眼结果,接着改。探索数据基本就是在重复这个循环,循环转得快,能问的问题就多。用自然语言转这个循环,每一圈都得重写一段话,然后再核一遍它到底改了什么。
还有个原因。要是 AI 时代最后只剩几门编程语言,TypeScript 大概率还在,它是这代全栈开发者的默认语言。但让 AI 写代码,前提是你读得懂它写的,而读得懂的前提是你自己还会写。查数据这件事,我不想外包到自己完全不碰代码的地步。
所以我要的很简单:用代码查,用我已经会的那门语言。
然后发现 JS 这边没有趁手的工具
JS 这边查数据库的库不少,Kysely、Drizzle、Prisma 都好用。但它们都是给应用代码准备的:schema 要迁移,查询要 review,代码要在线上跑几个月。我想要的「现在看一眼」,不在它们的问题清单上。
真到了随手查一下的时候,就剩两条路。一条是开 SQL 客户端,只能写 SQL,只给你一个网格,想 .map 一下或者引个 npm 包,就得出去另找地方。另一条是 mkdir test && npm init -y,粘连接串,console.log(JSON.stringify(rows, null, 2)),终端刷出一堵墙,改一行再刷一堵。
写 Python 的同事没这个烦恼。开 Jupyter,import pandas,三十秒后已经在看一张能排序的表了。代码写完就扔,不心疼。
JS 这边一直缺这么个东西。我找了一圈没找到,就自己写了一个:QuelPad,是一个桌面应用,我做了六个设计选择。
选择一表名直接当变量用,写法跟数组一样简洁可读
上面那段代码里的 tracks 没有 import,也没有 db.table("tracks"),连上库它就在那儿,是个全局变量。列挂在 lambda 参数上,t. 敲下去会弹出这张表的真实列名和关系;列名写错,编辑器里直接红线,不用等跑到数据库那边报错。
.where / .groupBy / .map 的用法和数组方法一样。t.album.artist.name 是顺着关系点下去的:曲目属于专辑,专辑属于艺人。JOIN 不用写,关系会自己加载。g 就是这一组里的曲目,「组内按时长倒序取前三」自然就写成 .orderByDesc(...).take(3)。
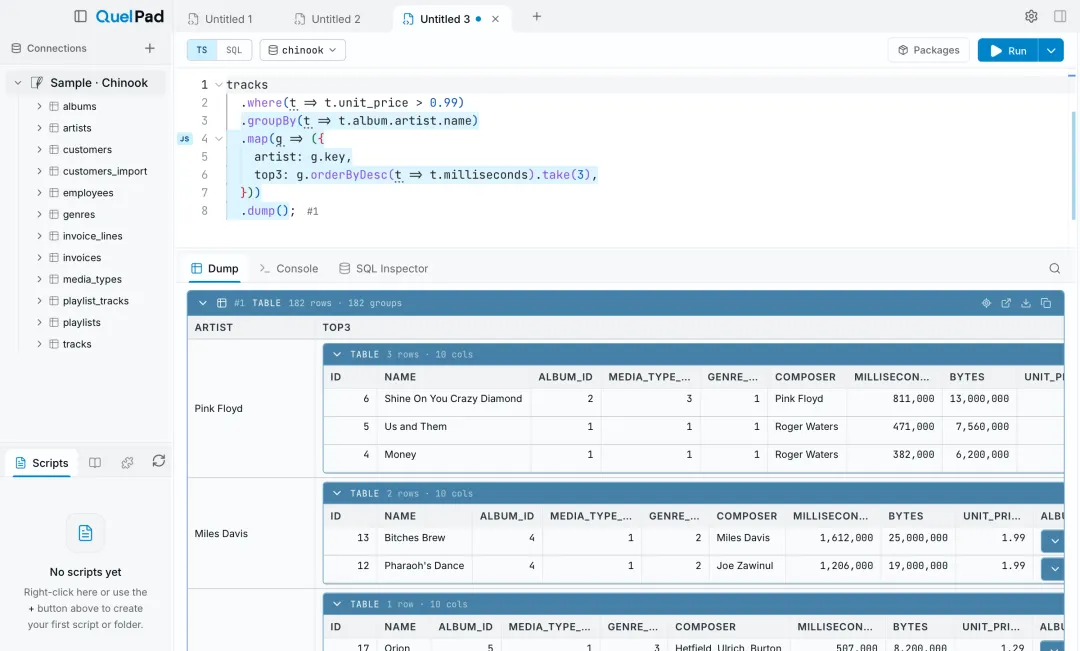
182 rows · 182 groups:182 个艺人,每人一行,top3 是能展开的子表。整个过程没碰 ROW_NUMBER() OVER (PARTITION BY …)。组内 Top-N 这类东西,还有移动平均、累计求和,都不用写窗口函数。
选择二在哪执行,写的时候就看得见
写法既然像数组,很自然会问:它是不是把整张表拉进内存了?
没有。规则只有一条:你用的动词决定这一步在哪跑。
.where.orderBy / .orderByDesc / .select / .distinct / .skip / .take | |
.map.sort / .window / .scan / .runningSum / .partition … | |
.groupBy | .select(g => …) 编译成 GROUP BY;接 .map(g => …) 就在脚本里分组,你拿到的是组内每一行 |
这条规则是写死在编译器里的,不会哪天版本一升就变。写的时候,编辑器会把在脚本里跑的那一段标成浅蓝:
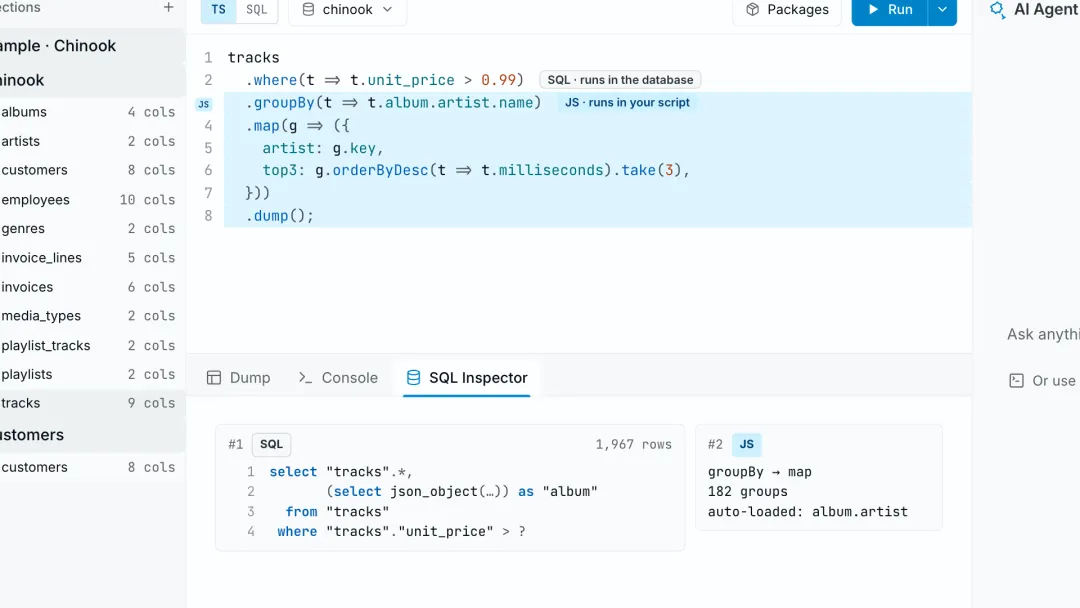
Inspector 里一步一条记录。上图的 #1 SQL 是 where 编译出来的查询,数据库先过滤,只交出 1,967 行;#2 JS 是分组和组内排序,在脚本里做。开头第一个问题「这个数怎么算出来的」,答案就是这两条记录,每一步都看得见。
对比一条从头到尾都在数据库里跑的链:
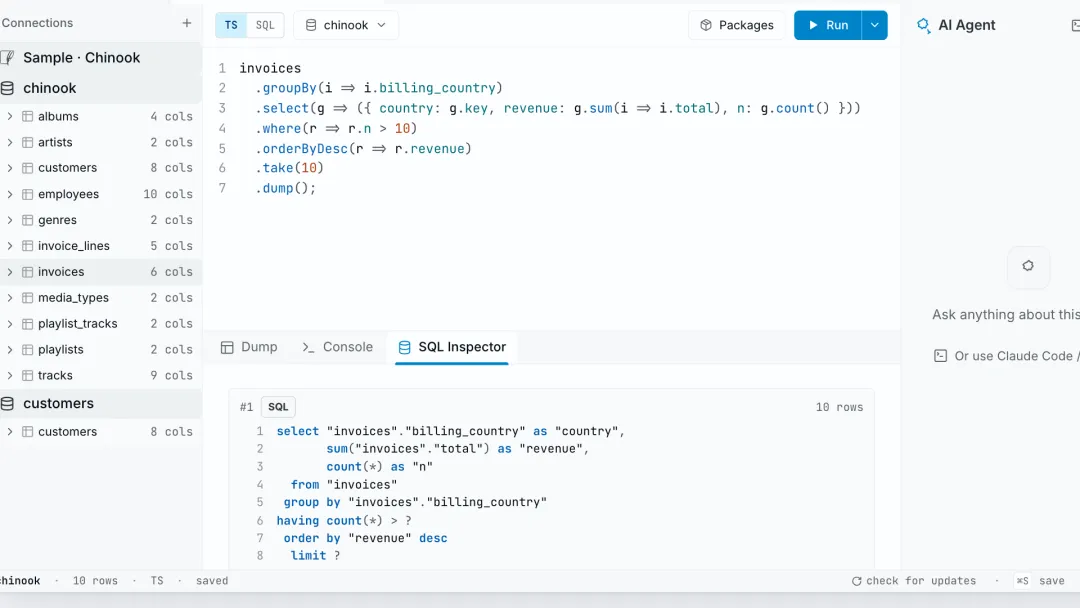
同样是 .groupBy,后面接的是 .select,编辑器里一行蓝底都没有,Inspector 里只有一条 SQL:分组之后的 .where 变成了 HAVING,.take(10) 变成了 LIMIT。卡片题头 10 rows,脚本这边什么都没算。
选择三查询结果直接展示,不用再翻 console.log
链尾的 .dump() 会看值的形状自己挑渲染方式:对象、数组能折叠、能导出的嵌套表格,支持超长列表的虚拟滚动。
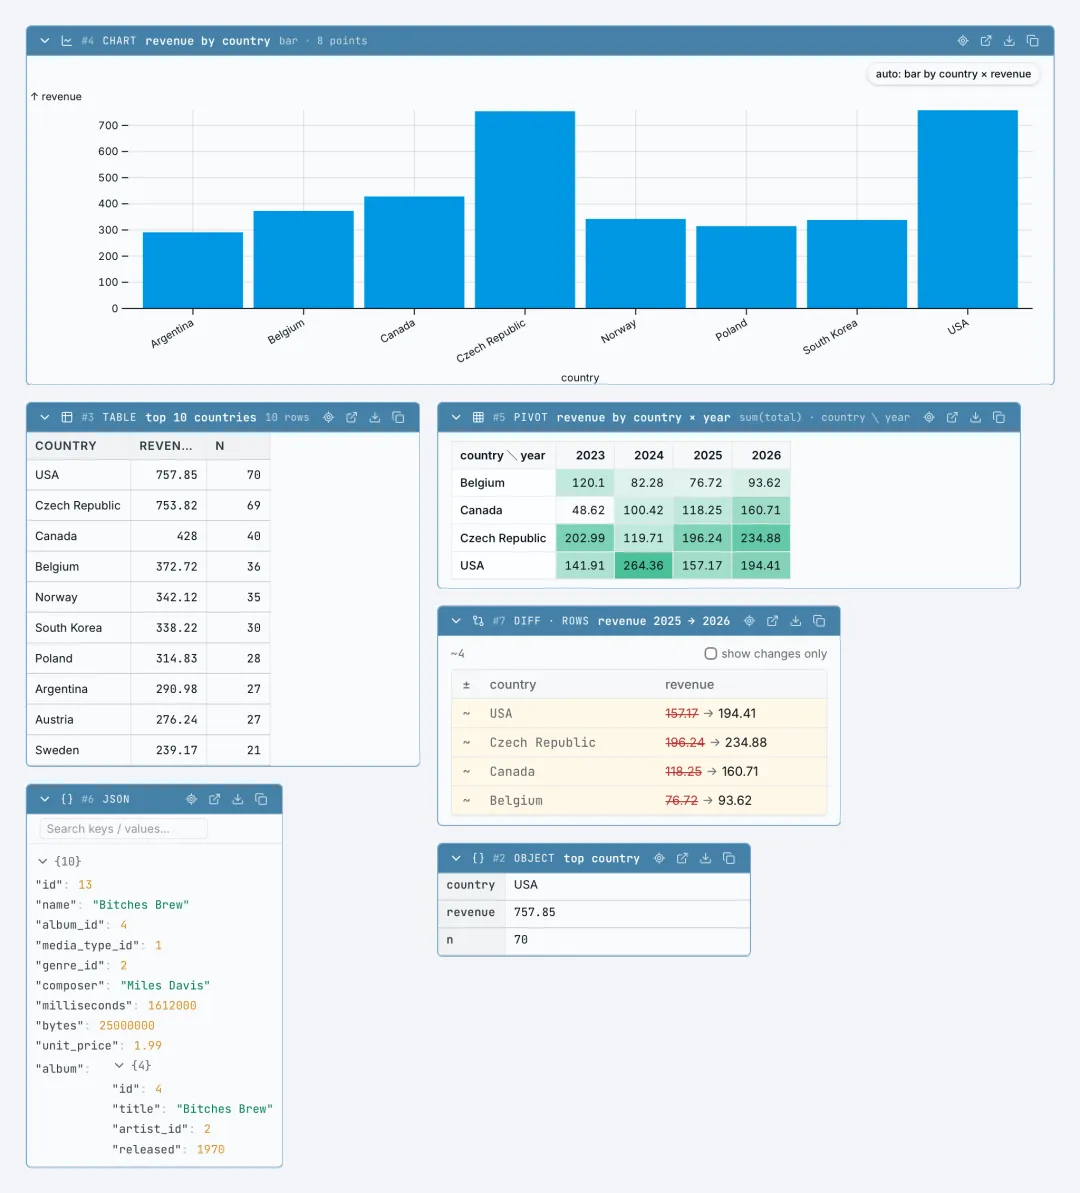
把 .dump() 换成 .chart() 就是图表,不指定类型时它自动选择。dump.pivot 出透视表,dump.diff 把两份数据逐行对比,fetch 回来的 JSON 不用再 JSON.stringify,dump.json(await res.json()) 渲染成可折叠的树,跟 DevTools 里一样一层层点开。上面这张图就是同一段脚本跑出来的几张卡片。
选择四像 notebook 一样分段运行,保存下来还是一个 .ts
Jupyter Notebook 里真正好用的是 cell:上面那段查询跑过一次,下面改一行,只重跑下面那段。
QuelPad 用一行注释来分:// @cell(可以带名字,比如 // @cell share)。第一个 marker 之前的代码就是第一个 cell。每个 cell 运行时自动缓存,改了下面的再 Run,上面的直接从缓存回放,只重跑改过的 cell 和它后面的:
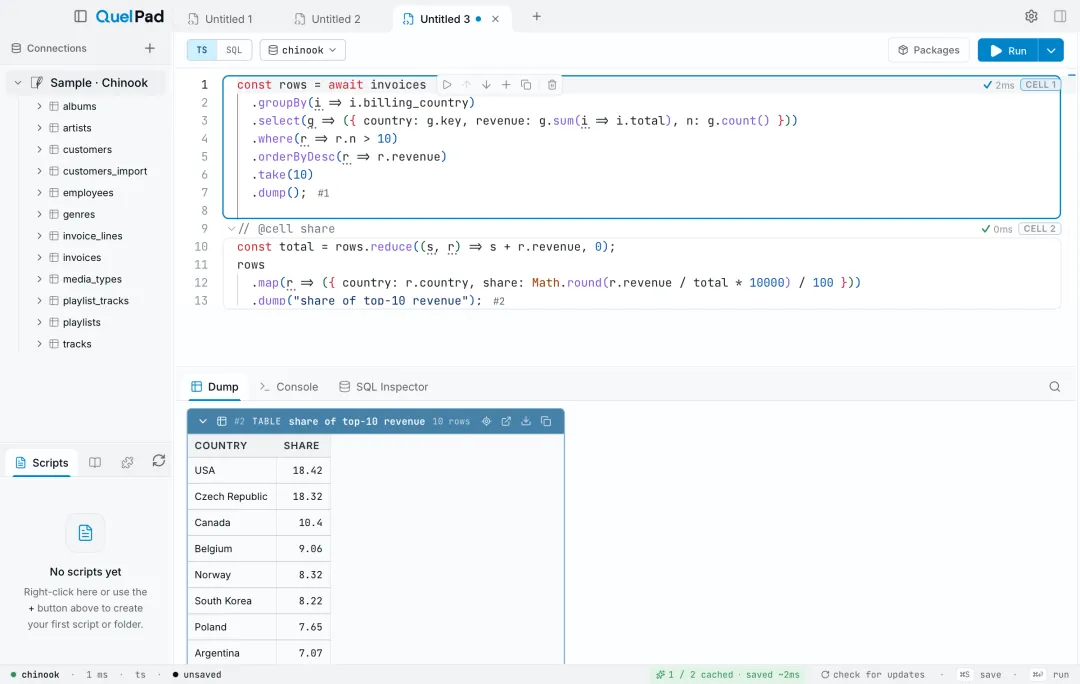
第二个 cell 算的是这十个国家各占多少。把第二个 cell 的小数位数改一下再跑,第一个 cell 那条查询不会再发到数据库。
选择五让 AI 把答案写成你能修改的代码
回到开头那三个追问。工具里 AI 还在,只是它交出来的东西变了。
内置的 AI(接你自己的 API Key,或者本地模型)回答「每个艺人最长的三首」,给的是选择一里那条链,直接写进编辑器,右侧弹一张 Edit applied 卡片列出 diff,能撤销:
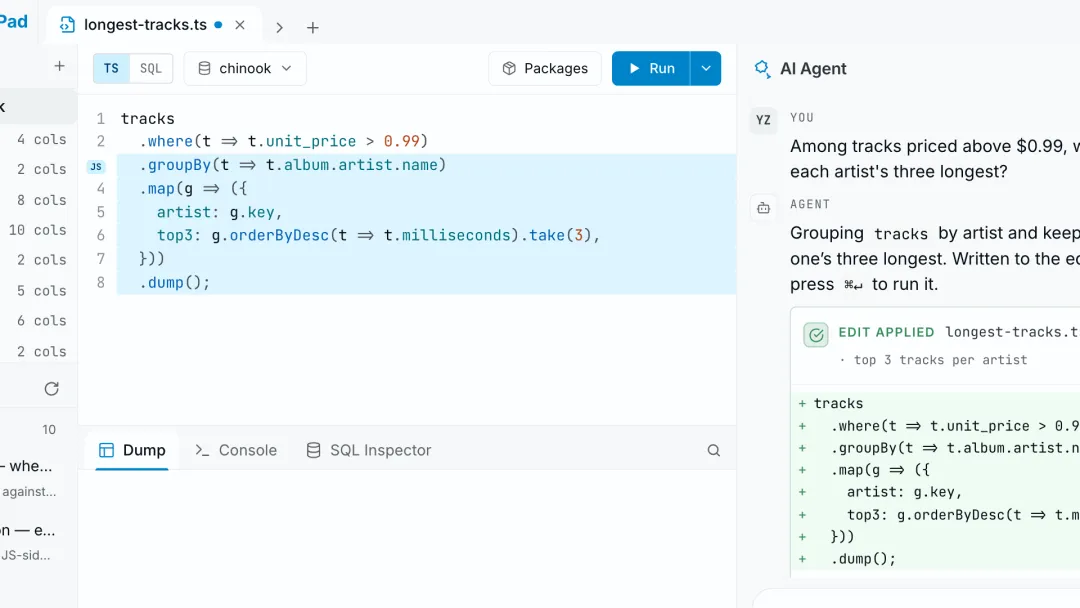
where、groupBy、map,可以一行一行对着问题核。它写的列名要过和你写的一样的类型检查。要不要运行,看你的设置(默认每次问你)。
选择六让自己的 agent 安全可信地执行
如果用 Claude Code、Cursor、Codex 这类 agent,直接连库,等于完全信任它的所有操作;而且很多数据库本身语义并不清楚,你需要跟它一次次解释。
QuelPad 给Agent准备了一个 quelpad 命令,也可以 quelpad mcp 作为 MCP server 接进去。agent 用 quelpad schema 读表结构,quelpad check 检查自己写的脚本,quelpad run / quelpad sql 跑查询。QuelPad 夹在中间,管两件事。
一是语义。你在 Semantics 里给表和列写过的说明,会作为 note 跟着 schema 一起给到 agent。写一次,之后每个会话、每个 agent 都知道这列是什么意思,不用再猜。
二是权限。数据库密码留在 QuelPad 里,agent 拿不到。agent 能做到哪一步,每个连接单独设:
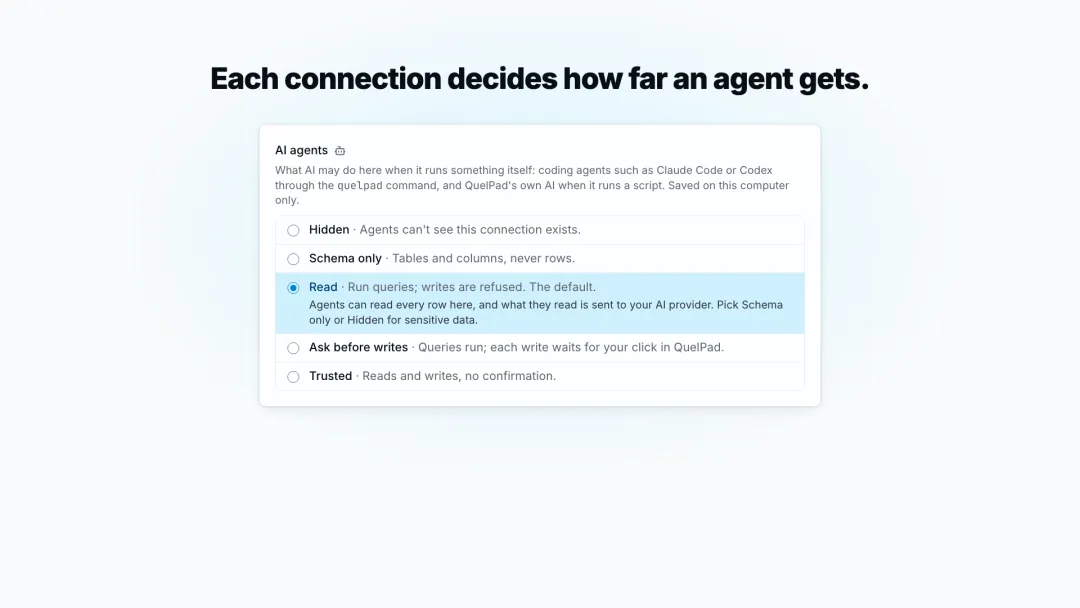
如果Agent要写入数据,Quelpad负责展示给你要修改的内容,让你确认是否继续。
最后
「AI 查库」和「代码查库」不用二选一。我想要的是让 AI 写出你读得懂、改得动、下周还能再跑的代码。
下载:quelpad.com · 文档:docs.quelpad.com/zh-cn
演示视频:
没有数据库也能用:CSV / Excel / JSON / Parquet 可以直接拖进来,就是一张带类型的表;也能 import npm 包、fetch 接口。不过它的重心还是查库。
评论区聊聊:你现在是怎么让 AI 查数据的?拿到数字之后,会去核吗?
QUELPAD · 开发手记