ARTICLE · 1111237
「AI编程省token」Headroom深推:工具输出压90%,Claude Code/Codex账单直降
写 AI 编程的人多半算过模型单价,却很少算另一笔账:Agent 每天读进去的东西到底有多少。Claude Code、Codex 这类终端 Agent 每调一次工具,就把一坨 JSON、一段日志、一个文件原样塞回上下文;会话越长,工具输出越堆越高,账单也就跟着涨。真正贵的还不是输入——很多模型的输出单价是输入的几倍,而 Agent 写回去的内容里,有一大半是"好的,我来看看"这类客套话和刚读过一遍的代码原文。
这周 GitHub 上有个项目专门啃这块:headroomlabs-ai/headroom。它的一句话定位是——在内容到达 LLM 之前,把工具输出、日志、RAG 片段、文件和对话历史全部压缩掉;同样的答案,只花零头的 token。
一、先把它的底细核实清楚
截至 2026-10-01 通过 GitHub API 核实的数据:
74,188 星、5,734 次 fork、219 个关注、541 个未关 issue 主语言 Python,Apache-2.0 许可,2026-01-07 建仓,最近一次代码推送 2026-10-01(今天仍在推) 最新 release 是 v0.39.1(2026-09-26),仓库标签里写着 compression、context-engineering、token-optimization、mcp、proxy、rag
它不是一个"聊天记录摘要器",而是一层跑在你本机上的上下文压缩层:压缩全程在本地完成,你的 prompt 和文件内容不会为了被压缩而发到任何地方。它同时给了库、代理、Agent 包装和 MCP 服务四种形态,代码改不改都能用。
二、压缩是怎么发生的
一次请求走的是固定流水线:Setup → Pre-Start → Post-Start → Input Received → Input Cached → Input Routed → Input Compressed → Input Remembered → Pre-Send → Post-Send → Response Received。
真正干活的是三个按内容类型分工的转换器:
CacheAligner 标出会打爆供应商 KV 缓存前缀的易变内容,但它从不改写 prompt; ContentRouter 判断这段内容是什么类型,再选对应的压缩器; SmartCrusher 处理 JSON——数组套字典、嵌套对象、混合类型。它靠字段方差统计挑要保留的项,而不是拿关键词表硬匹配;错误项、超出正常范围的异常值、首尾边界都会被留下; CodeCompressor 处理源码,按 AST 理解 Python、JS/TS、Go、Rust、Java、C/C++、C#、PHP; Kompress-v2-base 处理散文,这是官方在 HuggingFace 上训练的模型,训练数据是 Agent 轨迹。
还有一条设计是"压缩"和"提示缓存"两个诉求之间少见的兼顾:活区压缩(live-zone compression)。只有新增的字节被压——刚返回的工具输出、最新一轮对话;冻结的前缀逐字节不动,供应商的缓存因此存活,历史也不会被丢。缓存前缀在 Agent 场景里就是钱,改一个字节,整段缓存作废、全价重算。
三、它自己公布的实测数字
README 里给了一张用供应商 tokenizer 和它自带的 compress() 跑出来的对照表,场景都按真实 MCP 服务器输出格式构造、固定随机种子、离线跑:
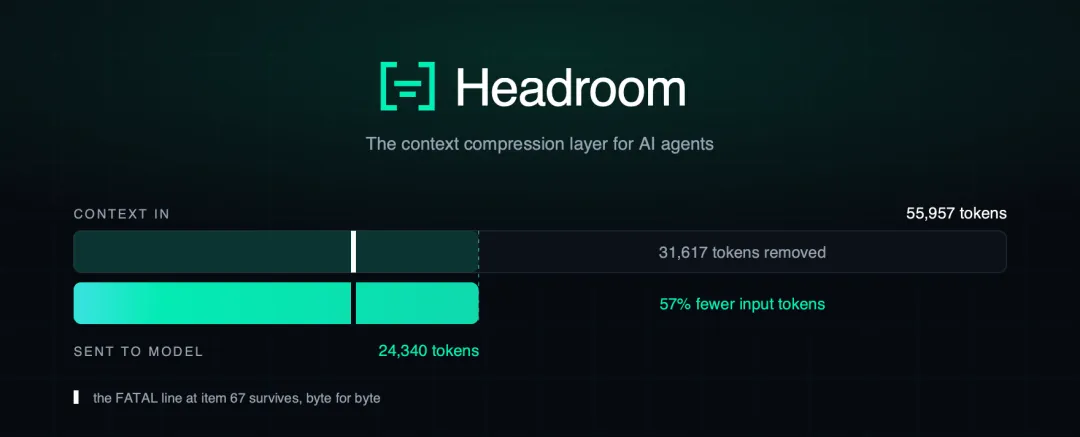
代码搜索(100 条结果):17,199 → 13,597,省 21% SRE 事故排障:55,957 → 24,340,省 57% 代码库探索:58,801 → 33,895,省 42% GitHub issue 分诊:46,067 → 32,429,省 30%
省多少取决于内容有多重复:重复的 JSON 数组和日志行在另一个延迟测试里能压到 90% 以上,散文和本来就密的输出几乎压不动。压缩本身耗时远低于 1 毫秒——10K token 的 JSON 搜索结果 p50 是 0.21 毫秒,100K token 时 1.4 毫秒,不会在 Agent 延迟里露头。
准确率也给了一组实测:GSM8K 数学 100 题压缩前后都是 0.870,零差异;TruthfulQA 事实性 0.530 → 0.560,官方自己说 ±0.03 落在置信区间内,所以这不算提升;SQuAD v2 在 19% 压缩率下 97%,BFCL 工具调用在 32% 压缩率下 97%。
四、输出侧也省一笔
上面压的都是你发出去的内容。模型写回来的每一个 token 你也付钱,而 Opus 这一档的输出单价是输入的 5 倍,其中很大一部分是仪式感:"好的,我来……"的开场白、把代码原样抄回一遍、把推理花在读文件这种常规步骤上。
Headroom 在代理层把这段也削掉,代码一行不用改:
简洁度引导(verbosity steering):在系统 prompt 的末尾追加一句"别啰嗦、别复述上下文",所以你的提示缓存照旧命中; 推理力度路由(effort routing):当这一轮只是模型在读完工具结果之后接着说话(读了一个文件、跑通一个测试),就把思考力度调低;新问题和报错仍然保留满力。
两者对 Anthropic 的 /v1/messages 和 OpenAI 兼容的 /v1/chat/completions、/v1/responses 都生效。输出侧省下的量是反事实的——我们看不到模型"本来会写"什么,所以它给的是带置信区间的估计,并明确标成估计值:
headroom output-savings# Reduction: 31.7% (95% CI 27.7% … 35.7%) [estimated]想要实测值,就把 10% 的会话留作不打磨的对照组(export HEADROOM_OUTPUT_HOLDOUT=0.1),看板上的 "Output Tokens Saved" 卡片会从 estimated 变成 measured。
五、四种接入方式
按"改代码多少"排,它有四种接法:
# 装uv tool install --python 3.13 "headroom-ai[all]"# CLI,独立环境pip install "headroom-ai[all]"# Python,带 CLInpm install headroom-ai # 只有 TypeScript SDK,没有 CLI# 选一种模式headroom deploy # 本地一键部署 + 写 Agent 配置headroom wrap claude # 包住一个编程 Agentheadroom proxy --port 8787 # 零改代码的落点代理# 或者:from headroom import compress # 库内联库内联只有几行:
from headroom import compressfrom openai import OpenAImessages = [{"role": "user", "content": "Analyze these results"}]result = compress(messages, model="gpt-4o")client = OpenAI()response = client.chat.completions.create(model="gpt-4o", messages=result.messages)print(f"Saved {result.tokens_saved} tokens ({result.compression_ratio:.0%})")headroom wrap 支持一长串 Agent:claude、codex、grok、copilot、cursor、aider、opencode、cline、continue、goose、openhands、openclaw、vibe、omp、zcode。它会起一个本地代理,顺手把 Serena 装上做语义代码导航,再把 Agent 配好、路由到 Headroom 上;不想要 Serena 就加 --code-memory none,反悔用 headroom unwrap <tool>。
有一个细节值得单独说:如果你本来就在跑代理,headroom wrap 不会再起一个,而是复用它。这些开关是每个请求实时读的,但复用起来的代理环境是启动时快照的,所以之后 export 的变量它看不到——它会通过回环的 POST /admin/runtime-env 把当前设置热同步给运行中的代理,不重启、不断请求。共享代理上这些覆盖是全局的,最后一次显式设置生效。
六、可逆、跨 Agent 记忆、失败学习
可逆(CCR):原文缓存在本地,模型需要全文时可以调 headroom_retrieve取回。压缩不是单向的,TTL 内原文一直可查。跨 Agent 记忆:Claude、Codex、Gemini、Grok 共用一个记忆库,自动去重; SharedContext让多 Agent 工作流之间传的是压缩后的上下文。headroom learn:挖失败的会话,把纠正写进CLAUDE.local.md(默认,已 gitignore)、CLAUDE.md、AGENTS.md、GEMINI.md或GROK.md。它还能从你过去打断长回复、没读完就翻页的行为里,反推你想要的简洁程度:
headroom learn --verbosity # 先预览它发现了什么headroom learn --verbosity --apply # 存下来,代理会自动读到MCP 服务: headroom_compress、headroom_retrieve、headroom_stats三个工具,任何 MCP 客户端都能挂。
七、几个容易踩的坑
短对话、散文、本来就密的输出几乎压不动,低于 min_input_words的内容会逐字节原样返回。别指望它对所有流量都有效。遥测默认是开的。它只报压缩比例、计数、供应商和模型 ID、系统和架构,不报 prompt、补全、代码和文件路径;想关用 HEADROOM_BEACON=off、DO_NOT_TRACK=1或--offline。输出侧压缩默认是关的,要 export HEADROOM_OUTPUT_SHAPER=1才开。公司网络里可能装不上:构建后端 maturin会下载rustup,走的是你不信任的连接。先装好 Rust,或者直接pip install --only-binary headroom-ai headroom-ai用预编译轮子,绕开 Rust 构建。Intel Mac 没有预编译的 ONNX Runtime(issue #941),源码构建会失败,要 brew install onnxruntime再指ORT_STRATEGY=system;原生轮子目前只覆盖 macOS Apple Silicon 和 Linux。cdn.pyke.io和huggingface.co这两个下载域名可能被挡:ONNX Runtime 走 Mozilla 的根证书,Kompress 模型走系统证书库;被挡时预下载后跑HF_HUB_OFFLINE=1,或把HF_ENDPOINT指向可信镜像。纯做网关、关掉压缩就不需要这两个资源。代理启动时会每天最多查一次 PyPI 看有没有新版,想彻底关掉用 HEADROOM_UPDATE_CHECK=off。x86 主机需要 AVX2。内容检测和嵌入相关性走的是预编译 ONNX Runtime,没有 AVX2 的 x86 主机(部分 Docker/QEMU、老云主机)会自动回退到 BM25 相关性加启发式检测,不会崩,但效果打折。
八、适合谁
每天开着 Claude Code / Codex / Cursor 写代码,工具输出和日志把上下文吃满、账单心疼的人; 同时在用好几个 Agent,想要一个共享记忆库的人; 需要压缩可逆、原文随时能取回的人; 已经用着某个 Agent 自带的上下文压缩,但想在它前面再压一层的人。
反过来,只用一家原生的上下文压缩、不需要跨 Agent 记忆,或者在本地进程跑不起来的沙箱里工作的人,可以先跳过。
一句话结论:Headroom 值得看的不是"又一个省 token 的小工具",而是它把 Agent 读进去的东西整段接管了——工具输出、日志、RAG 片段、文件、历史,在进模型之前先按内容类型在本地分别压掉,重复的 JSON 和日志行能压到 90% 以上;压缩耗时不到 1 毫秒,10K token 的 JSON 搜索 p50 只要 0.21 毫秒;只压新增的活区、冻结前缀不动,供应商缓存照样命中;原文用 CCR 存在本地随时可取,还能让 Claude、Codex、Gemini、Grok 共用一个记忆库。仓库是 Apache-2.0 的 Python 源码,最新 v0.39.1,想看清它怎么在本地分类型压缩、怎么和各个 Agent 对接,翻 headroomlabs-ai/headroom 的 README 和 docs 比任何转述都实在。