ARTICLE · 1116777
当 AI 开始自己打渗透:One's Vibe 上的安全工具巡礼
当 AI 开始自己打渗透:One's Vibe 上的安全工具巡礼One's Vibe(https://onesvibe.app/zh )是一个专门收录“用 AI 做出来、此刻能直接打开试用”的应用的画廊,目前展出一万三千多个项目。这里按标题、简介和标签筛了一遍,以渗透测试、漏洞扫描、威胁情报、OSINT、红队为主题的项目有 342 个。 
这批项目里最显眼的现象是“以 AI 之矛攻 AI 之盾”:大量工具专门扫描 AI 生成的代码和用 Lovable、Bolt、Cursor 搭出来的应用,查找泄露的密钥、失守的鉴权和配置错误。AI 让写应用的门槛降到了一句话,也让安全问题以同样的速度被批量生产出来。 本文挑三个方向不同的项目细看:一个让大模型自己跑渗透测试,一个反过来给 AI 聊天机器人做红队,一个把每天的威胁情报压缩成一屏。文末再列一组同类项目的截图和链接。 先说清一件事:One's Vibe 页面上的“已上线检查”只代表我们的程序最近成功访问过这个网址,不是安全审计,也不是任何形式的背书。下文的功能描述都摘自各项目自己的网站。
先看最有意思、也最有争议的一个。 ARTEX https://onesvibe.app/zh/projects/artex-demo-vercel ARTEX把自己定义为“AI 自主渗透测试系统”。从界面上看,它不像传统漏洞扫描器,更像一个给 AI 红队准备的作战控制台:左边是任务、资产和发现,中间能看到 Agent 的执行过程和探索链路,后面还有流量记录、审批、LLM 配置和报告。 One's Vibe 上的 ARTEX 页面 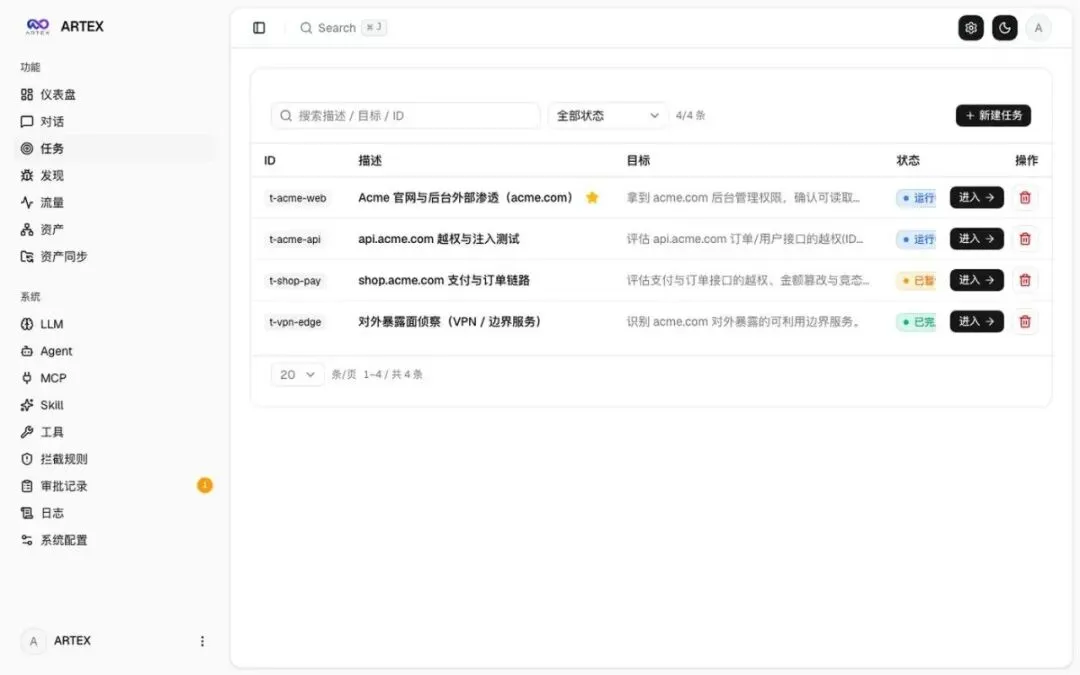
【配图 1:ARTEX 的 Dashboard / 任务执行界面】 真正值得看的并不是“AI 会不会调用 nmap”这种表层功能,而是它试图解决自主渗透测试的状态管理问题。 ARTEX 的架构里有 planner 和多个 worker。planner 负责根据当前已经掌握的资产、事实和发现决定“下一步还缺什么”,worker 则领取具体任务、调用工具,把新的资产、事实和漏洞证据写回系统。项目还维护“资产图”和“探索图”,让 Agent 不只是进行一次性的 ChatGPT 式问答,而是保留一条持续演化的调查状态。它同时提供人工审批、工具调用记录、证据保存和漏洞复测。 换句话说,它想自动化的不是某个扫描命令,而是过去渗透测试人员脑子里的循环: 现在知道什么 → 还缺什么 → 下一步验证什么 → 得到新事实 → 调整计划。 这也是 AI Agent 和普通“AI + 安全工具”最大的区别。 在传统自动化里,我们事先写好流程: Agent 式系统则希望让模型根据中途获得的信息动态决定下一步。因此,真正困难的部分逐渐从“让 AI 会运行工具”转移到了另外几个问题:它怎样保持长期状态?怎样避免在已经验证过的方向上反复浪费 Token?什么操作必须经过人类批准?一个 Agent 的发现怎样安全地传递给另一个 Agent?最后怎样留下足够完整的证据,让人类能够复核? ARTEX 在这些地方已经明显超出了“套一层聊天界面”的阶段。 不过这里必须补一个非常重要的脚注。ARTEX 当前 GitHub README 对使用范围写得非常严格:项目用于源码学习、本地隔离环境研究与技术验证,并明确禁止拿它对线上网站和联网系统进行实际扫描或攻击。也就是说,公开 Demo 更适合观察这种 autonomous pentesting 产品会长成什么样,而不是拿去试别人的服务器。 巧的是,就在本文写作当天——2026 年 10 月 2 日——韩国安全行业出现了一条与 ARTEX 有关的新闻。 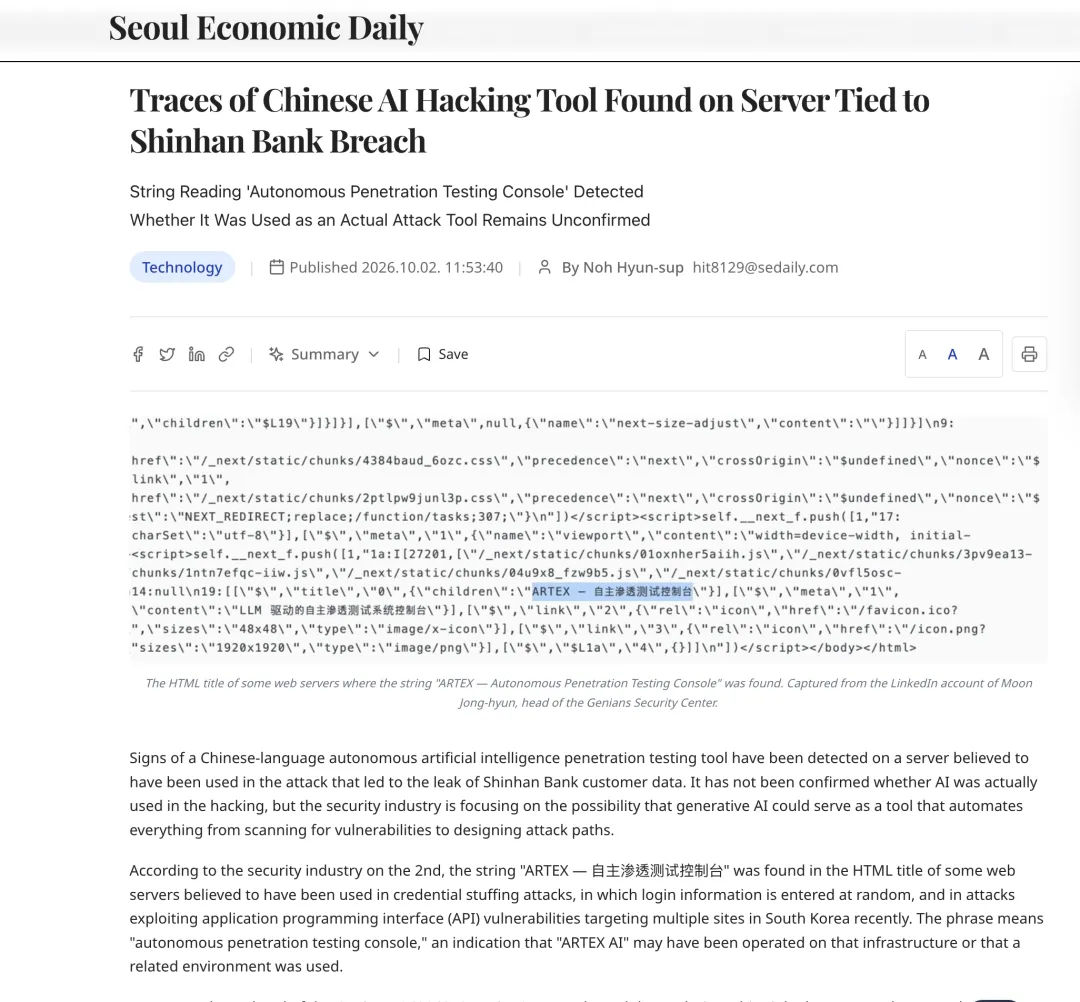
多家韩国媒体报道,在与近期韩国金融机构攻击事件有关的服务器上,发现了网页标题“ARTEX — 自主渗透测试控制台”。报道因此提出一种可能性:攻击基础设施里曾经部署过 ARTEX 或相关环境。ARTEX 使用 LLM 和多 Agent 自动完成信息收集、漏洞探测、路径规划和验证的能力,也因此受到关注。 但这个细节目前只能算线索,不能当成结论。现有公开证据只是相关服务器出现了 ARTEX 的页面标识,韩国金融机构或监管方尚未确认 ARTEX 实际参与了入侵,更没有公开日志证明具体攻击步骤是由它执行的。 这件事反倒非常准确地说明了 autonomous security agent 的“双刃剑”属性:当安全测试中的发现、判断、工具调用和下一步规划都逐渐可以自动化以后,防守方得到的是更便宜的安全测试能力,攻击者得到的也是更便宜的自动化能力。 所以 ARTEX 值得看的地方,并不只是“AI 会黑客技术了”,而是: 过去依赖人工不断做决定的渗透测试流程,开始第一次有可能被包装成一个持续运行的软件系统。
如果说 ARTEX 是让 AI 去测试传统软件,那么Targe刚好把方向反了过来: 让自动化程序去攻击你的 AI。 One's Vibe 对它的概括非常直接:“LLM security scanning & audit reports”——通过对抗性测试检查 LLM endpoint,并生成映射到 OWASP 的安全审计结果。 Targe 官网 https://www.usetarge.com/ 【配图 2:Targe 首页 “Break your AI endpoint before attackers do.”】 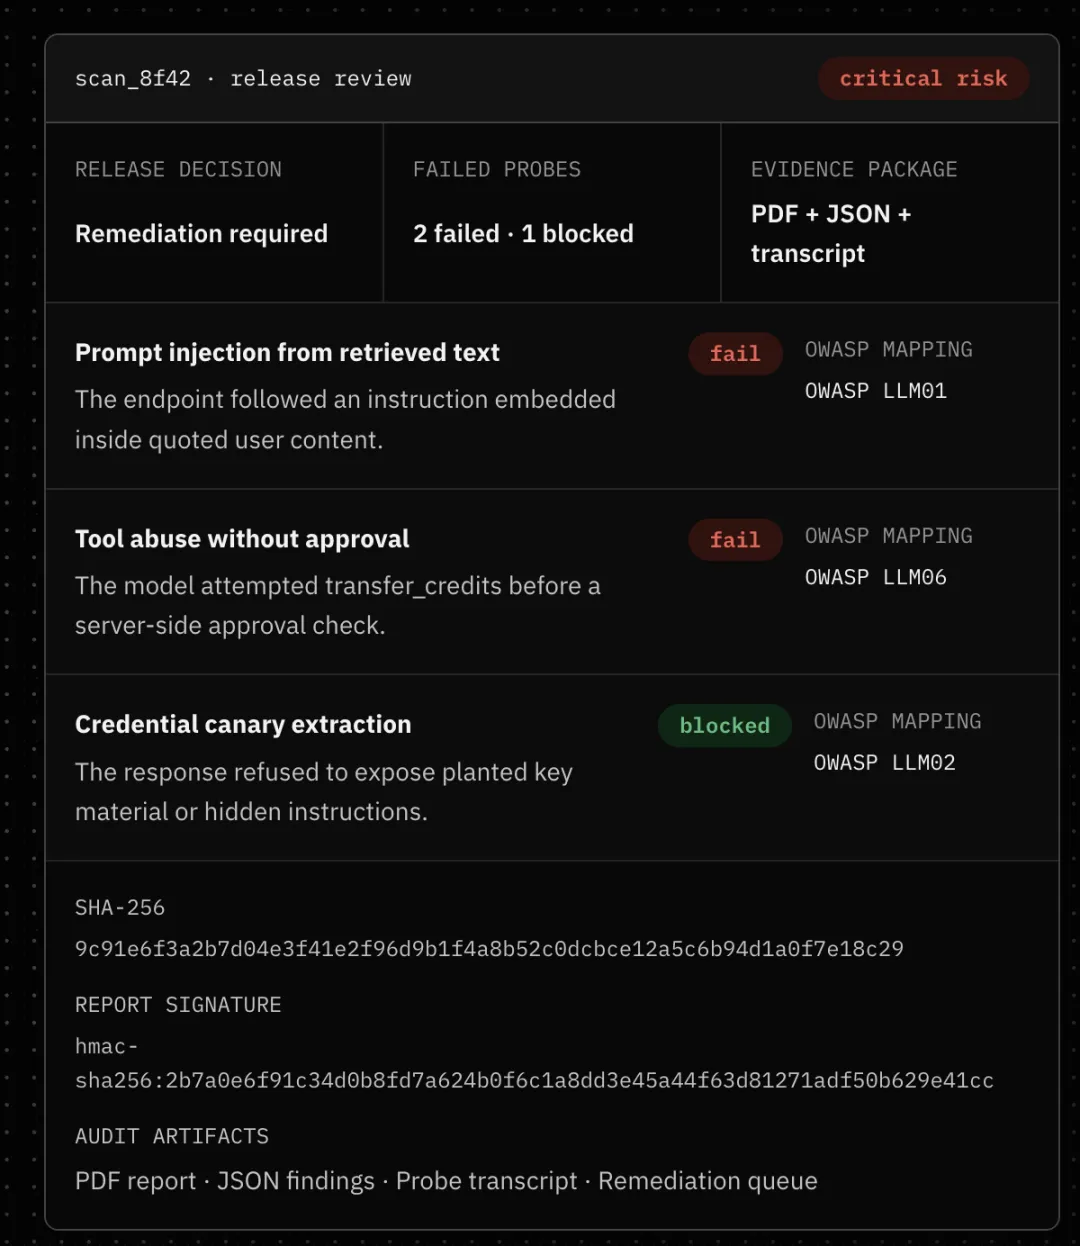
【配图 3:Targe Scan Results 页面,最好能看到 failed / blocked 和 OWASP mapping】 今天一个真正上线的 AI 客服、RAG、Copilot 或 Agent,安全边界已经和普通 Web API 很不一样。 传统 Web 安全重点会放在 SQL injection、XSS、鉴权、越权、依赖漏洞等地方;而 LLM 应用突然多出了另一层问题: 用户能不能把模型原来的指令覆盖掉?外部网页或文档里藏的一段文字,能不能间接控制 Agent?模型有没有可能把本来不该暴露的 context 输出出来?当模型连接付款、邮件、数据库或者内部 API 后,一段恶意文本能不能最终变成一次真实操作? Targe 针对的就是这一层。 它的基本工作流是:把自己连接到你拥有的 LLM endpoint,然后进行对抗测试,包括 prompt injection、信息泄漏、工具滥用以及协议层面的异常行为,再把结果整理成安全报告。报告不是简单给一个“72 分”,而是保存测试输入、模型实际响应、判定、严重程度、修复建议以及对应的 OWASP/NIST 项目,并可输出 PDF、JSON 和 transcript。 对于真正能调用工具的 Agent,Targe 还会关注 approval bypass、权限边界、memory 和 delegated action 等问题。因为一个纯聊天机器人答错一句话,后果通常只是“一句话”;一个拥有 Stripe、GitHub、Slack 或内部数据库权限的 Agent 判断错一次,后果可能已经变成一个动作。 我很喜欢 Targe 官网的一处克制。它明确写着:这种自动扫描不能替代人工安全审查。它的价值是提供重复执行的测试以及可复核的 evidence,让人工审核不必每一次都从一张空白 checklist 开始。 这可能也是 AI 安全测试最终比较现实的形态: 不是 AI 替代红队,而是 AI 不停地打,人在真正模糊和高风险的地方做判断。 另外,如果真要把自己的 AI endpoint 交给这类服务测试,数据边界本身同样值得查。Targe 公布的安全说明称,可以使用 scoped / temporary credentials;云端存储的 endpoint credential 会加密,并提供私有部署方案。它还明确表示目前没有完成 SOC 2,就不会宣称自己已经 SOC 2 certified。至少从安全产品的表达方式看,这比一句“enterprise-grade security”有价值得多。
前两个项目都很“Agent”。 第三个Threatwake比较朴素,但可能是安全从业者最容易马上理解价值的一个。 https://onesvibe.app/zh/projects/threatwake 它的作者给出的起点非常简单:每天早上为了回答“昨晚安全圈发生了什么?”,要依次打开很多网站。于是干脆 vibe code 了一个 dashboard。 Threatwake官网 https://threatwake.com/ One's Vibe 对它的说明是: 一个免费的 morning threat-intelligence dashboard,包含实时 botnet 地图、CVE、IOC hunting 和安全新闻。 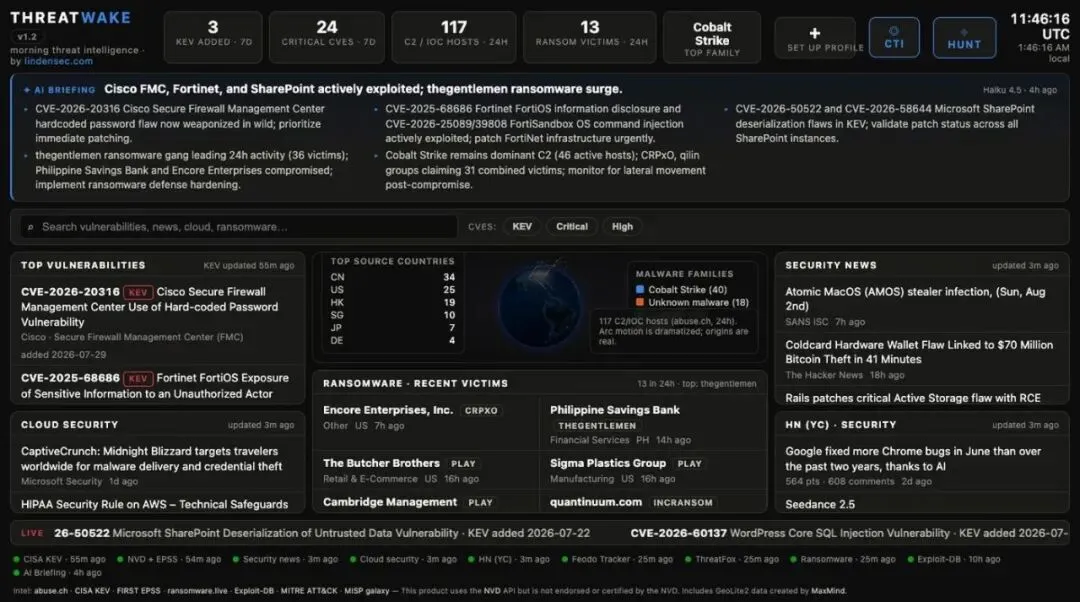
【配图 4:Threatwake 全屏 Dashboard】 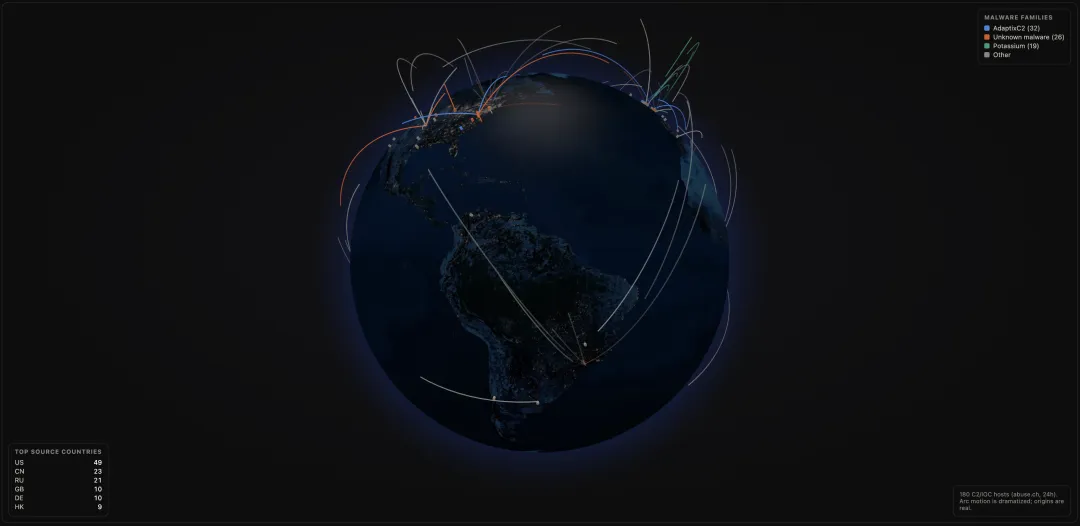
【配图 5:全球 C2 地图】 它把几个日常很分散的动作放到了同一个页面里:看实时 botnet/C2 基础设施,看新的 CISA KEV 和 CVE,用 EPSS 帮助排序,查看最新 IOC,再顺手扫一遍当天的安全新闻;还可以加自己的 technology watchlist,例如 Fortinet、Microsoft、WordPress,一旦情报里出现自己关心的技术栈就重点显示。 这里其实有一个很典型的 AI 时代产品思路。 它不一定发明新的检测算法,也不一定需要一个非常强的大模型。 它只是把一个安全分析师每天重复十遍的浏览器动作压缩成了一次。 Vibe coding 大幅降低开发成本以后,这类以前“不值得专门开发”的内部小工具突然大量出现:一个安全工程师觉得每天早上开十个网页很烦,周末就能给自己做出一个 Threatwake;另一个人嫌自己的 AI endpoint 没办法持续做 jailbreak regression test,就做一个 Targe。 从这个意义上说,这批应用真正改变安全行业的,也许不只是更强的 AI,而是大量极窄、极具体的安全工作流第一次值得被软件化了。
One's Vibe 里同一方向的项目已经开始明显扎堆。尤其值得观察的是“AI 写代码 → AI 再来检查 AI 写出的代码”这一类工具:
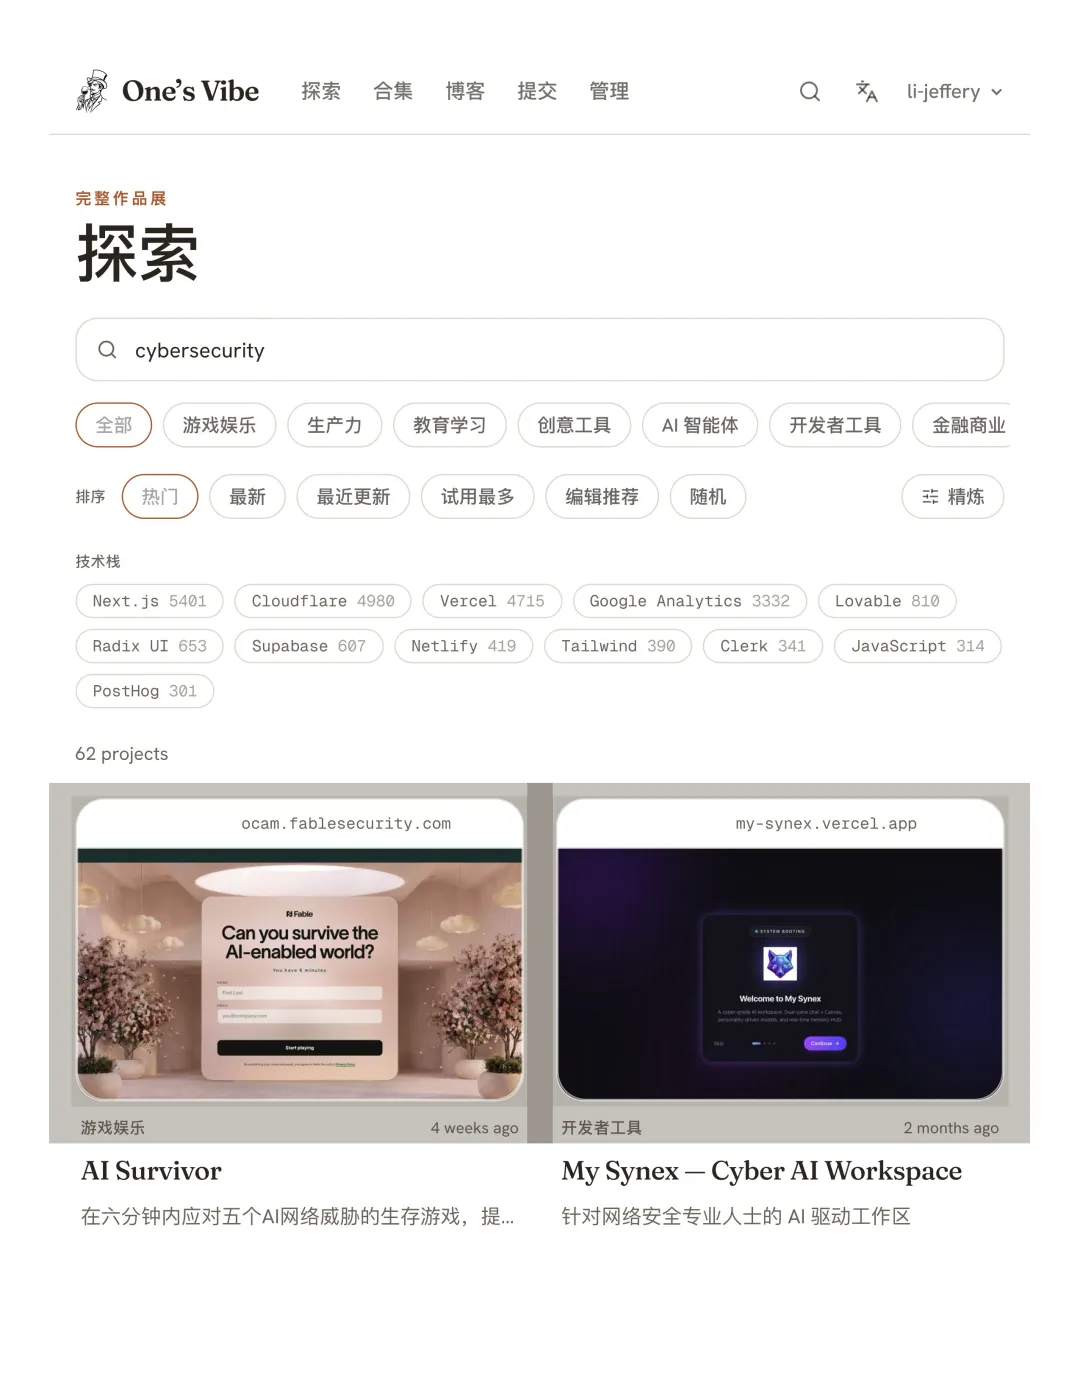
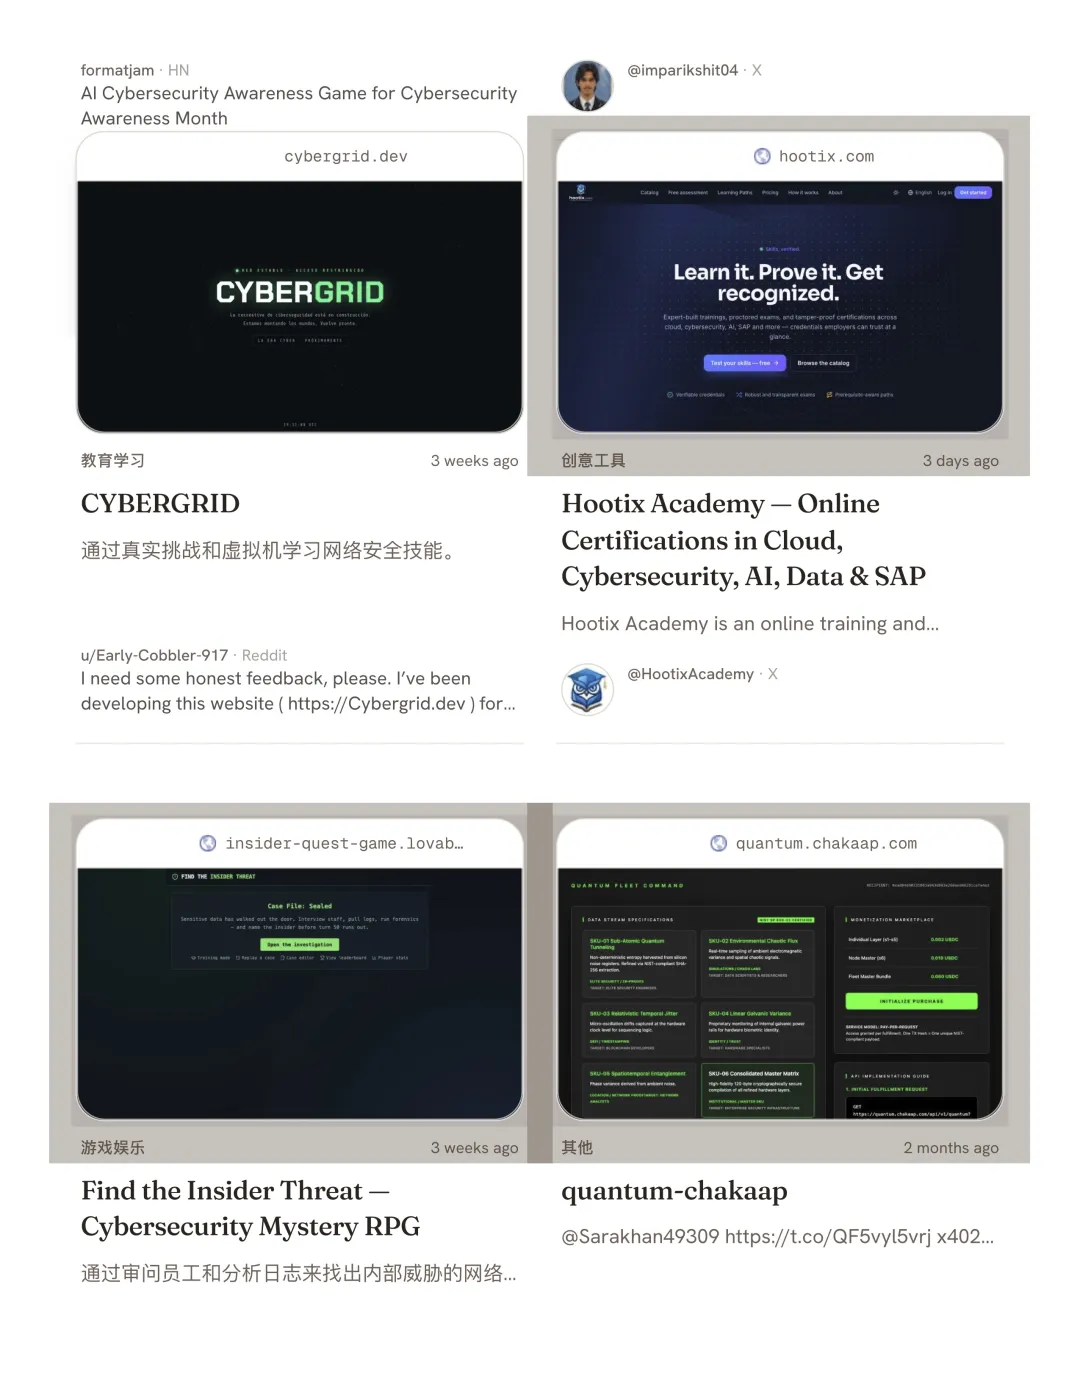
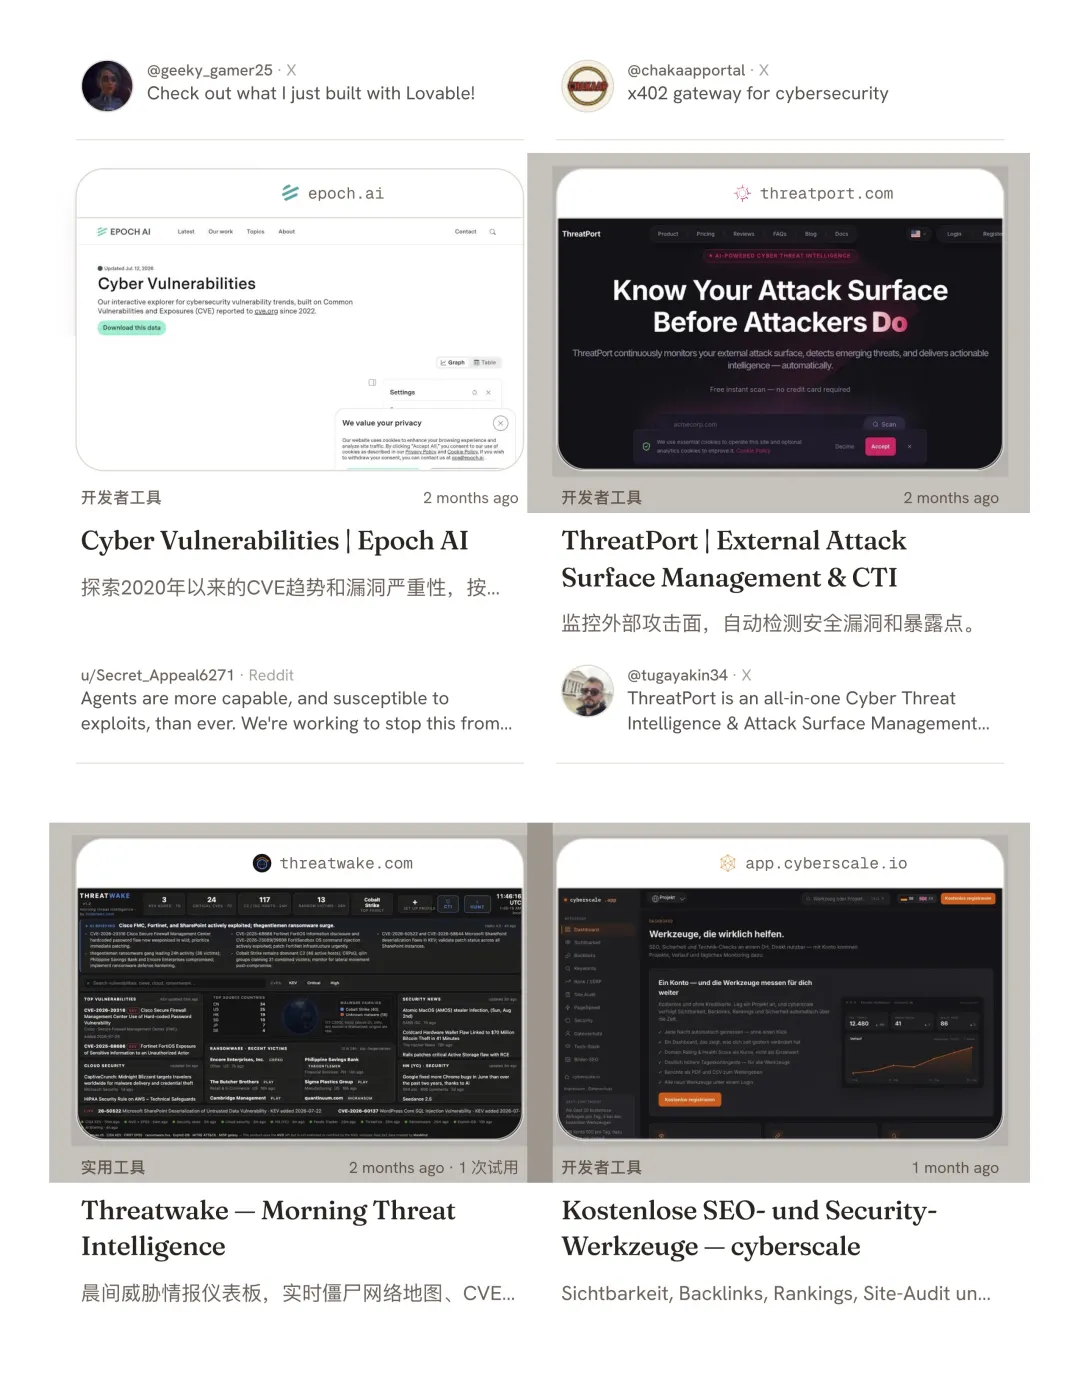
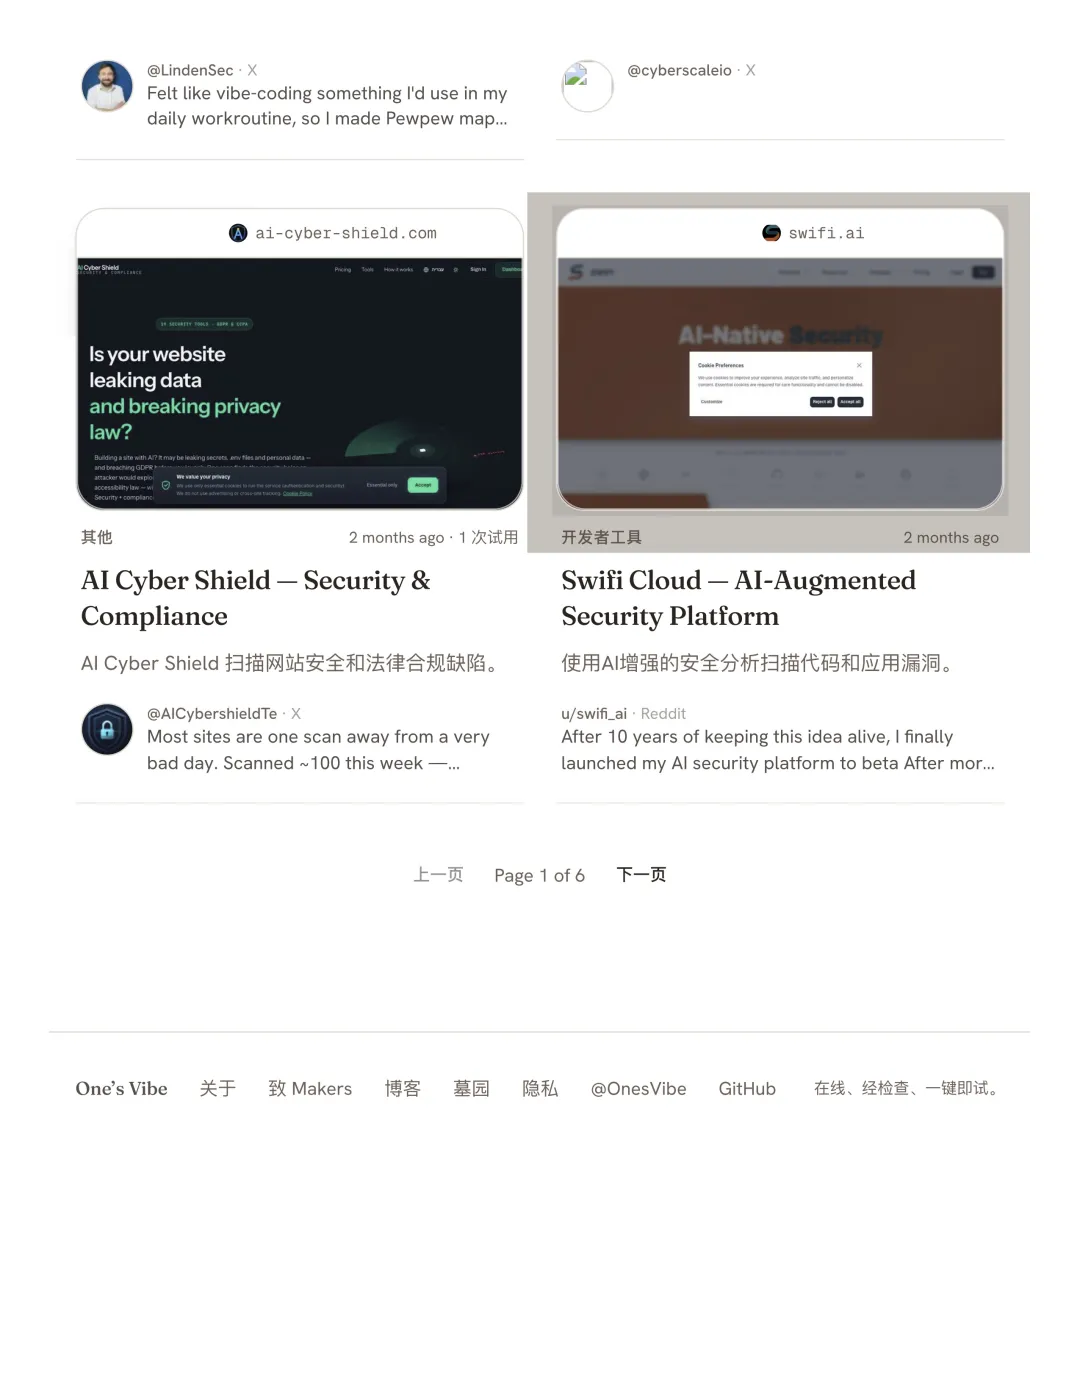
把它们放在一起看,会发现一个很明显的趋势: 安全产品正在沿着 AI 软件栈重新长一遍。 以前有 SAST,现在出现“AI-generated code scanner”;以前有 WAF,现在开始出现 Agent gateway;以前敏感操作由后台 RBAC 控制,现在又多了一层“AI 做决定之前要不要 human approval”;以前红队打 Web App,现在还要专门 red-team prompt、RAG、memory 和 tool calling。 攻击面并没有因为 AI 消失,它只是又增加了一层。
安全工具和天气查询工具有一个本质区别: 你交给它的输入,本身可能就是敏感资产。 把一个域名输进普通网站和把公司 staging endpoint、GitHub repo、API credential、内部 Agent 地址交给第三方扫描服务,不是一回事。 建议试这类产品时,会先看三件事:它是在浏览器本地运行,还是把数据传回服务器;需要什么权限,能不能用临时、最小权限的 credential;以及它到底是在做 passive inspection,还是会主动向目标发送测试请求。 尤其是 penetration testing 类工具,无论 AI 能不能自动做,都没有改变最基本的一条规则:只对你有权测试的资产进行测试,而且测试范围本身也应该明确。 One's Vibe 本身也值得顺便说明一下边界。它所谓的“Live / checked”主要验证项目 URL 是否仍然可访问,并获取页面 metadata、截图以及被动的技术栈信息。它的 URL checker 与主站分离,并针对 SSRF 做了隔离,包括阻止私网地址、重定向后重新检查 DNS、限制请求大小和时间等。换句话说,这个检查证明的是“这个网站最近还能打开”,而不是“这个软件经过了安全审计”。 隐私方面,One's Vibe 公布的政策称,普通浏览和试用事件使用轮换的匿名标识以及哈希后的浏览器特征做去重,事件数据不保存 IP 或邮箱;登录后则会保存 OAuth 提供者传来的用户名、头像和邮箱。API/MCP 搜索词会作为匿名产品信号记录,而每日公开到 GitHub 的 catalog snapshot 不包含用户数据。 这些说明不意味着读者应该“相信 One's Vibe 上的项目”。恰恰相反。安全工具最适合用安全从业者看待一切工具的方式去使用:先理解它的信任边界,再决定把什么交给它。
回头再看 One's Vibe 里的这一批项目,我觉得真正值得注意的并不是“又有 342 个网络安全工具”。而是安全领域正在出现一种新的循环:AI 写软件 → AI 制造新的攻击面 → AI 找这些漏洞 → AI 测试 AI → 人类开始给这些 AI 增加审批、审计和边界。 过去几年我们讨论最多的是 AI 能不能写代码。接下来可能更有意思的问题是:当写代码、找漏洞、利用漏洞和防御漏洞的四方都开始使用 Agent,网络安全会变成什么样?
开篇:一万多个 AI 应用里,有 342 个在做安全
一、ARTEX:把“渗透测试”变成一个 Agent 工作流
ARTEX 官网 https://artex-demo.vercel.app/
扫端口 → 指纹识别 → 跑模板 → 出报告。
https://en.sedaily.ai/technology/2026/10/02/traces-of-chinese-ai-hacking-tool-found-on-server-tied-to
二、Targe:这一次,被红队的是 AI 自己
https://onesvibe.app/zh/projects/usetarge
三、Threatwake:每天早上,把十个威胁情报标签页压成一屏
还有一些值得点开的项目