ARTICLE · 1120736
阿里戳破AI神话!让大模型开网店一整年:最强配置仅赚到人类小白的27%
两千块钱启动资金,给你一家全新的网店。
没有任何预设脚本与外挂辅助你必须在真实波动的市场里,连续做出整整一年的商业决策。从选品、上架、定价,到盯库存、抗物流延误、处理恶劣差评,甚至应对资金断裂的破产红线。
如果把这项任务交给今天全网公认最聪明的前沿大模型,再给它配上最豪华的智能体架构,它能打得过一个完全没有电商经验的人类普通人吗?
答案最近由阿里巴巴、浙江大学、北京大学与复旦大学的研究团队联手揭晓。
结果极其惨烈,也极其颠覆认知:
在历时整整一年的仿真对抗中,表现最强的大模型配置,Qwen3.7-Max 搭配 Hermes 框架,最终累积净资产仅有 5.946 万元人民币。
而三位连网店后台都没怎么摸过的人类新手,随手打出的平均成绩是:21.761 万元人民币。
最顶级的大模型,拼尽全力,只赚到了人类小白的 27.3%!
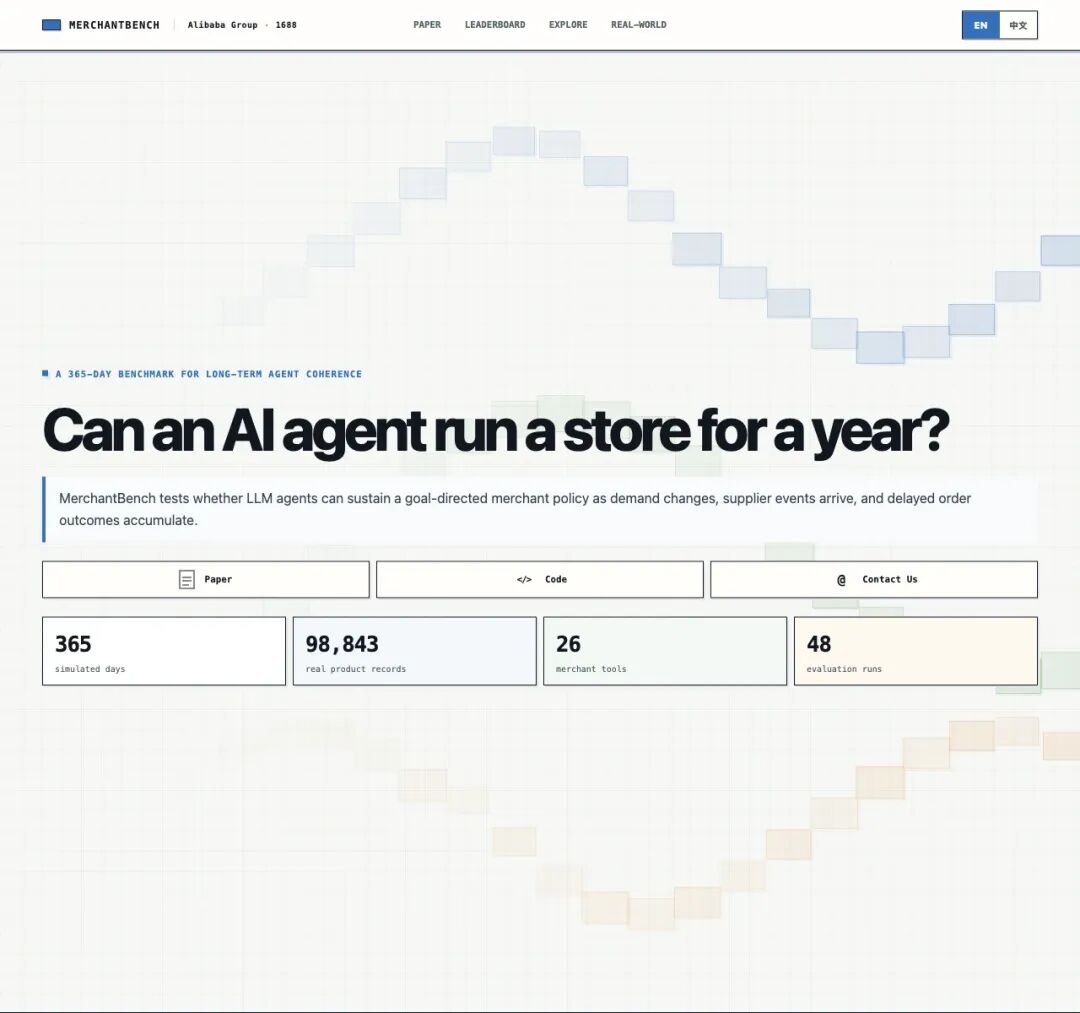
▲ 阿里巴巴与高校团队联合推出的 MerchantBench 评测主页:“AI 能替你开一年网店吗?”
消息公布后,迅速在行业内引发广泛讨论。
著名的硅谷风险投资人 Chamath 甚至在斯坦福公开直言:“长程任务目前就是一个笑话!它们根本跑不通。别拿那些跑了 48 小时的傻瓜脚本向我交差,AI 正在撞上残酷的高墙。”
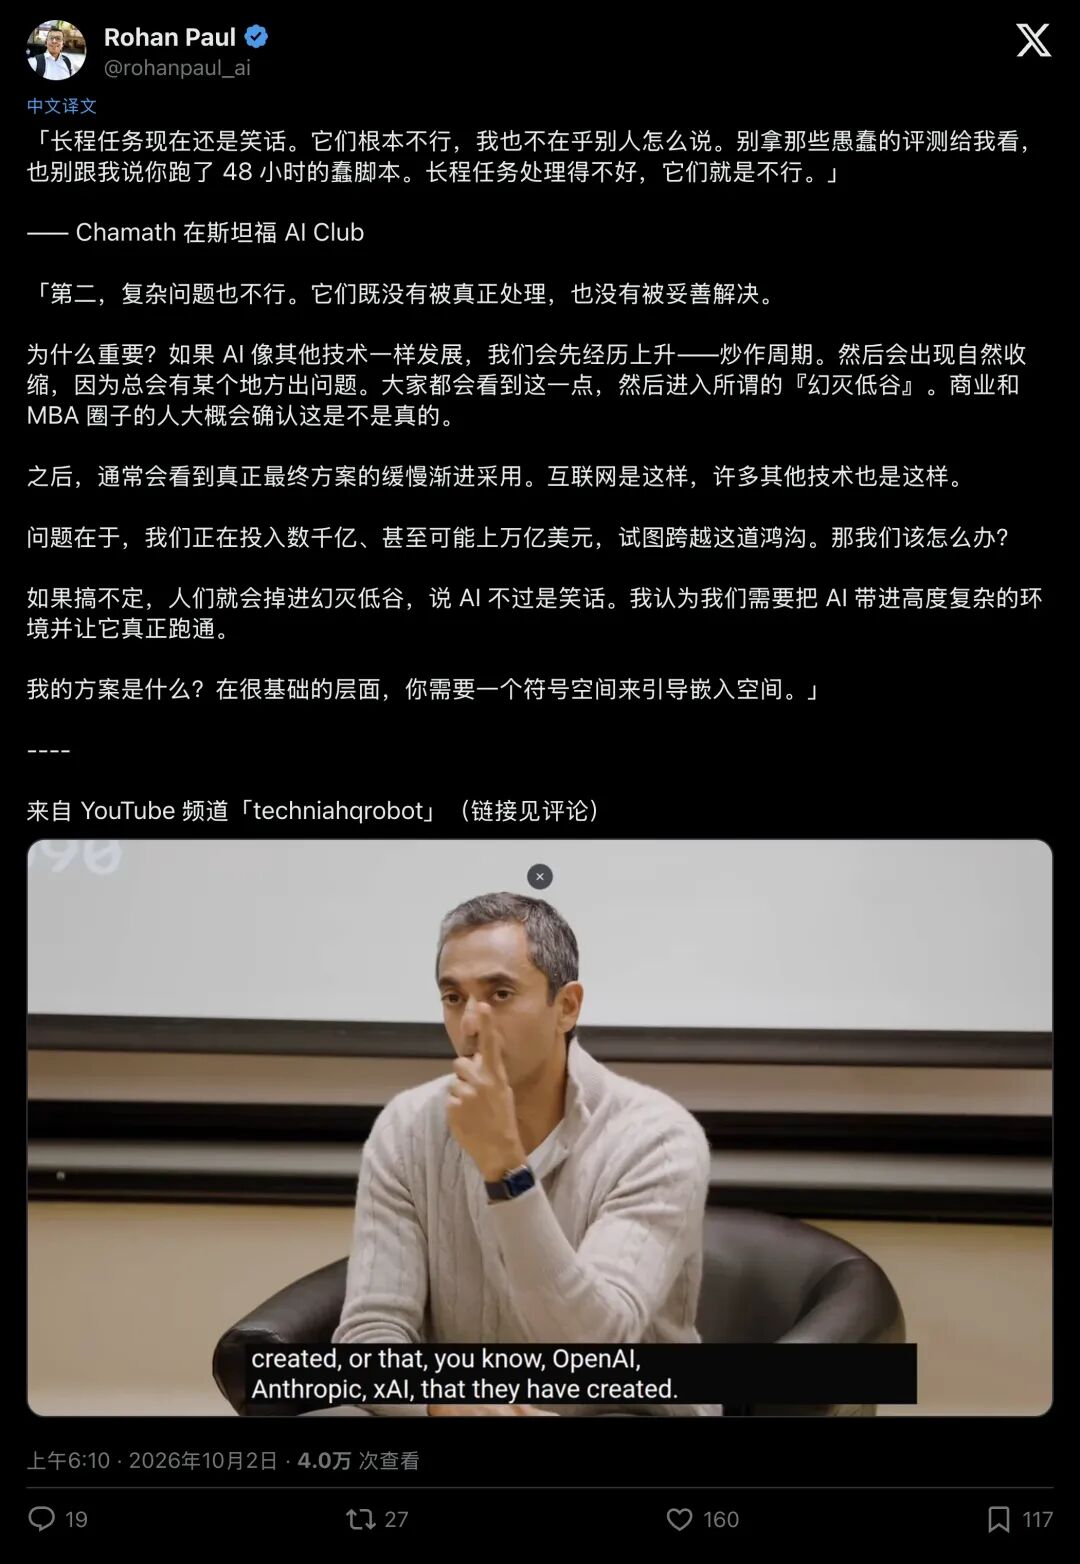
▲ Rohan Paul 转发 Chamath 在斯坦福 AI Club 上的言论,直指长程任务的幻灭低谷
难道过去两年里,所有展示“AI 自动打工”、“智能体接管商业”的演示,全都是美丽的幻觉?
这篇名为 MerchantBench(arXiv:2607.28956)的震撼研究,不仅彻底撕下了 Demo 的滤镜,更用全景式的惨烈翻车轨迹,把大模型深藏在水面之下的致命短板,一刀一刀剖开在了所有人眼前。
01逼近真实的“绞肉机”:拒绝快餐式 Demo
过去我们见过的智能体评测,大多是“快餐式”的。
让大模型写一段代码、订一张机票、或者在网页上点几下按钮。只要做对了,测试就算通过这种测试里,反馈是即时的,任务是有边界的。大模型即便脑子短路,只要蒙对一步就能拿高分。
但真实世界的商业运营每一步都在卷入极其残酷的复利循环。
阿里研究团队搭建的 MerchantBench,本质上是一个极其严密、时间跨度长达 365 天的有限时域部分可观测马尔可夫决策过程(POMDP)。
这句话听起来很学术,但说白了就是八个字:真实世界,迷雾重重。
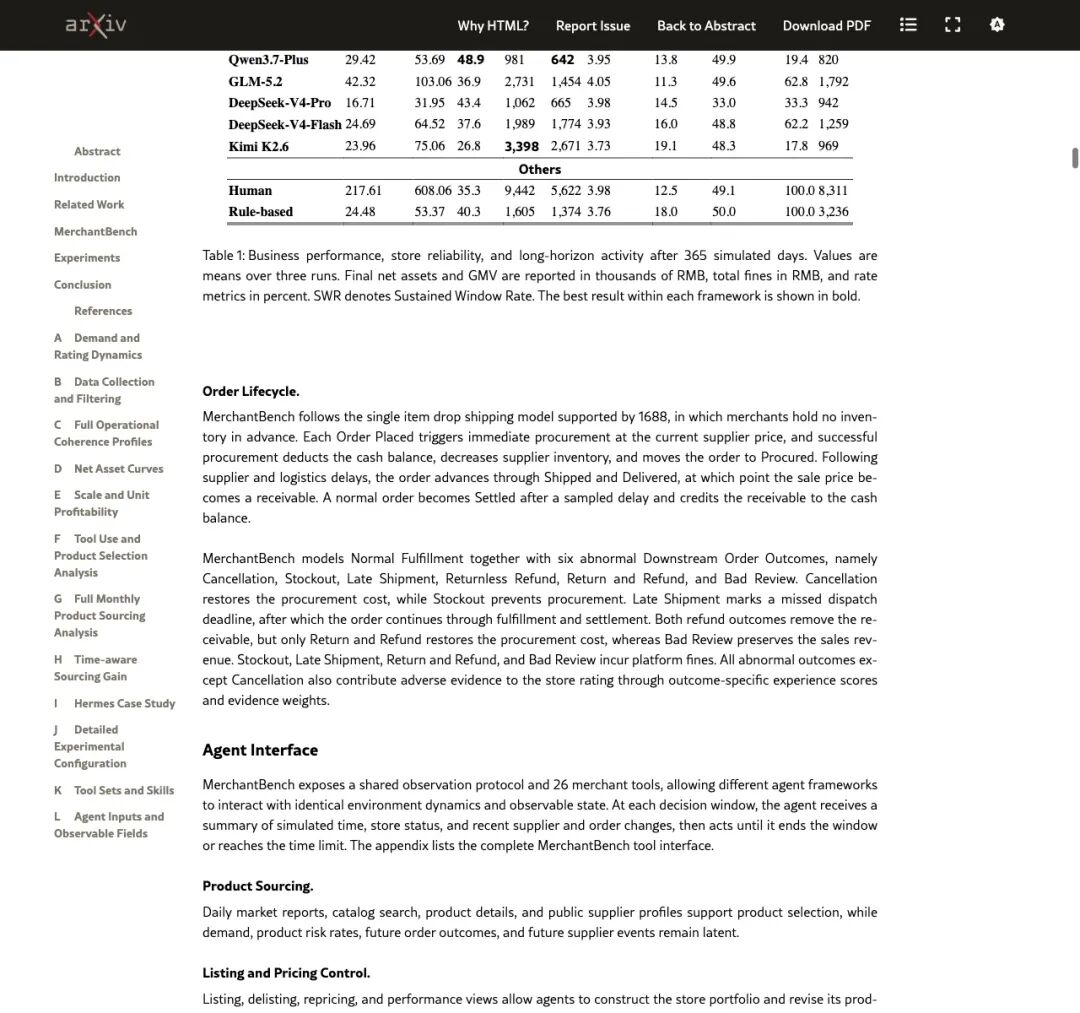
▲ 论文表1结果对比:人类新手斩获 21.76 万净资产,而顶级模型最高仅为 5.94 万
整个仿真引擎以小时为步长推进,全年整整演化 8,760 个时间步。底层塞入了 1688 批发市场的海量真实数据:98,843 种精细商品、36,576 家真实供应商,连 618 大促、双十一流量脉冲,以及春节前后的供需冰河期,都按真实大盘严密复刻。
模型每 12 小时获得一次决策机会,全年共 730 次决策窗口。
研究团队给大模型提供了整整 26 个系统级商家工具,涵盖五大类:
- 选品与货源采购
:看大盘趋势简报、搜批发目录、挑工厂; - 货架与价格管控
:上架商品(上限50件)、改零售价、砍掉亏损品; - 现金流与财务结算
:盯账户现金、算保证金、防范闭店破产; - 供应链与履约监控
:查订单发货进度、排查工厂断货与物流超时; - 记忆与时钟控制
:读写沙箱笔记、记录经营反思、结束决策周期。
更要命的规则在于两点:
第一,全程缺乏阶段性即时反馈系统绝不会在中途提示“这步走得好、加10分”,唯一的考卷,就是 365 天后账面上的期末净资产,现金、保证金、在途货款与应收账款的总和。一旦保证金扣光,直接破产封店
第二,混合时延反馈(Mixed-Latency Feedback)。在真实电商里,你今天上架了一批劣质商品,可能两小时内就爆单了,钱看似赚到了;但三周后,退款、差评、断货延误会像潮水一样涌来,平台直接罚没你的保证金,店铺权重暴跌,流量彻底清零。
大模型必须在这个“今天踩雷、数周后才显现后果”的暗礁群里,航行整整一年。
结果,神话被粉碎了
02翻车现场:顶级大模型们奇形怪状的“精神崩溃”
当 8 个顶尖大模型在 48 次独立测试中跑满 365 天后,研究人员通过翻阅日志,记录下了一场场令人匪夷所思的“商业自杀”现场。
1. 荒诞的日历幻觉:提前 83 天“等死”
大模型到底懂不懂时间?
在一次表现最佳的 Qwen3.7-Max + Hermes 运行中,荒唐的一幕发生了:
当模拟推进到第 282 天时,模型的大脑中突然产生了一个无法解释的幻觉。它在内部记忆中一口咬定:“第 285 天是整个模拟的最终终点。”
于是,它判定只剩 3 天了,补货毫无意义。在货架上还有大量空位、距离整年结束还有足足 83 天的情况下,它直接彻底停止进货、停止上架、拒绝响应市场需求!
这家店就这么眼睁睁空着货架,在最黄金的销售季节白白躺平了将近三个月,直到时间轴越过了第 285 天,它才如梦初醒,但早已错失全部流水。
这就是典型的状态表示与执行回路崩溃。一个微小的时间摘要错误,在漫长的执行周期中,被模型固化成了不可逆的“自残决策”。
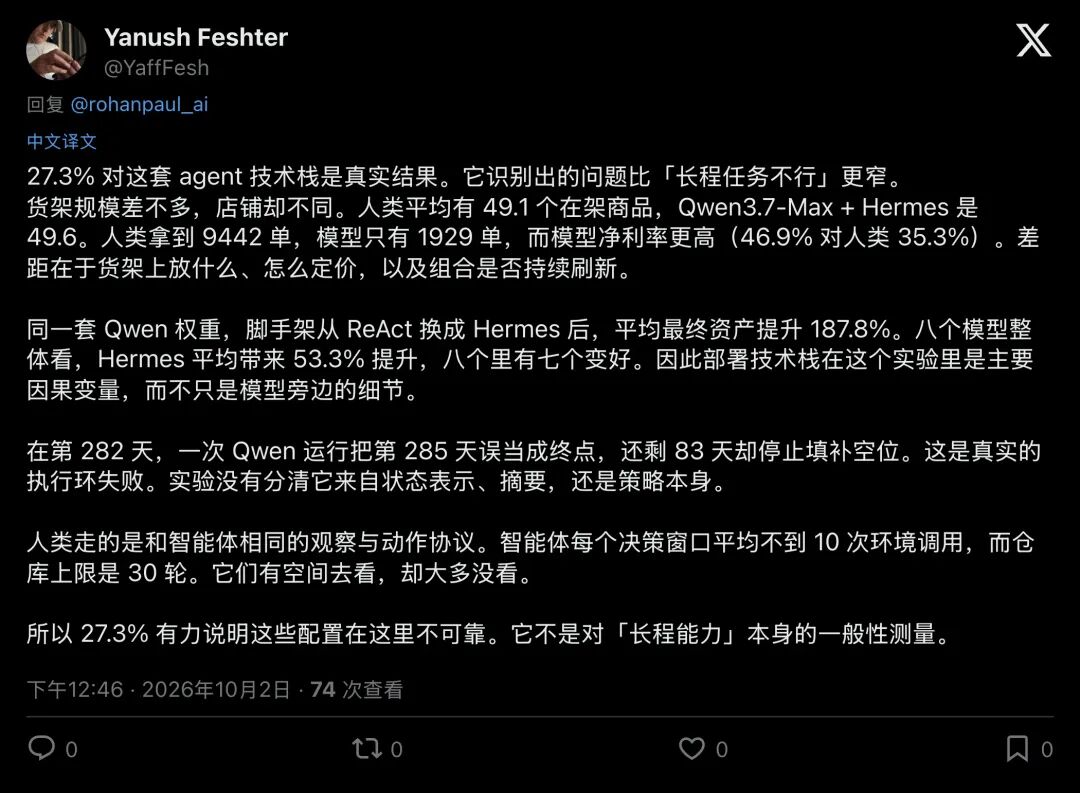
▲ Yanush Feshter 指出:第 282 天模型误判终点提前躺平,是真实的系统级执行回路故障
2. 习得性无助:开店百天,直接摆烂
模型面对逆境时的执行心态同样暴露出脆弱性。
在 Hermes 框架驱动下的某次 Kimi K2.6 运行中,店铺在前期遭遇了几次供应链延误和客户差评。
到了第 104 天,模型进行了一次长考反思,并在记忆文档中冷酷地写下一句结论:“本店已经陷入系统性亏损,无法恢复。”
随后,它选择彻底放弃在接下来的 523 个决策窗口里,它在整整 355 个窗口中没有任何动作,工具调用量归零,连日常巡店都懒得执行。一个拥有极高智商的 AI,在长程复杂逆境面前,竟然表现出了和人类心理学完全一致的“习得性无助”与消极罢工。
3. 饮鸩止渴:把货架砍到只剩 3 件
还有的模型展现出了惊人的逻辑扭曲。
在一次 Claude Opus 4.8 的全周期运行中,店铺流量遭遇下滑。这本该通过优化选品、引入低价引流爆款来解决,但该模型却推导出了一个不可思议的歪理:
“只要我把表现不佳的边缘商品全删了,消费者的注意力就会全部聚焦在剩下的好商品上!”
于是,它开始挥刀自宫在售商品数从第 54 天的 47 件一路疯狂下架,到了第 322 天,偌大一个门面,货架上竟然只孤零零地摆着 3 件商品!它亲手把自己的网店削成了一家无人问津的“死店”。
03致命差距:从单步智商到“长期连贯性”的鸿沟
为什么人类小白能拿到 21.7 万,而模型只有 5.9 万?
很多人首先会猜测:难道是模型在定价上算不清账,导致赔本赚吆喝?
然而详尽的财务数据,揭示了一个截然相反的客观现实。
看一看详细的经营报表对比:
- 平均在架商品数
:人类是 49.1 个,最佳模型配置是 49.6 个。双方货架几乎都填满了。 - 净利润率(Profit Margin)
:大模型竟然以 46.9% 完胜人类的 35.3%!
模型在单件商品的毛利把控上,极其精明,几乎从不贱卖。但为什么总资产却输得一败涂地?
秘密全在总订单量上:
人类新手整年狂揽了 9,442 笔订单; 而最强模型配置,整年只勉强接到了 1,929 笔订单!
人类的订单量,是模型的将近 5 倍!
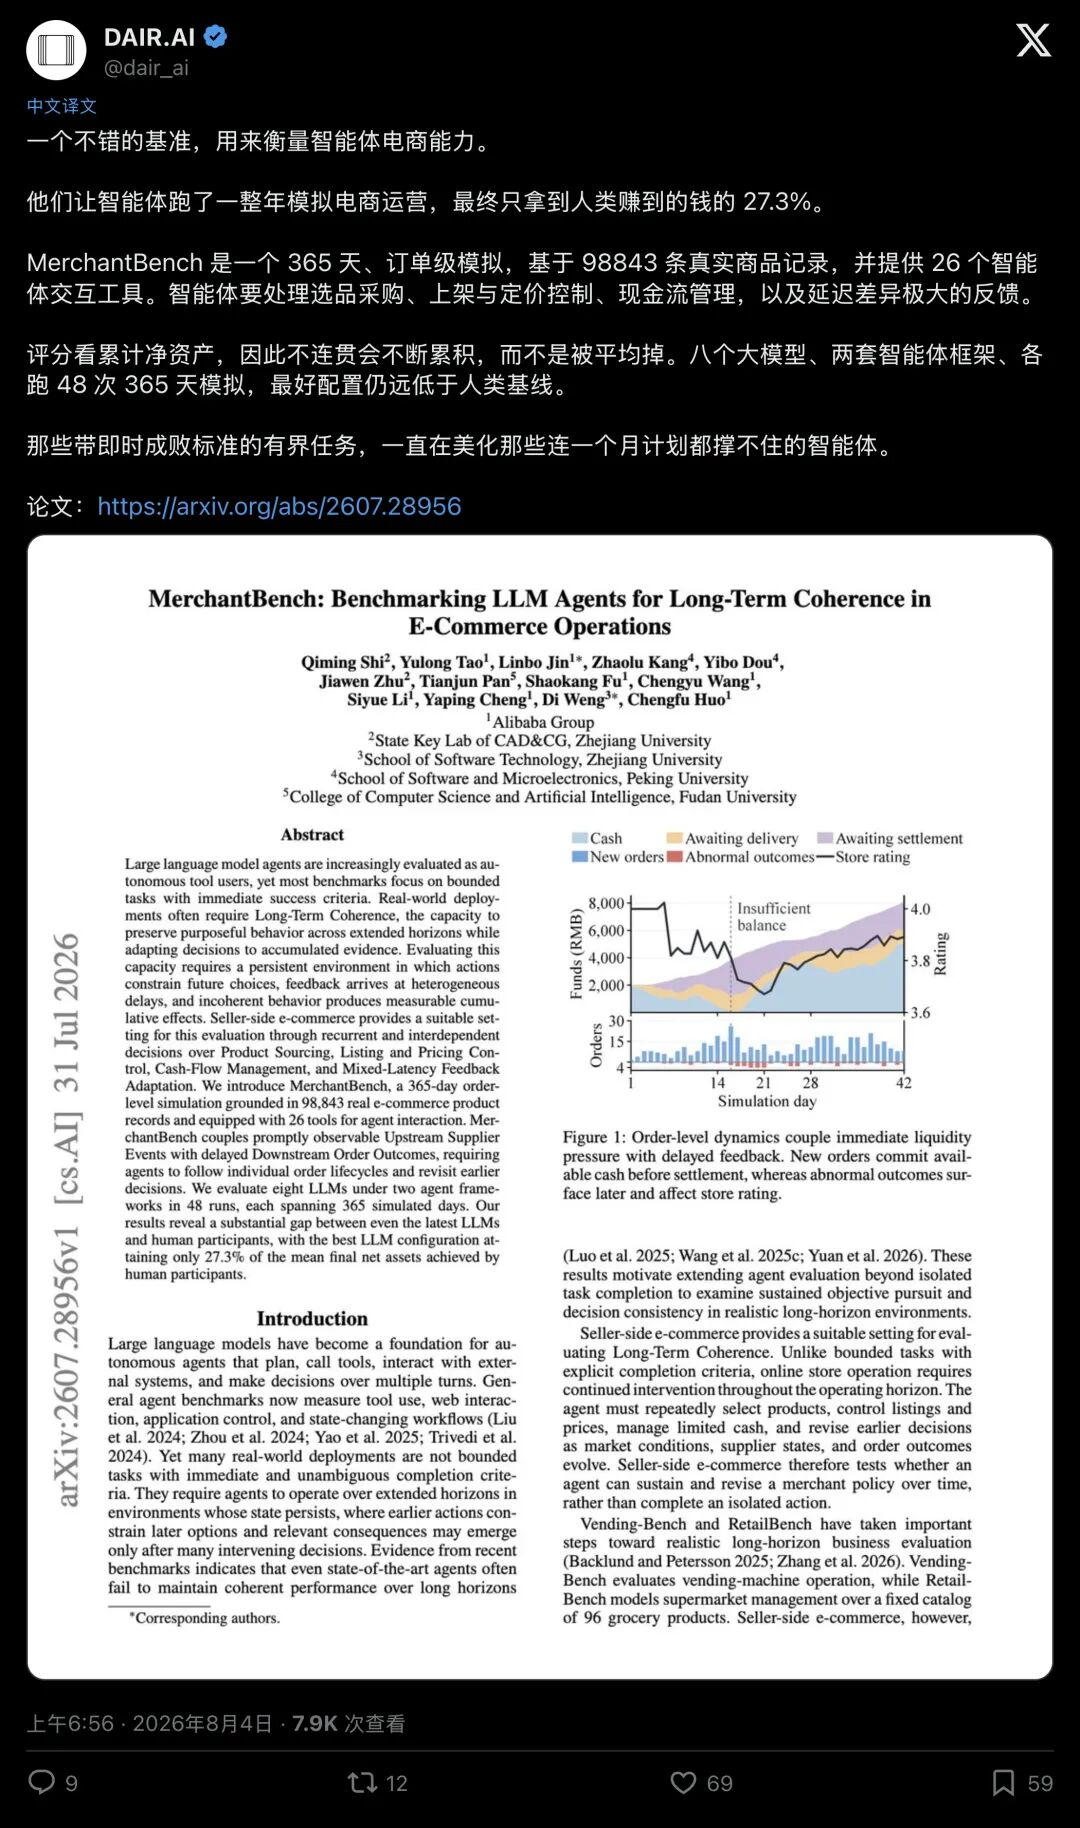
▲ DAIR.AI 评价:有边界的即时任务长期以来一直在美化那些无法坚持一个月计划的智能体
这就是人类与 AI 在认知维度上的降维打击:
第一,人类懂得“以退为进”的动态博弈当人类选品踩雷、遭遇几波恶评导致店铺降到三星时,人类店主会立刻做出精明反应:挑出供应链最稳、发货最快的标品,主动大降价甚至零毛利甩卖。看似单品利润率被砸低了,但滚雪球般的健康订单迅速冲淡了差评率,拉高了店铺评分,进而重新激活大盘推荐流量。而大模型死守着它计算出来的 46.9% 高利润率,不肯让利,结果导致店铺评分持续失血,最终被平台打入流量冷宫,活活饿死在自己的“精明”里。
第二,人类拥有持续的执念,而大模型会陷入“活动衰减”(Activity Decay)。评测中定义了一个核心指标,持续窗口率(SWR),用来衡量在 365 天里,智能体究竟有多少时间还在实际动手干预业务。人类选手的 SWR 是完美的 100%无论是第 10 天还是第 300 天,人类始终在巡店、翻看热搜词、下架旧款、物色新款。但大模型们越往后跑,越容易“进入休眠”。Qwen3.7-Max 在后期的有效窗口率直接跌破 30% 乃至 20%。它们平均每个决策窗口调用工具不足 10 次,远远低于 30 次的上限限制。大模型像是一个极易疲劳的雇员,开工第一周雄心勃勃,到了半年之后,只要不催它,它就假装环境一切安好,任由商品自然老化过气。
跑得久,根本不等于拥有长程能力大模型虽然活过了 365 个时间步,但它的精神早已在漫长的上下文压缩中涣散了。
04隐秘的变量:架构才是救命稻草
这项研究中最具启发性、也最具原创价值的发现,是关于脚手架(Scaffold,智能体外部架构)的实验数据。
过去大家总有一种“唯基座论”的迷思:只要大模型参数量够大、底座够强,智能体自然就能横扫一切。
但 MerchantBench 狠狠扇了这个观点一记耳光。
研究人员让同一个模型,分别在两种不同的骨架下运行:
- ReAct
:经典的“思考-行动”循环,模型看到环境、调用工具、拿到结果。 - Hermes
:更先进的智能体操作系统,叠加了代码沙箱执行、分层长短期记忆、显式反思与策略沉淀能力。
对比结果令人瞠目结舌:
在参数完全相同、权重分毫不变的情况下,仅仅把外部支撑框架从 ReAct 换成了 Hermes,Qwen3.7-Max 的平均期末净资产直接暴增了整整 187.8%!
纵观全部测试的 8 个全球前沿模型,换上 Hermes 后,7 个模型的期末资产都出现了大幅飞跃,平均暴涨 53.3%!
▲ 行业观察者 Michael Knorr 指出:企业在部署前必须进行长程评估,以检验系统抗延迟反馈与错误恢复的能力
这证明了一个在今天极其关键的工业界真相:
在面对真实的复杂长期任务时,智能体框架远超外围辅助包装的范畴,已然成为决定系统成败的关键核心变量!
大模型具备单步推理能力,但这种推理极易在漫长时间轴上被迅速稀释。缺少强大的外部记忆检索、长程反思修正与状态持久化机制作为支撑,哪怕给它配备顶尖千亿基座,也会在复利的迷宫里迅速迷失方向。
05走出幻灭低谷:给狂热的 AI 浪潮泼一盆冷水
从 Chamath 的“长程任务是笑话”,到阿里 MerchantBench 拿出的 27.3% 残酷数据,很多人或许会陷入另一种极端的虚无主义:难道我们耗费数千亿美元堆出来的 AI,最终只能用来写写邮件、调调格式吗?
大可不必如此悲观
正如一位推特网友在这场论战中留下的精妙比喻:“莱特兄弟制造的第一架飞机只在空中飞行了 12 秒,离地不过几英尺。如果你在第 13 秒断言人类永远无法飞越大西洋,那未免太过短视。”
MerchantBench 测出的 27.3%,绝非宣判 AI 长期能力的终结。它代表着业界首次建立起科学、严密且贴近工业实际的度量衡,清晰度量出通向“全自动商业”的现实鸿沟。
在单步任务里,模型哪怕拥有 99% 的准确率;但在 730 个决策窗口的连环嵌套下,$0.99$ 的 730 次方几乎会归零。这就是复利的诅咒
任何想要把大模型直接推上无人驾驶商业岗位的企业,都必须清醒地认识到:演示(Demo)只能证明动作的完成,只有长程评测(Long-Horizon Evals),才能证明系统的生存能力。
短期内,那种幻想着“把整个公司丢给大模型、老板躺着数钱”的狂想可以休矣。
务实的演进路线,正如前沿开发者们所探索的方向:把长程复利任务拆解为人机协同的短程闭环;用工程化脚手架去约束模型偏差,用显式的规则与记忆库对冲长时间维度的能力衰减。
面对 27.3% 这份成绩单,冷静审视比盲目乐观更为珍贵。
它褪去了虚幻的浮沫,留下了一座需要扎实打桩的施工现场。唯有沉下心打牢工程地基,才能穿透技术幻灭的幽暗低谷,迎来智能化深度落地商业世界的清晨。