ARTICLE · 1120744
清华满分论文震动全球AI圈:撕碎o1神话,强化学习根本没教出新智商!
过去两年,大模型的世界彻底陷入了一场集体狂欢。
从OpenAI的o1,到横空出世的DeepSeek-R1,再到Kimi-1.5,所有人都被一种近乎神迹的现象震撼了:给大模型加上可验证奖励的强化学习(RLVR),只要用答对给1分、答错给0分的简单信号去逼它,模型就会自己嘟囔着长考,甚至爆发出类似人类顿悟的“啊哈时刻”!
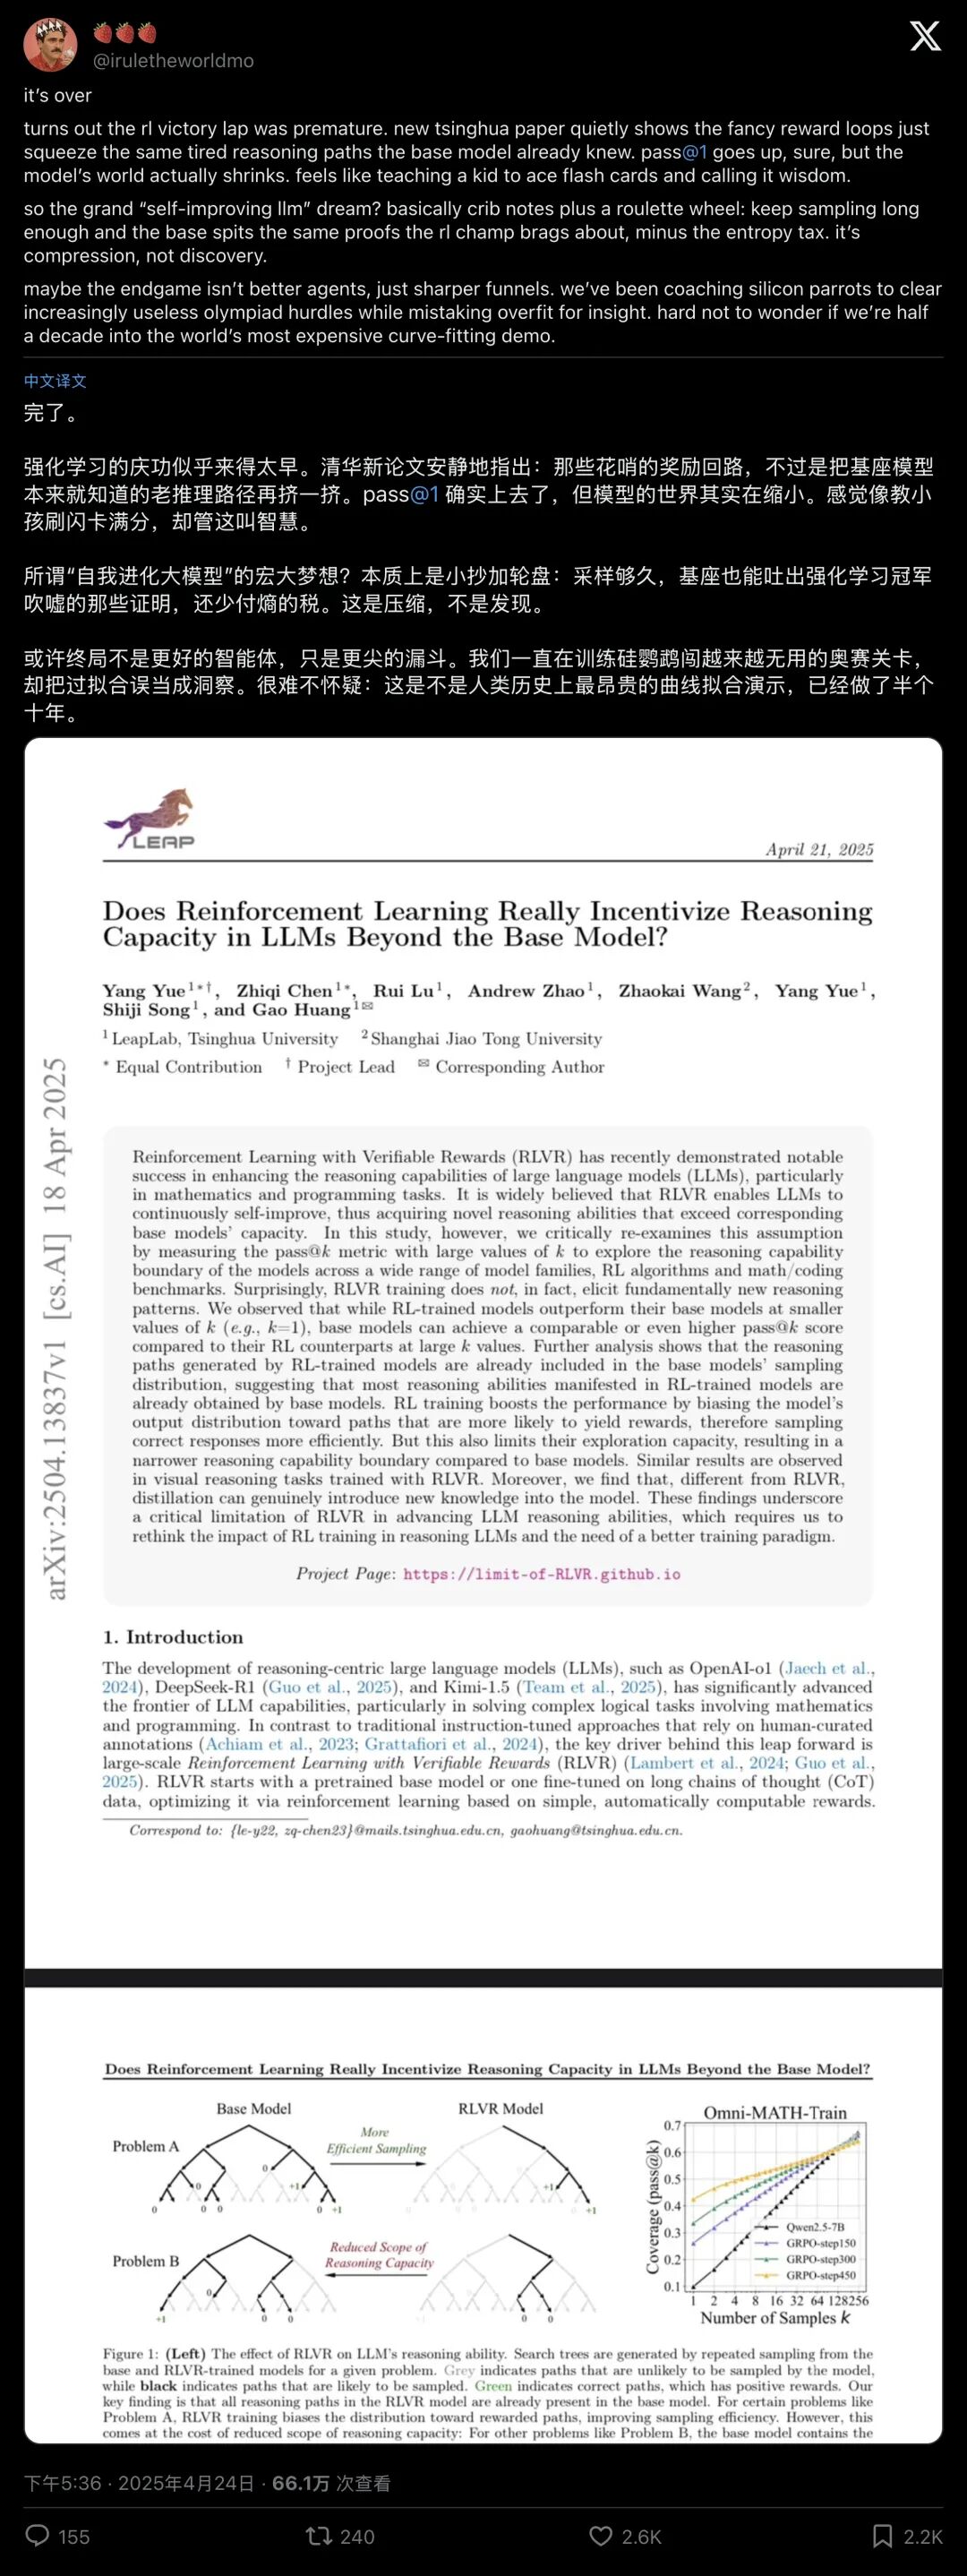
▲ 论文曝光后,海外技术圈爆发的剧烈震动:“强化学习的庆功宴开得太早了”
无数信徒激动地宣布:AlphaGo在围棋里突破人类思维的奇迹,终于在大语言模型上重演了!AI正在通过左右互搏,自主进化出人类从未教过的高维推理能力。
然而,就在所有人为AGI的倒计时欢呼时,清华大学的一支团队却悄无声息地递上了一把冰冷的手术刀。
这篇由清华大学自动化系LeapLab与上海交通大学联合发表的重磅论文,直接拿下了顶级AI盛会NeurIPS 2025的唯一满分评价,并最终斩获最佳论文亚军(Best Paper Runner-up),这是NeurIPS设立该奖项以来,首篇完全由中国本土学者独立完成的获奖成果。
他们做了一个极其严谨但残忍的对照实验,把整个AI圈的狂热遮羞布一把扯了下来:
大模型并没有学会任何新逻辑这场备受瞩目的自我进化,实则是一场昂贵而精巧的“存量压缩”。
01.幻觉破灭:单发命中90分,成百上千次却被基座“暴打”
为了把问题看透,清华团队设计了一场堪称“显微镜级”的残酷对决。
在评估AI解题时,业内通常看一个指标叫 pass@1:给模型同一道题,只让它做一次,答对就算过。这就像考试里的“第一反应”
但清华团队把采样次数放大了几百倍甚至上千倍,去测量 pass@k(比如pass@256、pass@1024):如果允许模型反复做1024次,只要其中有一次能蒙对,就算这道题在它的“能力覆盖边界”内。
这就构成了全篇最震撼的一组前后对照:
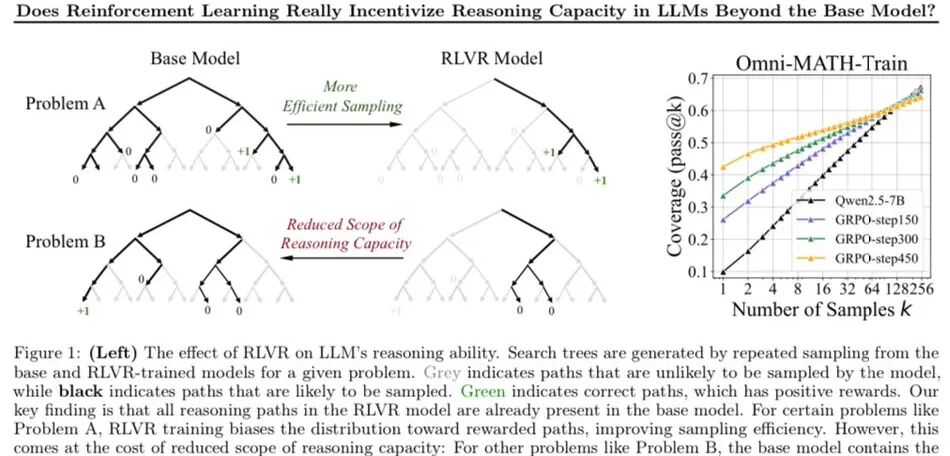
▲ 论文Figure 1:左侧显示RL训练后解题树被修剪、有效解题空间收窄;右侧显示大采样量下基座模型pass@k反超RL模型
在数学基准AIME和MATH上,经过强化学习训练的模型,在小采样量($k=1$)时的表现简直惊艳,单发命中率碾压原始的基座模型。各大厂商正是拿着这个数据,向全世界宣传“AI逻辑能力暴增”。
然而,诡异的事情在采样次数增加时发生了。
随着采样次数 $k$ 不断拉大,基座模型的准确率曲线开始疯狂攀升,以肉眼可见的速度逼近、追平,最终在成百上千次采样时,全面反超了经过强化学习训练的“学霸模型”!
很多时候,交叉反超点甚至在个位数的 $k$ 就早早出现了。
为何会出现这种反常现象?
打个通俗的比方:未经强化学习的基座模型,就像一个天马行空、思路杂乱但底子极厚的偏才。虽然他第一枪经常打偏,但如果给他1000颗子弹,他的子弹能覆盖整片靶场,总有一发能正中那个刁钻的靶心。
而强化学习训练后的模型,被教成了一个只背标准答案的做题机器。他打第一枪极准,但如果你让他开1000枪,你会绝望地发现,他打出来的所有弹孔都挤在同一个狭窄的小坑里。
那些稍微偏门、但原本基座模型完全能做出来的解法,被他自己亲手废掉了。
02.显微镜下的残酷真相:你解出来的,只是基座的“严格子集”
为了探究深层机制,清华团队把模型的内部工作机理层层剖开,给出了三项极具说服力的实证证据:
1. 严格子集定理:AI没有探索新大陆
研究团队将题目分成了四大类:两者都能解的、两者都不能解的、仅基座能解的、以及“仅RL能解”的。
统计结果显示:在MATH500题库里,经过RL训练后表面上才能解出的题目,占比不到1%,一共只有约5道题。
而当团队把基座模型的采样次数放宽到1024次时,奇迹消失了,基座模型对这5道题实现了100%命中。
这证明了一个冷酷的数学事实:当前强化学习模型能解决的全部问题,在统计学上几乎完全是基座模型潜在解题集合的“严格子集”(Strict Subset)!
它从来没有走出过基座模型画好的圆圈。
2. 困惑度追踪:它在背基座早就写好的草稿
大模型输出中那些“自我纠错”、“等一下我再想想”的惊艳反思,难道全凭强化学习自主领悟?
团队拿出了衡量语言模型序列概率的核心工具,困惑度(Perplexity)。如果强化学习真的发现了全新的逻辑链条,基座模型在阅读这条思维链时,困惑度应该极高,感到陌生和突兀。
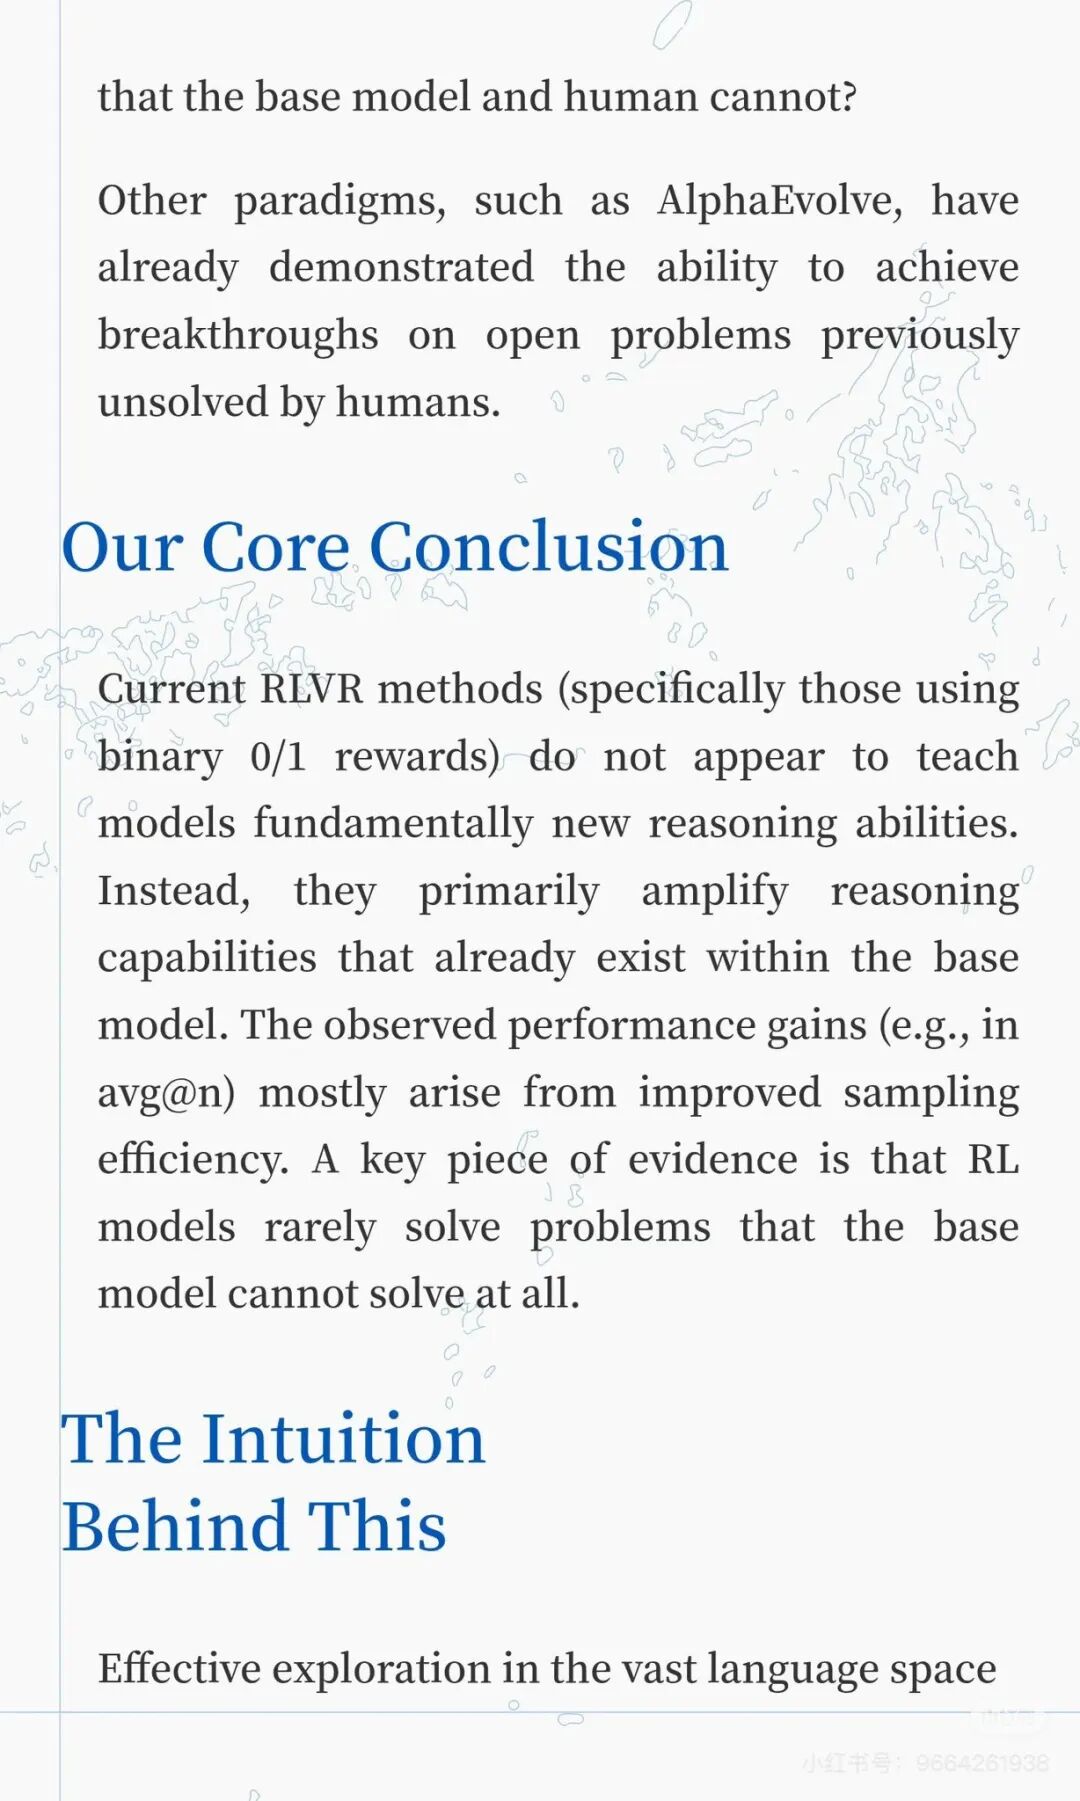
▲ 清华团队第一作者乐洋公开解读:强化学习生成的解题轨迹,在基座模型看来完全属于“轻车熟路”
然而,测量结果让人大跌眼镜:RL模型引以为傲的思维链,基座模型读起来不仅毫不陌生,反而处于困惑度最低的超高概率区间。随着强化学习一轮轮推进,基座模型对这些轨迹的困惑度还在单调下降!
真相大白了:所谓的反思与顿悟,种子早就埋在海量预训练数据的基座里。强化学习没有创造出哪怕一丝新的认知原语,它只是像猎犬一样,把基座里原本就存在的高频解法给叼了出来。
3. 解题空间锐化:零分题目不减反增
如果把每道题的做对概率画一张直方图,对比更是触目惊心:
强化学习把大部分题目的命中率强行推到了0.8至1.0的高频区;但代价是,准确率为0(彻底丧失解题可能)的题目数量,在强化学习之后居然激增了!
为了奖励那些显而易见的正确路径,算法把那些低概率但蕴含潜力的微弱通路切断。这种机制牺牲了探索深度,宛如一场为了应试而进行的大脑额叶切除手术。
甚至,团队尝试调高生成温度,强行让RL模型的输出熵恢复到跟基座一样的水平。结果呢?曲线依然全面落后于基座这表明,这种思维多样性的塌缩,已经被焊死在了权重突触里,调参数根本救不回来。
03.终极激辩:稳定答对95%的专家,算不算更聪明?
论文的结论如同一记重锤,砸碎了无数AI信徒的狂热幻想。
在社交媒体上,悲观情绪瞬间蔓延有人尖锐地写道:“我们狂欢了半天,原来只是在给硅基鹦鹉做应试集训,把一道道奥数题当成了智慧的证明,这简直是全球最昂贵的一次曲线拟合演示!”
但也有技术大牛提出了极具深度的反思与交锋:
“如果一个专家做预测,95%的时候都是对的;而一个普通人胡言乱语,五花八门的答案碰巧蒙全了100%的可能性,我们能说后者比前者更聪明吗?”
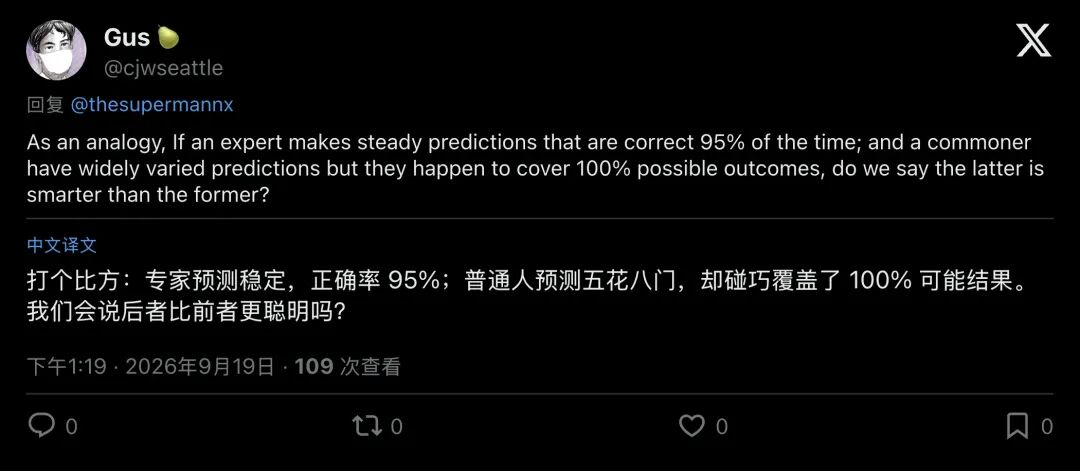
▲ 技术学者在讨论中提出反思:用牺牲边缘可能性换取高可靠性,究竟算不算更聪明?
这个反问直击产品与商业的命门
对于现实应用来说,谁能在实际业务里给你采1024次样?谁能忍受大模型胡说八道几百次只为了那一次灵光乍现?从工程落地看,用牺牲边缘可能性为代价,换取单次回答的高可靠性,这正是工业界最迫切需要的能力。
然而,这也恰恰是这项研究最具价值的警示:我们要分清什么是“工程上的高效采样”,什么是“科学上的智力跃迁”。
你可以赞美强化学习是一个极其出色的“漏斗”,把预训练海洋里的智慧精华以最高效率提纯出来;但你不能指鹿为马,把一个更锋利的漏斗,吹嘘成了能自主喷涌智慧泉水的源头。
更有趣的一组对照来自模型蒸馏
清华团队在对比实验中发现,当用更强大的大模型思维链去蒸馏一个小模型时,小模型在小 $k$ 和大 $k$ 上的表现是同步抬升的!
这带来了一个颇具黑色幽默的结论:当前的自我强化学习只能把老底掏空;而向更优秀的教师模型学习(蒸馏),才能切实注入全新的认知模式。
04.拨开迷雾:大模型离自主进化究竟还有多远?
面对网络上的过度解读,论文第一作者乐洋多次公开发文澄清:“我们从未否定强化学习,我自己依然是强化学习的坚定信徒。”
▲ 作者公开说明:当前的局限旨在呼唤全新且更具探索性的范式
清华团队的这项工作,旨在用扎实的科学事实把行业从盲目的狂热中拉回地面。
当前的RLVR之所以画地为牢,是因为它的设定太局限了:它面对的是死板固定的题库,依赖的是简单的0/1对错结果,模型只能在封闭的答题纸上自言自语。在这样的环境里,模型唯一能学会的生存策略就是“投机”,抱紧最稳妥的旧套路,剪掉一切冒险的新尝试。
这与当年AlphaGo在围棋复杂对局中自如博弈、自主发现“第37手”的壮举,存在本质差异。
要让大模型孕育出全新的认知能力,未来的强化学习需要打破现有束缚:
- 更密集的进程奖励
:跳出单一终局对错评判,在思维推导的每一步建立即时反馈; - 真实环境的多轮交互
:让AI像智能体一样去操作代码、调用工具、在物理世界的反馈中探索,摆脱在封闭提示词里的原地打转; - 更激进的探索机制
:从算法底层重赏那些未曾遇见的逻辑路径,摆脱一味奖励单发命中的平庸取向。
大模型没有魔法,它依然严格遵循着信息论与统计学的铁律。
清华这篇拿下 NeurIPS 亚军的硬核论文,给狂奔了整整两年的AI世界送上了一剂最好的清醒剂:别再沉迷于用最昂贵的算力教模型“背闪卡”了。更深远的探索,才刚刚拉开序幕