ARTICLE · 1120806
OpenClaw 2.0 | 03 上下文压缩:摘要不合格就不让写进去,compaction 现在会自己验货
「OpenClaw 2.0」系列第三篇。上一篇讲记忆怎么跨会话,这一篇讲同一个会话里的另一个难题:聊长了,窗口装不下。
一个会话聊上几百轮,模型的上下文窗口迟早装不下。OpenClaw 对付这件事有三样东西:裁剪、压缩,还有可以整个换掉的上下文引擎。第一期讲 Pi 的时候提过压缩,"上下文满了只压缩内存中的工作版本,磁盘上的原始记录一条不丢"。现在压缩归 OpenClaw 自己管,第一篇讲过,Pi 和 OpenClaw 各有一套压缩互相抢的问题,就是这么收掉的。这一篇看它自己的压缩是怎么做的,重点是一道默认开启的关:摘要写出来,先验货,不合格就不写进去。
窗口里装了什么 -- 先看一眼 /context
先看模型每一轮到底看到什么。系统提示词分成两截,中间隔着一条缓存边界:边界之前是稳定前缀,有基础指令和工作区文件(AGENTS.md、MEMORY.md 这些),每轮基本不变;边界之后是动态后缀,放当前时间、消息渠道、群聊上下文、运行时这些每轮可能变的东西。工作区文件有预算,每个最多 2 万字符,合计最多 6 万字符,超了就头尾截断,并在提示词里告诉模型"有文件被截断,直接去读"。
除了系统提示词,工具定义的 JSON schema 和 skill 条目也占窗口,最后才是对话转录:用户消息、assistant 回复、工具调用、工具结果。
这一摞装了多少,可以用 /context 看:list 看各部分大致多大,detail 看每个文件、每个工具 schema、每个 skill 的大小,map 画一张按字符面积算的树图,一眼看出谁占得多。
窗口越满,手越重 -- 先裁剪,再压缩
窗口快满的时候,OpenClaw 不是一上来就压缩,而是由轻到重一档一档来。
占用到窗口的 30% 以后,本地裁剪开始动旧的工具结果,先 soft-trim,只留头尾;到 50% 且可裁的内容够多,再 hard-clear,直接换成占位符。真正的压缩,在上下文超过"窗口减预留"的时候才出手,预留默认 20,000 token。再往后,模型直接报溢出,就先压缩再重试,最多 3 次。
裁剪 -- 只动旧的工具结果,原始记录不改
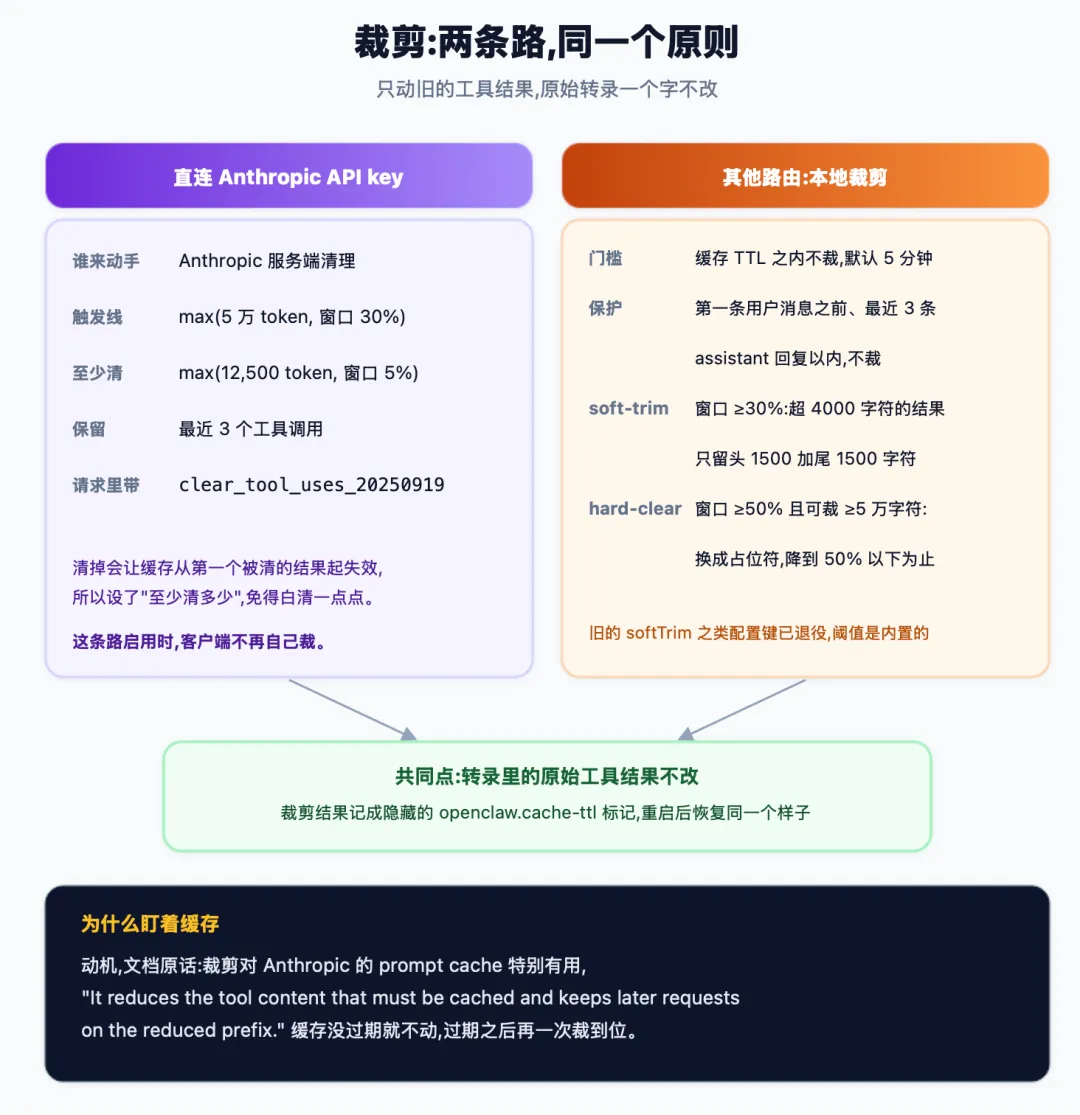
裁剪只处理旧的工具结果,不碰正常的对话文字。文档说得很直白:"Original tool-result entries are not rewritten",转录里的原始工具结果不改,裁剪的结果是一份投影,记成一个隐藏的 openclaw.cache-ttl 标记,重启之后照样恢复成同一个样子。
它有两条实现路径。直连 Anthropic、用 API key 的时候,裁剪交给服务端:请求里带上 clear_tool_uses_20250919,上下文超过 max(5 万 token, 窗口 30%) 就清,只留最近 3 个工具调用,而且每次至少清 max(12,500 token, 窗口 5%)。为什么要设"至少清多少",文档解释了:清掉一个结果,缓存就从第一个被清的结果起整段失效,清得太少不划算。其他路由走本地裁剪,先过一道门:缓存 TTL 之内不动,默认 5 分钟,Anthropic 的配置会默认设成 1 小时;第一条用户消息之前、最近 3 条 assistant 回复以内的,也不动。然后才是图里那两档,soft-trim 把超过 4000 字符的结果只留头 1500 加尾 1500,hard-clear 把结果换成 [Old tool result content cleared]。
这一切都围绕 prompt cache 转。文档的动机原话:"It reduces the tool content that must be cached and keeps later requests on the reduced prefix." 缓存没过期就不动,过期之后再一次裁到位,已经裁过的投影原样重放。改了已经发出去的前缀,缓存就废了。2.0 的发布说明里有一条这方面的修复,长会话里 prompt cache 崩掉,原因是聚合的工具结果截断改写了已经发出去的历史(#132017)。
另外,旧的 softTrim 之类的配置键已经退役,这些阈值是内置的,文章里的数字都不是你能调的。裁剪这套东西在 2026 年 2 月之前就有了,不是 2.0 新增的。
压缩 -- 把旧对话写成摘要
压缩比裁剪重得多,它要让模型把旧对话写成一份摘要。
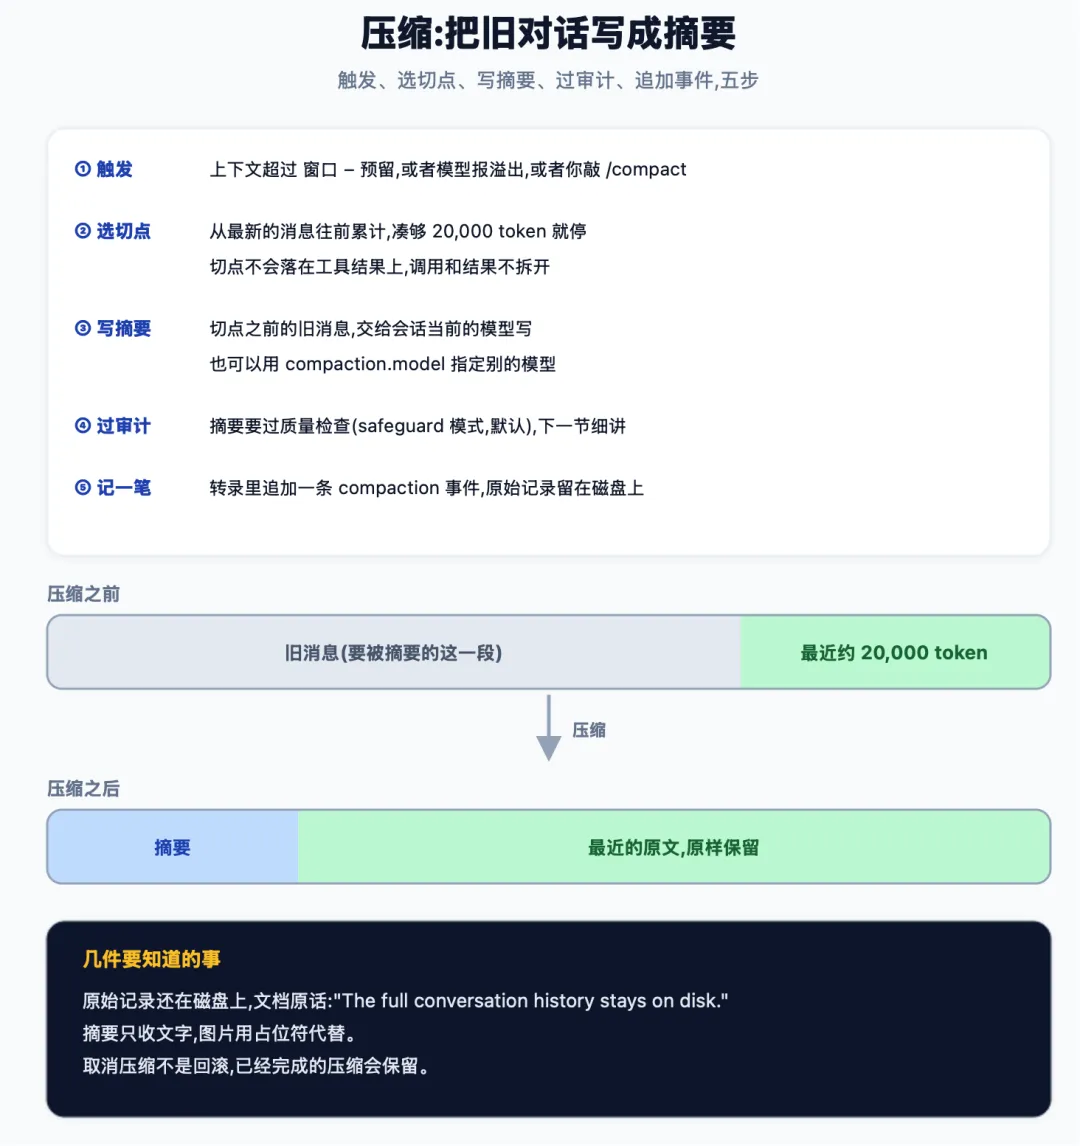
触发条件是 contextTokens > contextWindow - reserveTokens,预留默认 20,000 token,上限是窗口的四分之一。除此之外还有两条路:模型报上下文溢出,先压缩再重试,最多 3 次;或者你自己敲 /compact,后面还能带一段焦点,文档写最长 800 个字符。压缩之前,系统还会让模型先把值得长期记的写进当天的日记,这是上一篇讲过的 memory flush。
压缩的第一件事是选切点:从最新的消息往前累计 token,凑够 keepRecentTokens,默认 20,000,就停在那里。切点不会落在工具结果上,所以一次工具调用和它的结果永远不会被拆开。切点之前的旧消息,交给会话当前使用的模型写摘要,也可以用 compaction.model 指定一个别的模型;切点之后的,原样留着。
摘要写好之后,转录里追加一条 compaction 事件,记着摘要、firstKeptEntryId 和压缩前的 token 数。原始记录还在磁盘上,文档原话:"The full conversation history stays on disk."
有几处文档自己写明了边界:预算是近似的,一个工具调用和它的结果会待在一起,哪怕这一组超过了目标大小;预留只是一个"偏好的目标",不是模型服务商的 token 上限;取消压缩不是回滚,已经完成的压缩会保留;摘要只收文字,图片用占位符代替。
验货 -- 摘要漏了待办怎么办
压缩有个天生的毛病:让模型写摘要,它会漏。漏了待办、漏了刚说好的 ID,后面的对话就接不上了。
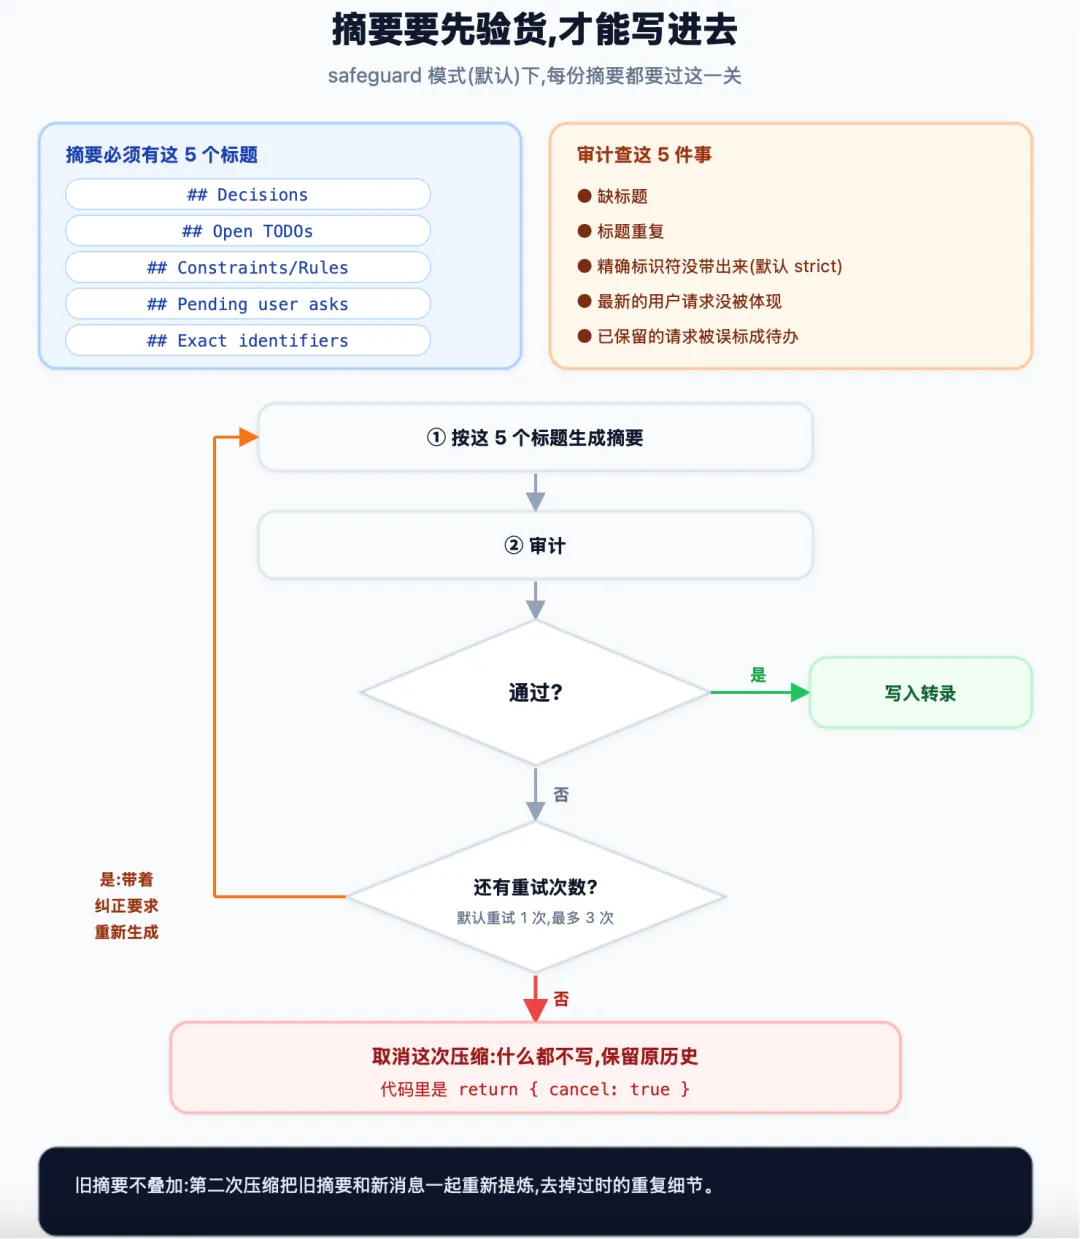
默认的 safeguard 模式给摘要加了一道质量审计。摘要必须带 5 个标题:## Decisions、## Open TODOs、## Constraints/Rules、## Pending user asks、## Exact identifiers。审计查 5 件事:缺标题、标题重复、精确标识符没带出来(默认 identifierPolicy: "strict")、最新的用户请求没被体现、已经保留下来的请求被误标成待办。
审计不过,不是直接写进去,而是带着纠正要求重新生成。总尝试次数是 maxRetries + 1,默认重试 1 次,最多 3 次。最后一次还是不过,代码里是 return { cancel: true }:这次压缩取消,什么都不写,保留原历史。 文档的说法一样:"If no finalized summary passes, compaction stops before writing a transcript entry, keeps the original history."
还有一处细节。第二次压缩的时候,safeguard 不会把旧摘要原样叠上去,而是把旧摘要和新消息一起重新提炼,提示词里要求"去掉过时的、重复的、被取代的细节"。default 模式是另一回事,它走增量更新,提示词要求保留旧摘要里的全部信息,摘要越滚越大。
这道关是后来才默认开的。CHANGELOG 里 2026.3.2 加了质量审计,默认关(#25556);2026.4.24 有一行,"re-distill safeguard summaries instead of snowballing previous summaries, and enable safeguard summary quality checks by default",才改成默认开,并且改成重新提炼(对应 #71357)。精确标识符这一块也是一路补的:2026.2.24 先加固了摘要提示词,要求原样保留 UUID、ID、主机、IP、端口、URL;2.0 的发布说明里还有一条,压缩时"总是恢复被审计的标识符"(#129423)。
压缩出过的真实故障也在 CHANGELOG 里留了名字。#65671:小上下文的本地模型,比如 16K token 的 Ollama,预留的下限比窗口还大,陷入无限压缩的死循环,修法是把预留下限封顶到模型窗口以内。压缩的默认超时也从 900 秒调到了 180 秒(#91361)。
引擎可以换 -- context-engine
裁剪和压缩,都是内置的做法。OpenClaw 还把"窗口里装什么、怎么压"做成了一个可以整个换掉的插件槽:上下文引擎。文档说得很克制,只在你想要不同的拼装、压缩或者跨会话召回方式时,才装一个插件引擎。
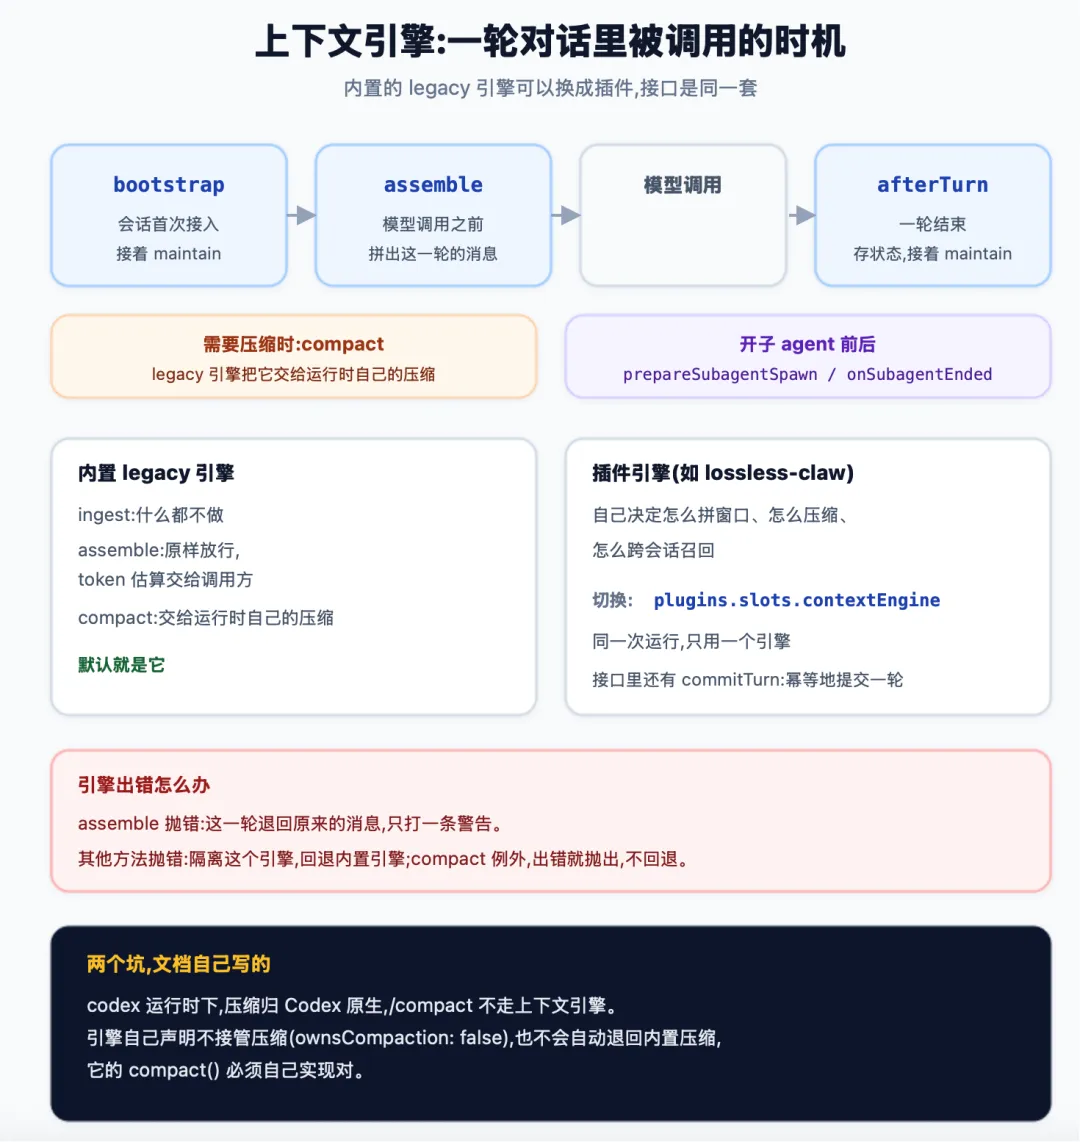
接口有一串方法,必选的只有四个:info、ingest、assemble、compact。一轮对话里,运行时在三个时机调它:会话首次接入时 bootstrap,接着 maintain;每次调模型之前assemble,在 token 预算内拼出这一轮的消息,返回消息列表和 token 估算,可选带一段追加到系统提示词的内容;一轮结束时 afterTurn,存状态,接着 maintain。需要压缩时走 compact,开子 agent 前后有 prepareSubagentSpawn 和 onSubagentEnded。
默认的 legacy 引擎几乎什么都不做:ingest 空转,assemble 原样放行,compact 直接交给运行时自己的压缩。想换,配 plugins.slots.contextEngine,插件调用 registerContextEngine 注册,同一次运行只用一个引擎,文档里的例子是 lossless-claw。这个槽 2026.3.7 就加了,CHANGELOG 里的话是"没配引擎插件时,行为零变化"(#22201)。
引擎出错,有两层保护。assemble 抛错,这一轮退回原来的消息,只打一条警告;别的方法抛错,隔离这个引擎,回退到内置引擎,只有 compact 例外,它出错就直接抛出,不回退。新的接口里还有 commitTurn,配一张 context_engine_turn_outbox 表:一轮被接受之后,先落库,再提交,提交成功才删,失败就留着,下一轮之前重试,保证一轮的提交幂等。
有两个坑文档自己写了。codex 运行时下,压缩归 Codex 原生,/compact 不走上下文引擎。引擎自己声明不接管压缩(ownsCompaction: false),也不会自动退回内置压缩,它的 compact() 必须自己实现对,空实现不安全。
收尾
压缩是个有损操作,摘要写错一次,后面全跟着错。OpenClaw 的做法是不信模型一次写对:标题和待办这种硬指标,让规则去验,验不过宁可不压。我的判断是,这比"换个更强的模型写摘要"靠谱,模型再强也会漏,规则不会。
你的长会话,有没有遇到过压缩之后,agent 忘了刚说好的事?你现在用的是 safeguard 还是 default 模式?评论区聊聊。
下一篇聊队列和 failover:默认改成 steer,你在它干活的时候插嘴,会发生什么。