ARTICLE · 1122031
AI 扔掉Chrome之后,轻量化浏览器 Moli 使用:60MB内核的4条实测结论
实测 · 无头浏览器选型
约 8 分钟读完 · 数据均来自可查证公开报道
我的那台 4G 内存云主机,最后是被 Chrome 拖死的。
不是夸张。跑一个抓取任务,Chrome 连 headless 一起要吃 700MB 往上,机器上还有别的服务在活着,内存高水位一到,OOM killer 挑软柿子捏,先走的永远是浏览器进程。后来我干脆把 Chrome 卸了,换上一个 Rust 写的无头浏览器内核——单实例峰值 58MB。听起来像捡了大便宜,但两个多月用下来,有惊喜,也有三次让我把到手的结论全部作废的暗坑。这篇就是把这些坑一个个踩明白之后,留下的四条实测结论。
先说清楚主角:Moli,一个 Rust 独立实现的浏览器内核(V8 + html5ever + Stylo),不是 Chromium 的封装,GitHub 上开源。它对外暴露 CDP 协议,Playwright 可以 connect_over_cdp 直连,官方口号就是给 AI agent 当轻量浏览器用。我选它的原因很朴素:内存小、单二进制、不用养一个 104MB 的浏览器全家桶。
📋 导读
① JS 到底有没有真执行——执行了,但“跑完”和“跑稳”是两回事
② 内存的真实账本——别光看空闲值,峰值和常驻是两笔账
③ 布局是个开关——不开 --layout,所有几何数据都是假的
④ 指纹一行定生死——它能当抓取内核,永远当不了反爬内核
※ ※ ※
测试怎么做的
为了写这篇,我重新跑了一遍完整矩阵。测试页全部本地自建,目标就是让每个结论都能被复现:一个 setTimeout 延迟 1.2 秒渲染正文的页面、一个 DOM 里塞 4000 个节点的页面、一个用 fetch 拉子资源的页面、还有表单点击、localStorage、canvas、WebSocket 各一。资源占用用 /usr/bin/time -v 取 Maximum RSS,这是进程生命周期内的物理内存峰值,比任务管理器里的瞬时值诚实。
对照基准用两个:一个是公开的 JS 渲染测试站(正文完全由 JavaScript 生成,HTML 源码里是空 div,业界爬虫教材标配),一个是 Moli 官方 README 里给的 Chrome 对比数——本机的 Chrome 已经卸载,没法同机复测,这一点我在文末资料来源里单独声明。
先给结论速览表,后面逐条展开:
※ ※ ※
结论一:JS 是真执行,但“执行完了”不等于“渲染好了”
第一个坑差点把我的整批测试数据报废。
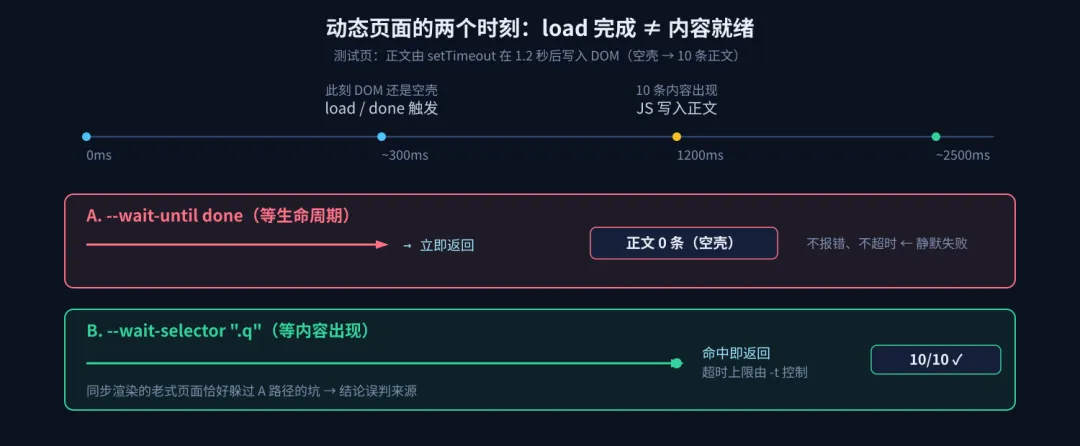
我自己写的延迟渲染页——正文由 setTimeout 在 1.2 秒后塞进 DOM——用默认参数抓,返回的 Markdown 里正文是零条。第一反应是这内核不行,V8 没跑 JS。但换官方那个外部 JS 测试站,同样默认参数,十条名言一条不少。
同一时刻我又做了个反证:用 --eval 在页面里数 DOM 节点,4000 个节点 0.22 秒全建成;fetch 子资源、localStorage 读写、按钮点击后表单值传递,全部正常。V8 是真干活,不是假装。
那差别在哪?在等待策略。
# 拿到空壳——等的是页面生命周期,不是内容 moli fetch -d markdown --wait-until done URL # 拿到全文——等的是"内容出现"这件事本身 moli fetch -d markdown --wait-selector ".quote-item" URL moli fetch -d markdown --wait-script "document.querySelectorAll('.q').length>=10" URLdone 是 load 事件之后的阶段。对一个内容全靠 JS 动态生成的单页应用来说,load 触发的那一刻,正文往往还一个字都没渲染出来——生命周期“完成”了,页面是空壳。Moli 老老实实等完了它承诺的生命周期,然后返回。行为没错,但和多数人的直觉相反:我们说“等页面加载完”,脑子里想的是“等页面渲染完”,这是两个时刻,中间差的那几百毫秒,就是空壳和全文的距离。
外部测试站没踩中这个坑,是因为它的 JS 在同步解析阶段就把内容写进了 DOM,load 之前内容已就位。而现在流行的 SPA 和 hydration 页面恰恰相反:先回一个空壳加一坨 JS,load 之后才开始填内容。所以这个坑是静默的——不报错、不超时,只是你的 Markdown 里少了一半正文,而你很可能没注意。
Moli 在这点上反而比很多工具诚实:它提供 --wait-selector、--wait-script、--wait-response-url 一整排显式等待原语,把“你在等什么”摆在命令行上。Playwright 用户习惯的 wait_for_selector 思路完全平移得过来。我把这一条排第一,因为翻车成本最高:数据静默缺失,错的是你的下游一切分析。
一句话:抓动态页面,把“等生命周期”改成“等内容”,一秒都不能省。
※ ※ ※
结论二:内存确实省了一个数量级,但要算清两笔账
先看今天的实测数:抓那个外部 JS 渲染站,单次 fetch 峰值 RSS 在 58.7-59.0MB 之间,五个实例同时跑,五个全部成功,总峰值约 290MB——我的 4G 机器毫无压力,这五并发要是换 Chrome,官方基准给的是单实例 773MB,五开直接 4GB,机器当场就没命了。
4000 节点的 DOM 重页面,峰值 56MB。轻量任务(静态 HTML、单值 eval)普遍在 40MB 上下。截图模式最重,138MB——布局引擎全开的代价,仍然不到 Chrome 的零头。
但这里有个必须诚实交代的地方。我顺手看了一眼那台常驻的 moli serve 进程——它的 CDP 服务已经跑了二十六七个小时,处理过一些请求,RSS 是 210MB。空闲内存和常驻内存是两笔账。单发 fetch 用完即走,峰值就是全部成本;serve 模式是长驻服务,像所有长驻进程一样会累积。官方宣传的“idle 十几 MB”是刚启动、没干活时的数字,拿它去规划长期运行的服务会失真。
所以我的实际用法分成了两路:
# 一次性抓取:直接 CLI 单发,用完进程消失,零常驻 moli fetch -d markdown --wait-selector ".item" -t 20000 "https://example.com/news" # 批量任务:起 serve 常驻,Playwright 连上去 moli serve --host 127.0.0.1 --port 9222 &# Playwright 零改动换内核 from playwright.async_api import async_playwright async def main(): async with async_playwright() as p: browser = await p.chromium.connect_over_cdp("http://127.0.0.1:9222") ctx = browser.contexts[0] if browser.contexts else await browser.new_context() page = await ctx.new_page() await page.goto("https://example.com/news") print(await page.inner_text("body")) import asyncio; asyncio.run(main())--eval 返回 Promise 时会自动 await,这个细节对写抓取断言很友好——--eval “document.title” 之外,你可以扔一个异步表达式进去等结果落地。
一句话:小内存机器上,单发 fetch 是白捡的资源,serve 常驻要按普通长驻服务的标准去配 memory limit。
※ ※ ※
结论三:布局是开关式的——不开 --layout,几何数据全是假的
第三个坑同样静默,而且更阴险:它给你数据,给你的全是错数据。
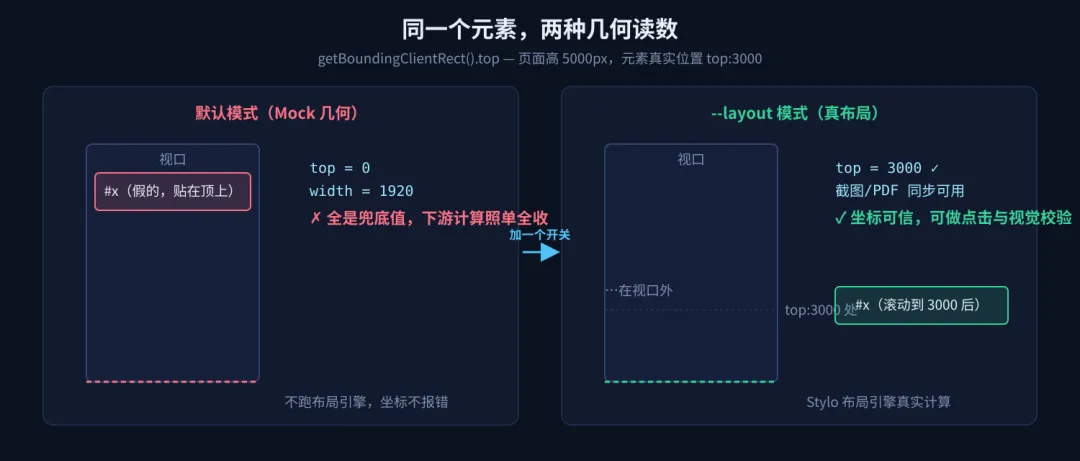
无头抓取有个常见需求:拿元素坐标,驱动点击或者做视觉校验。我在一页长 5000px 的测试页上放了一个 top:3000px 的元素,两种模式各读一次 getBoundingClientRect().top:
moli fetch --eval "document.getElementById('x').getBoundingClientRect().top" URL # → 0 (Mock 几何:布局根本没算) moli fetch --layout --eval "document.getElementById('x').getBoundingClientRect().top" URL # → 3000 (真布局)差了 3000 像素。默认模式下 Moli 不跑布局引擎——这是个合理的性能取舍,纯抓文本没人需要几何。但它不报错、不警告,getBoundingClientRect 照样返回一个对象,所有字段都是零值或者 1920 这种兜底宽度。如果你的脚本逻辑依赖坐标做判断,它会拿着假数据算出一个语法完全正确的错误结论。
同理,截图和 PDF 输出强制要求 --layout,不带你直接报错——这部分它倒是守得住。开了 layout 之后能干什么,我验证过:视口截图 1920×1080、整页截图 1920×5016 全高(懒加载长页一次到顶)、分页 PDF 两页,都是真实渲染产物。
我的视觉 QA 工作流现在是这样:静态页面起个临时 http 服务(file:// 协议被禁),--layout 截图,把 PNG 喂给识图模型做定向审查——重叠、穿字、乱码逐条问。以前这种检查要在带 VNC 的 Chrome 里开页面截图,小内存机器上卡死是常事。现在单发一条命令、一秒半出图。
--eval 配合 --layout 还能做行为级断言:直接在渲染后的页面上 dispatchEvent 一个 click 或 Escape,再读回元素的 style.display、querySelectorAll 的数量,验证“灯箱打开→关闭”这类状态迁移。整个链路不需要任何浏览器 GUI,对小机器意义重大——Chrome 加 VNC 一轮检查吃掉的时间,够 Moli 跑二十个页面。
一个必须提的副作用:这台机器缺 CJK 字体时,图里的 ∪、≠ 这类符号会被渲染成 u、=。截图里出现数学符号,先怀疑字体再怀疑代码。
一句话:几何数据是开关式的信任——默认值全部作废,用之前先确认 --layout。
※ ※ ※
结论四:指纹一行定生死,它的天花板是“抓取内核”
最后这条是选型的边界,也是官方 README 不会替你划清的一条线。
在一行 JS 里看浏览器的自报身份:
moli fetch --eval "JSON.stringify({ua:navigator.userAgent, wd:navigator.webdriver, chrome:typeof window.chrome, vendor:navigator.vendor, plugins:navigator.plugins.length})" URL # → {"ua":"...Chrome/145.0.0.0...","wd":false,"chrome":"undefined","vendor":"Google Inc.","plugins":5}UA 谎报 Chrome 145,webdriver 藏成 false,vendor 装得像模像样。但 window.chrome 是 undefined——真 Chrome 一定有这个对象,任何做过功课的风控脚本,一行就能识破。这不是 Moli 偷懒,是独立内核的原罪:底层 TLS 指纹、JA3、canvas 渲染特征、HTTP/2 帧序列全是自己实现的,伪装成 Chrome 需要把每一条特征都对齐,那是 cat-and-mouse 的军备竞赛,一个三人规模的开源项目追不上,也不该去追。
实测印证:知乎热榜返回扫码登录墙,某内容平台的验证页直接 0 字节秒退。失败还是静默的——不报反爬错误,只是把登录墙的壳或者空响应交给你。
所以我的分工表长这样:
拿它替 Chrome 跑日常抓取,成立;指望它替 stealth Chrome 打风控,不成立。省内存的红利和指纹可信度之间没有中间地带,认清这条线,Moli 是个优秀的抓取内核;看不清,你会把反爬任务的锅错记在它头上——我就曾把一个代理节点抖动导致的超时误判成引擎的锅,直连复测一次就真相大白了。失败先归因哪一层,再下结论。
※ ※ ※
给三类人各一句话
对小内存机器运维:把 Chrome 换成这类内核的收益是实打实的——五个并发抓取不到 300MB,这在 4G 机器上是“能不能干”和“敢不敢干”的区别。但 serve 常驻配好 memory limit,抓取脚本一律显式等待内容。
做爬虫/数据的人:它能做你的默认文本抓取引擎,JS 渲染、子资源、交互全通;把 --wait-selector 写进你的模板命令,把反爬需求单独分流。
做前端质量/自动化的人:--layout + --eval 的无 GUI 行为断言,在 CI 或者小机器上比 VNC Chrome 体面太多;但 Lexbench 那种高级 API 覆盖度(官方数字:81.9% 对 Chrome 99.8%)意味着复杂 Playwright 脚本先小样验证,报错先怀疑协议未实现。
※ ※ ※
写在最后
回头看,四条结论里真正咬到我的,没有一条是“内核能力不行”——V8 够用、网络栈真实、渲染链路完整。咬到我的三条全是静默行为:默认不等内容、假几何不报错、反爬失败不吭声。轻内核的功课不在功能面,在“它什么时候会假装成功”。
工具没有银弹。Chrome 那种重,是把成本摊在每个毫秒;这类内核的轻,是把成本藏在几个不说出口的默认值里。你把那四个默认值读明白了,60MB 的浏览器就能干过去 700MB 的活。
你现在跑抓取还开全家桶吗?评论区说说你的机器内存和方案,我看看有没有比这更省的野路子。
如果觉得这篇帮你提前避了坑,点个在看,转给那个还在小机器上硬扛 Chrome 的朋友。
下一篇预告:这条无头内核的选型线,其实是我整条 AI 内容流水线里的一块拼图——从选题哨兵到去 AI 味闸门,每个环节我都量过翻车率。下一篇把整条管道摊开讲。
※ ※ ※
资料来源
- ▪
Moli 开源仓库(Rust 独立浏览器内核,官方 README 含 192 URL 混合抓取与 Lexbench 基准、Chrome 773MB 对照值) - ▪
本机实测(2026-10-04):延迟渲染/4000 节点/fetch 子资源/存储/canvas/点击/WebSocket/截图/PDF/五并发/指纹探测/几何对照,/usr/bin/time -v 取 Maximum RSS,数据原样写入文中 - ▪
公开测试站 quotes.toscrape.com/js(JS 渲染验证);知乎/头条反爬面实测为登录墙与空响应 - ▪
Chrome 基准数字引自官方 README,本机未同机复测(Chrome 已卸载);文中所有页面均为自建测试样例,未涉及任何真实业务站点;示例均为通用化环境描述,非作者真实生产配置
轻内核的功课不在功能面,在它什么时候会假装成功。
在看 · 转发 · 评论区聊聊
如果这篇文章对你有用,欢迎关注公众号 AI前沿技术仓:
本文完整网页版:https://ivisi.cc/post/2026-10-04-moli-headless