ARTICLE · 1122026
AI应用的合规边界,越来越取决于它“能做什么”
过去企业讨论AI合规,最常问的几个问题是:
用了哪一家大模型?数据有没有发送给模型厂商?模型有没有备案?服务器部署在哪里?
这些问题当然重要。
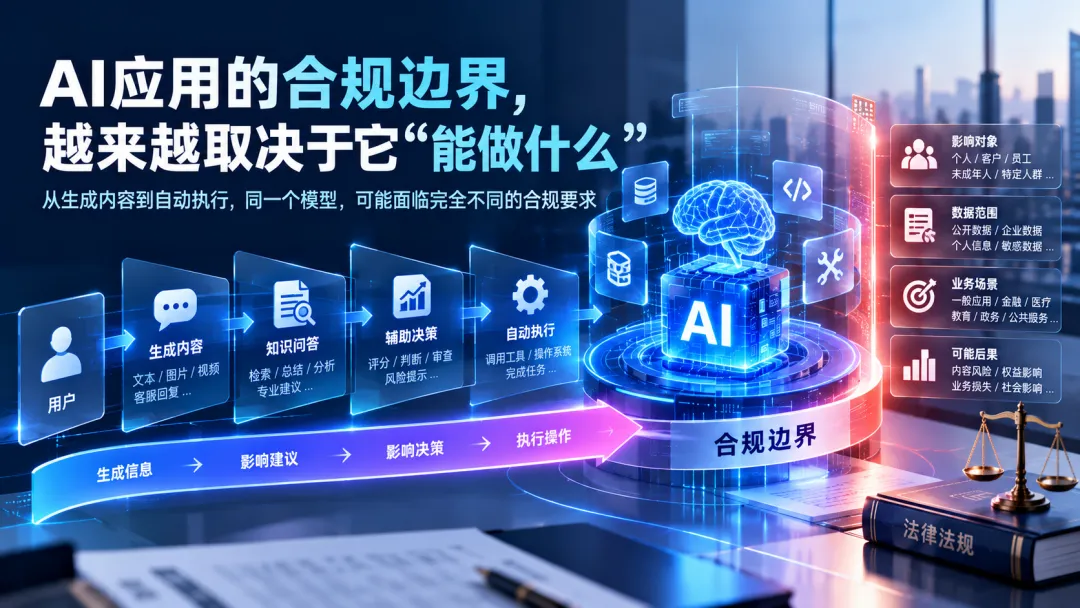
但随着AI从聊天机器人、知识问答走向RAG、Copilot,再走向能够调用工具和业务系统的AI Agent,仅仅知道“用了什么模型”,已经越来越难判断一个AI应用真正的合规边界。
一个很直观的例子是:
同样调用一个大模型API,一个应用只负责帮助员工总结会议纪要;另一个应用可以读取客户资料、判断客户风险,并自动修改CRM中的客户等级;第三个应用则模拟人的人格和沟通方式,与用户长期进行情感陪伴。
三者使用的底层模型甚至可能完全相同。
但它们面对的法律关系、风险等级和治理要求显然不会相同。
2026年7月15日起施行的《人工智能拟人化互动服务管理暂行办法》就是一个很有代表性的例子:普通智能客服、知识问答、工作助手等,如果不涉及持续性的情感互动,不适用该办法;而模拟自然人人格特征、思维模式和沟通风格,向境内公众提供持续性情感互动服务,则进入该办法的适用范围。中央网信办
这背后其实体现出一个值得企业关注的变化:
AI应用的合规边界,正在越来越多地由“它实际能做什么”决定,而不只是由“它使用了什么技术”决定。
01|核心判断:同一个模型,可以产生完全不同的合规问题
从技术架构上看,今天大量AI应用其实很相似。
底层可能都是:
用户 → AI应用 → Prompt → 大模型API → 模型输出
但只要在大模型周围增加不同能力,系统性质就会迅速发生变化。
例如:
                         大模型
                           │
          ┌────────────────┼────────────────┐
          ↓                ↓                ↓
       生成文本          读取数据          调用工具
          │                │                │
       内容生成          知识问答          AI Agent
                                            │
                              ┌─────────────┼─────────────┐
                              ↓             ↓             ↓
                            发邮件        修改CRM        审批业务
第一种应用的核心风险可能集中在生成内容。
第二种开始涉及企业数据和访问权限。
第三种则进一步进入业务行为和责任结果。
所以,企业在评估AI系统时,一个越来越重要的问题不是:
我们用了什么模型?
而是:
这个AI最终被赋予了什么能力?
因为真正产生法律后果的,通常不是“模型存在”这件事,而是模型被嵌入什么业务、处理什么数据、影响什么人,以及被允许执行什么操作。
02|第一条边界:AI只是“生成内容”,还是开始“影响现实”
先看最常见的生成式AI。
例如:
写营销文案、生成图片、制作视频、生成客服回复、辅助撰写公众号文章。
这类应用最核心的行为是:
生成信息。
于是合规重点自然会落到生成内容本身。
内容是否合法?
是否侵犯知识产权?
是否可能产生虚假信息?
是否涉及个人信息?
是否需要标识?
《人工智能生成合成内容标识办法》已经于2025年9月1日起施行,其将利用人工智能技术生成、合成的文本、图片、音频、视频、虚拟场景等纳入生成合成内容,并建立显式标识和隐式标识制度;相关规则还进一步覆盖内容生成、下载、复制、导出和传播等环节。中央网信办
这类治理逻辑的核心是:
AI生成了什么。
但如果AI开始从“生成信息”走向“影响业务”,治理重点就会发生变化。
03|第二条边界:AI是在“提供建议”,还是已经开始“作出决定”
假设一家银行内部使用AI。
第一种系统:
帮助客户经理总结客户资料。
第二种系统:
根据客户信息生成风险分析意见。
第三种系统:
自动决定客户是否满足某项业务条件。
从模型角度看,三套系统可能使用相同的大模型。
但从业务后果看,已经完全不同。
尤其当系统利用个人信息进行自动化决策时,《个人信息保护法》第二十四条要求保证决策透明度和结果公平、公正,不得在交易价格等交易条件上实行不合理的差别待遇;通过自动化决策作出对个人权益有重大影响的决定时,个人还有权要求说明,并有权拒绝个人信息处理者仅通过自动化决策作出决定。中央网信办
因此:
AI有没有“决策权”,本身就是一个重要的合规分界点。
这也是为什么企业不能简单写一句:
“本系统仅采用人工智能技术辅助业务。”
真正需要核验的是技术事实。
AI给出建议以后,是由员工独立判断?
还是员工实际上默认接受AI结果?
AI评分是否直接进入业务规则?
低于某个分数是否自动拒绝?
模型结果是否直接触发下一步系统流程?
如果答案逐渐从“辅助”变成“自动”,那么系统的责任结构也应该随之调整。
04|第三条边界:AI是在“回答问题”,还是开始“执行操作”
这是AI Agent带来的一个非常重要的变化。
传统Chatbot主要完成:
Input → Output
用户输入一个问题,AI返回一段内容。
Agent则可能变成:
Input → Reasoning → Tool Call → Action → Result
例如一个企业采购Agent可以:
读取采购需求,
查询供应商,
比较报价,
生成采购建议,
调用ERP,
创建采购单,
发送邮件。
这时企业面对的已经不只是:
模型会不会胡说。
而是:
模型会不会做错。
两者的治理逻辑完全不同。
因此Agent时代需要增加一套新的控制对象:
Identity → Permission → Tool → Action → Log
也就是:
谁启动Agent?
Agent代表谁行动?
可以调用哪些工具?
每个工具有什么权限?
哪些操作需要人工确认?
执行结果如何撤销?
整个过程是否留痕?
这也是为什么我认为:
AI Agent进入企业以后,权限治理会逐渐成为AI治理的核心问题之一。
过去AI安全更多关注模型输出。
未来还必须关注:
AI获得了什么行动权限。
05|第四条边界:AI面对的是“普通用户”,还是特定人群
功能相同,服务对象不同,风险也可能完全不同。
最典型的是未成年人。
再例如医疗、金融、教育等专业场景。
甚至同样是聊天机器人:
普通客服机器人和长期陪伴型AI,监管逻辑也可能不同。
2026年施行的《人工智能拟人化互动服务管理暂行办法》就非常清楚地体现了这一点。
该办法针对的不是所有Chatbot。
它针对的是利用人工智能技术,向境内公众提供模拟自然人人格特征、思维模式和沟通风格的持续性情感互动服务;普通智能客服、知识问答、工作助手、学习教育和科学研究等,如果不涉及持续性情感互动,则明确不适用该办法。中央网信办
为什么要区分?
因为功能发生了变化。
一个知识问答系统主要解决:
信息问题。
一个长期拟人化陪伴系统则可能进一步影响:
情绪、心理依赖、行为选择以及未成年人身心健康。
因此监管对象虽然仍然叫“AI应用”,治理重点已经完全不同。
这说明:
AI治理越来越不能只按照技术名称分类,而需要按照真实功能和真实影响分类。
06|第五条边界:AI是企业内部工具,还是向公众提供服务
这条边界也非常重要。
很多企业内部AI系统一看到“生成式人工智能”,就开始直接套用《生成式人工智能服务管理暂行办法》。
但该办法第二条规定的是:
利用生成式人工智能技术向中华人民共和国境内公众提供生成文本、图片、音频、视频等内容的服务。
同时明确,行业组织、企业、教育科研机构等研发、应用生成式人工智能技术,未向境内公众提供生成式人工智能服务的,不适用该办法。中央网信办
这并不意味着:
企业内部AI系统“不需要合规”。
而是意味着不能把:
“使用了生成式AI”
直接等同于:
“适用所有生成式AI服务规则”。
企业内部系统仍然可能涉及个人信息保护、数据安全、网络安全、知识产权、商业秘密、劳动管理、合同义务等问题。
所以判断一个AI应用的合规边界,必须先回答:
它到底在什么业务关系中运行。
07|企业最容易犯的错误,是用“模型清单”代替“AI应用清单”
很多企业开始建立AI治理制度以后,会先做一张表:
GPT、DeepSeek、Claude、Qwen……
然后记录:
模型厂商是谁、部署在哪里、API地址是什么。
这张表有价值。
但它解决的是:
Model Inventory。
真正做AI治理,还需要另一张更重要的清单:
AI Application Inventory。
因为同一个模型可能支撑十几个完全不同的应用。
例如:
                        同一个大模型
                            │
       ┌─────────┬──────────┼──────────┬─────────┐
       ↓         ↓          ↓          ↓         ↓
     文案助手   合同审查   客服机器人   HR助手   采购Agent
       │         │          │          │         │
    内容风险   法律专业性   用户数据   员工数据   执行权限
真正决定风险的,往往是下面这一层。
因此企业AI治理应该从:
“我们用了哪些模型?”
进一步升级到:
“我们让AI做了哪些事情?”
这是两个完全不同的治理视角。
08|我更建议建立一套“AI能力分级”
如果把企业里的AI应用按照“能做什么”拆开,可以建立一套非常实用的内部能力分级。
它不需要追求法律上的统一分类,而是服务企业自己的风险管理。
Level 1|生成
AI只能生成文本、图片、音频等内容。
核心控制:
内容安全、知识产权、生成标识、事实准确性。
Level 2|读取
AI能够读取企业知识库、客户资料或者业务数据。
治理重点增加:
数据权限、个人信息、商业秘密、RAG检索权限。
Level 3|建议
AI开始输出评分、判断、审查意见或者决策建议。
治理重点进一步增加:
专业准确性、可解释性、人工复核和责任边界。
Level 4|执行
AI能够调用Tool或者API,对业务系统实施操作。
例如:
发送邮件、修改CRM、创建订单、调用支付、操作ERP。
治理重点转向:
身份、权限、授权、操作日志、人工确认和可撤销机制。
Level 5|自主行动
AI能够根据目标自主规划任务、调用多个工具,并连续执行。
这时治理对象已经不只是一个模型。
而是一个:
具有一定自主行动能力的软件主体。
需要进一步考虑:
权限上限、任务边界、异常停止、持续监控、责任追踪和人工接管。
这五级不是现行法律规定的法定分类。
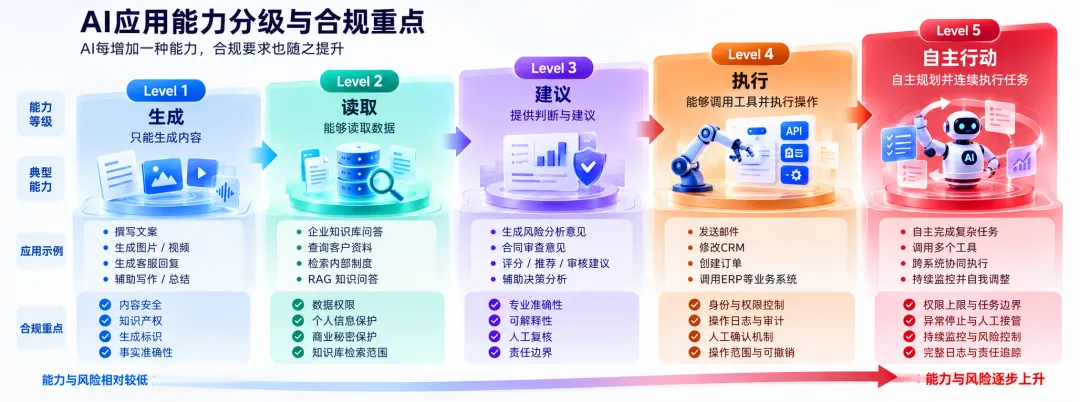
但作为企业内部治理框架,它有一个明显优势:
AI能力每增加一级,就重新检查一次治理措施是否匹配。
09|AI合规审查应该从“技术审查”转向“能力审查”
基于这个思路,我建议企业以后上线一个AI应用,不要一上来就问几十个法律问题。
先让产品经理和技术人员回答六个问题:
第一,它能看到什么?
知识库、个人信息、客户数据还是公开数据?
第二,它能生成什么?
普通文本,还是可能直接向公众传播的内容?
第三,它能判断什么?
只是信息总结,还是评分、推荐、审核和决策?
第四,它能操作什么?
只能回答问题,还是可以调用API修改业务系统?
第五,它影响谁?
内部员工、普通消费者、未成年人,还是特定行业用户?
第六,它出了错,会发生什么?
一句回答错误?
一份合同判断错误?
一笔订单被错误执行?
还是对个人权益产生重大影响?
这六个问题回答以后,很多合规要求其实会自然浮现出来。
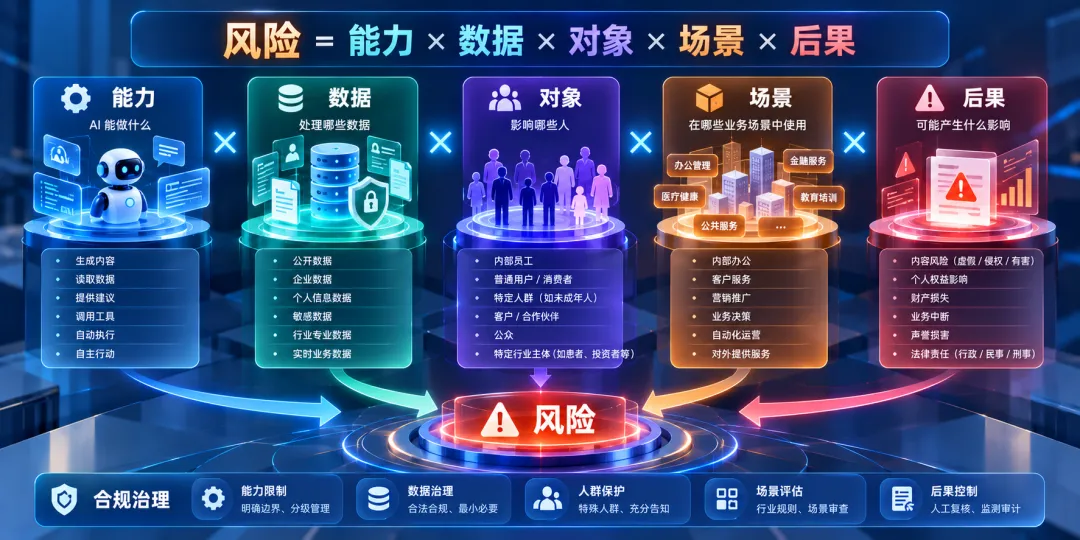
因此我更愿意把AI应用的风险理解成:
风险 ≠ 模型本身
而更接近:
风险 = 能力 × 数据 × 对象 × 场景 × 后果
这不是法律公式,而是一种企业治理方法。
10|法律规则最终需要落到技术控制上
如果只是形成一份《AI使用管理办法》,AI治理很容易停留在纸面。
真正有效的治理应该进入系统。
例如:
法律要求控制个人信息访问。
技术上就需要落实到:
IAM、RBAC、ACL、Metadata Filter。
要求高风险操作人工确认。
系统就需要设计:
Human-in-the-loop。
要求能够追踪Agent行为。
就需要保存:
User → Prompt → Reasoning/Decision Context → Tool Call → API → Result → Operator/Approver → Timestamp
要求控制AI的操作范围。
就需要设计:
Tool Allowlist、Permission Scope、Rate Limit、Transaction Limit。
要求出现异常可以停止。
就需要:
Kill Switch、人工接管、权限回收和回滚机制。
因此:
AI治理成熟度最终体现的,不是企业写了多少制度,而是法律要求能不能转化成系统控制。
这也是法律人员越来越需要理解AI技术架构的原因。
11|AI应用每增加一种能力,都应该触发一次重新评审
传统软件上线以后,功能变化往往被理解为产品迭代。
AI系统不完全一样。
例如一个最初只是内部知识问答的系统:
V1.0
只能回答公司制度。
风险相对有限。
后来升级:
V2.0
接入HR系统,可以查询员工信息。
数据边界发生变化。
继续升级:
V3.0
可以分析员工绩效并提出评价建议。
决策影响开始出现。
再升级:
V4.0
可以自动生成绩效结果并写回HR系统。
行动权限出现。
虽然产品名字一直叫:
“AI人力资源助手”。
但实际上它已经经历了四种不同的风险状态。
因此企业真正需要建立的是:
Capability Change Review
也就是:
AI能力变化评审。
当AI新增数据源、新增Tool、新增API、新增用户群体、新增自动执行能力或者从内部应用转向公众服务时,都应该重新判断其合规边界。
12|从“模型治理”走向“AI系统治理”
这也是我对未来企业AI治理的一个判断。
早期AI治理的关注点主要集中在:
模型。
模型是否安全?
训练数据是否合法?
输出内容是否合规?
算法是否需要备案?
这些当然仍然重要。
但Agent时代以后,治理对象会逐渐扩展为:
AI Application System。
完整对象变成:
用户
 ↓
AI应用
 ↓
身份与权限
 ↓
数据 / RAG
 ↓
Prompt
 ↓
模型
 ↓
Agent
 ↓
Tool
 ↓
API
 ↓
业务系统
 ↓
现实业务结果
 ↓
日志与审计
如果只治理中间那个“模型”,实际上只控制了整条链的一部分。
这也是为什么未来企业AI治理可能越来越像:
法律治理 + 数据治理 + 身份治理 + 软件工程治理 + 安全治理。
而不是一个孤立的“AI合规”部门能够单独完成的工作。
结语
AI技术正在发生一个非常重要的变化。
过去,大多数AI主要负责:
“告诉人应该怎么做。”
现在越来越多AI开始:
“替人做。”
从生成内容,到读取企业数据;
从提供建议,到影响决策;
从回答问题,到调用工具;
从调用一个API,到自主规划并连续执行多个任务。
AI每向前走一步,企业的治理边界都会发生变化。
因此未来判断一个AI应用是否合规,第一句话可能不应该是:
“它用了什么模型?”
而应该先问:
“它到底能做什么?”
然后继续追问:
它能看到什么数据?
能影响什么决定?
能调用什么系统?
能代表谁行动?
出了错误会产生什么后果?
这些问题回答清楚以后,数据保护、内容安全、知识产权、算法治理、权限控制、人工复核、日志审计和责任机制,才能真正找到落点。
所以我认为,企业AI治理下一阶段一个非常重要的变化,就是:
从“模型合规”走向“能力合规”,再从“能力合规”走向完整的“AI系统治理”。
AI的能力边界在哪里,治理边界就应该跟到哪里。