ARTICLE · 1129053
彭博:DeepSeek 把中美 AI 差距打到 3%,历史新低
流传已久的说法:中美模型差距还很大
15% → 9% → 3%
差距打到历史新低
彭博行业研究 10-05 报告 · LiveBench 81.1 vs 83.4 · R1 以来中国模型最高排名 · 附分母拆解
中美 AI 差距 · 一条收窄的线
📦 5 Parts + Conclusion
👉 滑动
PART 01
数字
15%→9%→3%
PART 02
分母
81.1 vs 83.4
PART 03
排名
全球第六
PART 04
另一半
前15仅3席
PART 05
变现
2030盈利论
一个流传了很久的说法:中国 AI 离美国最顶尖的模型,还差着一大截。
这个说法上周被一份报告正式改写了。
10 月 5 日,彭博行业研究(Bloomberg Intelligence)发布报告:自 9 月 DeepSeek 发布 V4.1 Flash 之后,中国顶尖模型与美国竞争对手在基准测试得分上的差距,已经缩小到 3%。
这个数字在今年年初是 15%,5 月是 9%。
15% → 9% → 3%,一条一路收窄的线,现在打到了历史最低。
更具体一点:LiveBench 榜单上,DeepSeek V4.1 Flash 拿下 81.1 分,全球第六——这是 DeepSeek 自 2025 年凭推理模型 R1 一战成名以来,中国模型拿过的最高排名。第一名是 Anthropic 的模型,83.4 分。
我今天把分母拆开算了算,也把这份报告「没说的那一半」翻了出来。这篇讲清楚三件事:3% 怎么来的、另一半数字是什么、对你选模型有什么用。
01
PART
报告说了什么:三个百分比一条线
PART 01
先把信源摆正:彭博行业研究是彭博旗下的智库(Bloomberg Intelligence),不是 DeepSeek 的自吹,也不是自媒体演绎。这份报告的署名分析师是 Robert Lea(罗伯特·利),发布于 10 月 5 日。
报告的骨架是三个百分比:
1今年早些时候,中美顶尖模型的基准得分差距约 15%;
25 月,收窄到约 9%;
39 月 DeepSeek 发布 V4.1 Flash 之后,差距缩小到 3%。
三个点连成一条线,方向和速度都摆在那了。分析师的判断更进一步:中国顶尖模型的表现已经「可媲美」Anthropic 和 OpenAI 的领先系统,性能持续提升意味着中国企业有望继续扩大市场份额。
他在报告里还有一句更重的话:这些进展「进一步令人质疑美国在 AI 领域保持长期技术领先地位的可持可续性」——原词是 sustainability,可持续性。而这一切发生在美国对英伟达芯片实施出口限制的背景之下,限制的成效因此被打上问号。
看一眼 LiveBench 的官方榜单,画面更直白:榜首 Claude Fable 5.1(83.4),往下 Claude 5.5 Opus(83.2)、GPT-6 Astra(82.2)、GPT-6.1 Sol(81.6)、Muse Spark 1.3(81.6),然后就是 DeepSeek V4.1 Flash(81.1)——中间只剩两个身位。
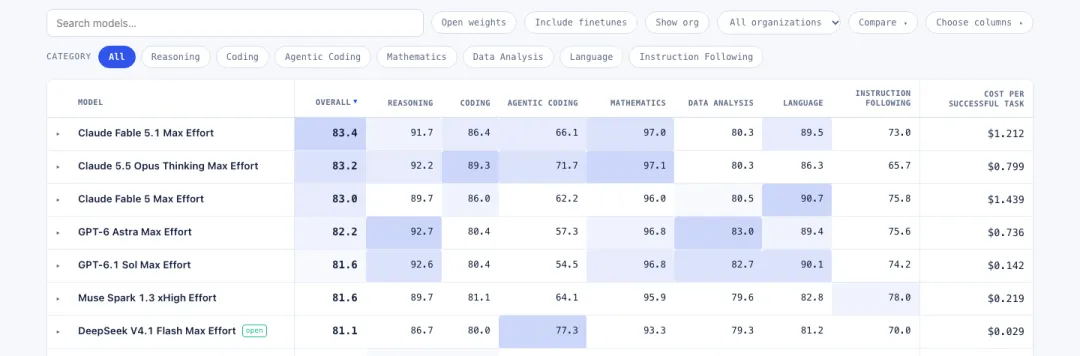
LiveBench 官方榜单(livebench.ai,2026-10-05 截):Anthropic 最高 83.4,DeepSeek V4.1 Flash Max Effort 81.1(OPEN · 免费商用),单任务成本 $0.029 对比榜首 $1.212
02
PART
分母拆解:3% 是怎么算出来的
PART 02
每篇聊跑分的稿子我都提醒同一件事:先看分母。这次我自己算了一遍。
BI 报告用的口径是 LiveBench 总分(23 项客观任务、7 大类、每六个月换题库防污染)。DeepSeek V4.1 Flash 是 81.1 分,Anthropic 最高分模型是 83.4 分——差 2.3 分,相对差距约 2.8%,四舍五入就是报告里的「3%」。
分母清楚了,这个 3% 是扎实的:同一张榜、同一个口径、相对差距。
但有两个必须标注的细节。
第一,榜单排名是动态的。BI 说的「全球第六」是 9 月的时点;我写稿时查 DataLearner 收录的 LiveBench 榜,DeepSeek-V4.1-Flash 以 81.11 分排在第 8——GPT-6.1 Sol 和 Muse Spark 的新版本发布把它顶下去了两位。分数没掉,是别人在涨。两个时点都对,引用时要带日期。
第二,「可媲美」不等于「处处一样」。LiveBench 是总平均分,拆开看分项,各家的形状不一样:DeepSeek 在编码与代理任务上能摸到第一梯队( coding 80.0、agentic 77.3),指令遵循(70.0)与头部模型仍有可见差距。「差距 3%」描述的是平均水平,不是每个战场。
还有个容易被略过的细节:榜单上 DeepSeek 那一行标着 OPEN 和免费商用,右侧成本列写着 0.029 美元/任务——榜首 Claude Fable 5.1 是 1.212 美元。分数差 2.8%,价格差了 40 倍。这是这份报告之外,我觉得最值得盯着看的数字。
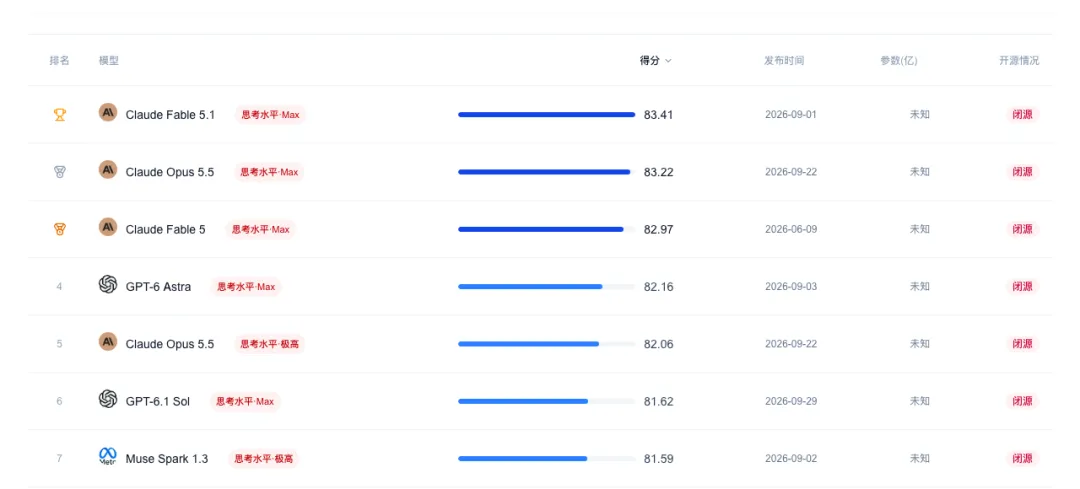
DataLearner 收录的 LiveBench 中文榜(2026-10-05 截):DeepSeek-V4.1-Flash 81.11 分列第 8、5520 亿参数、免费商用——前 7 名全部为闭源模型
03
PART
另一半数字:报告没有只报喜
PART 03
如果只看「3%」这个标题,会把这份报告读成一篇捷报。它的后半段其实相当清醒。
排名的另一面:前 15 名里,中国模型只占 3 席。顶部是密集的美国模型集团军,中国的头部还是单点突破,不是集团优势。分析师也提醒:排名是动态的,榜单高分和商业化变现之间,隔着一条很难走的路。
变现的另一面:中国 AI 行业可能要到 2030 年才能盈利。报告的估算逻辑是:国内市场有超过 1100 个大模型在打价格战,如果都挤在低毛利的 token 供给上,谁也建立不起竞争优势。应用侧,字节的豆包在变现上领先,DeepSeek 和腾讯的聊天机器人到今天还是免费的。要走上可持续盈利的轨道,报告的原话是:需要竞争降温、行业洗牌、更理性的定价。
监管的另一面:中国模型在海外面临审查压力。围绕「模型蒸馏」的指控(美方口径,未经证实)让中国模型在部分市场面临监管审视甚至潜在禁令。同期 Anthropic CEO 阿莫代伊还在呼吁全行业放缓步伐、引入第三方安全评估——头部厂商自己也在给速度踩刹车。
所以这份报告的完整读法是:性能差距基本抹平,但排名密度、商业变现、监管环境,三个战场都还没到能宣布「追平」的时候。
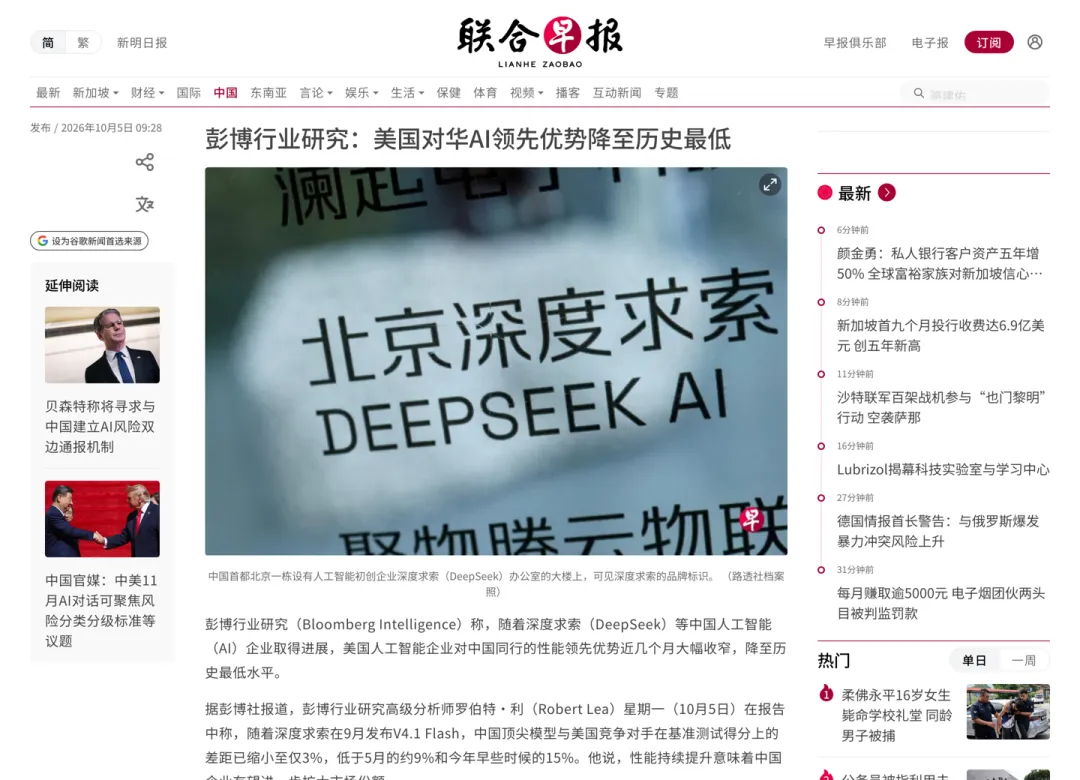
联合早报 2026-10-05 报道版面:年初 15% → 5 月 9% → 10 月 3%(彭博行业研究口径)
04
PART
对你选模型意味着什么
PART 04
对大多数人来说,榜单是别人打的,问题是自己的:这跟我有什么关系?
关系在选型。把这份报告翻译成选型语言,是三句话。
1「差不多性能」的选项变多了。81.1 对 83.4,总平均分只差 2.8%,但价格差几十倍。如果你的任务不是极限推理,把非关键任务交给高性价比模型,成本曲线会完全不同。
2选型该从「看榜首」改成「看任务形状」。总平均分抹平之后,分项差异才是关键:你的任务是重编码、重指令遵循,还是重数据分析?对着自己任务的形状挑分项强的模型,比盯着第一名更有用。
3别全押一条线。「可媲美」是平均态,不是保证态。双 harness 并存、关键任务留一手,是这半年被反复验证的稳健打法。
一句话:中国模型第一次把「省钱」和「能打」放进了同一个选项里——这是使用者真正的机会窗口。
05
PART
这份报告真正的信号
PART 05
最后说大一点。这份报告最重要的,不是 DeepSeek 排第六,而是「差距」这个东西第一次被数字钉死了。
过去两年,「中美 AI 差距」是个叙事问题:有人说差两年,有人说差三个月,谁都有理。现在它是一张公开榜单上可以复算的两个数字:81.1 对 83.4。
而且这个数字的走势比数值本身更有信息量——年初 15%、5 月 9%、10 月 3%,收窄的动力写得很清楚:中国研究者在国产硬件上做深度优化的能力,正在把「芯片受限」从死结变成工程题。
对做内容的人,这也是一份方法论样本:看榜先问分母(总分还是分项)、问时点(9 月第六还是 10 月第八)、问边界(平均抹平还是处处追平)。三个问题问完,大部分跑分新闻自己就会说话。
写在最后
15%、9%、3%——三个百分比画出的不是一条终点线,是一条还在收窄的进行时曲线。
真正值得盯的下一个数字不在榜单上:是这些高分模型什么时候开始赚钱。性能的仗快打完了,生意的仗才刚开始。
11 月如果出新榜,我来复盘这 3% 是守住了,还是继续往下压。
@AI超级个体日记
数据核对日 2026-10-05 | 3% 为彭博行业研究口径(LiveBench 总分相对差 ≈2.8%);「全球第六」为 9 月时点、10 月初 DataLearner 榜为第 8
信息来自 Bloomberg Intelligence 报告(Robert Lea)、联合早报、The Straits Times、香港经济日报、LiveBench 官网与 DataLearner 榜单;AI 辅助整理,已标注口径
👍 点赞 · 在看 · 转发,三连就是最大支持