ARTICLE · 1134784
AI交出722份数学稿件,这次还附上了验算材料
AI不只在做考试题,也开始提交研究级数学稿件。OpenAI公开了一批内部模型的成果,并附上部分可由计算机检查的证明材料。看点不只是数量,而是哪些结论有证据、哪些仍需数学家审查。
文|最极客
10月6日,OpenAI发布一批内部模型产生的数学研究结果,配套材料放进公开代码仓库。截至本次核查,目录列出722份稿件,按相关性归为372个结果家族。
这里的“家族”不是新的数学概念,而是一种整理方式:同一组研究可能包含主要结果、辅助论证、推论或不同证明。因此,722份稿件不能直接写成“攻克722个独立难题”。
这也不是一款已向所有人开放的新模型发布。官方称,产生结果的是尚未公开的内部模型,相关成果处于不同验证阶段;部分还没有配套的Lean形式化证明,可能存在问题。
先理解:它交的不是普通答案
一道算术题可以让计算器复算,但数学研究经常面对“对所有满足条件的对象,某个结论是否成立”。列出很多正确例子,还不够证明它永远成立。
举个本文自编的简单例子:前面几个数代入公式都成立,并不意味着后面的数一定也成立。证明要说明为什么每个符合条件的情况都被覆盖,而不能只展示已经试过的部分。
AI写出一段流畅推导,也面临同样的问题。它可能省略一个关键条件,或在看似自然的一步里用了尚未证明的结论。这种错误不一定像算错加减法那样醒目。
所以,今天真正值得关注的,是研究稿件与检查材料一起公开。它让外界能从“听公司描述结果”进一步走向“查看具体论证”,但公开本身不是正确性的最终判定。
Lean做什么?让证明接受规则检查
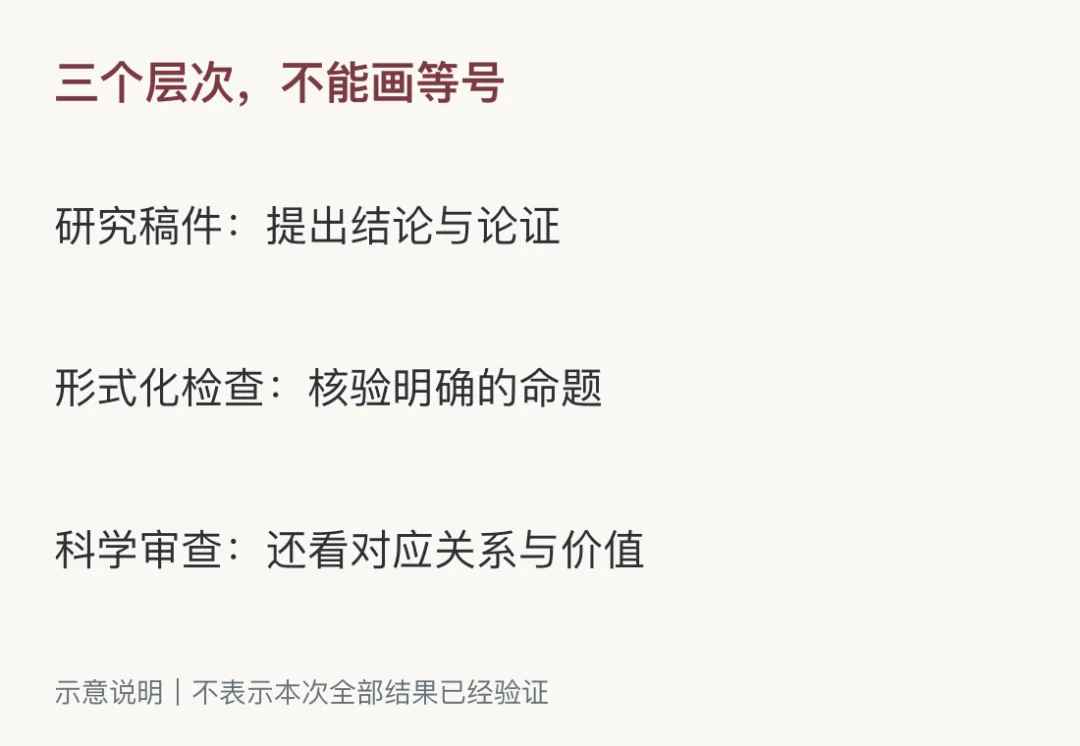
Lean是一种编程语言和证明助手。可以把它理解成一个严格的逻辑检查工具:人或AI把定义、前提和推理写成规定的形式,再由程序检查这些步骤能否成立。
这与让另一个聊天机器人说“我觉得证明没问题”不同。后者仍然是在生成判断;形式化检查要求论证能够遵守明确的推理规则。
不过,程序检查的是写进系统的命题。假如原本想证明“所有情况”,实际输入时却多加了一个限制条件,即便形式化证明通过,也不能说更宽泛的原命题得到证明。
用生活化比喻来说,解答本身要对,题目也不能被悄悄换掉。审核者需要对照自然语言稿件与形式化陈述,确认两者讲的是同一件事。
OpenAI仓库提供了形式化目录和额外检查说明。它们是进一步核验的入口,不是让读者只看一张“通过”截图就相信全部结果。本文核对的是公开说明与材料结构,没有在本地复验整批数学证明。
数量大,仍然不能直接算成功率
按仓库说明,评估过程中模型接触了约4000个问题,最终材料又经过整理和重要性筛选。问题、稿件和结果家族不是同一种计数单位,不能拿722除以4000,就宣称得到模型解题成功率。
一个问题可能衍生多份稿件,相关结果也可能被归到一组。想比较不同模型,需要知道题目选择、尝试次数、使用资源和验收标准是否一致。
官方还公开了10份推理摘要,并用ChatGPT Pro思考量来描述计算投入。这是资源量的参照,不等于普通用户打开聊天框就能按同样速度复现,也不能当成研究人员的实测工作时间。
对于非专业读者,不必急着记住每个猜想的名字。先问三个问题更有帮助:材料是否公开?这项结果验证到哪一步?后来有没有修订或独立检查?
对科研的价值,在于能否成为可靠积木
数学研究的一条结论,常常会成为下一条结论的前提。如果能够生成并核验更多有用的辅助结果,研究人员就可能把精力放在更重要的结构和联系上。
但这只是潜在价值,不是本次发布已经证明的工作效率提升。大量稿件也意味着需要投入阅读、核对、解释和整理;产生候选证明与真正理解其意义,是不同的工作。
OpenAI表示会保留公开版本历史,用新版本记录修订。这一点很重要:严肃研究应允许纠错,也应让读者知道自己引用的是哪一版。
眼下最稳妥的结论不是“数学已被AI解决”,而是AI辅助研究正交出规模更大、可供检查的材料。接下来值得看的是具体结果怎样经受核验,又能否被其他研究者真正用起来。