ARTICLE · 1136985
OpenAI为API引入文本水洗功能:与Anthropic不同,默认处于关闭状态
OpenAI为其API推出了名为textGrain的新文本水印系统,允许开发者自主选择是否开启。与Anthropic的全局默认开启策略不同,OpenAI采取了默认关闭的灵活性方案,以满足欧盟AI法案等透明度要求,同时该技术在代码和短文本识别上面临一定局限性。
译自:OpenAI brings text watermarking to its API -- and unlike Anthropic, it's off by default[1]
作者:Paul Sawers
OpenAI 宣布开发者现在可以自主选择为其 API 生成的文本启用水印,这是该公司将其现有的内容溯源工作扩展到更难可靠识别的 AI 输出形式之一。
在周一发布的博客文章[2]中,该公司详细介绍了一个名为 textGrain 的新系统。该系统通过微妙地影响模型所选择的词语——例如,在句子中任何一个词都说得通时偏爱某个合适的词——将“统计信号”嵌入到生成的文本中。经过足够长的段落后,这些选择会形成一个 OpenAI 的检测器能够识别的模式。
全球的 API 客户从今天开始可以在受支持的模型上启用水印,OpenAI 表示,在未来几周内,它将开始自动为欧盟(EU)境内 ChatGPT 和 Codex 产生的符合条件的文本添加水印。这是为了响应欧盟人工智能法案[3]下的新透明度要求。
该公司写道:“从今天开始,全球的 API 客户将能够为部分模型自主选择文本水印。在 API 中,文本水印默认保持关闭状态。”“这让客户能够决定水印如何契合他们的透明度义务以及他们向用户提供的体验。”
“在 API 中,文本水印默认保持关闭状态。这让客户能够决定水印如何契合他们的透明度义务以及他们向用户提供的体验。”
OpenAI 与 Anthropic 的不同方法
值得注意的是,OpenAI 的方法与 Anthropic 在8月宣布为 Claude 推出文本水印[4]时概述的方法有所不同。Anthropic 表示,它将在全球范围内将其支持的 Claude 模型应用水印,并解释说它尚无可靠的方法来按地区限制该技术。该水印还延伸至通过其 API 使用 Claude 的开发者,以及 Claude 和 Claude Code 等其他产品。
Anthropic 没有为 API 开发者描述相应的自主关闭选项,这使得开发者对他们的模型输出是否带有水印的控制权较少。
该公司在其文档中确认[5]:“水印将应用在模型层面,这意味着无论文本来自哪个 Claude 产品或界面,它都会存在。”
对于确实希望使用水印的 OpenAI API 客户来说,它可以在项目或组织级别激活,客户能够选择哪些支持的模型应该使用它。该公司表示,一旦启用,无需对单个 API 请求进行任何更改。
OpenAI 的溯源记录
OpenAI 已经将几种溯源技术用于其他类型生成的内容。早在 2024 年,它开始向[6]生成图像中添加内容凭证(Content Credentials),使用由内容溯源和真实性联盟(C2PA)开发的开放标准来记录有关文件来源和历史的信息。
它后来在[7] 2026 年 5 月将谷歌的 SynthID 水印添加到支持的图像中,7 月添加到音频中,现在提供了一个内容溯源 API[8] 用于检查支持的图像和音频中是否存在这些信号。
OpenAI 完全可以使用现有的文本水印技术(例如 SynthID),而 Meta 也开发了自己的 TextSeal[9] 方法。在其常见问题解答[10]页面上,OpenAI 表示开发 textGrain 是为了让其“对水印可检测性与同一提示生成的响应多样性之间的平衡有更多控制……”。事实上,它表示在测试中 textGrain 匹配或超过了 SynthID 的检测性能,并计划将该技术开源,以便“其他人可以在其上进行构建并帮助改进文本水印”。
“代码也更难加水印”:信号减弱的地方
然而,这项技术也有一些局限性。由于 textGrain 通过模型在合适词语之间做出的选择来产生信号,当可供选择的词语较少时,检测就会变得更加困难。
OpenAI 表示,在心理学等领域,其检测器在目标误报率为 1% 的情况下,可以捕捉到大约 80% 带有水印的 200 Token 段落,以及 95% 的 400 Token 段落。对于数学等受更多限制的材料,检测率较低。
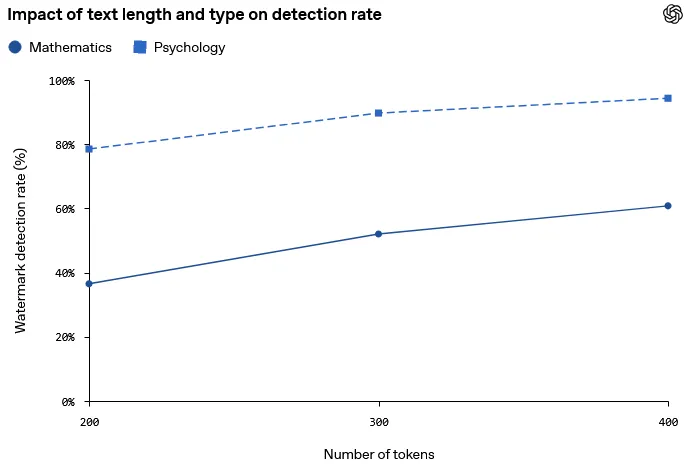
文本长度和类型对检测率的影响(来源:OpenAI)
编辑输出也会大大削弱信号。在 OpenAI 的测试中,用同义词替换 400 Token 段落中 10% 的单词,其检测率从 92% 左右降至 66%。替换 25% 则将其降至仅 17%。
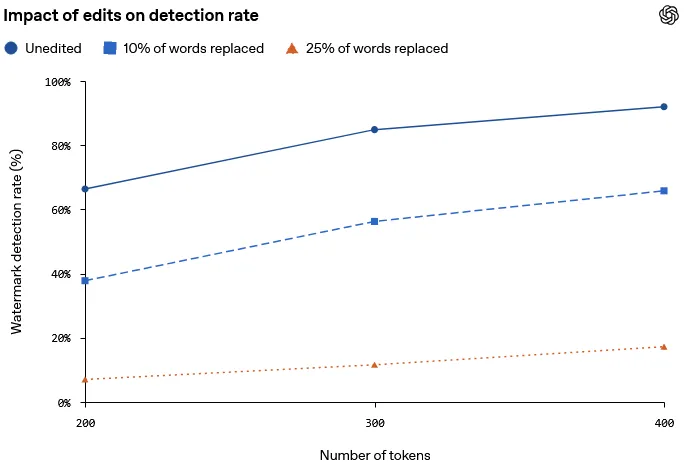
编辑对检测率的影响(来源:OpenAI)
值得注意的是,OpenAI 警告称,较短的段落可能包含太少的内容,导致其检测器无法可靠地识别水印。
该公司补充说:“代码也更难加水印,因为与普通散文相比,接下来的内容合理的选择更少。”
“代码也更难加水印,因为与普通散文相比,接下来的内容合理的选择更少。”
这使得即将推出的 Codex 推广值得关注。OpenAI 计划在欧盟自动为符合条件的 Codex 文本输出加水印,同时也承认源代码本身特别难以加水印。该公司尚未准确解释其所指的“符合条件”的 Codex 输出是什么意思,或者水印是否会应用于生成的代码本身。
正如 The New Stack此前报道的那样[11],Anthropic 在 Claude 方面也遇到了类似局限性。代码赋予其水印系统的机会较少,无法在不改变程序运行方式的情况下嵌入信号,尽管代码中的自然语言文本(例如注释)更容易添加水印。
还有一个问题是,引入这些 Token 偏好是否会影响生成代码的质量。OpenAI 在多个编码和智能体基准(包括 DeepSWE、AutomationBench 和 Terminal-Bench)上测试了带水印和不带水印的 Astra 模型,并表示发现在性能上没有显著差异。这表明启用 textGrain 不会严重损害编码能力,尽管它并没有告诉我们随后如何可靠地识别生成的代码带有水印。
访问检测器完全是另一回事。选择加入 textGrain 的 API 客户并不能自动获得检测其水印的能力,OpenAI 表示其最初将检测器的访问权限限制在研究文本溯源和检测可靠性等领域的经批准的研究和学术机构。例如,此类访问可以允许研究人员检查水印在编辑和其他转换下的可靠存活情况,或者调查检测器产生误报或漏掉带水印文本的情况。
The New Stack 已向 OpenAI 询问有关构成符合条件的 Codex 输出的更多详细信息,以及它是否有特定于代码的检测率。如果我们得到回复,将在此处更新。
引用链接
[1] OpenAI brings text watermarking to its API -- and unlike Anthropic, it's off by default: https://thenewstack.io/openai-api-text-watermarking/[2] 周一发布的博客文章: https://openai.com/index/eu-text-provenance/[3] 欧盟人工智能法案: https://artificialintelligenceact.eu/article/50/[4] 8月宣布为 Claude 推出文本水印: https://thenewstack.io/anthropic-claude-text-watermark/[5] 在其文档中确认: https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content[6] 开始向: https://openai.com/index/understanding-the-source-of-what-we-see-and-hear-online/[7] 后来在: https://openai.com/index/advancing-content-provenance/[8] 内容溯源 API: https://developers.openai.com/api/docs/guides/content-provenance[9] TextSeal: https://github.com/facebookresearch/textseal[10] 常见问题解答: https://help.openai.com/en/articles/8912793-provenance-signals-in-openai-generated-content[11] 此前报道的那样: https://thenewstack.io/fable-5-1-watermark/