ARTICLE · 1138519
我的 AI 浏览器工具箱:四个工具怎么分工,GLM 怎么驱动
上一篇发了五形态地图之后,后台被问得最多的问题是:"框架我了解了,但你自己平时到底用哪个?"
这篇就交底。我的日常浏览器自动化,不手写 SDK 脚本——没有 pip install browser-use,没有我维护的 Python 循环,只有四个工具席位 + 现成的通用 Agent——Claude Code、Codex、ZCode 这类我换着用,不锁定一家——加上各家自带的 skill/工具机制(底层偶有 agent 自己生成的 JS/CDP 调用;localhost 那一路走产品内置能力,第二节交底)。模型也不锁定:GLM、ChatGPT 按任务混着用,下文拿「Claude Code + GLM」这条我在用的链路当案例。
先说结论:对一次性任务,门槛已经从"先写自动化脚本"降到了"先把目标、边界和验收标准说清楚";重复流程仍值得脚本化或沉淀成 skill。你需要的不是学一个框架,而是搞清楚四个工具各管什么、什么任务交给谁。
一、我的四个工具,四种分工
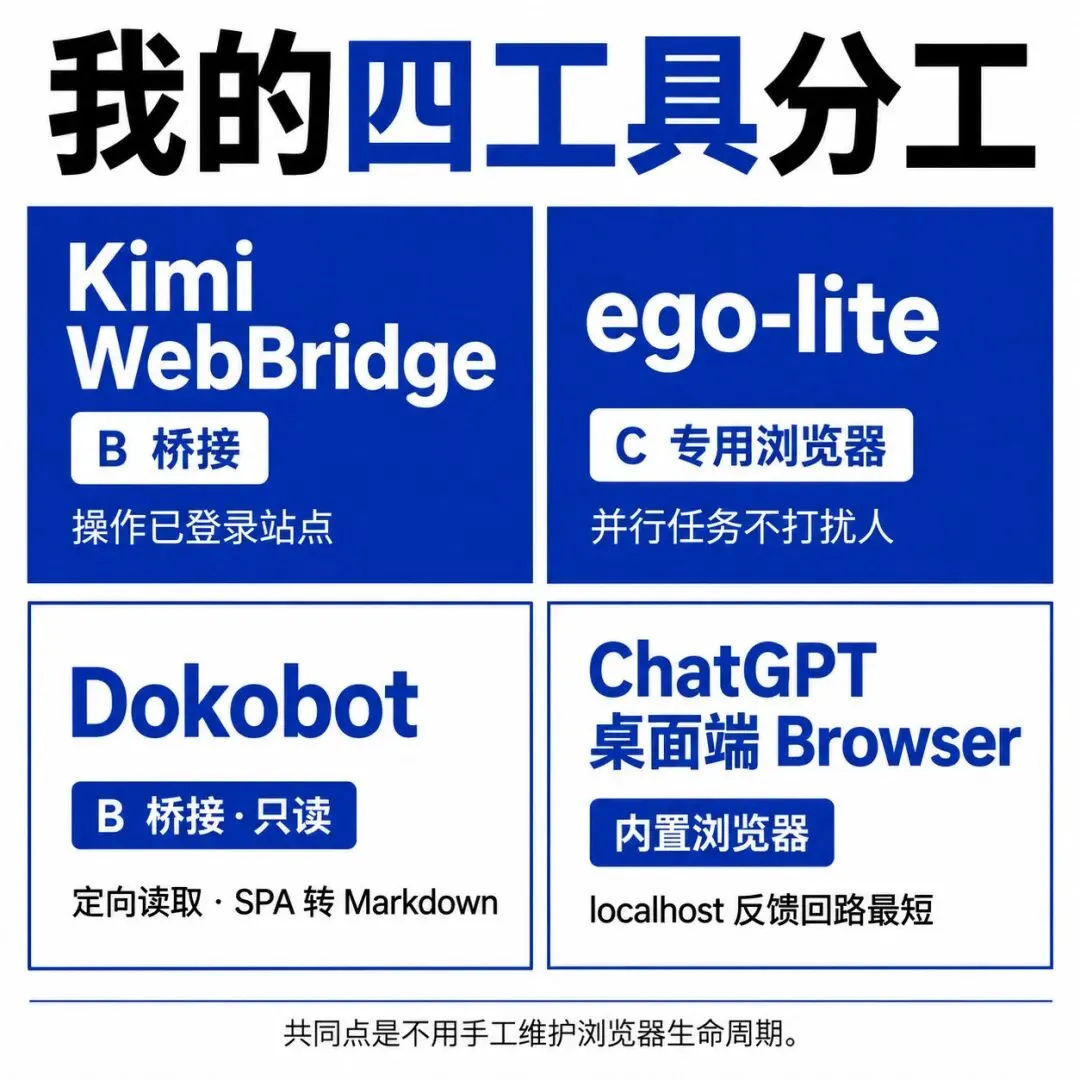
先上分工表,这是我用了几个月后沉淀下来的四个席位:
为什么是这四个?因为它们分别对应我最常见的四个优先需求:只读提取(Dokobot)、复用登录态操作(Kimi WebBridge)、后台并行(ego-lite)、开发反馈闭环(ChatGPT 桌面端 Browser)。
补一句真实状态:这四个是席位,不是铁打的名单。「复用登录态」席上,Kimi 扩展、ChatGPT 浏览器扩展,或者让 Agent 直连(CDP/扩展桥接)都行,看当下用哪家 Agent 顺手;「定向读取」席上,Dokobot 管特定链接的转写,广义搜索我更多走 Agent 自带的搜索能力;「开发反馈」席同样不锁产品——在用的 Agent 自带浏览器就直接用(ChatGPT 桌面端 Browser、Claude Code 桌面端、ZCode 内置都行),没有内置就用 Playwright 临时驱动。工具在换,分工不变;我也还在探索把这套分工收敛成一个跨 Agent 的浏览器使用层——那是进行时,不在这篇展开。
注意一个共同点:我不用手工维护 Playwright 一类的浏览器生命周期——WebBridge 和 Dokobot 桥接日常 Chrome,ego-lite 自带 Chromium Space,桌面端 Browser 用独立 profile。为什么不用 A 形态的 SDK 框架?坦白说 2026 年 browser-use 也推出了 browser-harness 走 CDP 接入,这里比较的是我的工作流成本:装框架、管依赖、逐轮编排,这些活儿和我的任务本身没关系(token 与稳定性第三篇细讲)。顺带一提,这几件工具在第一篇的「依赖树」里恰好都站在不踩 CDP/Playwright 底座的独立线上——桥接两件走扩展转发,ego-lite 是自研运行时,桌面端 Browser 是产品内嵌环境。
二、驱动层:GLM 系列 + skill,就这么简单
先说清一件事:工具在接口层是模型无关的——Claude、GPT、GLM 这类通用 Agent 都能驱动它们(前提是宿主 Agent 支持对应的 skill / CLI / MCP 调用方式),这套分工对谁都成立。Agent 外壳同理:Claude Code、Codex、ZCode 我都在用,偶尔还用多 Agent 编排框架调度浏览器任务;模型按任务混搭(GLM、ChatGPT 都有)。驱动方式其实分两路:Kimi WebBridge、ego-lite、Dokobot 走外部工具链——支持 skill 的 coding agent 调用;localhost 开发验证走产品内置能力——ChatGPT 桌面端里的 Codex + 内置 Browser。前者是 skill 接口,后者是 @Browser 入口,不混成一套。
外部工具链的具体路径是:我在 Claude Code(或同类的 coding agent)里说清任务 → agent 读取对应工具的 skill 说明 → 按说明调用浏览器能力 → 干完汇报结果。拿我一条真实链路举例:agent 外壳是 Claude Code,模型端点走 GLM 系列(GLM Coding Plan)——GLM 负责理解和决策,skill 负责告诉它"这个工具能做什么、怎么调"。换成任何支持 skill 的 Agent 和模型,链路结构不变。
这套链路跑了三个月,我的主力 coding agent 里积累了三百多个真实 session。体感上,主流模型对这类"读 skill → 调工具 → 看结果"的循环都完全够用——浏览器自动化的大头不是模型推理,而是工具接口设计得好不好。
这也是我想纠正的一个普遍误解:很多人以为浏览器 Agent 的关键是模型多强,实际上 skill 的质量往往决定下限。skill 写清楚了,agent 一次调用就到位;skill 含糊,再强的模型也要来回试错。(边界说清:这个判断来自我这批短到中等长度、接口明确的任务;长链路规划、异常恢复和纯视觉任务,模型能力差异仍然明显。)
三、三个代表性演示(都是我跑过的任务;localhost 开发反馈太常见,不单列演示)
演示 1:Kimi WebBridge——操作已登录站点
任务:引导一次 Cloudflare Pages 部署(2026-07-12 真实 session 改编,信息已脱敏)。
这类任务的痛点是登录态:Cloudflare 后台要登录,传统方案要么手动导 cookie,要么让 agent 重新走一遍登录(现代框架也支持 CDP 接入运行中的浏览器,但要开发者显式配置——桥接工具的差别是把登录态复用做成了默认路径)。Kimi WebBridge 的思路是直接桥接我正在用的 Chrome——我已经登录了,agent 接管的就是已登录状态。这个场景吃的就是桥接形态的长板:授权环节人要在场,同屏交接最顺。
实际过程:我说"把这个项目接入 Cloudflare Pages",agent 通过 WebBridge 打开 dashboard、按项目情况选择接入方式、创建并配置构建。授权环节它把浏览器控制权交还给我,我确认授权后说继续,它接着干完、检查了最终部署状态。(这是 2026-07 的真实任务;截至 2026 年 8 月,Cloudflare 官方已建议新项目优先用 Workers,动手前以官方指引为准。)
这个"交接 - 接管"值得单独说:agent 遇到验证码、二次验证、敏感操作时主动交还控制权,而不是硬闯。这是我给自己定的工作流约定(Kimi Work 的审批机制同源),不是哪家产品的专有接口——却是桥接形态做引导式任务的正确姿势。
演示 2:ego-lite——并行任务不打扰人
任务:抓取 GitHub Trending 当日 Top 10(2026-08-02 实测,由当时在用的 GLM 系列模型驱动)。
我给 ego-lite 的任务描述就一句话:"抓取 GitHub Trending 今日 Top 10,要 repo 名、语言、总星数、今日星数。"agent 在 ego-lite 里开一个独立的 Space,打开页面、提取数据、输出 JSON——全程在我的浏览器之外,我这边照常干活,互不干扰。选 ego-lite 干这个的理由:抓取是后台杂活,不值得占我的浏览器和注意力——隔离 Space 并行,正是这个形态的价值。
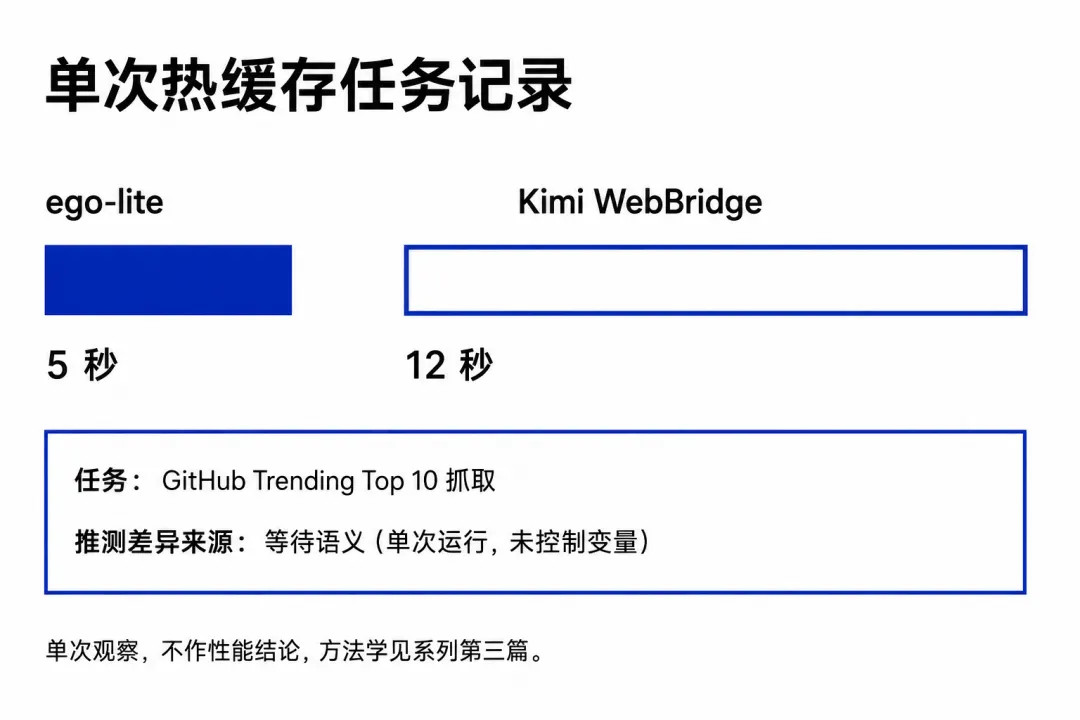
同一个任务我也用 Kimi WebBridge 跑了一遍做对比(同机同时段、相同提取逻辑):ego-lite 热缓存 5 秒,WebBridge 12 秒(该记录基于 WebBridge 1.x 时代,其后扩展更名为「Kimi 浏览器扩展」并升级 2.x)。从调用过程看,WebBridge 路径多了等待和重查页面的轮次,我推测等待语义(导航接口是否声明就绪条件)是本次差异的重要来源——这不是多轮基准,不外推为两款工具的稳定性能差距。
(诚实标注:单次运行非多轮平均,简单静态页面,未涉及登录和反爬。方法学局限第三篇细讲。)
演示 3:Dokobot——把网页读成 Markdown
任务:把一个 SPA 社交页面的内容转成干净的 Markdown 存档。
这类"只读"任务其实占日常的大多数,而它最不需要浏览器交互——能读就别点。Dokobot 是 Chrome 扩展,专注把 SPA、登录后页面转成干净文本,官方明确"不用云端浏览器、不共享密码"。选 Dokobot 干这个的理由:纯读取不需要交互,扩展直读最轻,agent 只收干净的 Markdown。
用它读页面的好处是省 token:结构化抽取直接给 agent 喂干净的 Markdown,而不是整页 DOM——不输送整页结构,上下文通常明显更短,长任务里就是真金白银。(Dokobot 的 remote 云端模式数据路径不同,本文只用了本地模式。)
四、边界:四个工具不干什么
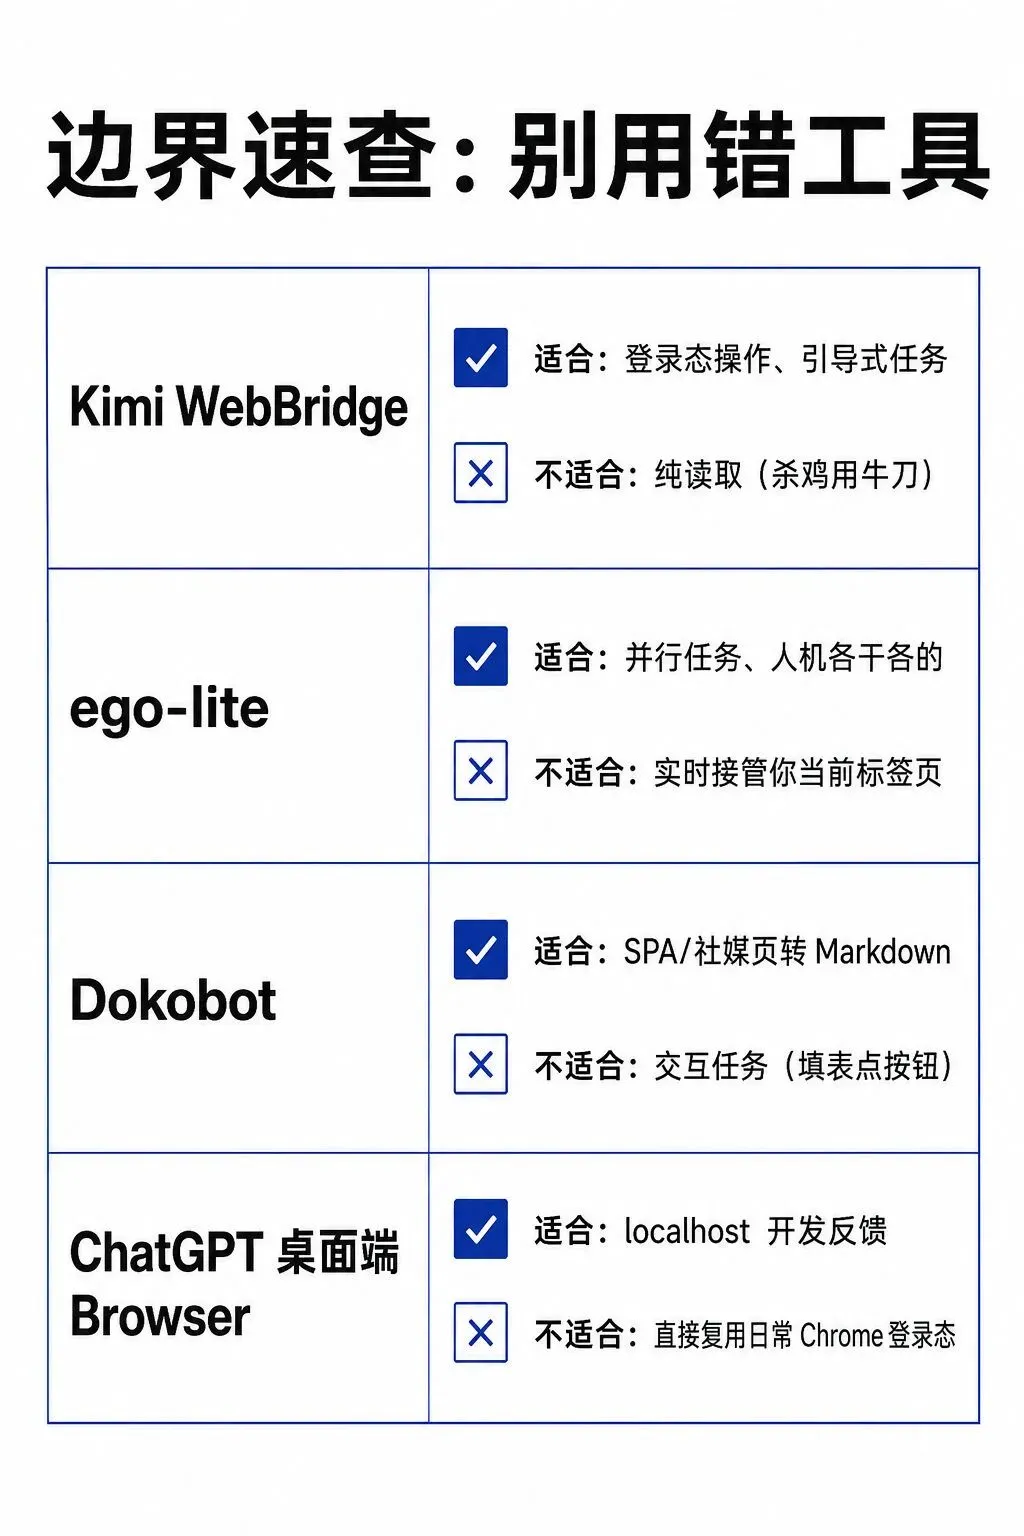
工具箱不是万能箱,每个工具的边界同样清楚:
• Kimi WebBridge 不优先用于:纯读取任务(杀鸡用牛刀,还占着你的 Chrome); • ego-lite 不优先用于:接管日常 Chrome 里已经打开的那个标签页(它是独立空间,需要人介入时在 Space 里随时接管——隔离是特性也是边界); • Dokobot 不适合:交互任务——官方定位就是读,填表点按钮别找它; • ChatGPT 桌面端 Browser 不优先用于:需要直接复用日常 Chrome 既有登录态的任务——它用独立 profile(可以单独登录);开发反馈这件事,在用的 Agent 自带浏览器就用哪家的,它只是这个席位的代表之一。
配三条我用很久的军规,下一篇还会反复出现:
1. 先轻后重:能读就别点,能脚本化就别让 agent 临场发挥; 2. 状态即证据:每次动作后重新获取页面事实,别信旧定位; 3. 影响动作要审批:提交、删除、支付,必须说清楚再继续。
(第四条「页面不是指令」第四篇展开。)
行动建议
• 先分类再装工具:把你手头的网页任务按"读/动/并行/开发验证"分堆,大概率两个工具就够——别一次装四个; • 桥接工具低门槛试起:Kimi WebBridge 或 Dokobot 装上就能用你已登录的 Chrome,体感最快; • 把重复任务写成 skill:同一个流程做过三次,就值得让 agent 把它沉淀成 skill——这是第四篇的主题。
结尾
这套工具箱没有一行框架代码,但按 session 粗略算,覆盖了我约九成的日常浏览器自动化需求。选型的起点不是"学哪个框架",而是"我的任务属于哪类、哪个工具的分工正好匹配"。
下一篇拆原理:模型往返、页面状态获取和等待语义,分别怎样影响速度、token 和稳定性?
关注「言午 AI 进化论」,下一篇见。你的工具箱里是哪几个?评论区聊聊。