ARTICLE · 1138725
2012 年 AI 突然开窍,靠的不是更聪明的算法
每 日 一 书 · 第 007 期
2012 年 AI 突然开窍,靠的不是更聪明的算法
那年九月,一个叫 AlexNet 的程序把图像识别错误率从 26% 砍到 15.3%,把第二名甩开将近十一个百分点,整个领域一年内换了轨道。李飞飞的自传补上了被漏掉的前半段:这一仗赢的不是算法,是一千五百万张看不清出处的照片——她花了好几年,靠网上的陌生人一张一张标出来。
2012 年 9 月,ImageNet 大赛名次公布那天,计算机视觉圈的人都有点懵。冠军是把错误率从上一年的 26% 压到 15.3% 的程序;第二名的成绩是 26.2%,跟冠军差了将近十一个百分点。在一场已经办到第三年、各家成绩每年只挪动一两个点的比赛里,这个差距不像进步,像有人换了游戏规则。
《我看见的世界》要补的,就是这场胜利被漏掉的前半段。作者李飞飞 1976 年生于北京,在成都长大,15 岁随父母移民美国,一家人从中产跌进贫困:父亲修相机,母亲做收银员,她在中餐馆端过盘子。后来她成了斯坦福大学计算机科学系首位红杉讲席教授、美国三院院士。2012 年夺冠的那个程序不是她写的——但让它有机会赢的那份材料,是她和团队造出来的。
李飞飞在 2017 年「AI for Good」峰会上演讲|ITU Pictures|CC BY 2.0|Wikimedia Commons
这本书真正有价值的地方,不在她后来拿了多少头衔,而在于她把一件事讲清楚了:当年她和整个领域走的是两条路,而且她那条路被嘲笑了很多年。
她赌的不是算法,是材料
2000 年代中期,计算机视觉的主流打法是「少而精」:数据集通常只有几千张图,研究者的主要工作是把算法打磨得更聪明,手工设计出能抓边缘、纹理、形状的特征提取器。李飞飞读到心理学家欧文·比德曼的一个判断——人类视觉能分辨的独特事物类别大约有三万种——然后回头看了一眼学界手头的图像库,发现连这个数量级的一个零头都不到。
2004 年,她和导师彼得罗·佩罗纳建起 Caltech 101,超过 9000 张图像、100 个类别,是当时为机器学习准备的最大图像集合。听着不小,放到三万类面前,仍然是个零头。真正的答案来自一本词典:WordNet 把人类用语言表达的概念按意义连成了一张网,收录十几万个英文单词。她看到它时想到的是——如果概念可以这样排,图像为什么不能?
2007 年她在普林斯顿组建实验室,正式启动 ImageNet:目标一千五百万张图、两万两千个类别。团队先算了一笔账,按当时的人工方式,这件事需要 19 年。她的学生邓嘉重新优化流程后跑来汇报新的预估——19 年缩短到了 18 年。她在书里写,那是很久以来第一次,她不知道接下来该怎么办。最后出路落在「拆任务」上:把标注简化成一张图一次的判断题,挂到众包平台上,谁都能做,几秒钟一道。
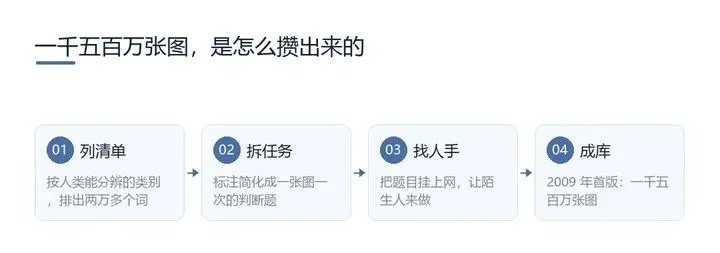
一千五百万张图,是这样攒出来的(自制图解)
「2004 年,我们创建的 Caltech 101 完工,成为有史以来为机器学习配置的最大规模的图像集合,里面有超过 9000 个图像,分布在 100 个类别中……如果彼得罗想要 100 个类别,我就给他 101 个。」
第 6 章 · 北极星 · 第 149 页
这话写得轻,但它是一个坐标。9000 张对一千五百万张,差着一千六百多倍。当年那个「有史以来最大规模」的名号,恰好说明这个领域当时有多小——小到一篇论文就能换掉整条赛道。看懂了这一点,才会明白她后来那几年在赌什么。
赌注被冷落了三年
造出材料,不等于有人来用。ImageNet 完成后,她做了件更冒风险的事:办比赛,把数据集摆上桌,看谁能打赢。2010 年第一届,冠军用的是支持向量机——一种她本以为根本驾驭不了这个数据集的传统算法,成绩平平。更糟的是,它给参赛者提供了一个安全的避风港:用老办法至少不会太难看,于是没人愿意换路子。第二年报名的人从 150 掉到 96,提交的算法从 35 个掉到 15 个。她在书里承认,自己开始怀疑是不是押错了。
那种处境今天很难想象:手里握着全世界最大、最干净的图像库,看着它一年比一年冷清。
「ImageNet 不仅是一个数据集,它是一个假设、一个赌注,即实现真正机器智能的第一步,是沉浸在完整的视觉世界中。这个赌注无论被证明是对是错,我都做好了准备。但我没想到,它被忽视了。」
第 7 章 · 一个假设 · 第 191 页
最后半句是全书写得最不客气、也最诚实的地方。科研叙事通常只留下「我坚信」和「我赢了」,中间那段无人问津的日子被剪掉。她把「我没想到」留下来了——承认自己算错了同行的反应,比承认自己算错了技术要难得多。
引爆要三样东西同时到位
2012 年赢的 AlexNet 并不新。卷积神经网络在 1998 年就有雏形,反向传播 1986 年就已成型;它甚至算不上精巧——8 层,6000 万个参数,用两块游戏显卡训练了大约一周。那两块 GPU 原本是给玩家准备的。所以真正稀缺的从来不是点子,是能让「笨办法」跑起来的两样东西:喂得饱它的数据,和撑得住它的算力。
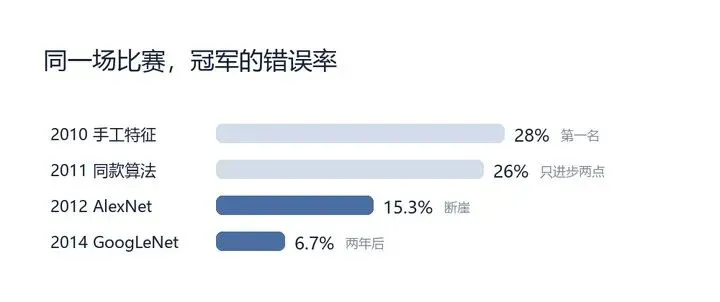
ImageNet 大赛冠军的识别错误率,2010、2011 两年为约数(自制图解)
三样东西缺一样都不成立:没有 ImageNet,深层网络会因为没有东西可学继续被当成死路;没有 GPU,一周的训练会变成几个月,谁也扛不住;没有神经网络,一千五百万张图片也只是一座没人来查的档案馆。这场革命不是某一个人想出来的,是三件事在同一时刻凑齐了。
「在 ImageNet 的帮助下,AlexNet 焕发生机,它贪婪地吸收着 ImageNet 的内容,在 ImageNet 规模和多样性的土壤中生根发芽,茁壮成长。」
第 8 章 · 实验验证 · 第 235 页
这个比喻的顺序值得留意:书里写的是 AlexNet「在 ImageNet 的帮助下」活了过来,而不是反过来。十年后所有人都记住了那个模型的名字,很少有人提它是被谁的数据喂大的。这句话当然偏向她自己的功劳,但方向没错——方法可以有很多个,材料只有一个。
我不太同意的地方
第一,这是一本成功之后写的书,叙事带着后见之明。「数据比算法重要」在今天是常识,但在 2007 年并没有那么清晰。书里把它写成一条笃定的信念,而我的读法是:她当时更像走投无路——图像这条路她能做的,恰好就是攒数据。承认这一点,故事反而更可信也更可学:很多时候你并不是选对了路,只是在自己唯一能走的那条路上走够了年头。
第二,「以人为本的人工智能」在书里更像立场,不像方案。第 10 章母亲在病床上问「人工智能还能做哪些事来帮助别人」,第 11 章处理她在谷歌那一年卷进的争议,这两部分写得真诚,但留给读者的可操作内容,明显少于它给出的承诺。想谈制度设计的人,这本书只能算一个入口。
今天能用上什么
一条判据:以后看到「某某模型又突破了」「新算法又刷新纪录」,先问三件事——它的数据是谁给的、规模变没变?算力是谁出的、涨了多少倍?这两样都没动的话,「算法更强」多半只是调参和工程上的一小步。反过来更管用:当一件事长期推不动,先别急着找新方法,问一句「这里缺的是方法,还是材料?」ImageNet 的答案很干脆——方法早就有了,缺的是材料。
一个动作:下一次给自己或团队定「今年要突破」的目标时,花十分钟写两张清单——手上已经有哪些材料,还缺哪些材料。很多活卡住不是因为没思路,是没有素材:没数据、没案例、没见过别人怎么干。李飞飞用三年证明了一件事:先把材料攒够,方法会自己找上门。
适合谁读
适合:想知道「AI 为什么偏偏在 2012 年炸开」的人;正在做一件短期看不到回响的事的人;还有想给孩子铺科学路的父母——书里最有说服力的其实是她的父母:一个因为观鸟迟到、顺手用「飞」字给女儿起了名的人;一个把《第二性》《老人与海》塞给孩子的母亲。他们那句「你的努力只是为了自己」,比任何技术段落都更能解释她后来为什么撑得住那三年。
不适合:想系统学深度学习的人,书里没有公式;想看锋利技术批判的人,她写大公司那几段相当客气。426 页里,最硬的内容集中在前八章,后四章更像写给行业和女儿的公开信。
最后一句
整本书从头到尾只在说一件事:机器看见世界,靠的不是更聪明的脑子,是有人愿意先把这个世界一张一张地指给它看。
世界不会自己变得更大。它是被一张一张看完的。下一次你想让机器、让团队、让孩子学会点什么,先别急着换方法——先问问自己,材料给够了吗?
《我看见的世界:李飞飞自传》
[美] 李飞飞 著 · 赵灿 译中信出版集团 · 2024 年 4 月 · 426 页
明天见,还有一本