ARTICLE · 1151351
Skill 机制全景解析 - Pi 源码分析 07
本文是「Pi 源码剖析」系列的第七篇,本文系统剖析 Pi 的 Skill(技能)机制:从“SOP 口袋小册子”心智模型出发,深入源码逐行还原多源目录发现、六级优先级仲裁、Frontmatter 元数据校验与内存优化,并透视“模型自主 JIT 读取”与“用户显式展开”的双轨运行与上下文生命周期。
一、先建立心智模型:Skill 是一本外部化的“SOP 口袋小册子”
1. 痛点:上下文过载与“注意力迷失”(Lost in the Middle)
在 Agent 开发中,开发者最容易犯的一个直觉性错误,是试图把所有可能用到的规约、文档和最佳实践,一股脑塞进 System Prompt。
这种做法会带来三大严重弊端:
1. Token 成本飙升:即使用户只是打个招呼或者问一个简单问题,每一次与模型的对话都要为这数万字静态知识全额付费; 2. 注意力分散与性能下降:大模型的长文本注意力分布存在“迷失在中间(Lost in the Middle)”的固有缺陷,过多无关规约会直接稀释模型对用户核心意图的关注度; 3. 系统臃肿且难以维护:不同工程、不同团队对特定任务的规范各不相同,硬编码在 System Prompt 里的知识无法根据项目灵活挂载与卸载。
2. 类比:口袋索引卡与案头工具书
在现实生活中,一个资深运维专家或全栈工程师绝不会在脑子里背诵几百页的全部命令手册。相反,他的工作方式是:
• 口袋里装一张轻量索引卡:上面只写着几行字:“遇到 PDF 数据抽取,翻看《PDF 操作 SOP》;遇到微服务部署,翻看《K8s 交付手册》”; • 书架上分门别类摆放小册子:每本小册子内部包含具体的执行步骤、参考模板和辅助脚本; • 按需索骥(Just-In-Time):接到具体任务时,看一眼索引卡,发现命中匹配项,再把对应的小册子从书架上拿下来仔细阅读并依此操作。
在 Pi 中,Skill(技能)就是这套外部化、按需加载的 SOP 小册子体系。Pi 实现了开放的 Agent Skills 规范(agentskills.io),其核心心智模型非常简洁:
• 启动时只交出目录:Pi 仅把各技能的“名称、路由描述和文件物理路径”作为极简列表交给模型; • 执行时由模型自主翻书:模型通过对比当前任务与各技能的描述,一旦确认需要,便主动调用内置的 read工具读取SKILL.md的详细内容进入上下文;• 用完即走,按需供给:不触发的技能永远不占上下文,彻底将“海量专业能力”与“精简上下文窗口”两者的矛盾解耦。
3. 三大扩展机制边界辨析:Skill vs Extension vs Prompt Template
Pi 提供了三套能力扩展手段,初学者常因分不清使用场景而产生混淆:
| Prompt Template | *.md) | /name 显式调用) | ||
| Skill | SKILL.md + 附属脚本/资产 | 模型自主 JIT 感知/skill:name) | ||
| Extension |
一句话辨析:Extension 解决的是“能不能做”(增加新可执行能力与工具),Skill 解决的是“怎么做好”(指导模型如何正确运用工具与规范),Prompt Template 解决的是“怎么省事”(人类快速发起固定指令)。
二、Skill 的规范定义与物理结构
1. 物理目录布局
一个标准的 Skill 是一个独立的目录,其根节点必须存在一份名为 SKILL.md 的入口说明文件:
d2-diagram/├── SKILL.md # 核心规约入口(包含 YAML Frontmatter 与核心指示)├── scripts/ # 配套自动化脚本(如编译、转换、校验脚本)│ └── render.sh├── references/ # 详细参考手册(如语法备忘、API 字典)│ └── syntax-cheat.md└── assets/ # 预置模板或静态资产 └── template.d2技能内部若需要引用同目录下的附属文件,一律使用相对路径(如 references/syntax-cheat.md)。Pi 在将技能告知模型时,会明确注明该技能所在的基准绝对路径(baseDir),使模型能够准确地基于此路径调用工具定位资源。
2. YAML Frontmatter 元数据规约与校验
SKILL.md 的头部必须以 --- 包裹的标准 YAML Frontmatter 开头。Pi 在读取文件时会进行严格提取与安全校验:
---name: d2-diagramdescription: 使用 D2 声明式绘图语言生成高质量软件架构图、时序图与数据流图。当用户需要画图或替换 ASCII 图时使用。disable-model-invocation: false---# D2 绘图指南...正文说明...在源码 packages/coding-agent/src/core/skills.ts 中,核心字段的提取与校验逻辑如下:
1. name(技能名称):• 提取逻辑:优先采用 Frontmatter 中的 name;若未显式声明,则自动回退为当前技能所在的父目录名称(由loadSkillFromFile函数处理)。• 命名规则( validateName函数校验):长度不得超过 64 个字符;仅允许小写字母a-z、数字0-9和连字符-;首尾禁止为-;严禁包含连续两个连字符--。2. description(路由描述,核心必填):• 提取逻辑:必须为非空字符串,长度不得超过 1024 个字符(由 validateDescription函数校验)。• 红线机制:如果缺失 description或其内容为空白字符,Pi 会直接将该技能判定为无效并放弃加载。因为模型完全依靠这段描述来决策是否启用该技能,失去描述的技能在系统内部将毫无路由价值。3. disable-model-invocation(禁止模型自主调用):• 选填布尔值。若声明为 true,Pi 生成 System Prompt 时会将此技能从公开发布的清单中隐藏,模型将完全不知道它的存在,仅供用户在终端通过/skill:<name>手动显式触发。
对 Agent Skills 规范其他字段的处理态度:官方 Agent Skills 规范中提及的
license、compatibility、metadata、allowed-tools等扩展字段,Pi 的 YAML 解析器会予以静默放行(容错不报错),但当前 Pi 运行时不对其进行单独存储或特殊拦截。
3. 内存常驻对象结构与“正文不缓存”设计
当 Pi 加载一个 Skill 后,会在内存中构建一个 Skill 实例对象:
export interface Skill { name: string; // 技能名称(Frontmatter 或父目录名) description: string; // 路由描述 filePath: string; // SKILL.md 的物理绝对路径 baseDir: string; // 技能所在目录绝对路径(用于解析从属相对路径) sourceInfo: SourceInfo; // 溯源信息(标记来自 local/project/user/package) disableModelInvocation: boolean;// 是否对模型隐藏}关键设计细节:请注意,内存中的 Skill 接口中完全没有存储 Markdown 正文(Body)字段。
很多开发者初看源码会感到疑惑:为什么不把 SKILL.md 的全文一起读入内存缓存?答案依然是极端克制的资源开销与热生效考量:
• 如果一个工程或全局安装了上百个技能,启动时若全量驻留正文,不仅浪费堆内存,还会使内存中的数据与磁盘脱节; • 保持内存中仅驻留数十字节的轻量元数据,在需要执行时直接由模型调用 read工具或命令展开函数即时从磁盘读取。这种设计保证了极低内存开销以及正文修改后的“免重启秒级生效”。
三、Pi 的 Skill 都在哪?多源发现机制
Pi 在启动阶段会通过包管理器(DefaultPackageManager)与 loadSkills 函数遍历多个层级目录。
1. 五大多源发现路径
Pi 的技能检索范围覆盖了从命令行临时参数到项目、全局乃至依赖包的全层级:
1. CLI 临时参数:启动命令中通过 --skill <path>显式指定的路径(支持单个文件或目录);2. 项目级本地目录: • 工作区根目录下的 .pi/skills/;• 工作区当前目录及其所有父目录(向上追溯至 Git 根目录)下的 .agents/skills/(兼容通用 Agent Skills 规约);3. 用户全局目录: • 全局用户配置目录: ~/.pi/agent/skills/;• 全局标准代理目录: ~/.agents/skills/;4. 项目与全局 settings.json显式声明:在配置文件的skills列表中配置的本地绝对或相对路径;5. 外部 Package 依赖:通过 pi install引入的 npm、Git 或本地包,读取其package.json中的pi.skills或约定的skills/目录。
2. 目录递归与边界探测算法
在遍历目录时,loadSkillsFromDirInternal 函数执行了一套严谨的边界探测逻辑:
进入扫描目录├── 检查当前目录是否直接存在 "SKILL.md"?│ ├── 是 → 将当前目录确认为 Skill 根节点,加载该 SKILL.md│ │ ★ 立即终止向下继续递归(防止将子目录中的文档误判为独立技能)│ └── 否 → 继续向下扫描子节点│ ├── 忽略文件过滤(.gitignore, .ignore, .fdignore)│ ├── 跳过隐藏目录与 "node_modules"│ ├── 遇到子目录 → 递归调用内部探测│ └── 根目录下遇到独立的 "*.md" → 兼容加载单文件技能这一算法确保了类似 my-skill/references/manual.md 这样的参考文档不会被错误地提升为一个独立的顶级技能。
四、同名 Skill 优先级裁决与冲突诊断
当开发者的全局配置中装了一个官方发布的 pdf-tools 技能,而当前项目又为了定制业务在 .pi/skills/pdf-tools 写了一个同名技能时,Pi 会如何裁决?
1. 六级 Precedence 权重算法
在 package-manager.ts 的 resourcePrecedenceRank 函数中,Pi 依据资源的来源元数据(PathMetadata)计算一个整数权重分值。分值越小,优先级越高:
function resourcePrecedenceRank(m: PathMetadata): number { if (m.origin === "package") return 4; const scopeBase = m.scope === "project" ? 0 : 2; return scopeBase + (m.source === "local" ? 0 : 1);}由此推导出的完整六级优先级金字塔如下:
| 0(最高) | source: "cli"local + project | --skill 参数,或当前项目 .pi/settings.json 中显式列出的路径 | |
| 1 | auto + project | .pi/skills/ 与 .agents/skills/ 自动发现的目录 | |
| 2 | local + user | ~/.pi/agent/settings.json 中显式列出的路径 | |
| 3 | auto + user | ~/.pi/agent/skills/ 与 ~/.agents/skills/ 自动发现的目录 | |
| 4(最低) | origin: "package" |
2. First-Wins 注册机制与 Collision 诊断追踪
在收集到所有候选资源后,系统根据上述权值升序排序(权值相同的保持原有先后次序):
resolved.sort((a, b) => resourcePrecedenceRank(a.metadata) - resourcePrecedenceRank(b.metadata));紧接着,在 loadSkills 函数中执行注册:
• 采用 “先到先得(First Wins)” 策略:遍历排好序的技能列表,当发现 skillMap中已存在同名键时,后入者判定失败;• 生成冲突诊断( ResourceDiagnostic结构):明确记录一条collision警告,标出胜出者路径(winnerPath)和落败者路径(loserPath),供诊断面板或启动日志追踪。
这种设计保证了工程团队可以在项目中随时用同名本地实现覆写第三方包或全局默认技能,而绝不会引发行为不确定性。
五、深入实战:项目显式配置与外部 Package 导入
1. 项目级显式配置(settings.json 中的 skills)
若不想依赖常规目录的自动扫描,可以直接在当前项目根目录的 .pi/settings.json 中使用顶层 skills 数组显式指引(对应配置项 Settings.skills):
{ "skills": [ "skills/pdf-tools", "../external-skills/review-flow", "~/shared-skills/release", "!skills/experimental-*", "-skills/deprecated-skill", "+skills/experimental-v2" ]}• 路径解析基准:项目配置中的相对路径默认以 .pi/目录为基准解析。指向项目根目录下的文件需使用../前缀;• 模式匹配与过滤(Overrides)(底层由 applyPatterns函数执行):• !pattern:Glob 规则排除,批量禁用命中通配符的技能;• -path:强制精确排除,拥有绝对最高优先级,彻底剔除;• +path:强制精确包含,用于在被!批量排除后,定向拉回指定技能。
2. 外部 Package 导入与 Project Trust 安全闸门
通过 pi install 可以引入跨项目共享的技能包:
# 全局安装外部包pi install npm:@example/pi-tools@1.0.0# 项目级安装外部包(写入 .pi/settings.json)pi install -l git:github.com/example/pi-tools@v1其背后的执行与生效链条为:
1. 自动下载与物理落地:npm 包缓存于 .pi/npm/node_modules/,Git 仓库克隆至.pi/git/;2. Project Trust(项目信任)安全闸门: • 技能包中可能夹带可由模型执行的 Shell 脚本。为了防范供应链攻击,项目级配置的 Package 必须在用户显式授予“Project Trust”后才会被实际载入; 3. 标签绑定与最低优先级: • 从 Package 解析出的所有技能,其元数据被硬性固定为 { origin: "package" },其仲裁分值被赋予最低的4。这保证了哪怕第三方包内部包含各种宽泛的技能定义,项目内只要有同名实现,主导权永远牢牢掌控在本地开发者手中。
六、双轨运行机制:模型自主感知 JIT vs 用户显式展开
Pi 的运行时为 Skill 设计了优雅的“双轨制”:既支持模型在多轮对话中自主按需加载,也支持人类通过命令行强行注入。
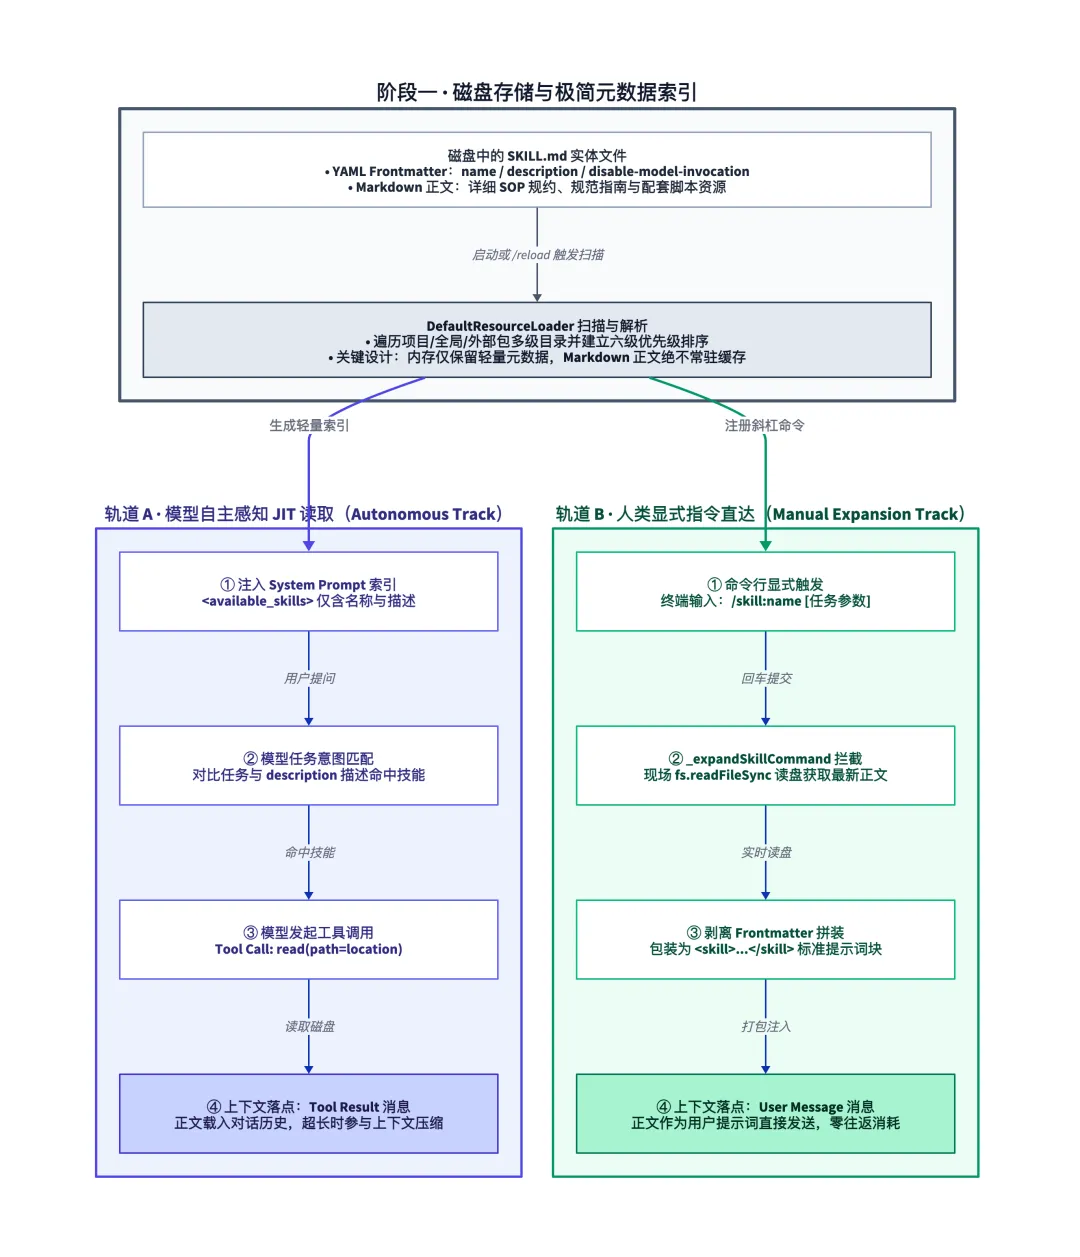
1. 轨道 A:模型自主感知与 JIT 工具调用(Tool-based Reading)
这是日常开发中最自然、最节省上下文的交互路径:
1. 目录注入 System Prompt:在系统提示词构建阶段, formatSkillsForPrompt函数将所有可见技能格式化为专用的 XML 块并嵌入<skills>节区:<skills>The following skills provide specialized instructions for specific tasks.Use the read tool to load a skill's file when the task matches its description.When a skill file references a relative path, resolve it against the skill directory (parent of SKILL.md / dirname of the path) and use that absolute path in tool commands.<available_skills> <skill> <name>d2-diagram</name> <description>使用 D2 声明式绘图语言为技术文章生成高质量软件架构图...</description> <location>/Users/.../.agents/skills/d2-diagram/SKILL.md</location> </skill></available_skills></skills>2. 语义匹配与自主决策:用户提出需求:“帮我把这段逻辑画成一张架构图”。模型在规划步骤时阅读 <available_skills>,发现d2-diagram的功能和任务完美契合。3. 工具调用与结果回灌:模型生成标准的工具调用报文: read(path="/Users/.../d2-diagram/SKILL.md")。4. Agent Loop 闭环:Pi 的 Agent 循环拦截到该 Tool Call,执行系统调用读取文件,并将完整的 SKILL.md文本作为一条role: "tool"消息送回对话历史。模型阅读了 SOP 的每一个约束(如移动端宽度、配色要求、多模态校验红线)后,开始执行具体的制图操作。
2. 轨道 B:人类显式斜杠命令展开(Slash Command Expansion)
有些时候,模型的自主判断可能不够灵敏,或者开发者希望在首轮对话就强行将技能规约下发给模型。此时可以使用斜杠命令:
1. 命令发现:Pi 在初始化终端自动补全时,会将所有可用技能映射为 /skill:<name>候选命令;2. 底层拦截与展开:用户输入 /skill:d2-diagram 帮我绘制模块依赖图。在消息尚未推入模型队列前,AgentSession的内部方法_expandSkillCommand捕获该指令:• 提取技能名称并查表获取 skill.filePath;• 调用 readFileSync同步读取磁盘文件;• 调用 stripFrontmatter彻底剥除顶部的元数据;• 包装为结构化 XML 片段并附加用户参数: <skill name="d2-diagram" location="/path/to/d2-diagram/SKILL.md">References are relative to /path/to/d2-diagram.[这里是 SKILL.md 剥离 Frontmatter 后的完整 Markdown 正文]</skill>帮我绘制模块依赖图3. 无往返直达:该拼装后的内容直接作为一条普通的 role: "user"消息提交给 Agent 循环。模型在首轮就持有完整知识,免去了一轮 Tool Call 的往返延迟。
七、Skill 在上下文中的落点与内存优化考量
初学者常问:“一个技能在上下文窗口里到底待在什么地方?”
答案是:取决于生命周期的不同阶段。
1. 静态未激活期
• 落点:位于 System Prompt 的 <skills>独立 section 中;• 状态:仅存极简元数据。包含 name、description和location。一个典型的 Skill 在此阶段仅占几十个 Token,即便系统中挂载 50 个技能,总开销也不过 1500~2000 Token。
2. 动态激活期
• 若通过模型自主 JIT 触发: • 完整正文作为 role: "tool"的执行响应内容,追加进多轮对话历史数组(Messages Array)中。• 若通过用户 /skill:name触发:• 完整正文被展开并嵌入进 role: "user"的用户请求报文中,追加进对话历史数组中。
这种设计使得“技能的加载”完全服从 Agent 对话历史的上下文管理规则:当会话轮次极长发生 Context Compaction(上下文自动压缩裁剪)时,早期加载但当前不再需要的技能内容会伴随陈旧对话历史一同被压缩摘要,绝不会永久侵占 System Prompt 的宝贵黄金位置。
八、Skill 修改后的生效逻辑与重载机制
在日常开发中修改了技能文件后,Pi 会如何表现?这需要区分修改的内容类型:
1. 仅修改正文说明、附属脚本或参考文件
• 行为:免重启、即时生效。 • 原理: • 在模型自主调用模式下,模型是通过 read工具在运行时向操作系统读取文件的。只要你在编辑器里按下了保存,模型下一次发起read时拿到的一定是磁盘上的最新字节;• 在用户 /skill:name命令模式下,_expandSkillCommand在每次回车触发时都会现场执行一次readFileSync。保存文件后立刻输入命令,展开的内容必定是最新版本。
2. 修改了 Frontmatter 元数据(如更改 name、重写 description、切换 disable-model-invocation)或新增/删除了 Skill 目录
• 行为:必须触发重新加载。 • 原理: • 系统的目录树发现、技能匹配索引表以及 System Prompt 中的 <available_skills>清单,是在 Session 初始化时由资源加载器(DefaultResourceLoader)预先装配并缓存的;• 修改 description改变了模型的自主路由判断基准,新增目录改变了可用技能集合。若不重新索引,当前活动 Session 依然沿用旧的元数据缓存。• 生效途径: • 在交互终端输入 /reload命令:这是 Pi 最优雅的热更新特性。执行/reload后,依次触发handleReloadCommand->session.reload->_resourceLoader.reload()。Pi 会重新扫描全局与项目的所有配置目录,重新计算六级优先级与同名冲突,重新生成 System Prompt 并刷新命令行的自动补全候选列表。整个过程无需退出终端,耗时通常在百毫秒级。• 重新启动 Pi:重新运行命令行亦会执行完整的冷启动初始化加载。
九、总结与架构设计哲学
回顾 Pi 对 Skill 的整体架构设计,我们可以提炼出三条关键工程哲学:
1. JIT 替代 AOT(按需即用优于预先加载):将“知识的描述”与“知识的实体”解耦。在 System Prompt 中维持极其扁平轻量的目录索引,把知识正文推迟到运行时通过标准工具调用动态索取,用极小的 Token 成本换取了近乎无限的能力扩展空间。 2. 严格的层级主权与安全边界(Precedence & Trust):在资源仲裁上建立“项目高于全局,显式高于隐式,本地高于外部包”的确定性六级优先级,让团队定制能够稳定覆盖通用预设;同时通过 Project Trust 机制建立外部包的执行安全红线。 3. 双轨闭环兼顾智能与受控(Autonomous + Manual):既支持大模型在复杂任务中“心有灵犀”地自主感知并查阅 SOP,又为人类开发者提供了直接利用 /skill:name展开指令的绝对操控权。智能与确定性并存,是现代专业级 Agent Harness 不可或缺的架构标杆。