ARTICLE · 1166002
微软掀翻大模型底层逻辑!剥夺AI说话能力,成本暴跌99%的新物种诞生
如果一家市值万亿美元的科技巨头,兴师动众发布了一款最新的人工智能模型,但这个模型根本不会说话,你会有什么反应?
它不写诗,不做开放问答,不会陪你促膝长谈,甚至连一句完整的中文或英文句子都挤不出来。
微软就这么干了
2026年10月9日,微软CEO萨提亚·纳德拉(Satya Nadella)亲自下场,微软CTO办公室副总裁牵头,向全世界隆重推出了一款奇怪的模型,Microsoft-Decision-1。
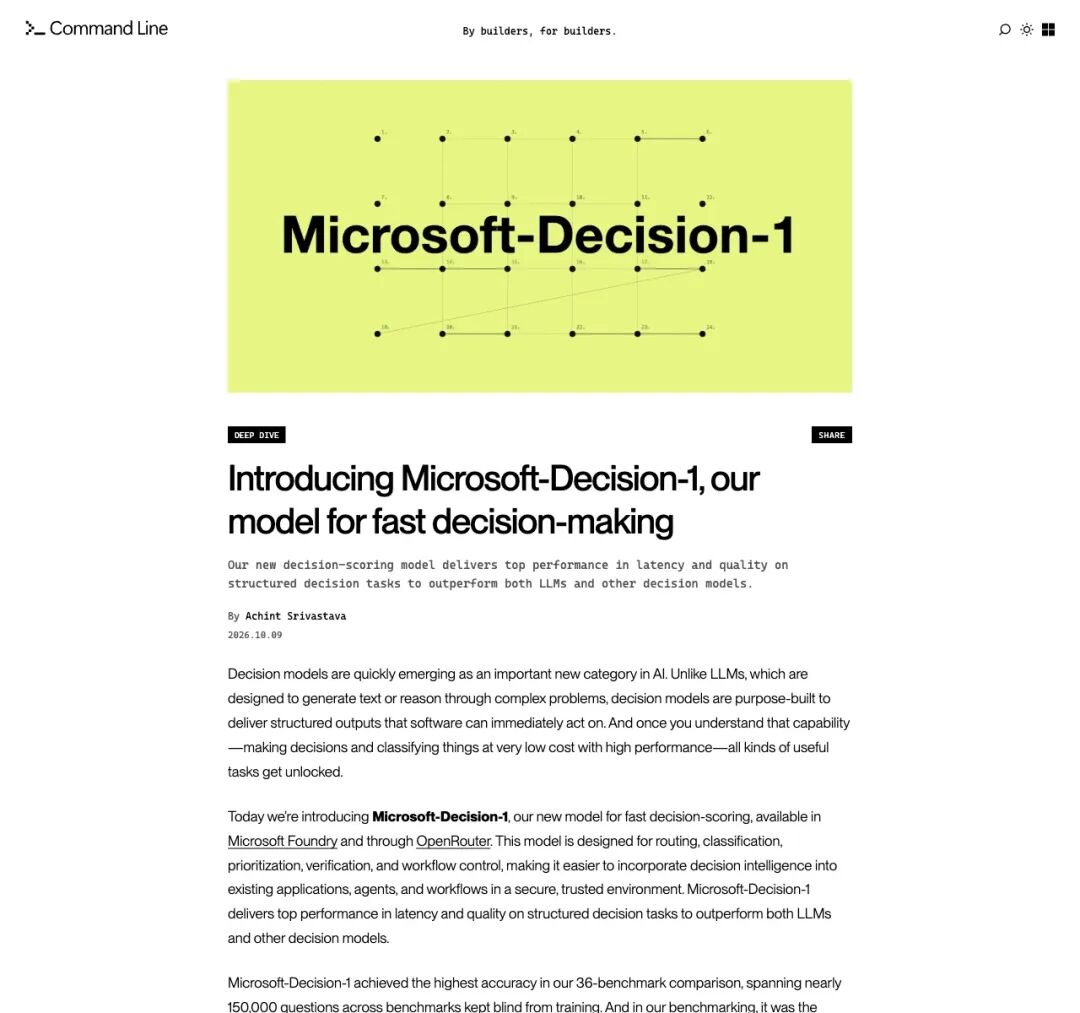
▲ 微软 Command Line 官方技术博客发布长文:专门面向快速决策的全新模型
消息一出,迅速引发技术社区的热烈反响。人们很快发现:微软不仅剥夺了它的“舌头”,还给出了一个极具颠覆性的价格:每100万个输入Token只要4分钱(0.042美元),输出Token全部免费!
响应速度更是快到令人发指:85毫秒。
人类眨一下眼睛需要200到300毫秒,而这个模型完成一次高精度判断,比你眨一次眼还要快上近三倍;比通用大模型 GPT-6 Sol 快了整整35倍。
微软到底在发什么疯?一家引领大语言模型浪潮的巨头,为什么要费尽心机打造一个“哑巴”?
01杀鸡用牛刀:传统AI正在被废话逼疯
要看懂微软这步险棋,先得看看现在的智能体(AI Agent)究竟被折磨成了什么样子。
过去两年,所有人都在迷信“大模型无所不能”。我们让大模型去写代码、做客服、管服务器。但在真实工业界,一个复杂的智能体跑起来,内部其实充满了密密麻麻的微小选择题:
“这通投诉电话,该分给退款组、维修组还是人工客服?” “刚才搜索出来的这篇文档,到底跟用户的提问有没有关系?” “生成的这段代码,是否触碰了生产数据库的高危权限?” “当前这个回答质量太烂,该重试、直接拒绝,还是交给人类接管?”
这些问题,全都是封闭的单选题或打分题。
但传统的通用大模型是怎么处理的?它像一个每小时收费上千美元的文科大博士,被你硬生生拽到流水线门口当保安。
每当走过来一个工件,博士都必须清清嗓子,自回归地“一个词一个词”往外蹦废话:“尊敬的用户,根据您的提问,我经过深思熟虑后认为,该请求属于工程技术类,原因有一二三四……”
这种机制在工程上简直是灾难:
第一,延迟高得让人抓狂大模型吐出这么一堆漂亮话和JSON格式,哪怕只耗费半秒钟,只要智能体链路里串联了十几个判断节点,整个流程就会瞬间卡死十几秒。
第二,显存与算力的极度浪费为了生成几个表示选项的字符,后台庞大的GPU要持续维持着巨大的计算缓存,电费在燃烧,算力在空转。
第三,随时可能神经错乱哪怕你严令禁止它闲聊,它也偶尔会多吐一个标点符号、漏一个括号,导致下游软件系统的代码直接报错崩溃。
我们为了让AI按下一个“是”或“否”的按钮,竟然一直在承受大模型自回归生成的漫长折磨与天价账单。
微软这把手术刀,精准地切在了这个脓包上。
02砍掉舌头,直接把“小脑”焊死在芯片上
Microsoft-Decision-1 的底层逻辑极其纯粹:彻底放弃文本生成,只做单次前向打分(Single-pass Scoring)。
什么叫单次打分?
以往的大模型像在写文章,写完上句看下句,词词相扣;而 Decision-1 像一位面无表情的高考阅卷老师看答题卡,一眼扫过去,直接在预设的选项上砸出概率值。
调用它的时候,开发者给一段最长达 3.2 万字的情境状态(state),再配上一道带选项的问题:
比如是非题(True or False); 比如路由单选题(退款/投诉/开票); 比如优先级打分题(轻微/严重/致命)。
模型只做一件事:在前向传播结束的瞬间,直接吐出标准的数据格式,告诉你选项A的概率是 92.2%,选项B是 7.8%。
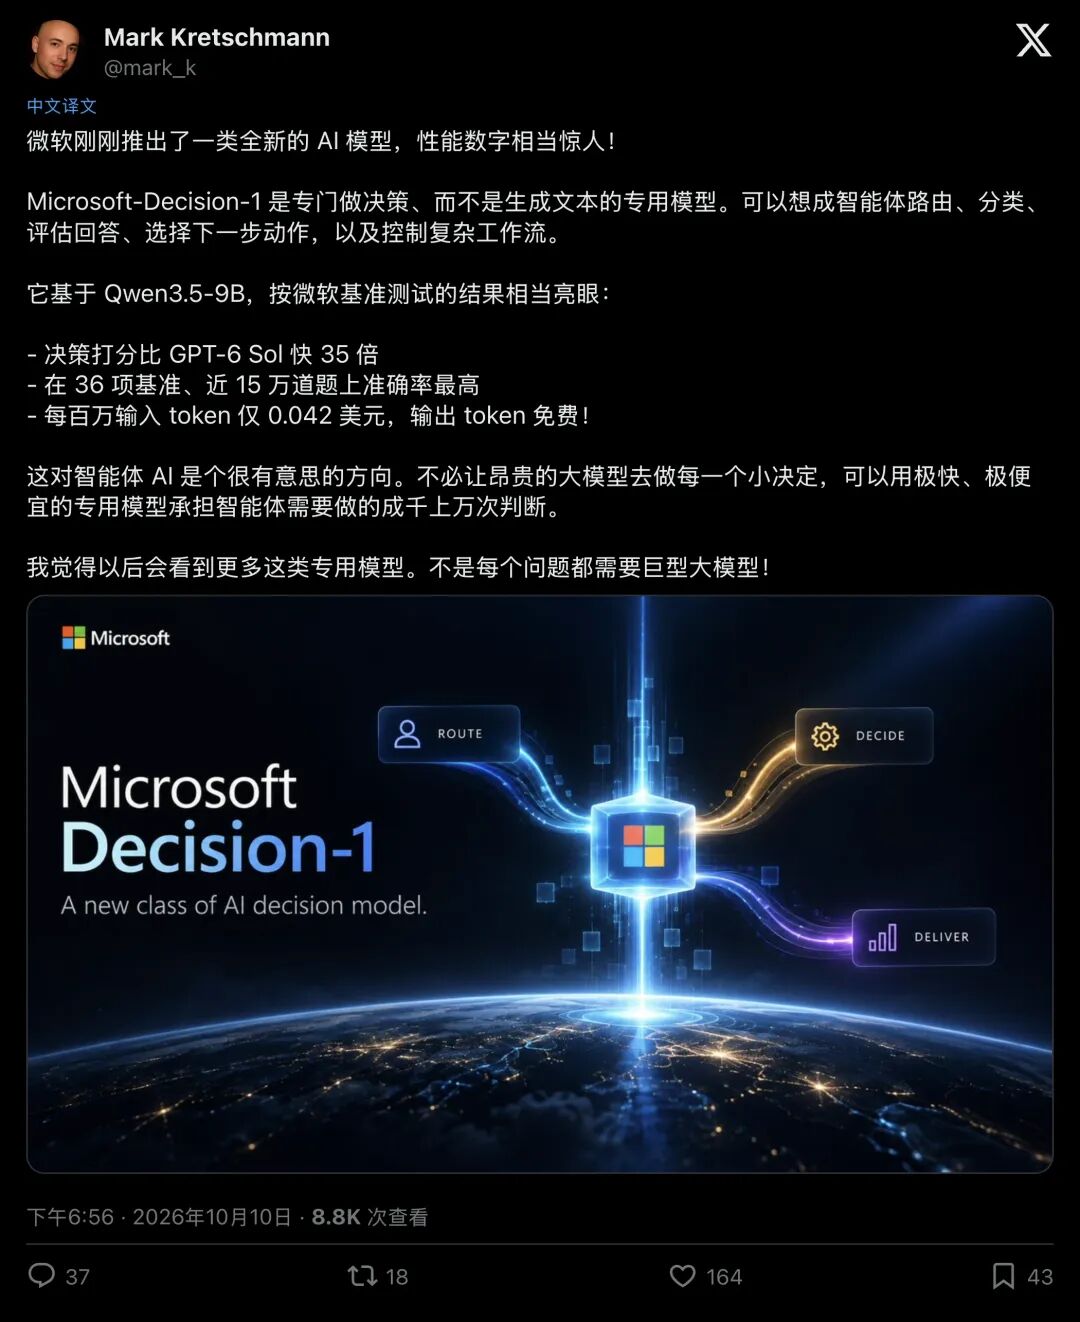
▲ 开发者社区热烈讨论:专为决策而生的新型模型架构,实现35倍的响应提速
整个调用过程极其干脆:没有冗余对话,直接输出结构化概率。
根据微软官方技术白皮书披露,这个由微软CTO办公室倾力打造的全新杀手锏,第一版后训练的开源底座,赫然写着:Qwen3.5-9B(通义千问)!
一个来自中国的开源底座,被微软拿去深度后训练,剥离了闲聊能力,强化了语义决策神经,摇身一变成为了支撑微软庞大云端业务的“特种兵”。
在微软内部的实际淬火中,这个模型的战绩相当吓人:
- Xbox 游戏研究团队
:用它处理来自玩家社区和Steam的上万条开放式吐槽反馈,速度比 GPT-6 Sol 快了14倍,成本直接缩减到原本的二百分之一; - Copilot 质量监控
:给聊天助手的回答质量实时打分,表现媲美顶尖大模型,而速度暴增了整整100倍; - 在线事故快速响应
:当服务器报警,工程师调取海量日志与通话记录时,它在关键知识检索与意图分流上,比昂贵的通用大模型又快又准。
03江湖擂台:打地鼠、太空射击与抗“投毒”实战
微软在自家的宣传博客里写得天花乱坠,但在群雄逐鹿的AI江湖里,各路技术极客可不买账。
早在微软入局前三周,这个被称为 System 1(决策模型) 的新赛道就已经硝烟弥漫。创业公司 TypeSafe 的 Jev、OpenAI 的 Decisions API、Cloudflare 的 Clef 早就打作一团。
微软发布推文的第一时间,评论区就有同行直接开怼:“等一下,有人告诉过他们 JEV 的存在吗?”
▲ 社区第一时间的调侃:“有人告诉过他们关于 JEV 的事吗?”
第三方的基准测试平台 JevBench 动作极快,第一时间把微软 Decision-1 拉上测试台,结果很快出炉:
在同类通过 API 调用的决策模型组里,微软 Decision-1 综合排名第6。
老牌劲旅 Jev 稳坐第4,而 Sage 雄踞第1;如果把所有开源自建与闭源托管的模型混在一起大杂烩,微软排在第12位。而在另一项决策指数(Decision Index 0.3.1)的民间估算中,它大约在第19名。
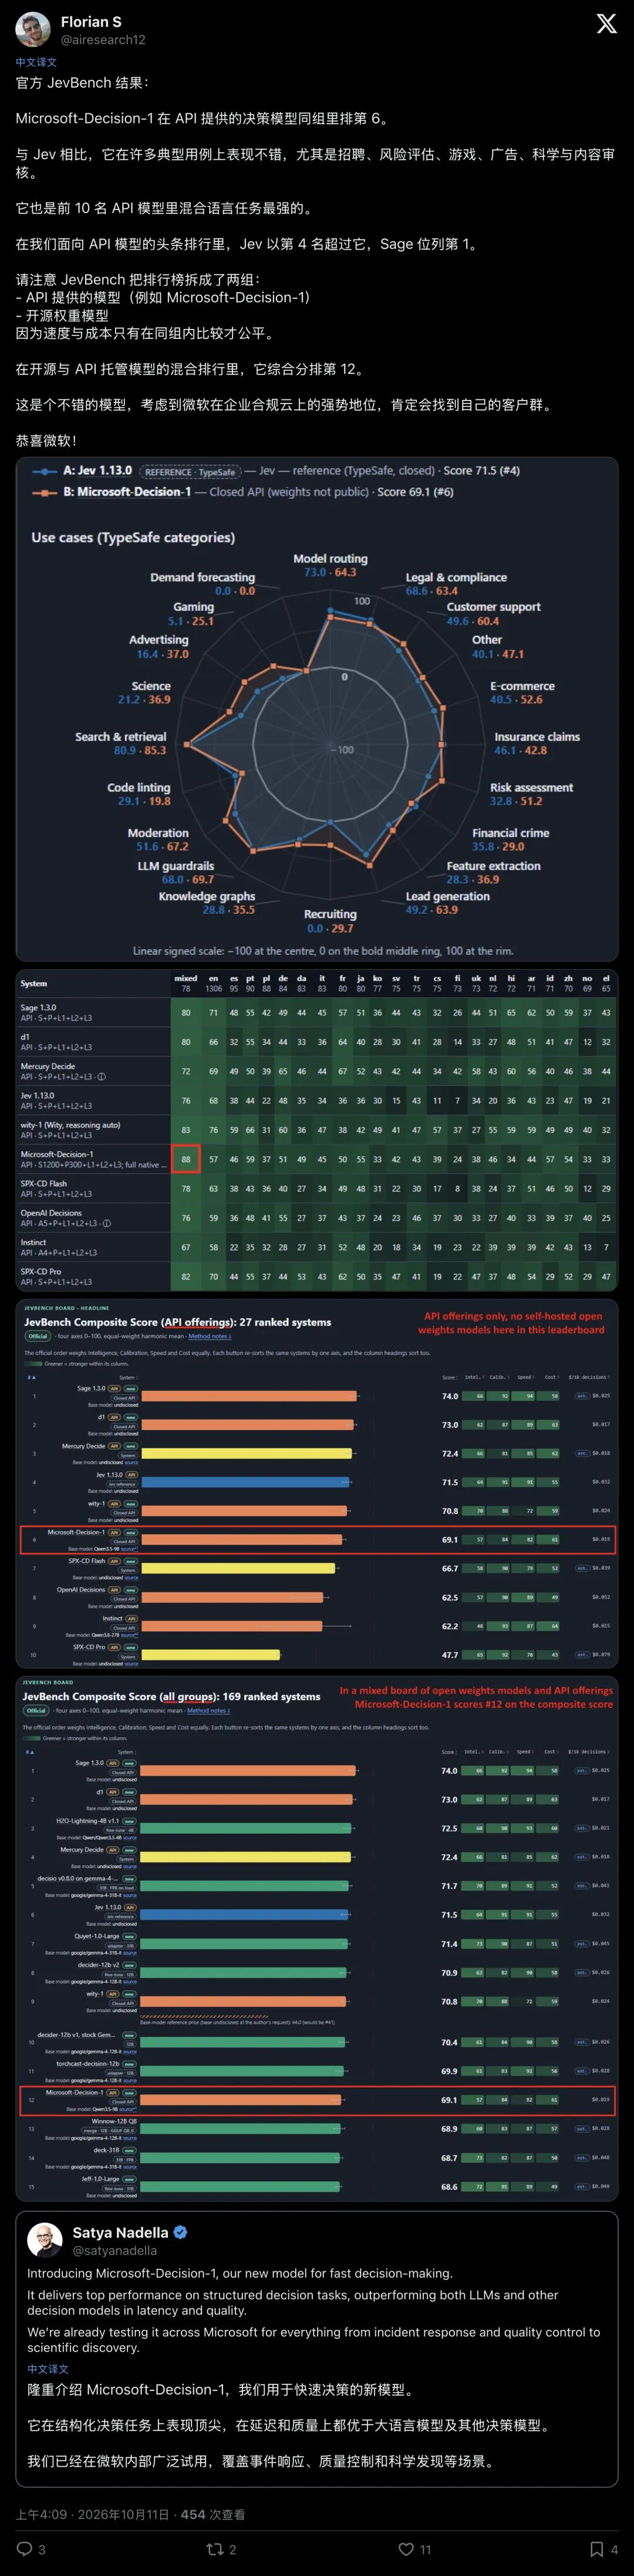
▲ 独立评测机构公布 JevBench 战报:微软在 API 组名列第6,但在招聘、风控与多语言任务上表现突出
这说明微软并不像自己吹的那样“全维度独孤求败”。但为什么开发者们依然为之兴奋?
因为在这个极其苛刻的细分赛道里,工程落地的关键在于:在极致的速度与抗噪能力下,它到底稳不稳。
有人将 Decision-1 与 OpenAI 的同类接口接入经典的街机游戏《太空侵略者》(Space Invaders),让AI在几毫秒内判断该往左移、往右移还是开火射击。结果表明:微软决策模型以极低的延迟做出连贯决断,得分一路狂飙,把反应略慢的对手远远甩在身后。
在更严苛的临床医学与科研决策测试中,测试人员故意在真实的病历描述周围塞进大量毫无关联的废话乱码、重排选项顺序进行“文本投毒”。
换作普通大模型,可能早就被带偏了思路,开始胡说八道;而这个基于 9B 剪裁训练出的“决策小脑”展现出了惊人的定力:翻转率几乎为零。在 669 道临床模拟决策中,它准确砸中了 611 道,不仅稳坐第一梯队,处理完所有病历总共才花了不到两美分。
在企业级市场,这恰恰契合了工业品的核心标准:便宜、准时、皮实,绝不擅加发挥。
04智能体的双脑时代:人类思维的倒影
站在更高的维度审视,微软剥夺AI语言能力的举动,正是大模型工业化进程中必然降临的分工革命。
二十世纪最具颠覆性的认知心理学家丹尼尔·卡尼曼在《思考,快与慢》中提出过著名的理论:人类的大脑主要由两套机制协同运作。
- System 1(快思考)
:直觉、本能、快速反射。看到飞来的棒球下意识躲闪,看到熟人的脸瞬间认出,几乎不消耗意志力; - System 2(慢思考)
:逻辑、计算、深度推理。算一串多位数乘法,写一篇复杂的商业计划书,必须全神贯注,极度消耗能量。
过去两年,整个人工智能行业干了一件极其反直觉的蠢事:我们试图让一个庞大无比的 System 2,去包揽包括躲避飞球、按电梯按钮在内的所有生理反射。
其结果就是系统奇慢无比,成本高上天际。
现在,AI终于长出了属于自己的“小脑”与“反射神经”:
未来的高阶智能体架构,必然是清晰的双脑分工:
System 1(决策模型)负责站岗:由 Microsoft-Decision-1 这类专精模型常驻前哨。它们以85毫秒的反应、几分钱的成本,每秒钟处理数万次路由判断、安全审计与量规打分;
System 2(生成大脑)负责攻坚:昂贵的旗舰大语言模型退居二线。只有当快思考模型判定“当前任务极度复杂、需要撰写宏篇论述或复杂推导”时,才会被唤醒点火,发挥其深层智力价值。
大模型的虚火正在退去,机械流水线上的齿轮正在咬合。
AI 不再需要每一次都向人类展示它那滔滔不绝的口才。在看不见的底层网络里,无数个沉默寡言、被剥夺了舌头的“决策小脑”,正以每秒成千上万次的速度,冷静地支撑起庞大AI帝国的运转。
有时候,学会把精力留给关键决断,才是智能走向成熟的标志。