ARTICLE · 1175430
AI获客软件,普通人也能自己写——原理、代码、成本、红线,一篇讲透
销售每天抱着手机加人、发话术、被拒、被拉黑;老板交了几万块买「全自动获客系统」,两周后发现就是群发器,账号还被封;你自己会打字、会用AI,看着市面上动辄几万一年的获客系统,心里犯嘀咕:这东西我也能写吗?
能。但要先接受一个残酷前提:AI获客软件里,真正值钱的从来不是代码,而是「合规的线索来源 + 你真的懂客户」。代码只是把这两样东西自动化的工具。本文分七块讲透:四种形态、六层架构、技术选型、三个核心原理、180行可跑代码、商用化五件事、三条合规红线与成本账。
别急着交那笔几万块的「智能获客系统」年费,先花20分钟搞清楚——它到底是怎么运转的。
01 先分词:所谓「AI获客软件」,其实只有四种形态
市面上所有叫「AI获客」的东西,全部可以归到下面四类。搞清楚这一点,比看一百篇测评都有用。
形态 | 说白了干什么 | 典型形态 | 技术难度 | 合规风险 |
AI外呼 | 机器人打电话初筛客户 | 电话机器人、智能客服坐席 | 中 | 高 |
线索挖掘 | 从公开信息里找潜在客户并打分 | 企业名录库、意向评分系统 | 中 | 中 |
私域承接 | 加进来之后的自动应答、分层、跟进 | 企微 SCRM 、 AI 销售助手 | 中 | 低 |
内容获客 | AI 批量生产内容,多平台分发引流 | 短视频矩阵、图文分发 | 低 | 低 |
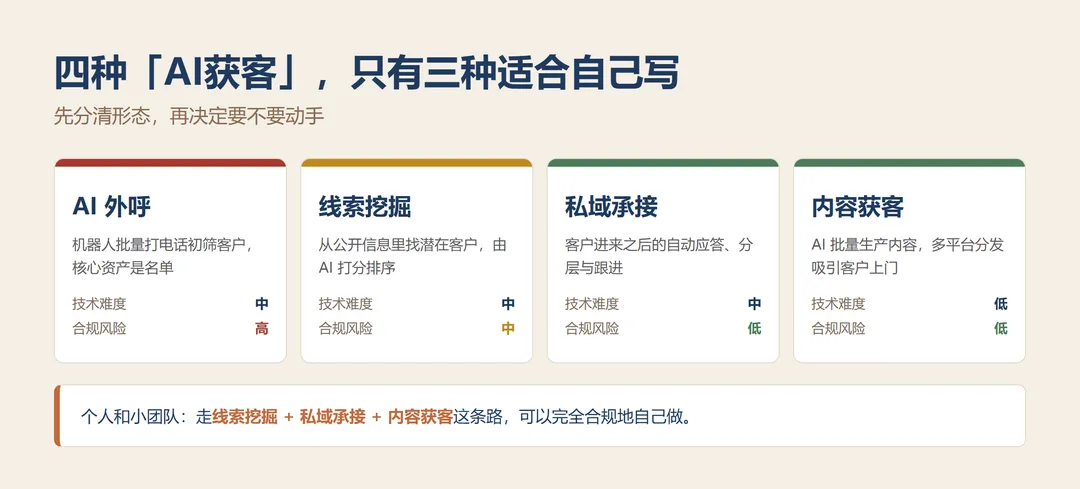
图1 四种「AI获客」形态:只有三种适合自己写
怎么选,一句话:
·个人和小团队:老老实实做「线索挖掘 + 私域承接 + 内容获客」,这三块可以完全合规地自己写。
·AI外呼:能不做就不做。它是唯一一个「技术在你这、风险也在你这」的形态,后面第7节会讲清楚为什么。
所以本文的代码,聚焦在前三类。这也是普通人唯一走得通的路。
02 拆开看:一个获客系统就是六个模块
不管你是自研还是买SaaS,架构都一样,就是这六层:
① 线索入口层→② 清洗画像层→③ AI评分层 ↓ ⑥ 数据回流层←⑤ 会话承接层←④ 触达执行层
① 线索入口层——钱都花在这儿。线索从哪来?合规的来源只有这几种:官网/落地页表单留资;公众号、视频号、朋友圈互动留资;直播/线下活动的报名表;客服咨询转介;公开的企业工商信息、招投标公告、行业展会名录(注意:是「企业公开信息」,不是「个人手机号」)。技术实现就是「接收 + 入库」:一个HTTP接口 + 一张表。
② 清洗画像层——脏数据不配进CRM。重复、缺字段、乱码、广告灌水,都会让后面AI的判断变蠢。这一步做三件事:去重(按手机号/公司名)、补全(从公司名反查行业规模)、打标(来源渠道、地域、行业)。
③ AI评分层——整个系统的大脑。让大模型读线索原文,输出一个0-100的意向分和一个建议动作。这一步决定了销售第二天先给谁打电话。
④ 触达执行层——最需要克制的一层。只有两种合规做法:官方API(企业微信客户联系、公众号客服消息、平台开放平台)和人工执行。任何「模拟真人操作绕过平台风控」的方案,都在给自己埋雷。
⑤ 会话承接层——把知识库接给AI。客户问「你们和XX家比有什么优势」,AI得答得出来。做法是RAG:把你的产品资料、案例、报价规则切片入库,让模型基于你的资料回答,而不是自己编。
⑥ 数据回流层——让系统越用越准。哪条话术回复率高?哪个渠道的线索转化好?这些数据回流到评分提示词里,系统才会进化。没有这一层,你的系统永远停在第一版。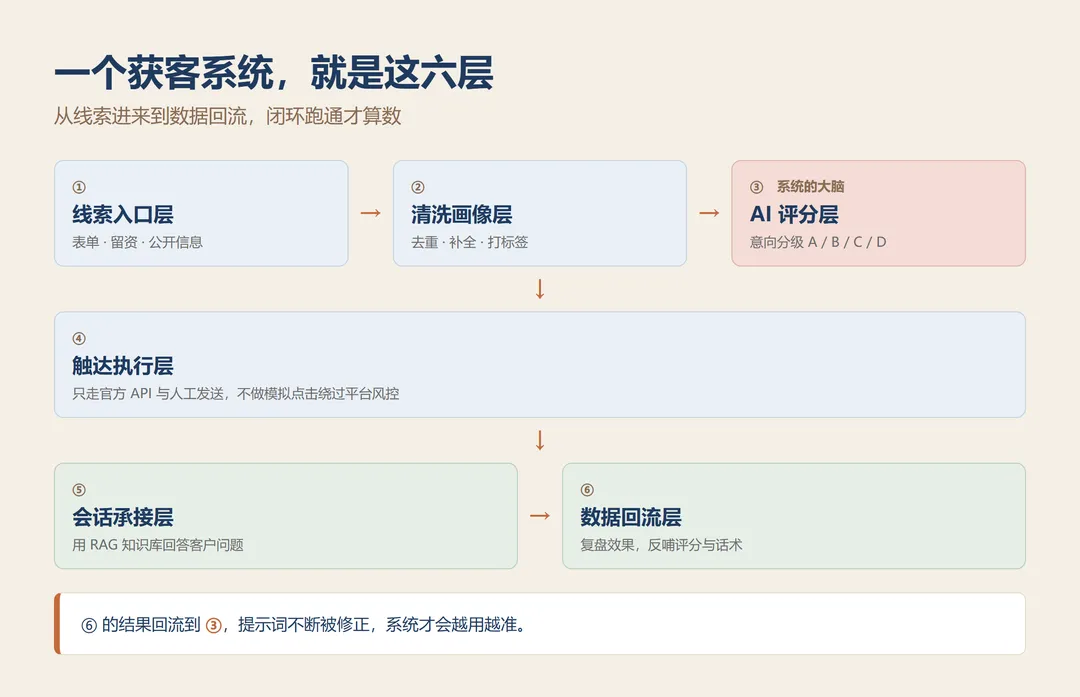
图2 AI获客系统六层架构:⑥的结果回流到③,闭环才算跑通
一句话总结:获客软件 = 接收线索 → 打分排序 → 生成话术 → 合规触达 → 智能应答 → 数据回流。
03 技术选型:别造轮子,全部用现成的
很多人一想到「写软件」就头大。其实2026年做这类工具,栈非常固定,而且都有现成方案:
层次 | 推荐方案 | 为什么 |
语言 | Python | 大模型生态最全, AI 写的代码质量最高 |
后端框架 | FastAPI | 一个文件就能起 HTTP 服务,自带接口文档 |
数据库 | 自用 SQLite ,多人 PostgreSQL | SQLite 零配置,一个文件就是数据库 |
任务队列 | Redis + Celery (简单场景直接while + sleep ) | 批量任务要限速、要重试 |
大模型 | DeepSeek / 通义千问 / Claude / GPT | 都兼容OpenAI接口协议,换模型只改两行 |
前端后台 | 先用FastAPI自带的简单 HTML ,后期再上低代码 | 别在 UI 上浪费第一周 |
部署 | 本地电脑跑自用,云服务器跑多人在线 | 自用阶段零成本 |
关键认知:这些技术栈你不需要会写,你需要会「说清需求」。用 WorkBuddy / Claude Code / Codex 这类工具,你把第二步画的那张六层架构图丢进去,让它一层一层实现,它就是你的程序员。
换模型的成本是零。所有主流厂商都兼容 OpenAI 的接口协议,意味着你写 base_url 和 api_key 两行,就能从 DeepSeek 切到通义,或者反过来。这是2026年做AI应用最大的红利——不要把系统绑死在某一家模型上。
04 三个核心原理:不懂这些,代码就是废的
评分、话术、触达,各讲一个原理。这三个原理想明白了,代码才不是废的。
原理一:AI线索评分 = 把销售的老经验,变成一段提示词
老销售看一眼线索就知道「这人靠不靠谱」。AI做的事,就是把这段经验翻译成规则:
维度 | 问什么 | 权重参考 |
需求明确度 | 他有没有说清要解决什么问题? | 30% |
预算信号 | 有没有提到价格、预算、比价? | 25% |
决策权重 | 是他拍板,还是「我问问领导」? | 25% |
时间紧迫度 | 有没有提到「这个月」「尽快」「项目节点」? | 20% |
评分提示词的三条铁律:
·规则要量化。写「判断意向高低」没用,要写「90-100分:需求明确+有预算+是决策人+30天内落地」;
·强制结构化输出。必须让它只吐JSON,否则你没法写程序去接;
·必须给出理由。没有理由的分数,销售不会信,也就不会用。
原理二:AI写话术 = 用客户的「原话」当饵
群发消息为什么被拉黑?因为它对每个人说的话一模一样。
AI话术的杀手锏是引用客户自己说过的具体问题。第一句就命中他自己提过的痛点,他会觉得「这个人在认真看我的问题」——这是群发永远做不到的。
要写进提示词的约束(很重要):
·字数80-120字,微信一屏读完;
·第一句必须复述客户的原话或原场景,禁止「您好,我们是XX公司」;
·中间给一个具体的价值点(一个数据、一个案例、一个方法),不许空承诺;
·结尾一个轻问句,把决策权交回客户;
·禁用词清单:亲、保证、最低价、包过、百分百。
原理三:自动化触达——三种实现方式,只有一种能用
方式 | 原理 | 合规性 | 结论 |
官方API | 走企业微信、公众号、平台开放平台的授权接口 | 合规 | 唯一推荐 |
半自动 | 程序生成内容 + 任务列表,人工点击发送 | 合规 | 冷启动最优 |
RPA/模拟点击 | 模拟人在手机上操作,绕过平台限流 | 违规 | 别碰 |
第三种是市面上「全自动加粉软件」的通用做法。短期看着爽,一旦被平台识别,轻则封号清零,重则——第7节细说。
一句话总结:评分靠量化提示词,话术靠复述客户原话,触达只走官方API或人工。
05 手把手:180行跑通「AI线索打分 + 个性化话术」
下面这套代码是完整可跑的。它做三件事:读线索 → AI打分分级 → 生成个性化触达话术,并把结果存库。
先明确边界:这套代码只做「分析与生成」,不自动发消息。发送动作由你自己在官方渠道完成。这不只是保守,这是唯一能长期跑下去的做法。
(这套代码我已经在本地跑通了一遍,含一个不消耗API额度的离线自测脚本,跟着下面的步骤走,半小时内你就能看到结果。)
5.1 环境准备
mkdir ai-lead && cd ai-lead # 建虚拟环境(Windows) python -m venv venv venv\Scripts\activate # 装依赖 pip install fastapi uvicorn openai # 配置你的模型密钥(以 DeepSeek 为例,便宜且国内直连) # Windows PowerShell: $env:DEEPSEEK_API_KEY="sk-你的密钥"
目录结构:
ai-lead/ ├── core.py# 内核:建表、打分、生成话术 ├── pipeline.py# 批量流水线 ├── app.py# 网页后台(看线索、看话术) └── leads.db# 数据库(自动生成)
5.2 内核 core.py
# -*- coding: utf-8 -*- """AI 获客内核:线索评分 + 个性化话术生成(只分析,不群发)""" import os import json import sqlite3 import logging from openai import OpenAI logging.basicConfig(level=logging.INFO, format="%(asctime)s %(levelname)s %(message)s") log = logging.getLogger("ai-lead") DB_PATH = os.getenv("DB_PATH", "leads.db") # ---- 1. 模型客户端:兼容 OpenAI 协议,换模型只改这两行 ---- client = OpenAI( api_key=os.getenv("DEEPSEEK_API_KEY", ""), base_url=os.getenv("LLM_BASE_URL", "https://api.deepseek.com/v1"), ) MODEL = os.getenv("LLM_MODEL", "deepseek-chat") # ---- 2. 建表 ---- SCHEMA = """ CREATE TABLE IF NOT EXISTS leads ( idINTEGER PRIMARY KEY AUTOINCREMENT, nameTEXT, companyTEXT, sourceTEXT,-- 官网表单/公众号/活动/客服转介 rawTEXT,-- 客户原始信息(表单内容、聊天记录) scoreINTEGER,-- AI 意向分 0-100 levelTEXT,-- A/B/C/D reasonTEXT,-- 评分理由 next_action TEXT,-- 建议下一步动作 pitchTEXT,-- AI 生成的个性化话术 statusTEXT DEFAULT 'new',-- new/scored/pitched/done created_atTEXT DEFAULT (datetime('now','localtime')) ); """ def init_db(): with sqlite3.connect(DB_PATH) as conn: conn.executescript(SCHEMA) # ---- 3. 意向评分 ---- SCORE_SYSTEM = """你是资深 B2B 销售运营分析专家。请根据客户线索判断成交意向强度。 评分标准: - 90-100(A级):需求明确 + 有预算 + 是决策人 + 30天内要落地 - 70-89(B级):痛点明确,但预算或时间未定 - 50-69(C级):只是在了解,暂无明确需求 - 0-49(D级):非目标客户或疑似骚扰 只输出 JSON,不要任何多余文字,结构如下: {"score": 0, "level": "A", "reason": "40字以内", "next_action": "20字以内"}""" def score_lead(name: str, company: str, raw: str) -> dict: """调大模型给线索打分,返回结构化结果""" user_msg = f"客户姓名:{name}\n公司:{company}\n线索原文:{raw}" resp = client.chat.completions.create( model=MODEL, messages=[ {"role": "system", "content": SCORE_SYSTEM}, {"role": "user", "content": user_msg}, ], temperature=0.2, response_format={"type": "json_object"},# 强制输出 JSON ) data = json.loads(resp.choices[0].message.content) data["score"] = max(0, min(100, int(data.get("score", 0)))) if data.get("level") not in ("A", "B", "C", "D"): data["level"] = "C" return data # ---- 4. 个性化话术生成 ---- PITCH_SYSTEM = """你是一名从业10年的金牌销售,风格:真诚、专业、不油腻。 请根据客户线索,写一条 80-120 字的首次触达消息(微信场景)。 要求: 1. 第一句必须呼应客户自己提过的具体问题,禁止群发口吻; 2. 中间给一个具体的价值点(数据、案例或方法),不要空承诺; 3. 结尾用一个轻问句,把决策权交回客户; 4. 禁用词:亲、保证、最低价、包过、百分百、全网最; 5. 只输出消息正文,不要任何解释。""" def make_pitch(name: str, company: str, raw: str, info: dict) -> str: user_msg = ( f"客户:{name}({company})\n" f"线索:{raw}\n" f"AI 判断:{info['level']}级,理由:{info['reason']}\n" f"建议动作:{info['next_action']}" ) resp = client.chat.completions.create( model=MODEL, messages=[ {"role": "system", "content": PITCH_SYSTEM}, {"role": "user", "content": user_msg}, ], temperature=0.7,# 话术要有点变化,别每次都一样 ) return resp.choices[0].message.content.strip() # ---- 5. 数据库读写 ---- def add_lead(name, company, source, raw) -> int: with sqlite3.connect(DB_PATH) as conn: cur = conn.execute( "INSERT INTO leads(name,company,source,raw) VALUES(?,?,?,?)", (name, company, source, raw), ) return cur.lastrowid def pending_leads(limit: int = 20): with sqlite3.connect(DB_PATH) as conn: conn.row_factory = sqlite3.Row return conn.execute( "SELECT * FROM leads WHERE status='new' ORDER BY id LIMIT ?", (limit,) ).fetchall() def save_result(lead_id: int, info: dict, pitch: str): with sqlite3.connect(DB_PATH) as conn: conn.execute( """UPDATE leads SET score=?,level=?,reason=?,next_action=?, pitch=?,status='pitched' WHERE id=?""", (info["score"], info["level"], info["reason"], info["next_action"], pitch, lead_id), ) def list_leads(): with sqlite3.connect(DB_PATH) as conn: conn.row_factory = sqlite3.Row return conn.execute( "SELECT * FROM leads ORDER BY score DESC, id DESC" ).fetchall()
5.3 批量流水线 pipeline.py
# -*- coding: utf-8 -*- """批量跑线索:打分 + 生成话术。带限流,保护接口也保护对方。""" import time import core def run(limit: int = 20, interval: float = 1.5): core.init_db() rows = core.pending_leads(limit) if not rows: print("没有待处理线索。") return print(f"本次处理 {len(rows)} 条线索\n" + "-" * 60) for r in rows: try: info = core.score_lead(r["name"], r["company"], r["raw"]) pitch = core.make_pitch(r["name"], r["company"], r["raw"], info) core.save_result(r["id"], info, pitch) print(f"[{info['level']} {info['score']:>3}] {r['name']}({r['company']})") print(f"理由:{info['reason']}") print(f"话术:{pitch}\n") except Exception as e: print(f"[跳过] {r['name']} 处理失败:{e}") time.sleep(interval)# 限流,防止把接口打爆 if __name__ == "__main__": # 造三条测试线索(真实场景来自你的表单/公众号后台) core.init_db() core.add_lead("张工", "某市政建设集团", "官网表单", "问你们做不做桥梁钢结构深化设计,我们有个项目下个月要开工," "工期比较紧,想先了解下你们做过哪些类似的桥,预算大概200万左右。") core.add_lead("李经理", "某贸易公司", "公众号留言", "随便看看,先了解下。") core.add_lead("王总", "某建筑设计院", "活动报名", "我们院想找长期合作的深化设计团队,院长让我先摸底," "年底前希望能定下来一家。") run()
跑一次你会看到类似这样的输出:
[A95] 张工(某市政建设集团) 理由:需求明确、提到开工时间与预算、直接对接人 话术:张工您好,看到您提到下月开工、工期紧,这类情况我们在XX桥项目上…… [C55] 李经理(某贸易公司) 话术:李经理您好,您说先了解一下,我把我们做过的三个同类项目整理成…… [B82] 王总(某建筑设计院) 话术:王总您好,您提到院里要找长期合作团队、年底前定下来……
A级线索第二天第一个打,D级直接归档。销售的一天就省下来了。
5.4 网页后台 app.py
# -*- coding: utf-8 -*- """最简单的获客工作台:浏览器打开 127.0.0.1:8000 就能看""" from fastapi import FastAPI from fastapi.responses import HTMLResponse import core app = FastAPI(title="AI 获客工作台") core.init_db() COLOR = {"A": "#c0392b", "B": "#c4693a", "C": "#7f8c8d", "D": "#95a5a6"} @app.get("/", response_class=HTMLResponse) def home(): rows = core.list_leads() items = "" for r in rows: c = COLOR.get(r["level"] or "C", "#7f8c8d") items += f""" .......你就有了一套自己的获客看板。
5.5 已经跑通了,接下来怎么进化
跑通上面这套大约需要一个下午。然后按这个顺序加功能:
·接入真实线索源:把官网表单提交、公众号关注事件,用webhook打到你自己的接口上;
·加RAG知识库:把你的产品资料、案例库切片向量化,让AI能答具体问题;
·加回流统计:记录每条话术的回复率,把高回复率的话术样本喂回提示词;
·再考虑触达:接企业微信官方接口或平台开放平台,做合规的自动化触达。
注意顺序:先把「判断准不准」做对,再谈「发得快不快」。判断不准,发得越快死得越快。
06 从Demo到商用,还差五件事
上面是Demo。真拿去跑业务,下面五件事一件都躲不掉:
第一件:限流与稳定性。批量任务必须排队、限速、失败重试。用 while + sleep 只能在几十条级别凑合,上百条就得上 Redis + Celery。同时给你的模型调用加超时和降级——大模型接口偶尔抽风是常态,不能让它拖垮整个流程。
第二件:数据安全。客户信息是敏感数据。最起码做到:传输加密(HTTPS)、敏感字段脱敏存储(手机号中间四位)、数据库不对外网开放、密钥走环境变量而不是写死在代码里(上面代码已按这个写)。如果客户量大或涉及强监管行业,必须私有化部署——这也是为什么很多企业选开源模型:数据不出自己的服务器。
第三件:多租户与权限。一旦你不是自己用,而是给公司多个销售用,就要加账号体系、数据隔离、操作日志。这块很枯燥,但它是「工具」和「产品」的分水岭。
第四件:知识库的持续维护。AI客服答得准不准,取决于你的知识库有没有人维护。这不是技术问题,是管理问题。定一个规矩:产品资料更新后48小时内必须同步知识库,否则AI就会拿着过期报价去应答客户。
第五件:效果归因。到底哪个渠道的线索最值钱?哪句话术回复率最高?没有数据回流,你永远在凭感觉优化。至少记录四个字段:线索来源、评分、话术版本、最终结果。
一句话总结:Demo拼的是AI能力,商用拼的是工程能力和管理能力。
07 三条红线:比技术重要一百倍
这一段不是免责声明,是决定你能不能长期做下去的生死线。先把法律依据摆出来,都是有据可查的:
红线一:未经同意,不得打商业电话、发商业短信。《中华人民共和国消费者权益保护法实施条例》明确:经营者未经消费者明确同意,不得向消费者拨打商业性电话、发送商业性信息。消费者取消后,必须立即停止。这条直接判了「买名单盲打」的死刑。所谓「AI外呼每天打几万个」的玩法,无论技术多先进,名单本身就不合法。
红线二:非法获取、买卖个人信息,可能构成犯罪。《中华人民共和国个人信息保护法》要求处理个人信息遵循合法、正当、必要、诚信原则,不得过度收集、违规使用。未经允许收集、倒卖手机号等信息,情节严重的涉嫌侵犯公民个人信息罪;为诈骗提供AI外呼技术支持,可能构成帮助信息网络犯罪活动罪。
处罚有多重?同一部法律第六十六条规定:违规处理个人信息、拒不改正的,处一百万元以下罚款;情节严重的,处五千万元以下或上一年度营业额百分之五以下罚款,并可责令暂停业务、吊销营业执照。不是「罚酒三杯」,是可能直接关停。
红线三:AI必须亮明身份,且要提供拒绝方式。《人工智能拟人化互动服务管理暂行办法》要求AI服务提供者落实信息披露义务,保障用户知情权,禁止用AI实施误导、欺诈、骚扰。《个人信息保护法》第二十四条也规定:通过自动化决策向个人推送商业营销,应同时提供不针对个人特征的选项,或提供便捷的拒绝方式。客户说「不要」,就必须停——这不是礼貌,是法定义务。
三条铁律,贴在墙上:
事项 | 能做 | 不能做 |
线索来源 | 客户主动留资、公开企业工商信息、公开招标公告 | 购买 / 爬取个人手机号、通讯录 |
触达方式 | 官方 API 、人工发送、已授权客户 | 无授权群发、模拟点击绕过风控 |
身份披露 | 主动说明是 AI 或机器人 | 冒充真人、伪造身份 |
拒绝权 | 一键退订、立即停止 | 反复骚扰、换号继续打 |
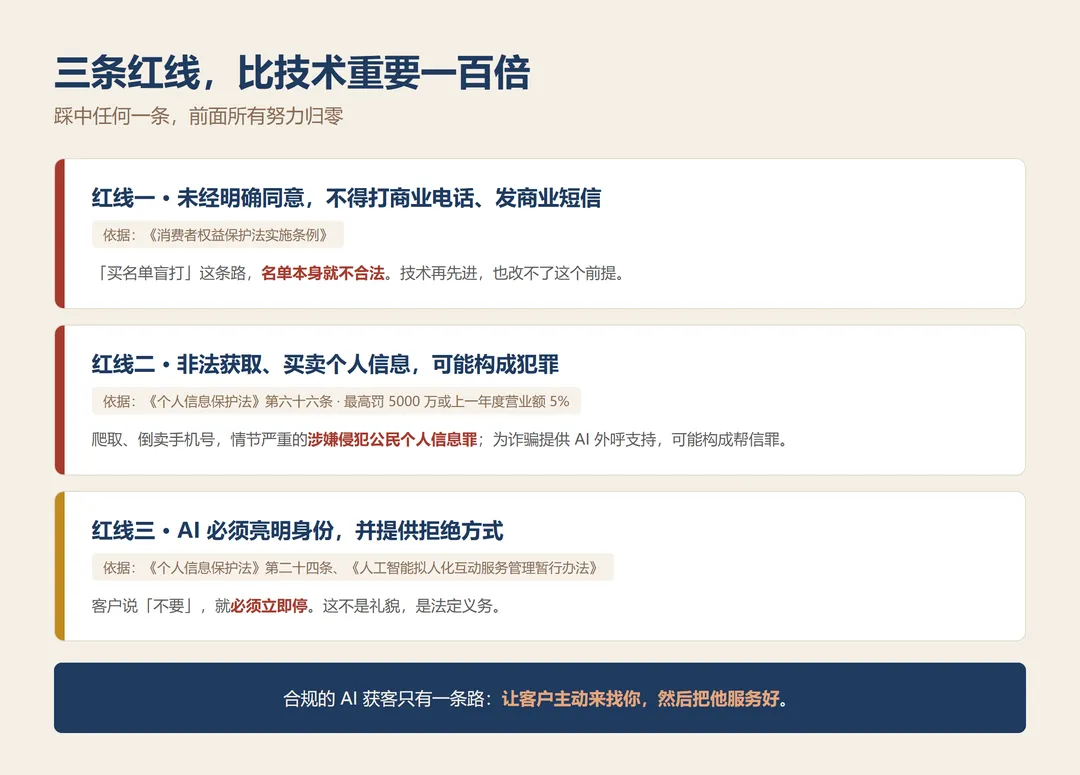
图3 三条红线:每一条背后都有明确的法条与处罚依据
补充一个信号:2026年8月起,三大运营商已同步开展线上售卡渠道专项整治,严禁外部平台售卖手机卡,从源头压缩「黑卡」流通。行业监管只会越来越紧。
合规的AI获客只有一条路:让客户主动来找你(内容获客),然后把他服务好(私域承接)。所有「绕过这一步」的捷径,都是在赌自己不会被查到。
08 成本账:花多少钱,花多少时间
最后算笔实在账。以「自用 + 小团队」为标准:
项目 | 自用版 | 小团队版( 5-20 人销售) | 对外卖 SaaS |
服务器 | 本地电脑 /0 元 | 云服务器约 ¥100-300/ 月 | 独立集群, ¥ 几千 / 月起 |
数据库 | SQLite免费 | PostgreSQL含在服务器内 | 需要高可用架构 |
模型 API | 免费额度够玩,正式用几十元 / 月 | ¥300-2000/ 月(视调用量) | 按量计费,需成本模型 |
开发时间 | 一个下午出 Demo ,两周可用 | 1-2 个月 | 6 个月以上,需团队 |
资质成本 | 无 | 无 | 增值电信业务许可等,合规成本高 |
合计 | 近零成本 | ¥500-2500/月 | 六位数启动 |
对比一下:市面上「全自动AI获客系统」的年费普遍在几万到几十万。
但请记住开头那句话——你省下的是代码钱,省不下的是「懂客户」这件事。AI能帮你把100条线索里的20条挑出来,但那20条要谈成,还是得靠你。
09 给三种人的三条路
如果你只是想让业务好做一点:别自己写。直接选一个合规的私域SCRM工具(重点看它有没有官方接口、有没有合规资质),把「自动应答 + 客户分层」用起来,一个月就能见效。自己写只在你需求非常特殊时才划算。
如果你会用AI、想自己搭:按第5节的代码跑通Demo,用WorkBuddy或Claude Code把你自己的业务规则喂进去,让它帮你补全触达层和数据层。一个下午起步,两周能跑通自己业务的完整闭环。这是2026年最值得投入的一项技能。
如果你想把它做成产品卖给别人:先解决合规,再谈技术。资质、数据来源、用户授权、审计能力——这四样任何一样缺了,商业模式都不成立。技术反而是最容易的那部分。
最后
AI获客这件事,本质上是把一个人从「体力活」里解放出来:不再需要一个个看线索、一条条想话术。
但工具再好,也只有两个东西决定结果:你的线索从哪来,你对客户有多懂。
代码只负责让这两件事跑得更快。别把它想得太玄,也别指望它替你搞定客户。
如果这篇文章帮你省下了一笔冤枉钱,点个赞,转给那个还在被「全自动获客系统」收智商税的老板。