ARTICLE · 1177063
通读完13万星的REA源码,它的防幻觉设计值得每个做AI的人抄一遍
13 万颗星。
这是 REA 现在在 GitHub 上的星标数。10 月 7 日那天它还不到 1 万,一周之后,6 位数。
一个逆向工程工具。全球干这行的工程师加起来,可能都填不满这个星数的零头。
哈哈,说实话,挺离谱的。
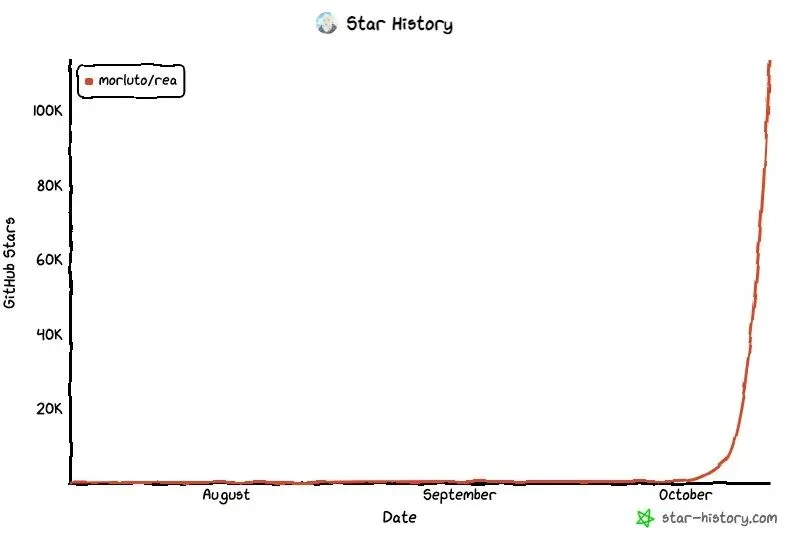
REA 的 star 曲线。躺了小半年,10 月第一周几乎垂直起飞
全网几百篇报道都在说同一件事,AI 把逆向的门槛打到了地板上。这话没错。但我把 REA 的源码翻了一遍,读完想说,这只解释了一半。
我本来是想搞清楚它怎么驱动 Ghidra 的,结果读完最大的收获,跟逆向没什么关系。
这个项目的代码里藏着一套东西,每个做 AI 产品、尤其是做 MCP 工具的人,都该看一遍。
怎么让 AI 不说谎。
先交代一下,REA 是怎么工作的
给没接触过它的读者补一句。REA 自己不「看懂」软件,它是你的 AI 编程助手和本地分析引擎之间的一座桥。
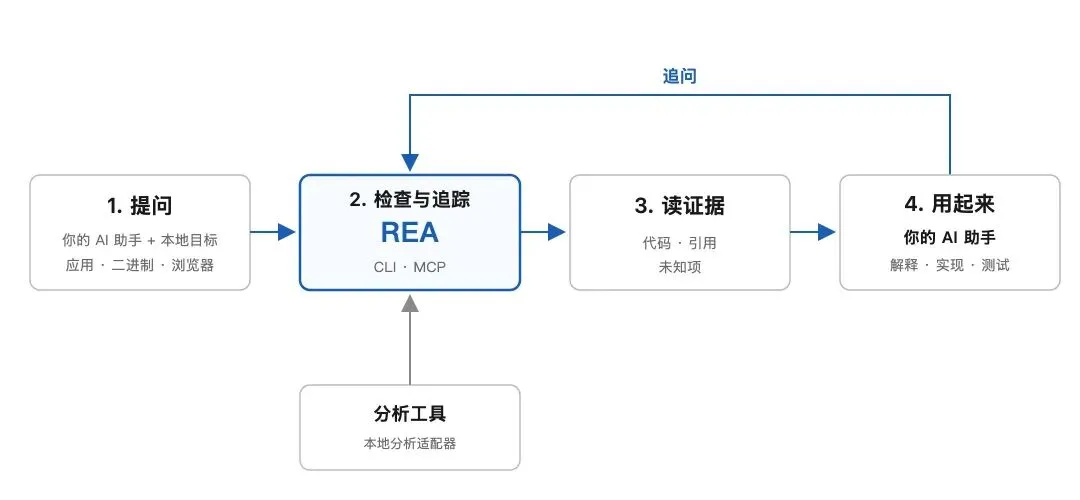
REA 的调查流程。AI 提问,REA 调用本地分析工具查证据,AI 拿到证据再回答你
你问 AI「这个软件为什么这么干」,AI 通过 REA 去调用 Ghidra、jadx 这些分析引擎,拿到的不是一坨原始汇编,而是一条条标好来源的证据。AI 看着证据回答你,你不放心,就顺着证据自己查。
它能拆什么、不能拆什么,一句话就能说清。
能拆的你电脑上的东西安装包、二进制、应用里的代码、网页脚本、APK只要文件在本地,它就有办法碰不到的服务端风控、推荐算法、业务逻辑全在别人的机房里,它连边都摸不到
所有分析都发生在你自己的电脑上,出了本机,它就没有超能力了
所以别指望拿它去研究微信的风控怎么给你定性,那套东西在云端,客户端只是个遥控器。
就记住一句话就好了,客户端是窗户,服务端是墙。
看懂这个流程,才能看懂它后面那些设计有多反常。
为什么是逆向工程,先逼出了这套设计
读源码的第一感觉,是这代码对 AI 的防备深得反常。
想想也合理。逆向工程可能是全天下对准确性要求极高的行当。AI 说「这个函数在 0x180124945」,错一个字节偏移,整份分析报告就是垃圾。AI 说「这两个版本的这个函数行为一致」,漏看一条跳转,复刻出来的东西就是错的。
在这个领域,幻觉不是体验问题,是事故。
所以一般 AI 工具那种「信任模型是默认设置」的写法,在这里根本活不下去。REA 的每一层都假设 AI 会说错话,然后逐层上锁。
我摘了 4 个最值得抄的设计。每个都说一句,它反常在哪,我们能抄什么。
第一道锁,把「事实」从模型手里拿走
REA 里所有字节级的事实,全部来自确定性工具。反编译是 Ghidra 干的,解 APK 是 jadx 干的,模型一行汇编都不许碰,只许转述。
转述还戴着镣铐。每条结论必须标注身份,三级,写死在数据结构里。
observed工具直接看到的反编译输出原文derived从证据推出来的有完整推理链inferred猜的明说证据不足
REA 的证据三级制。每条结论必须认领自己的成色,不许混着卖
每条结论还必须附一行「这次分析不知道什么」,这个字段是必填的。它的开发文档里还有一条硬规则,没查到的东西必须标记为「未知」,不允许显示成「不存在」。
一字之差。前者是诚实,后者是幻觉。
最狠的是这个,两条互相矛盾的结论,写不进同一个数据库。系统直接拒收,没有「先存下来再说」这个选项。
大部分 AI 产品的思路是让模型更聪明,指望它自觉。REA 的思路是另一套,不靠自觉,靠制度。
你不需要一个不说谎的模型。你需要一个让谎言无处落脚的系统。
第二道锁,防幻觉的战场在传输层,不在 prompt
这是整个源码里最反常识的地方。
现在行业防幻觉,基本在两层使劲。一层是训练,RLHF、对齐。一层是 prompt,系统提示词里写上「不许编造」。
REA 焊死的地方比这两层低得多,在进程间通信层。
子进程传给主进程的每个数据块,发送方算一次哈希,接收方再算一次,对不上直接拒收。分析结果太大、超出内存预算,宁可只保留一副骨架,也绝不「凑合着把大图补全」。所有控制帧过严格的格式校验,解析失败直接当错误抛出来。
我一开始看到哈希校验这段,心想至于吗,传个数据搞得跟过海关一样。读完整个项目才看懂,这就是它的底层逻辑,AI 拿到的每一份原料,都得先验货。
光说设计有点虚,说一个我亲测的现场。
我把「REA 是怎么防幻觉的」这个问题丢给了一个 AI。它交回来六条分析,每条都带着具体的源码符号名,文件名、函数名一应俱全。
我拿着这些符号名回仓库里逐条核查。
六条,全中。
那一刻我反应过来这套设计真正的回报。它让「验证 AI 有没有说谎」这件事,便宜到了一条命令的程度。AI 说结论的时候必须带上证据锚点,你想查它,一条命令就够了。
prompt 是劝模型别说谎,传输层校验是让谎言在物理上过不来。哪个更靠谱,做过产品的人心里都有数。
它的翻车,翻得很有原则
说完设计,来看两个真实的翻车现场。说实话,这是全文我最想写的一节。
第一个现场来自一位开发者的公开实测。他在 Windows 上拿 REA 分析一个 25.9MB 的应用安装包,跑了 20 秒,停了。一行红字,Delete owned object by handle failed。然后拒绝继续,证据零条。
按正常软件的思路,跑不了就降级,降级不了就跳过,实在不行装死转圈。
结果它不干。
我扒了源码,发现它在 Windows 上给自己设了三道门禁。能不能管住自己启动的进程,能不能建出私有权限的目录,会不会被快捷方式骗到别的路径。三条里任何一条证明不了,整个功能直接关门。
证明不了安全,就一行分析都不跑。
第二个翻车更微妙。有人拿它分析一个 3.5MB 的系统程序集,被「元数据超预算」的保险丝误拒了。防幻觉的机制太灵敏,把正常文件也熔断了。这个误伤被作者老老实实当成 bug 收进了 issue 列表,没有辩解。
两个现场放一起看,挺哭笑不得的,但仔细一品全是敬意。一个宁可不能用也不肯含糊,一个误伤了就老实认错。
翻车分两种,一种是能力不够,一种是底线不让。
REA 的翻车,全是后者。
一个宁可给你一行红字、也不给你编一段像样答案的工具,你猜,它会让挂在它上面的 AI 干什么。
我们能抄的是这个。你的工具出错的时候,给模型的是什么。一个诚实的错误码,还是一段看起来很有道理的错话。
说明书开始写给模型看
最后这个设计比较小,但对做 MCP 工具的人来说,可能是最直接能抄的一个。
REA 的每个工具说明书里都内嵌了调用示例。人看文档,模型看例子,参数写错的概率直接砍掉一大截。
它安装的时候还会往 agent 里塞一份「逆向工程师工作手册」。先建清单,再追调用链,什么时候该停下来读汇编,一步一步教。手把手教到这个份上,多少有点婆婆妈妈,但架不住真管用。输出格式也是专门设计的一种紧凑格式,为了帮模型省 token。
它给 AI 的不只是工具,还有老师傅的手感。
以前我们写文档给人看。现在,得给模型也写一份了。
聪明的 AI 会一直值钱,但很多行业在等另一个东西
回到开头那个问题。一个逆向工具,凭什么 6 天 10 万星。
表层原因大家都看到了,逆向民主化。但 13 万人用 star 投的,其实是另一票。
这几年,所有让 AI 变诚实的努力都往模型身上使,训练、对齐、系统提示词。REA 证明了还有另一条路,改不了说谎的人,就改那个让说谎变得可能的环境。
说白了,聪明的 AI 会一直值钱,这没跑。但医疗、法律、金融这些行业真正等的,是一个在自己领域里不说瞎话的 AI。这个市场比「更聪明」大得多。
如果你正在做 MCP 工具,这四道锁几乎可以直接搬进你的仓库。事实分级标注传输层校验宁可报错也不含糊给模型看的说明书。模型会一代代换,这套设计跟模型无关,它是工具层的基本功。
让 AI 变聪明的路已经很挤了。让 AI 在关键的地方不说瞎话,这条路还空着。
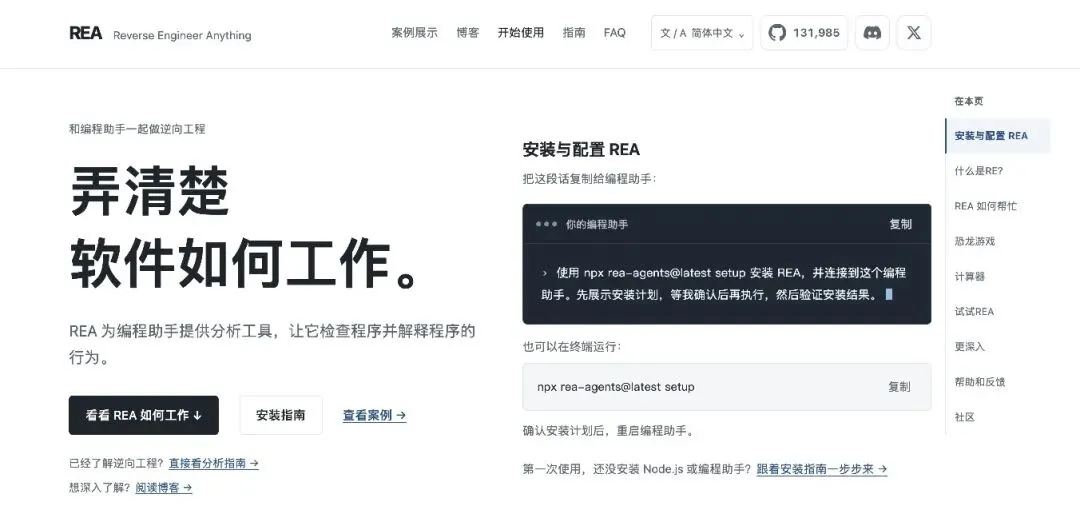
REA 的中文官网,案例展示里有几个完整的逆向调查实录,值得一看
这篇文章只摘了 4 条,源码里值得学的远不止这些。它对子进程的管理、对工具契约的写法、对「不确定」的一整套建模方式,都是 AI 时代做工具的教科书。
最后放两个入口,感兴趣的自己去看,一周一百多次提交,迭代快得吓人。
中文官网(文档 + 案例实录)· rea.tools/zh-CN
源码仓库 · github.com/morluto/rea
值得大家去深挖一下源码,理解一下 REA 背后的设计逻辑,会对大家用 AI 更有帮助。
我是大林,大模型算法专家,持续关注 AI。
微信(dalinvip2023),备注【公众号 AIGC】,进 AIGC 交流群。
主页:www.dalinaip.com/about
如果文章对你有一点点 🤏🏻 帮助,关注公众号并【星标】,可以及时收到最新 AI 信息,点赞、在看、转发给更多的朋友,后面我继续分享更多的 AI 内容。