ARTICLE · 1177414
别急着喊软件完了,我用 19 万星的 REA 拆了一次,它两次说没找到
这个月 AI 圈最火的一个词是逆向。一个叫 REA 的开源项目,全称 Reverse Engineer Anything,号称让 AI 逆向一切。10 月 6 日它冲上 GitHub 日榜第一,今晚我刷新时已经 19.4 万星。Matthew Berman 那条 "Reverse Engineer Anything 😂 Software is done." 有 360 万人看过。
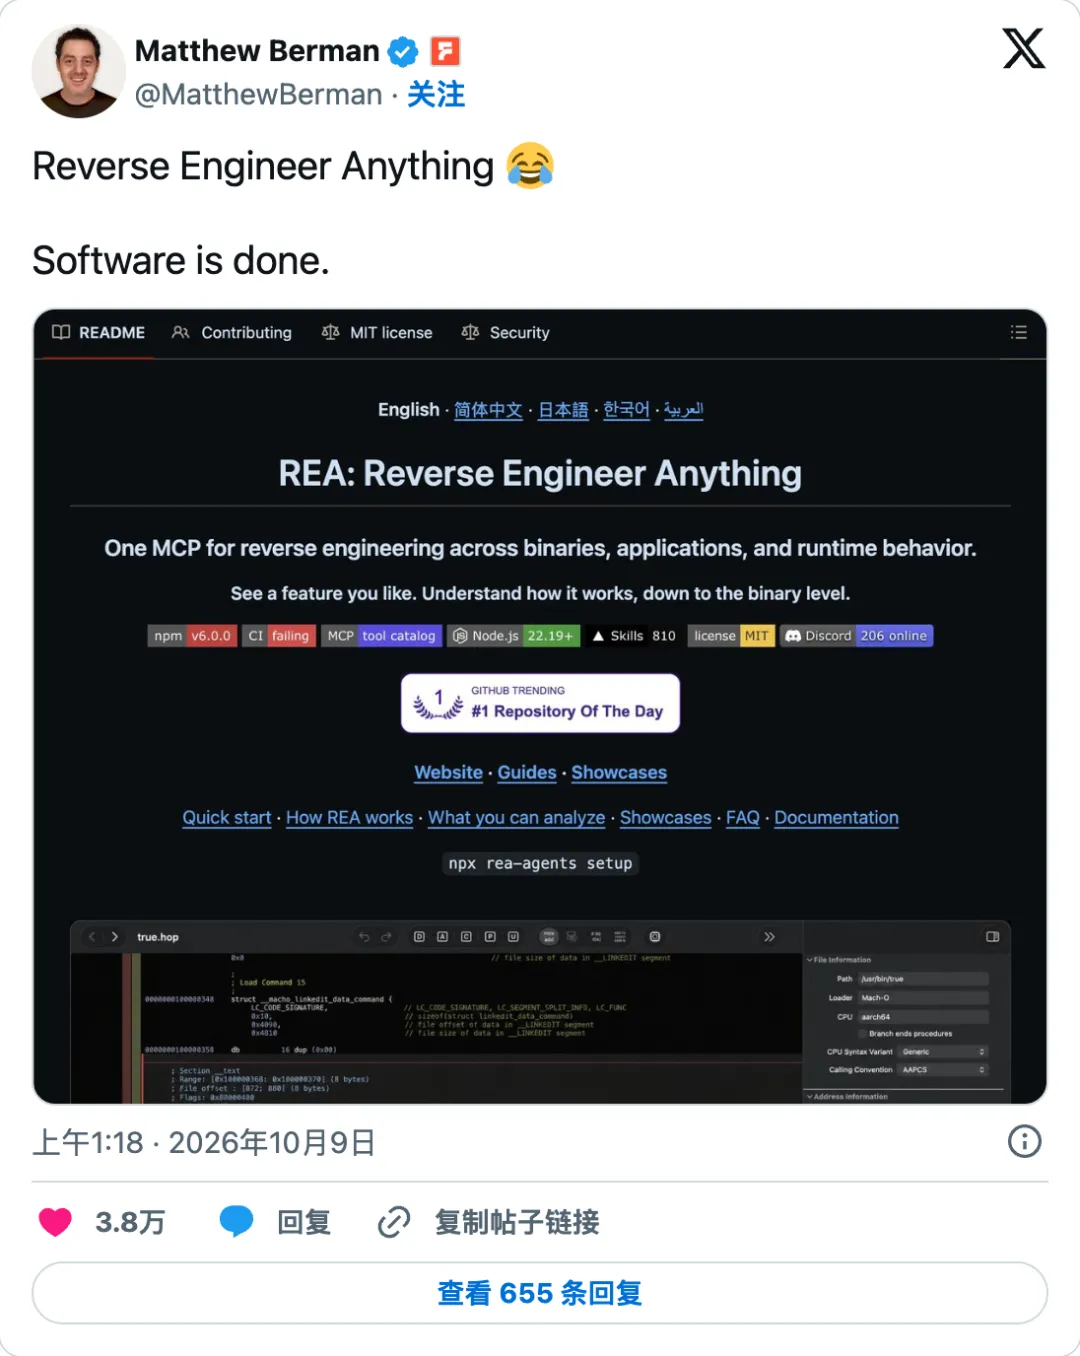
我拿它真拆了一个软件。几分钟后,4,724 个文件全摊开了,这一步确实漂亮。可我顺着两条线索追问关键机制,它两次回答没找到。
软件到底是不是完了,我拆完的感受没那么简单。下面把经过讲一遍。
它到底在干什么
程序员写的代码,编译以后会丢掉大部分给人看的信息。函数原来叫“计算余额”还是“验证密码”,电脑不在乎,留下来的只有一串指令和内存地址。从这堆东西倒推软件怎么工作,就是逆向工程。以前这是少数专家的手艺。有一群玩家把《超级马里奥64》完整还原成 C 代码,干了两年。
REA 自己不做反编译。它是一座桥,通过 MCP 这个标准接口,把 Ghidra、IDA、Hopper 这些专业反编译器,还有浏览器和抓包工具,交给 Claude Code、Codex、Cursor 这类 AI 智能体去指挥。网页和 Electron 写的桌面应用不用装额外工具,直接拆安装包就行。
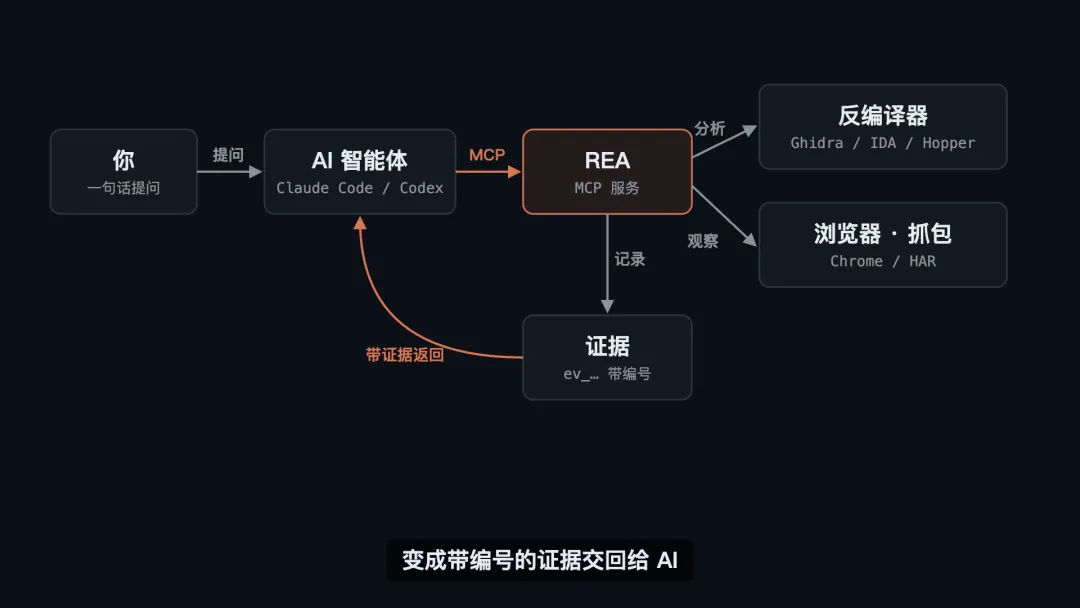
它的文档里有一条规矩我很喜欢。每条结论都带一个证据编号,能追到哪个文件、哪个地址。没查到的东西标成 unknown,没覆盖到不等于不存在。这条规矩后来在我身上应验了。
我拿它拆了 Orca
Orca 是我写代码时用的工具,能同时开好几个 AI 一起干活,开源,GitHub 上 9 万多星。我一直好奇一件事,几个 AI 同时在跑,它怎么知道谁在干活、谁卡住了等我确认、谁已经干完了。靠盯着终端里的字去猜吗?
我让 Codex 装上 REA 6.4.0,去分析我电脑里装的 Orca 1.4.224 的安装包。第一步的结果很壮观。4,724 个文件,两千一百多万个语法节点,5 个窗口,1,031 条进程间通信的频道,整个应用的骨架摊在一个 JSON 里。
然后我顺着两条线索往下问。一条是 Orca 接收 AI 状态用的端口变量 ORCA_AGENT_HOOK_PORT,一条是派出去的任务干完以后回报的消息 worker_done。两次结果一模一样,no-match,匹配数 0。REA 顺手把整张图的覆盖度标成了 partial,部分覆盖。
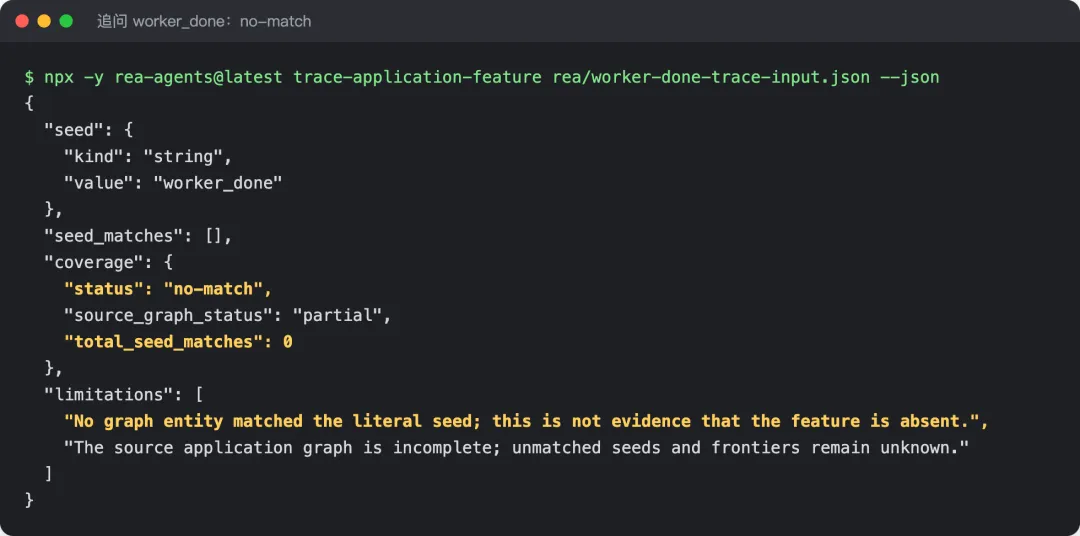
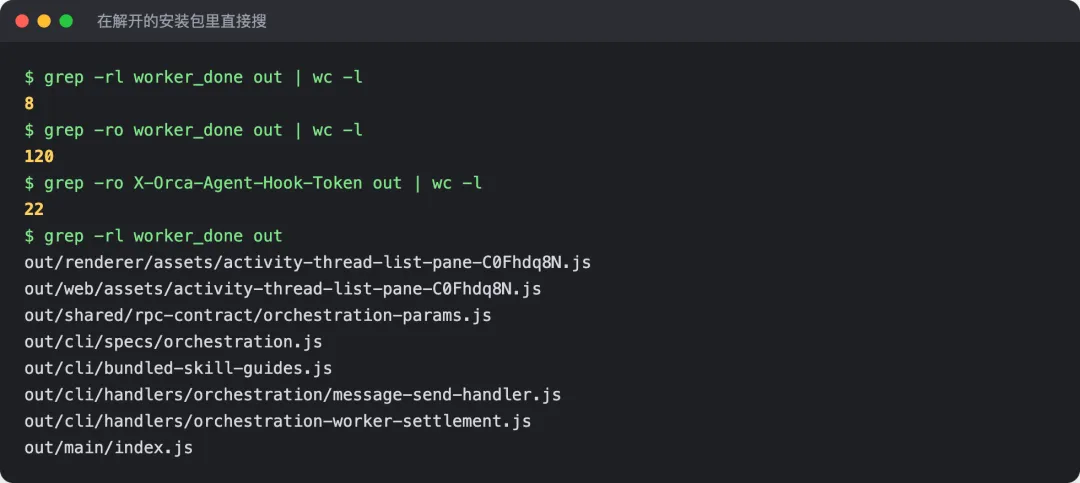
这两个词真的不在安装包里吗?我又让 AI 在解开的安装包里直接搜了一下 worker_done,8 个文件,出现了 120 次。东西一直都在,REA 画的那张图没覆盖到这一块。
这里得坦白一句。REA 还在跑分析的时候,Codex 已经去 GitHub 把 Orca 的源码拉下来读了。Hook 和派工这两块机制,是它先在源码里找到,再回头去 REA 的结果里核对的。所以这一次算不上盲拆。
于是倒过来验证了一遍,不看源码,只看安装包,这些东西找不找得到。找得到。AI 回报状态时带的口令头 X-Orca-Agent-Hook-Token 在安装包里出现了 22 次。派工那张数据库表的建表语句原样躺在主进程的代码里,开发者写的注释一行都没删。
Orca 是怎么做的
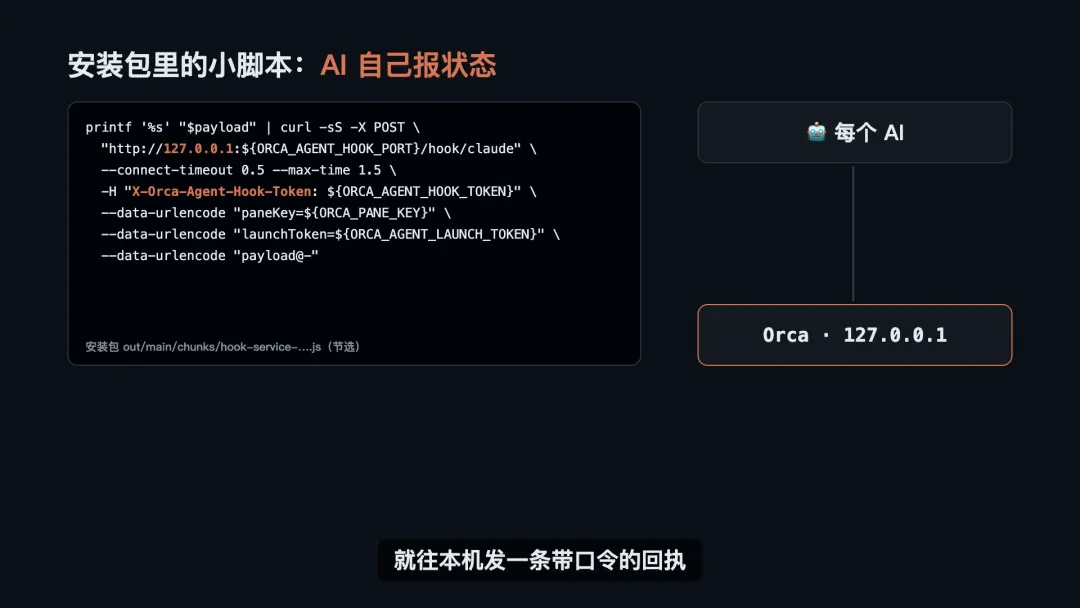
Orca 给每个 AI 装了一个小 hook。AI 每到一个阶段,开始干活、需要你确认、干完了,就往本机 127.0.0.1 的一个端口发一条请求,请求头里带着口令,报告自己现在是什么状态。Orca 根本不用看屏幕猜,AI 自己会说。口令是防止本机随便哪个程序冒充 AI 乱报。
派活那边有个细节我挺佩服。每个任务有一个任务号,每派给某个 AI 一次,再发一张新的派工单号。AI 回报完成时两个号都得对上才算数。上一轮迟到的回报带着旧单号回来,会被直接弹回去,不会把新一轮的任务错误地结掉。
我想知道的就是这些,拿到了。代价是我得清楚哪些是 REA 找到的,哪些是 Codex 从源码里看来的。
这次拆下来,我对“软件完了”冷静了不少
REA 给我的东西更像一张地图。文件有多少,窗口有几个,进程之间怎么通信,几分钟就数清楚了,这一步人工做要花很久。可我真正想问的那个机制,在地图上是一块空白。剩下的路得 AI 顺着地图去读打包后的代码,人再去核对。
它两次老实说没找到,我反而更信它。要是它当时编一个像样的答案给我,我大概会被带偏很久,还觉得自己挺懂。
我不是唯一一个觉得没那么神的人。MindStudio 做过一个对照实验,让 AI 复刻苹果自带的“预览”,用 REA 和不用 REA 各做一次。两版都能用,REA 那版的布局和功能更贴近原版,不用 REA 的那版还先做完。在这么简单的应用上,差距不大。
REA 自己的 README 也写得很克制,它不承诺还原原始源码,也不会自动克隆一个应用。同期刷屏的“一个人用 AI 重写 Adobe 七款软件”,原帖没提 REA。
用得好的人,都只拿走一块
那它值在哪?我翻了这两周 X 上用 REA 的实战帖,用得好的几个人有个共同点,谁都没打算复刻整个产品。
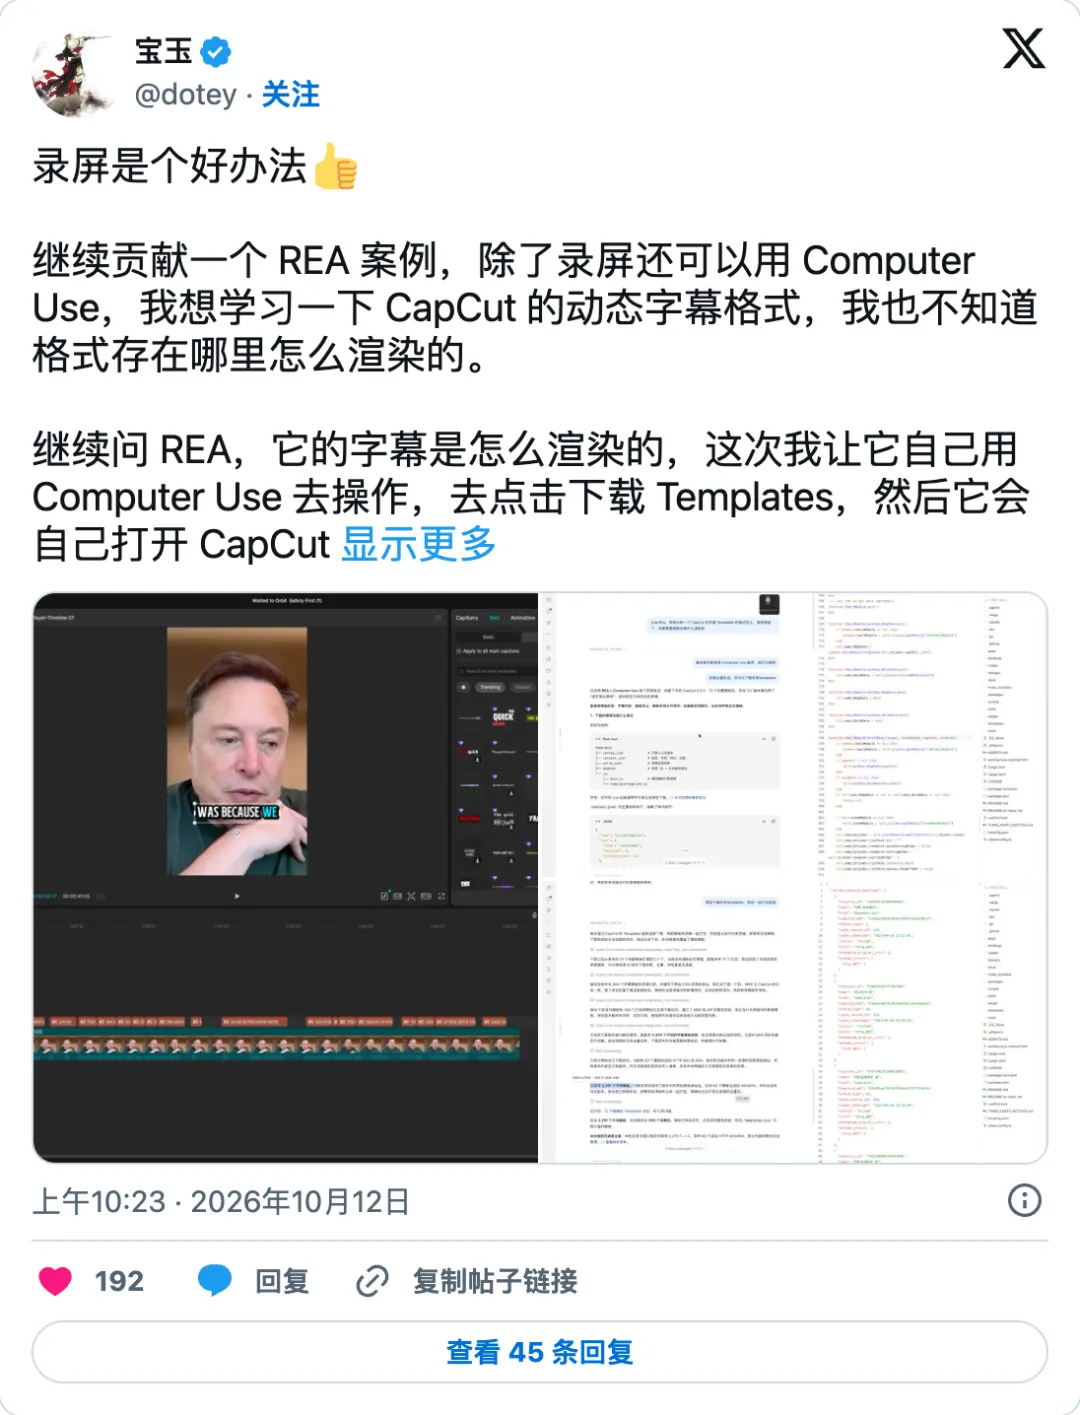
宝玉在做一个开源剪辑工具 BaoCut,缺两块,设计能力和动态字幕。设计那块,他去拆了 Claude Design,接进 BaoCut 以后,连 GPT-6.1 Sol 做设计都明显变好了。字幕那块,他让 Codex 用 REA 加上 Computer Use 自己打开 CapCut,一个个点下载字幕模板,同时盯着网络请求和文件存在哪。点了几十个,Codex 嫌太慢,自己拼出了下载地址,一口气下了 2,291 个模板。
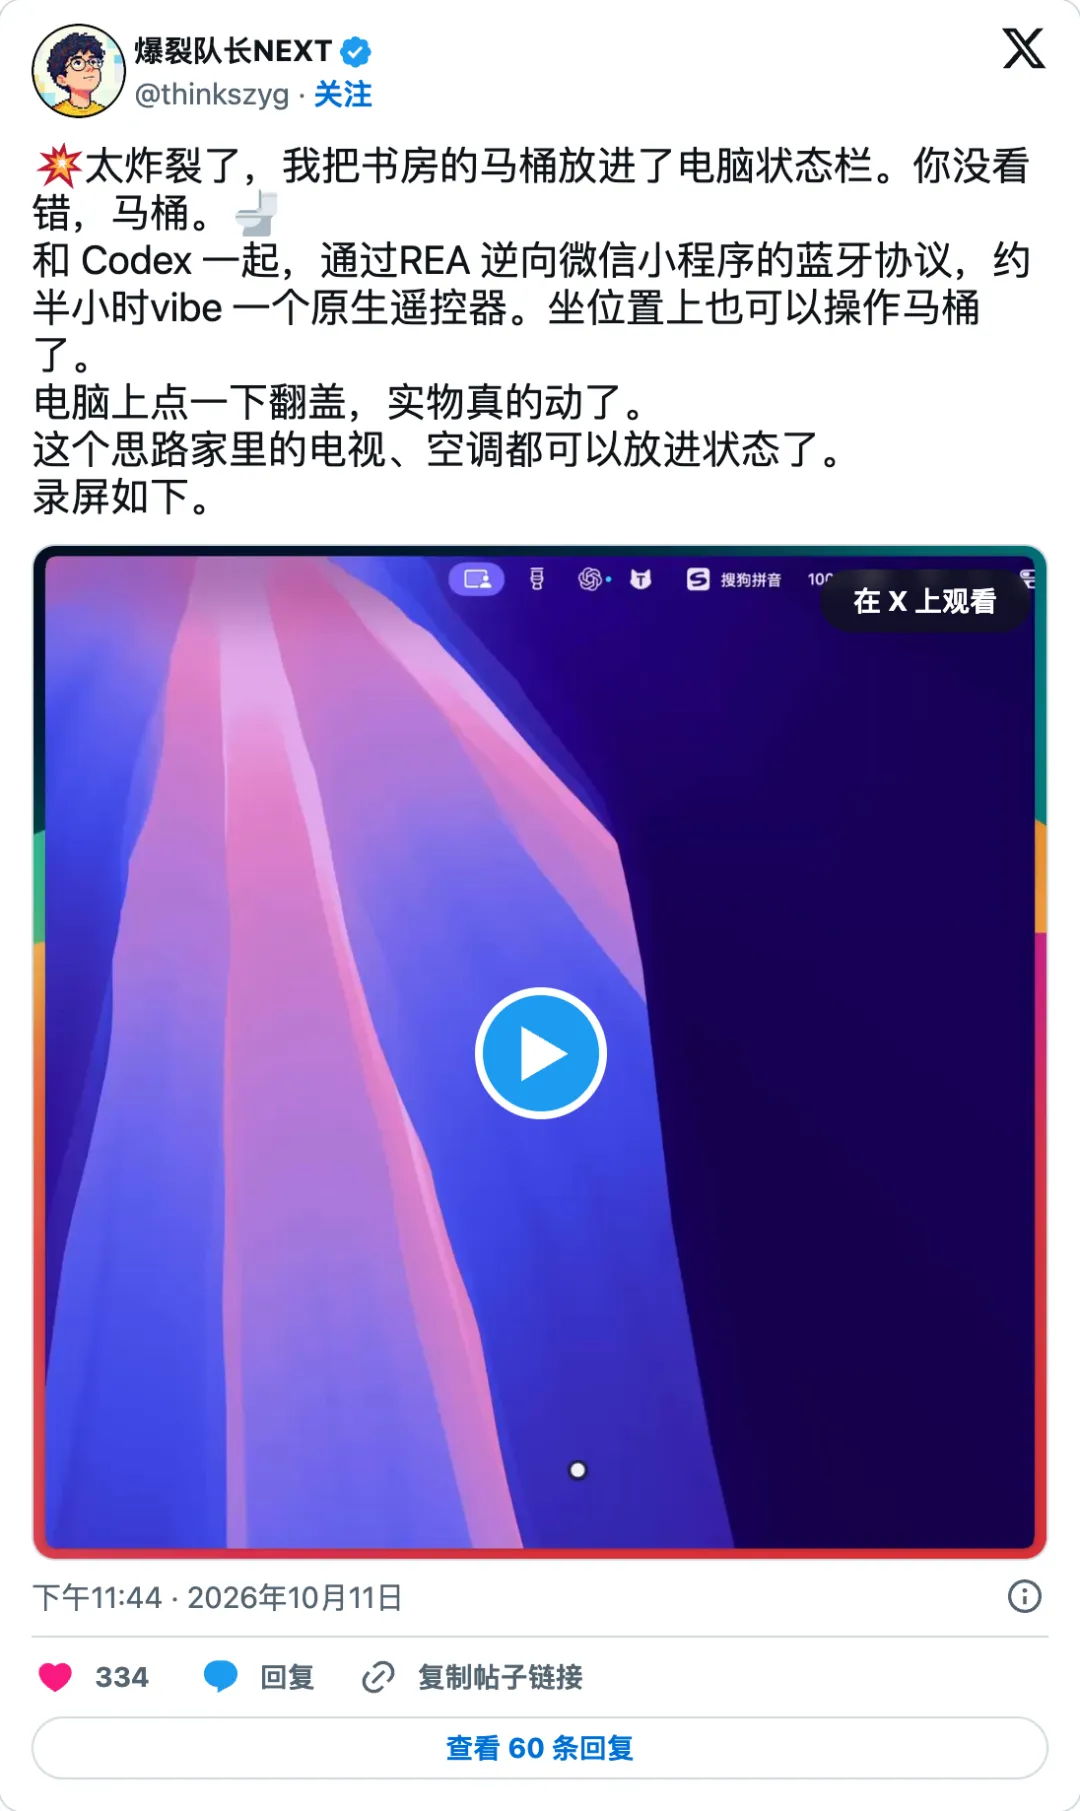
还有一位开发者嫌自家智能马桶的微信小程序难用,和 Codex 一起用 REA 逆向了小程序的蓝牙协议,半小时做出一个 Mac 状态栏遥控器。电脑上点一下翻盖,马桶盖真的抬起来了。又过了一个多小时,家里所有设备都进了那个状态栏。
我拆 Orca 也只为一个问题,它怎么判断 AI 的状态。最后带走的就一句话,别从屏幕上猜 AI 在干什么,让它自己报。以后谁要做同时管好几个 AI 的工具,这一招都用得上。
想自己试,四步就够
先装 Node.js,在终端敲一行 npx rea-agents setup,选你用的 AI 助手,Claude Code、Codex、Cursor、Gemini CLI 都行。它改配置前会先备份,让你确认。
然后把目标拿到本地。桌面应用的安装包本来就在你电脑里,网页的脚本可以直接下载,手机 App 可以连模拟器或者抓它的网络请求。
接着用大白话问。“用 REA 分析一下,某某功能是怎么实现的?”后面再补一句,“告诉我需要怎么配合。”这句是从宝玉那里学来的。他研究 Codex 内置浏览器的批注功能时就这么问,中间他配合点了一次,最后顺藤摸瓜发现 OpenAI 官方本来就提供了一个现成的接口。
最后拿着找到的证据,让 AI 写你自己的实现,跑起来验证。马桶那位点一下盖子真的动了,才算数。
我自己踩过一次坑,补两条。具体的词搜不到时别急着放弃,让 AI 直接去读打包后的代码,东西可能就在那里。还有,要求它把每条结论的来路标清楚,哪条是 REA 查到的,哪条是它从别处看来的,不然你分不清自己到底知道了什么。
它碰不到的地方
服务器上的逻辑根本不在你电脑里,REA 拆不到。值钱的东西以后大概会更多地留在云上。
项目声明里也写清了哪些忙它不帮,绕 DRM、绕授权校验、做外挂。X 上有人发帖说用 REA 拆了 TradingView,免费用付费指标,54 万人看过。这正是它反对的用法,也可能违反用户协议和版权法。逆向前先看清楚当地法律和软件的许可协议。
回到那条 360 万浏览的推文。软件里的做法确实越来越藏不住了。可我从 4,724 个文件里拿走一招,靠的是先知道自己要找什么,再一条条核对 AI 交回来的东西。
项目地址 github.com/morluto/rea