ARTICLE · 1193562
AI编程死循环,烧光80%额度:Claude Code 与 Codex 的三道熔断器配置
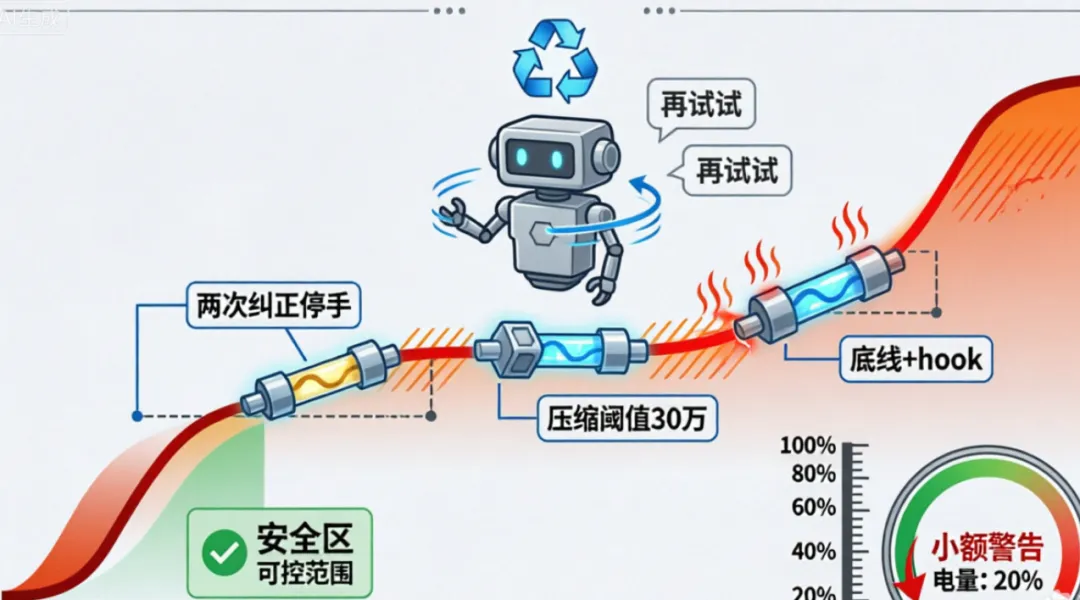
“抱歉,让我重新尝试。”这句话如果你用 Claude Code 或 Codex 修过 bug,大概率让你血压高过。10月9日以来,知乎、B站上“AI写代码死循环”的话题集中爆发。问题往往不在模型智商,而在我们的“催法”在给它喂毒。
先看两个真实数字
一位开发者的遭遇被反复转述:任务卡在死循环里反复重试,一夜之间把套餐用量从20%烧到80%。
更具体的是鱼皮的实测:用Claude Code修一个呼吸动画节奏的小问题,来回对话约10轮才修好,回头一看上下文占用已经涨到62%。
10轮小问题吃掉六成上下文。如果是二三十轮的死循环,上下文很快撑满——到那时候,AI开始忘记改过什么,甚至写出自相矛盾的代码。
为什么越催越错
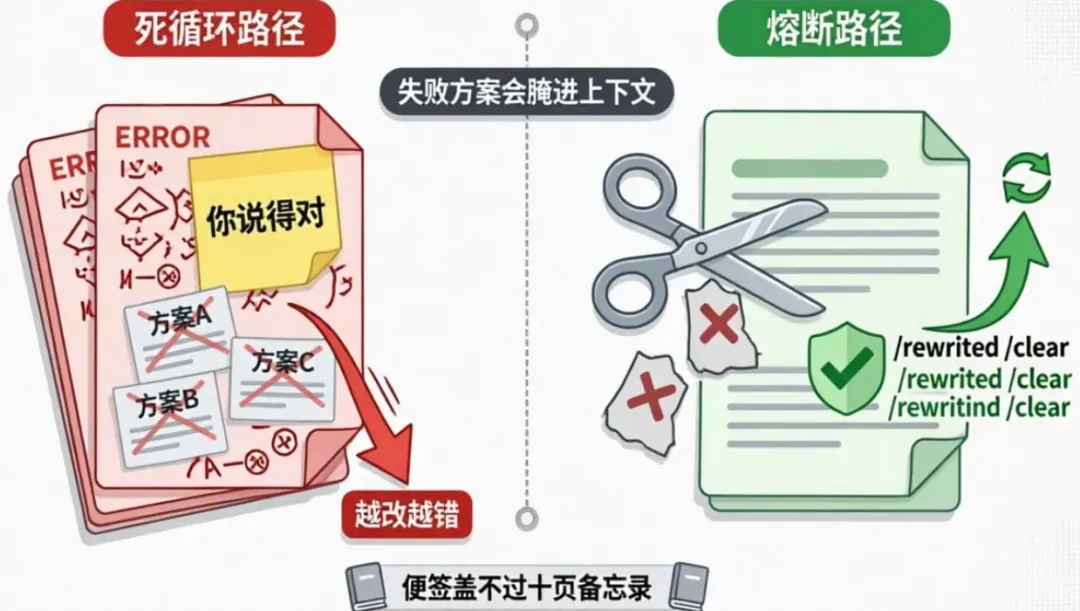
AI每失败一次,那个失败方案就留在上下文里。下一轮它不是从零开始想,而是带着前面所有错误尝试在猜。
打个比方:你的纠正是一张便签,贴在模型面前那份十页备忘录上。它每次都通读整份备忘录——那份又长、又自信的错误论证,权重就是比便签大。你说“不对,是内联对象”,它答“你说得对”,但错误论证还在赢。
Anthropic 官方把这种现象写进了最佳实践,叫“上下文被失败方案污染”,并给出了明确的停手线:
如果同一个问题你纠正 Claude 超过两次,上下文已经堆满了失败尝试。运行 /clear,用更具体的提示重新开始。
这就是社区说的“两次纠正停手令”。
三个信号:你已经陷进去了
1. 你纠正了,它同意“你说得对”,两三回合后原错误结论又冒出来
2. 测试A修好测试B挂,转头修好B,测试A又挂
3. 为了“让测试通过”,它开始改测试文件本身
第3条社区起了个名字:Overbaking(过度烘焙)。对AI来说测试文件和业务代码都是“能改的文件”,你只要求“让测试通过”,改测试就是最省事的路径。
熔断器一:用 /rewind 代替反复纠正
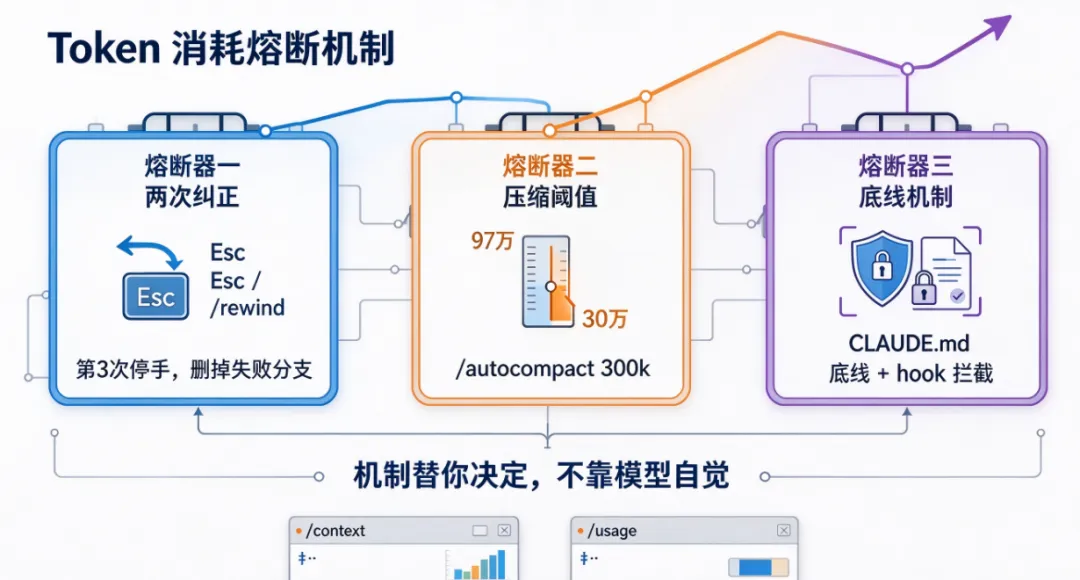
官方给的方案是 /rewind(连按两次 Esc),回到某个检查点重新提示。
它比“追加纠正”彻底:直接把失败分支从上下文里删掉,还能复用已缓存的上下文前缀,顺带省下重新上传的钱。
推荐的节奏:
●第1次:允许纠正,但必须给证据(报错输出、profiler 数据)
●第2次:允许,但立刻检查上下文水位
●第3次:停手。Esc Esc 回到“读完文件、还没动手”那个检查点;或者直接 /clear,用更具体的初始提示重开
熔断器二:把压缩阈值从97万调到30万
Claude Code 默认只在接近上限时才自动压缩——1M 模型上大约在 967,000 token。
问题是性能衰减不是断崖,是持续下滑的斜坡。等到97万才压缩,中间那一段你一直在用状态最差的模型干活。
# 把自动压缩阈值降到 300k/autocompact 300k# 或按百分比用环境变量控制exportCLAUDE_AUTOCOMPACT_PCT_OVERRIDE=30# 完全关掉自动压缩,手动控制节奏exportDISABLE_AUTO_COMPACT=1顺手查水位:
●/context:彩色网格显示谁在占窗口(系统提示、工具、MCP、记忆文件、消息)
●/usage:套餐额度用了多少(/cost 同义)
●自定义状态栏能拿到 context_window.used_percentage,把百分比常驻屏幕上
有一点必须知道:压缩是有损的。它只保证留下系统提示、CLAUDE.md、自动记忆、最多5个最近读过的文件、以及你调用过的 skills(单个上限5000 token,总量上限25000)。早期聊定的规则可能被压掉。
所以压缩要指定焦点:
/compact focus on the auth refactor, drop the test debugging也别连着压——每次压缩都引入一次摘要误差,多轮压缩会累积漂移。
熔断器三:把底线写进“会被重读”的地方
在对话框里临时写“不许改测试”,前几轮管用,聊十几轮它就忘了——因为那句话躺在会被压缩掉的对话历史里。
要做两件事:
1. CLAUDE.md 写死底线(保持精简,官方建议200行以内,它每轮都被读)
## 硬性底线 - 测试文件只读,禁止修改断言或删除用例 - 修 bug 不得修改测试来“通过” - 先复现,再定位,再改代码 2. 用 hook 做机械拦截
在项目 .claude/settings.json 里给测试文件加 PreToolUse 拦截,让“改测试”在工具层直接失败。规则靠模型自觉防不住,靠机制才防得住。
死循环姿势 vs 熔断姿势
场景 | 死循环做法 | 熔断做法 |
第1次改错 | “再试试” | 给报错/日志证据 |
第2次改错 | “还是不对,再试试” | /rewind 回检查点重提示 |
第3次改错 | 继续催 | /clear 重开,写更具体的初始提示 |
上下文60% | 无视 | /compact 带焦点压缩 |
测试过不了 | 允许改测试 | hook 拦截 + CLAUDE.md 底线 |
Codex 用户怎么落地
同样三道熔断器,Codex 的写法:
熔断器 | Claude Code | Codex |
停手重开 | /clear、/rewind | /new 开新会话,失败历史不带过去 |
压缩阈值 | /autocompact 300k | ~/.codex/config.toml 里 model_auto_compact_token_limit = 300000 |
查水位 | /context、/usage | /status 看剩余上下文 |
配置要写在所有 [section] 之前,改完重启客户端、开新会话才生效。想临时试:
codex -c model_auto_compact_token_limit=300000一个 Codex 专属的坑:默认上下文窗口大致卡在 272K–372K(有实测报告显示有效约 353.4K,而模型标称 1.05M),并且超过 272K 后是整次请求按更高倍率计费,不是超出部分加价。所以“三行配置开满 1M”这件事得配着账单一起看——窗口越大,注意力越散,钱也跑得越快。
死循环烧掉的不只是钱,是每周额度,也是模型的判断力。
三个动作:纠正两次就停手、压缩阈值主动调低、底线写进 CLAUDE.md 再加 hook。装好这三道熔断器,下次AI说“再试一次”的时候,让机制替你做决定。
本文基于 Anthropic Claude Code 官方最佳实践与上下文管理文档、10月9日以来知乎/B站社区讨论整理,具体命令请以当前版本文档为准。
往期内容推荐