ARTICLE · 1197477
2026年AI Agent的“成年时刻”:从实验室演示到万级智能体自主协作


2026年的AI领域有一个被反复提及的判语:AI Agent正在完成它的“成年礼”。如果用一个词概括2026年上半年到9月之间最值得关注的AI技术动向,答案不是某个更大的模型参数,而是“自主性”——AI正在从“你问我答”的工具,变成“你给目标、我来执行”的协作主体。
这个转变并非一夜之间发生。但2026年9月前后密集出现的几个事件,让我们第一次清晰地看到Agent自主能力的边界正在被持续刷新。
2026年9月,OpenAI公布了一项令人瞩目的成果:用约10,000个协调运行的AI Agent,在88小时内解决了一个困扰数学界近90年的流体力学难题——Navier-Stokes方程是否存在“奇点”的问题。
具体数据是这样:这1万个Agent之间交换了270万条消息,生成了约1300亿个输出token,最终产出了一份解析证明和Lean形式化验证代码。验证又花了额外17小时。OpenAI透露,他们使用的内部模型“显著强于GPT-6 Astra”,而GPT-6 Astra本身已是2026年9月初发布的最强公开模型之一[1]。
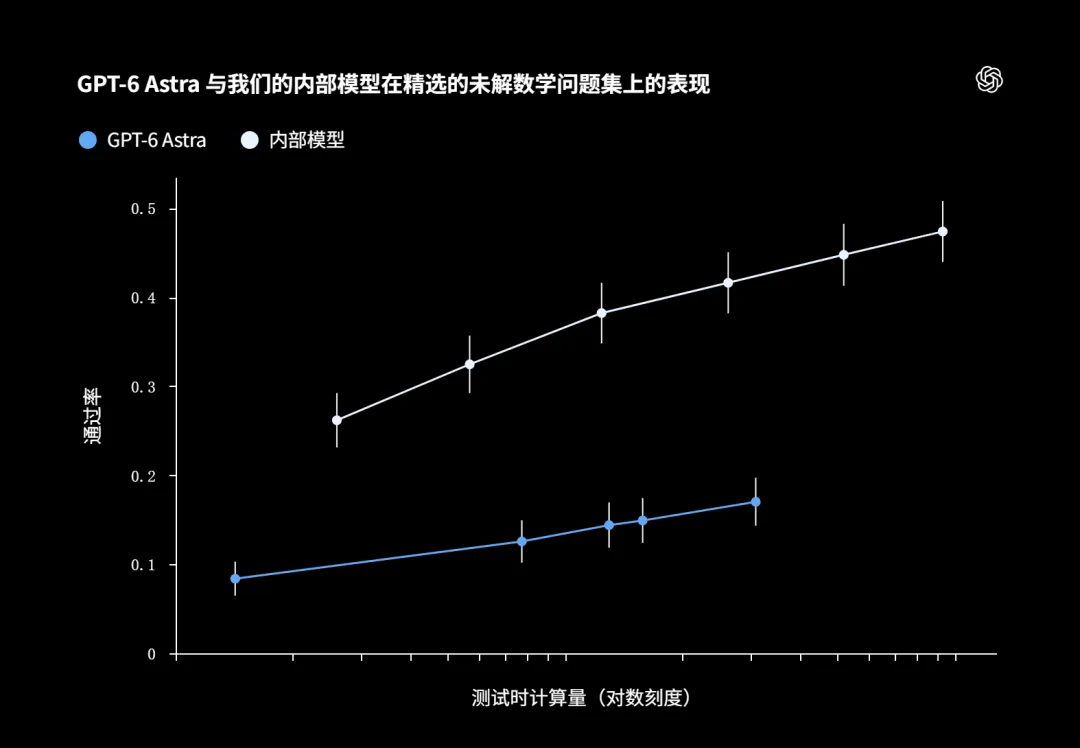
Navier-Stokes方程是克莱数学研究所2000年选定的七个“千禧年大奖难题”之一,确认解答可获100万美元奖金。OpenAI强调不打算申领奖金,因为证明尚未经过独立验证和正式接受。
但即使抛开“数学证明是否成立”的学术判断,这件事本身已经传递了一个强烈的信号:Agent系统正在具备处理超长程、大规模协作任务的能力。传统单模型推理在这个问题上的局限是显而易见的,90年来人类数学家都没能解决的问题,一个模型在一次对话中给出答案的概率微乎其微。而1万个Agent在近4天时间里持续交换信息、分配子任务、迭代修正,这已经不是在“回答问题”,而是在“组织研究”。
如果说OpenAI的实验展示了Agent协作的规模,那么9月8日发布的NeoHorse-1则指向了Agent能力的结构性变化。
基元律动联合无问芯穹,与清华、北大、阿里巴巴等机构推出了首个“Agent-Native模型”NeoHorse-1[2]。所谓Agent-Native,核心在于训练数据的本质不同:传统模型学习的是“题和答案”,NeoHorse-1学习的是“做事的过程”,即何时搜索、何时调用工具、工具返回了什么、下一步怎么走、走错了如何回头。
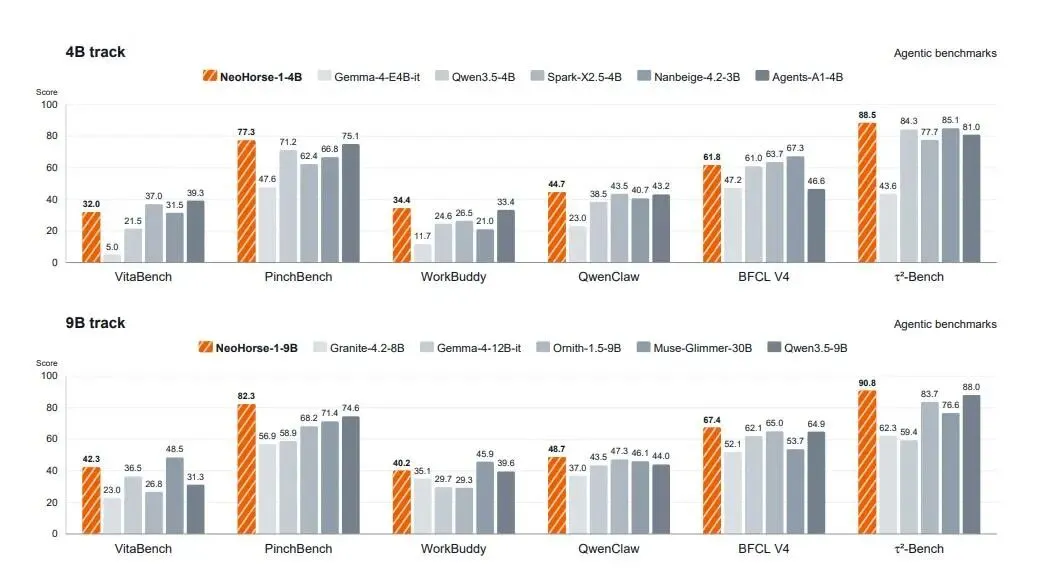
团队利用Agent执行轨迹中隐含的“路由难度信号”来组织课程学习,让模型先接触低难度轨迹,再逐步过渡到复杂的长程调试场景。结果是,仅4B参数的NeoHorse-1在10项Agent基准评测中,未加权平均分位居同类模型之首,在五项基准上超过了Qwen3.5-9B底座模型;9B版本则在复杂状态维护和失败恢复中保持明显优势。
这个方向的深层含义在于:未来的Agent能力可能不再依赖于“把工具塞给一个通用模型”,而是从训练阶段就让模型“长成”一个Agent。工具调用不再是外挂的能力,而是模型的内生本能。
更早一些的2026年5月,阿里发布的Qwen3.7-Max提供了一个更“硬核”的自主执行案例。
测试平台是平头哥真武M890,一款刚发布的训推一体AI芯片,内置144GB显存,片间互联带宽800GB/s,性能达到上一代真武810E的三倍。模型面对的是一个完全陌生的硬件架构:没有芯片架构文档,没有性能分析数据,也没有针对新架构的示例内核代码。工作空间的初始内容仅有任务描述、一个参考实现和评测脚本。
Qwen3.7-Max从这个近乎空白的状态出发,自主编程并持续运行了35小时。在此期间,它完成了432次内核评估和1158次工具调用,全流程涵盖内核编写、编译、性能瓶颈分析、迭代优化以及编译错误的自我诊断与纠正,最终实现推理速度提升10倍[3]。整个过程没有任何人工接管,也没有出现中途偏离目标的情况。这不是“模型在演示中跑了一个长任务”,而是一个完整的工程闭环,从规划到执行再到验证,全部由Agent自主完成。
团队在事后分析中指出,长程自主执行的关键瓶颈不是单步推理能力,而是“状态维护”:在几十小时、上千次工具调用之后,模型是否还能记住目标、保持策略一致性[3]。Qwen3.7-Max的测试表明,这个瓶颈正在被突破。其技术文档提到“原生思考保留”机制,允许复杂的推理轨迹在多个执行轮次之间持续存在。这意味着模型不是在每次工具调用后重新构建上下文,而是将中间推理状态作为一等公民来管理,从而在长时间运行中保持策略的一致性。从架构上看,Qwen3.7-Max采用万亿级MoE架构,每Token仅激活约220亿参数,原生支持100万Token上下文窗口,使模型能够在超长文本和数万行代码中维持跨文件、跨步骤的逻辑关联。
这个案例的意义不在于“模型会写内核代码了”,而在于它验证了一种能力:Agent可以在长时间跨度上自主完成复杂工程任务,并保持目标一致。这种能力一旦成熟,就不会只停留在芯片设计领域。它正在向翻译等知识工作场景渗透,成为下一代翻译工具的基础设施。而这一趋势,在2026年的翻译产品中已经可以看到清晰的落地痕迹。
2026年8月,网易有道宣布其全线AI Agent产品矩阵完成DeepSeek-V4-Flash正式版接入,覆盖有道翻译、有道AI同传、全场景办公助手LobsterAI等产品[4]。其中,“同传Agent”早在2026年3月就已推出。用户打开耳机同传功能后,Agent会自主完成语音识别、翻译、术语匹配和输出管理的全流程,而非简单地把识别结果送进翻译引擎。
同传场景对Agent的要求,与第三部分的工程案例在逻辑上高度一致。会议进行中,术语偏好可能变化,上下文不断累积,发言人可能切换话题,Agent必须持续跟踪这些信息并保持翻译策略的一致性。本质上,同传Agent面临的同样是状态维护问题,只不过对象从芯片内核变成了语言和语境。
这意味着翻译场景中的Agent已经不再停留在论文原型阶段。当底层模型具备了长程状态维护和自主纠错能力,翻译Agent才有可能从“一次翻译”走向“一场会议的全流程管理”,持续跟踪上下文、动态调整术语策略、在译员和听众之间扮演协调者角色。
把这几件事放在一起看,2026年AI Agent的演进呈现出一条清晰的线索:在规模上,从单个Agent走向万级Agent协作;在架构上,从“调用工具的通用模型”走向“Agent-Native模型”;在时间尺度上,从分钟级交互走向小时级甚至日级的自主执行;在场景落地上,从实验室走向同传耳机和办公助手。
对翻译专业的学生和从业者来说,真正需要关注的不是“Agent会不会取代译员”这个老问题,而是当Agent能够自主管理一场翻译任务的全流程时,译员的角色将如何从执行者转向目标设定者和质量仲裁者。你需要告诉Agent这场翻译的读者是谁、术语偏好是什么、哪些内容可以意译、哪些必须严格对应,这些判断本身正在成为新的核心竞争力。Agent的“成年”不意味着人的退场,而意味着人与机器的分工正在被重新书写。
本文转自“前沿翻译技术”微信公众号
原创:董金泉
转载编辑:刘倩宇
审核:丁羽翔
终审:王华树、赵文利