ARTICLE · 1198533
八千亿参数直接免费下载,普通人搬两台电脑真能捡到大便宜吗
把一个总参数达到 8160 亿的庞然大物直接打包放上网,让人免费下载,甚至还宣称只要在自家的办公桌上摆两台苹果电脑,就能把它当场跑起来。
2026 年 10 月 15 日,Meta 正式放出了名为 Muse Spark Open 的开放权重模型。它的总参数规模达到 8160 亿,每次推理却只调动其中约 420 亿参数,同时能吞吐多达 100 万个输入输出单位的超长上下文。官方博客更是直接给它扣上了一顶耀眼的帽子:迄今为止能力最强的美国开放权重模型。
但只要你稍微细看几眼官方自己贴出来的测试榜单,就会发现一个令人有些发懵的现象。在综合智能指数上,这个刚出炉的美国头牌拿到了 39 分,不仅没能登顶,反而落后于一帮老对手:GLM 5.3 拿了 45 分,Kimi K3 是 44 分,两万多亿参数的 Qwen3.8 也拿到了 40 分。甚至在几天前的 10 月 12 日,Meta 自己刚刚闭门推出的闭源旗舰 Muse Wonder,跑分也远远压它一头。
一边喊着最强,一边把真正压箱底的东西藏在门后,还附赠一套动辄要花上几万美元的桌面部署指南。这场看似慷慨的巨头大放送,到底藏着怎样的算盘?
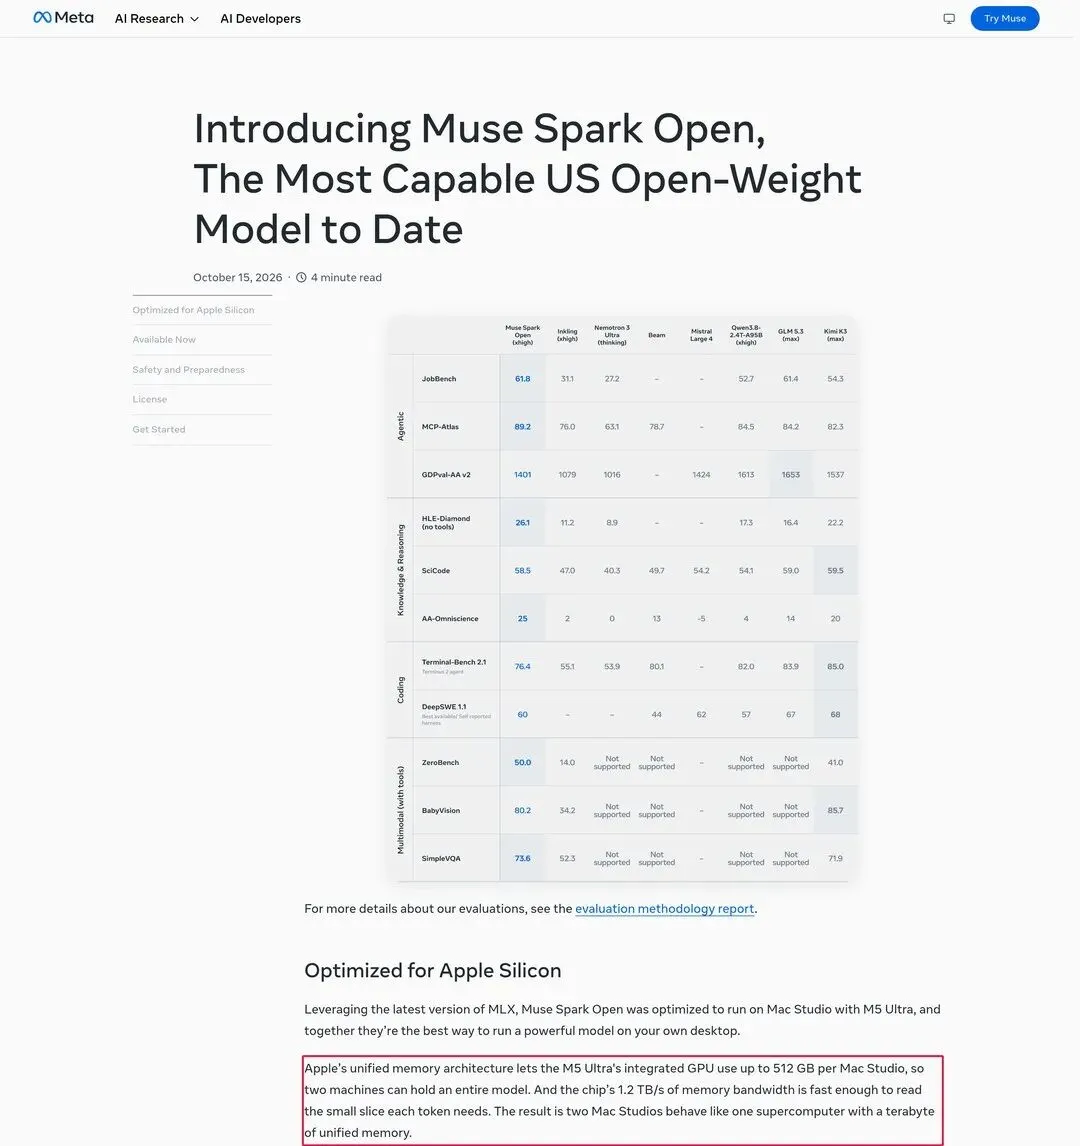
Meta官方博客:双Mac运行规格
一、为什么 8000 多亿参数的巨无霸,每次干活只动用二十分之一
在以往的直觉里,模型体积越大,需要的算力就呈指数级飙升。一个超过 8000 亿参数的模型,过去如果想让它动一下,机房里密密麻麻的加速卡非得同时咆哮不可。但这一次,Meta 却表示普通机构甚至能用更低成本把它跑起来,这是怎么做到的?
说白了,Meta 在这里彻底抛弃了那种全员上阵的硬拼路线,转而采用了一种类似大医院专家分诊的稀疏混合专家结构。在模型的 62 层架构中,藏着整整 256 个各怀绝技的专家模块,这些专家几乎占满了整个模型 97% 的参数量。当一段任务指令输入进来时,模型并不会让所有专家一拥而上,而是通过一套精巧的路由机制,在每一层仅仅挑选 8 位最对口的专家出面应战。
这样一来,尽管总共有 8160 亿参数常驻在显存里严阵以待,但在实际处理每一个计算动作时,真正被激活干活的只有大约 420 亿参数。算力开销被死死压在了 420 亿的小体量级别,但它背后依托的,却是 8000 多亿参数沉淀下来的庞大知识储备。
问题就出在这了:既然每次只用一小部分,那为什么不能只下载这 420 亿?答案是,你永远不知道下一句话需要哪位专家出马,所以所有专家都必须寸步不离地待在显存里备战。按最标准的 16 位浮点数格式计算,整套权重光是装进硬盘就需要大约 1.5 吨位级别的空间,也就是 1.5TB。如果要用传统硬件部署,往往需要跨越 4 台各插了 8 张先进加速卡的专用服务器,通过 32 路并行才能勉强撑开。
为了不让高昂的硬件门槛把人吓跑,Meta 与芯片厂商在这里玩了两手极深的底层压缩。他们先是在进入专家层之前加入了一套压缩机制,把原本宽大的数据通道瞬间切窄一半,等专家处理完再还原回去,单这一招就直接砍掉了将近一半的投影层参数。紧接着,他们拿出了专为最新一代硬件定制的 4 位低精度量化版本。在精度几乎不发生察觉损耗的情况下,这套原本重达 1.5TB 的庞大身躯,被硬生生压成了大约 540GB 到 700GB 的显存占用。原本需要一整个机架才能吞下的怪物,如今被强行塞进了一台单独的高性能服务器节点里。
甚至在长达 100 万单位的上下文处理上,他们也没有采用每层都看完全文的笨办法,而是在 62 层里安排了 46 层只看身边局部窗口的窄视角层,仅仅留下 16 层做统揽全局的宽视角层。这种混合处理方式,让处理超长文本时的缓存压力直接骤降到了原本的四分之一左右。
二、两台苹果电脑拼出超级计算,普通人真的能在桌面上玩转吗
如果说数据中心里的压缩还只是常规操作,那么 Meta 宣称能让它跑在办公桌上,才是真正彻底点燃技术圈好奇心的火星。
你可能很难想象,官方给出的桌面运行方案,竟然是把两台搭载苹果 M5 Ultra 芯片的桌面电脑并排放在一起。Meta 官方甚至把它形容为一台拥有 1TB 统一内存的个人超级计算机。在他们的官方演示中,这套系统不需要连网,完全在本地就能驱动专门的代码工具,给开源软件修改代码缺陷、增加新功能,甚至能直接接管专业剪辑软件,把横屏视频逐帧分析并裁切成竖屏。
但这里面的技术账和经济账,普通人一算就会发现完全不是那么回事。
苹果能够参与这场狂欢的唯一底气,在于其芯片内部极为特殊的统一内存架构。在普通电脑里,图形显存和系统内存各走各的道;但在苹果这套顶级芯片上,高达 512GB 的大容量内存可以被图形处理器直接以每秒 1.2TB 的极高带宽快速吞吐。当两台各自顶配 512GB 统一内存的机器放在一起,刚好能拼出大约 1TB 的共享空间。借助最新的专用机器学习底层框架,两台电脑通过雷雳五代数据线直接串联,利用超低时延的远程直接内存访问技术,把模型像切香肠一样一边分一块,或者把每一层按宽度切分后协同计算。
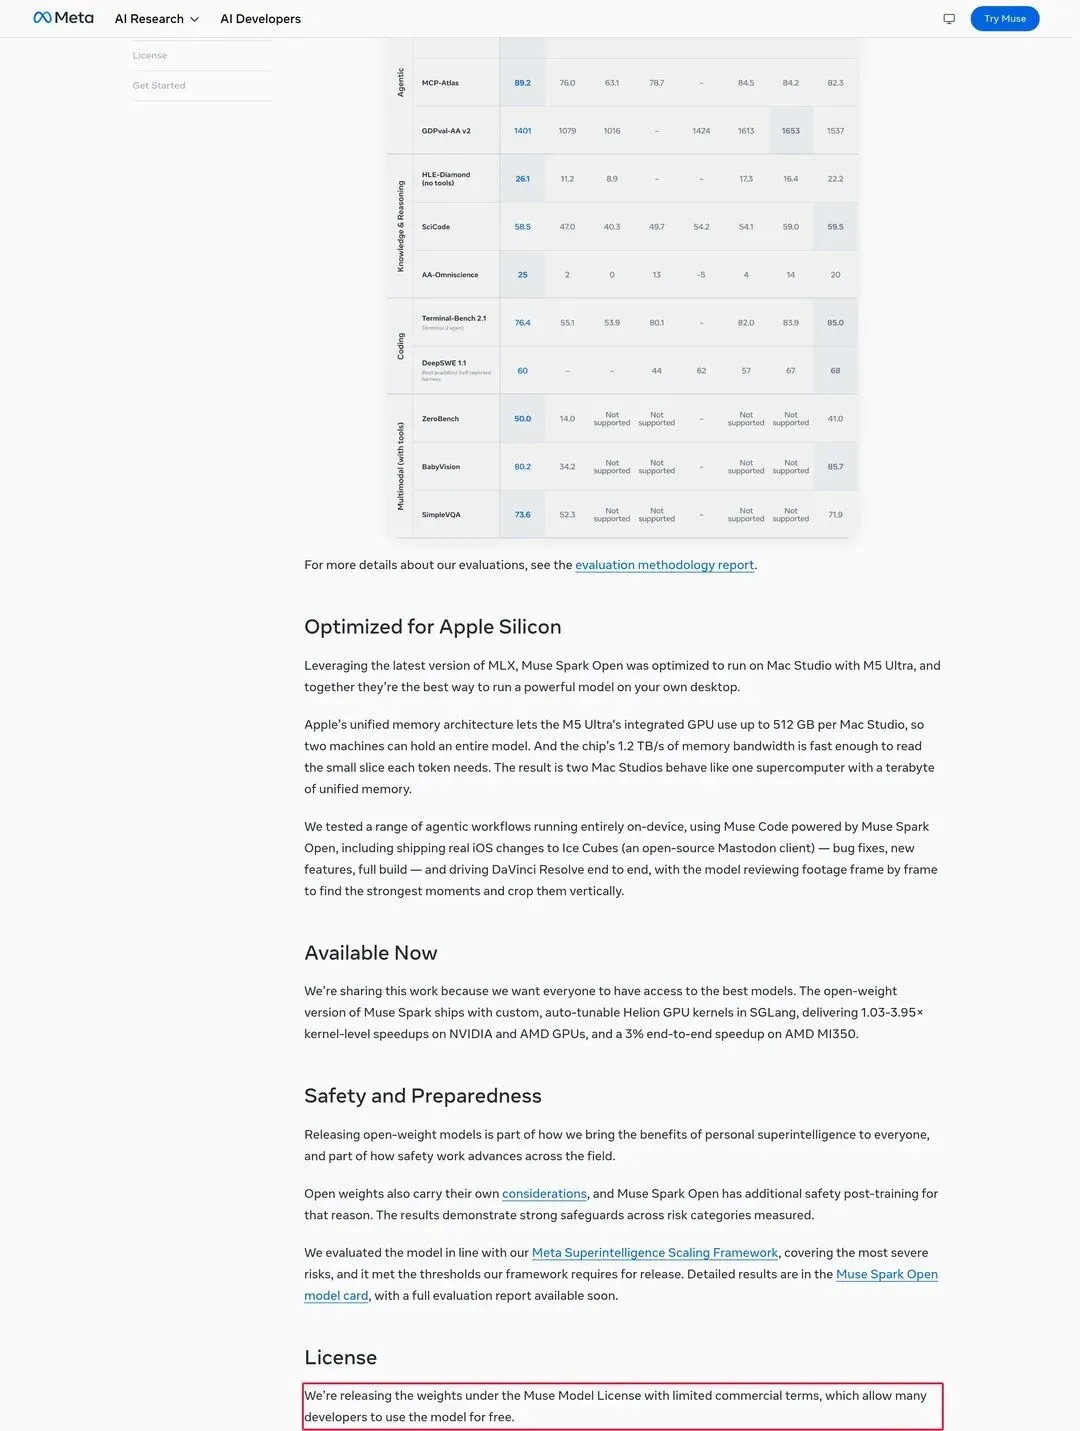
Meta官方公告:模型授权条款
苹果自家的测试数据显示,如果用四台机器组网,每秒钟输出的速度可以达到 36 个单位以上,这已经明显超过了普通人类的平均阅读速度。相比前代芯片,生成首个反应结果的时延更是缩短了整整 4.6 倍。
可浪漫的极客画面背后,是一张让人倒吸一口凉气的账单。
首先,能够支持单机 512GB 统一内存的苹果机型,官方要到 10 月底才会正式上市,价格甚至都还没公布。作为参考,现款 256GB 内存配置的同级别工作站,单台售价就高达 10799 美元。这意味着如果想要凑齐 1TB 的内存容量,光是购置四台机器的硬件成本就超过 4.3 万美元,折合人民币接近 30 万元。
更现实的是,即便你在本地千辛万苦搭好了这套昂贵的工作站,如果你只用两台机器以最基础的流水线方式运行,它的生成速度每秒只有大约 15 个单位,稍微加长上下文,处理首批数据的等待时间就能长达近一分钟。换句话说,桌上造超算的宣传确实在工程上被证明跑通了,但它目前依然是极少数顶尖研究者或不差钱极客的昂贵玩具,离普通开发者的办公桌还隔着厚厚的一层美钞。
三、标榜最强却打不过闭源旗舰,扎克伯格到底在下一盘什么棋
既然费了这么大劲把参数拉满、把本地运行的噱头做足,为什么 Meta 不干脆把自家最厉害的技术毫无保留地拿出来?
只要把时间指针往回拨三天,你就会看到 Meta 极其现实的商业面孔。就在放开这款开源权重的三天前,即 10 月 12 日,Meta 刚刚发布了真正的闭源王牌 Muse Wonder 以及更高阶的完整版。在那套衡量大模型综合能力的权威评测中,闭源的旗舰模型跑出了 52 到 56 的顶尖高分,而在专门考量编程能力的复杂智能体测试中,更是拿下了 68 分的傲人成绩,直接追平了业内最顶尖的闭源标杆。
相比之下,今天大张旗鼓开源的这个大块头,跑分只有 39 分。面对这种反差,Meta 首席人工智能官在接受彭博社采访时丝毫没有掩饰,甚至直接道破了天机:出于安全性和能力两方面的考虑,我们通常不会开源我们最强大的模型。但他紧接着又补了一句意味深长的话:世界上大多数人工智能都将运行在开放模型上,它们应该是美国的。
这句话撕开了巨头竞争最核心的战略幕布。在过去近两年时间里,无论是阿里巴巴的 Qwen、月之暗面的 Kimi,还是智谱的 GLM,在开源权重领域都展现出了极强的统治力。在各类软件工程和复杂代码生成的实际战场上,这些早已发布的开源先行者一直占据着排行榜前列。Meta 冠上的这顶迄今能力最强的美国开放权重模型帽子,前面最关键的限定词,其实是美国这两个字。
在这场追赶背后,Meta 悄悄构筑了一套阶梯极其分明的商业防线。最底层的轻量模型完全遵循极度宽松的开源协议,免费任人拿去折腾;中层的庞然大物虽然开放了参数权重,但扣上了一份极其严苛的专属许可协议。这份协议明确规定:只要任何第三方企业利用这个模型包装成对外提供服务的接口,且过去 12 个月内总营收超过了 2000 万美元,就必须坐到谈判桌前,找 Meta 另行签订书面协议交钱。不仅如此,所有使用该模型做出来的产品,甚至哪怕是经过二次修改衍生的产品,都必须在软件界面、设置菜单或文档里显眼地标注上源自该模型的字样。
大模型分层演进与生态部署架构示意
而在最顶端、真正赚钱的企业级专业高难度任务上,Meta 则用高昂的订阅费和按量收费的闭源接口牢牢把关。一个处理长篇大论要花 20 美元输出费用的闭源旗舰,才是他们准备从企业口袋里掏真金白银的工具。
这场声势浩大的开源盛宴,说到底从来不是一次不计回报的慈善施舍。它是一场精心计算过的生态合围:用次顶级的庞大参数稳住开发者的心智,把品牌标签强行贴进成千上万的应用底层,再用高耸的商业壁垒防备潜在的商业竞争对手。那个曾经毫无保留把核心技术摊在阳光下的开源斗士,如今在商业现实的催化下,已经彻底熟练地玩起了门里做生意、门外赚吆喝的双面游戏。