ARTICLE · 1202629
做服装电商想用 AI 出图?2.6 万张的经验,这篇够了
做服装电商的,应该都动过这个念头。
模特图,能不能让 AI 出?
我们也动过。最早的做法特别朴素。开一个对话窗口,把衣服图和模特图丢进去,等它出一张。不满意,改提示词再来。满意了,复制下来,再拿去 PS 修。提示词记在一个文档里,用的时候复制粘贴,好不好全靠人眼盯着看。
一天下来,也就几套图。
现在呢?
到今天,系统累计出了 2.6 万张图。8、9 两个月,平均一天 140 张上下。出到最后也没出成的图,从一成降到了千分之三。
更有意思的是,干活的主力模型从 3 月到现在,一直没换过。
同一个模型,差别在哪?
差别全在模型外面那一圈。 提示词怎么写,怎么管,系统怎么搭,怎么让它自己跑起来。
这半年我们一边出图一边踩坑,踩出来 12 条经验,按这个顺序摆在下面。做服装电商、想用 AI 出图的,可以先存着,用到哪条翻哪条。不一定条条适合你,挑能用的拿走就行。
开始之前,先花半分钟看一张换装图是怎么来的。
它要三样东西。衣服的商品图,一张模特底图(我们管它叫母图),还有一段提示词。中间还多一步,叫过渡图,先把母图上模特身上的衣服换成一件白色紧身衣,姿势和背景就此定住,再往上「穿」真衣服。
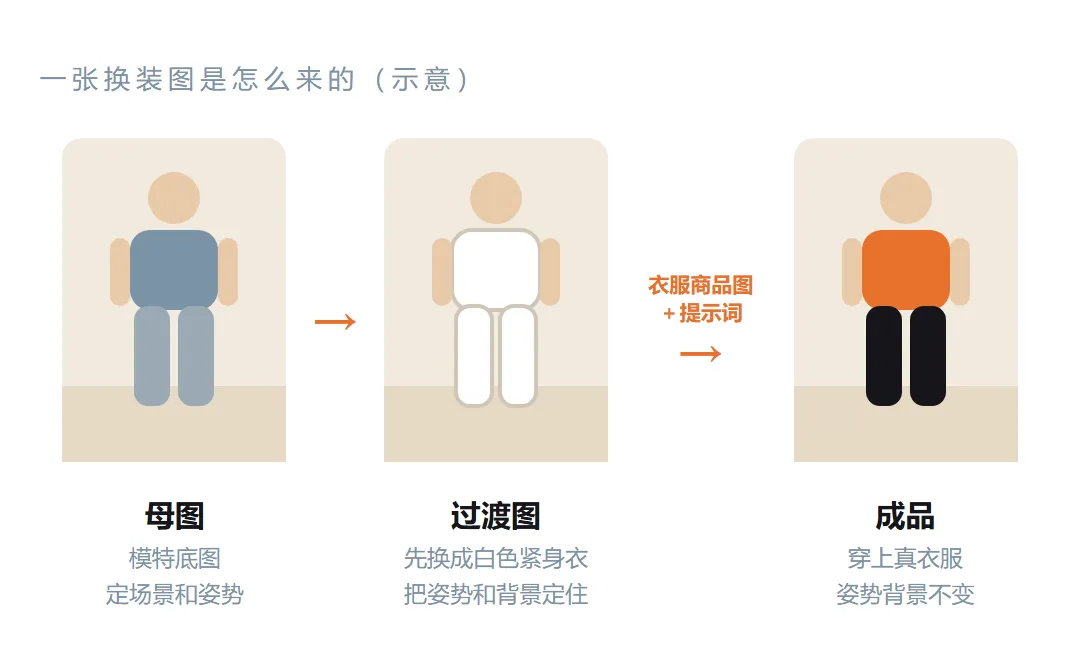
就这么个流程。坑全在细节里。
第一部分
提示词怎么写
经验 01
先把硬约束写全
6 月,运营拉了一张反馈表,专门收集出图的毛病。没几天,攒了 13 条。
自己换了个姿势的。把背景换掉的。四肢少了一截的。袜子上长出脚趾的。
还有一张,模特多了一只脚。
三只脚。。。
回头翻提示词,问题其实很简单。那时候的提示词非常短,就是让它把衣服换上去。姿势要不要跟母图一模一样?背景能不能动?人体结构要不要正常?一个字都没写。
它不知道,只好自己发挥。
于是有了第一版核心模板,把姿势、背景、服装还原、人体结构,一条一条写死。
你没说的,它就自由发挥。 这句话,后面还会反复出现。
经验 02
能用图说的,别用字说
7 月,运营又来反馈。出图的姿势跟母图对不上。
母图上,模特是侧身跪坐,脸朝着一边。出来的图,被转成了一个标准的背影。更怪的是它时好时坏,同一张母图、同一段提示词,这张对,过几分钟下一张就错。
查到最后,问题出在一句话上。
母图是背面的时候,提示词前面会多一句「模特背向镜头」。
这句话本来是好心,想帮模型认清朝向。模型可不这么理解。它把这句描述当成了命令,乖乖把人转成了正背面。
我们做了个对照。带着这句话出 9 张,姿势对了 6 张。删掉这句话,9 张全对。
母图就摆在那儿,朝哪边一目了然,根本用不着文字再说一遍。
原理 | 条件生成(Conditional Generation)
现在主流的出图模型,都是「按条件生成」。你给它的每一张参考图、每一个字,都是它要满足的条件,最早把这套机制讲清楚的是 2022 年慕尼黑大学和 Runway 的潜在扩散模型论文(Rombach 等)。条件不分「描述」和「命令」,进了提示词的,一律照着画。所以文字和参考图说的不是一回事时,经常是文字赢。我们后来的规矩是,参考图上看得见的东西(朝向、姿势、背景),提示词里一个字都不重复。
经验 03
只写你要的,别写你不要的
这个坑,是我们自己改提示词改出来的。
9 月出一批陈列图,有件上衣凭空长出了侧边抽绳。原图上根本没有。
我们觉得是约束不够,就在提示词里加了一句。不得增加参考图里没有的结构,比如抽绳、绑带、开衩、口袋、荷叶边。
重出一看,抽绳没消失,搬家了。
上衣是对了,抽绳长到了原本没有抽绳的裤子上。另一张的下摆,多出一个抽绳打的蝴蝶结。还有两张,把衣服上真实存在的拼接给弄丢了。
我靠。
多画一根抽绳,一眼就能看出来。丢掉一块真拼接更隐蔽,衣服看着只是素了一点,得拿着原图一处一处对,才发现少了东西。
原理 | 为什么「不要」不管用
出图时,模型会对比「带提示词」和「不带提示词」两种画法,再往带提示词的方向使劲推。这个做法叫无分类器引导(Classifier-Free Guidance),出自 2022 年 Google 的 Ho 和 Salimans。提示词里出现的每个词都在往画面里推,「不」这种小词几乎没分量,「抽绳」两个字却实打实进了条件。这也是很多出图工具要单独开一栏「负面提示词」的原因,想排除的东西,得放进专门往反方向推的那一栏,而不是写在正文里说「不要」。
后来的写法,是只做正向表述,一个结构名都不提。「严格照参考图复现服装本身,版型、长度、拼接位置、系带方式都以参考图为准。」我们还加了一道检查,约束句里只要出现具体的结构名,就过不去。
顺带提一句,这条只管出图。写文案的文字模型,「禁止提及某某」通常是管用的,别一刀切。
经验 04
没锁死的地方,它按「常规」去补
试穿功能里有一种搭法,两件上衣,一件外穿,一件内搭。
结果时不时出来两个人,一人穿一件。
想想也合理。两张上衣图摆在一起,最常见的情况,就是两个人各穿一件。你没说清楚,它就按最常见的来。
改法是补一句话,写明只有一位模特,外面穿哪件,里面穿哪件。改之前 5 张里只有 2 张是一个人,改完 5 张全对。
你在意的每一处,都得有个锚。 要么拿参考图钉住,要么用文字写死。两头都没管的,就是它自由发挥的地盘。
经验 05
图上看不清的地方,补一张细节图
8 月,一件黑色连体衣,门襟上一排扣子,出图老是画错。数量不对,排法也不对。
原因很简单。黑衣服配黑扣子,在商品图上几乎看不清,提示词里又没提一个字。模型看不清,也没人告诉它,只能瞎编。
我当时提的需求,原话是这样的。「是否可以再添加一个细节图,指定某个服装部分的细节,细节图的颜色可以和服装图不一样,提示词写明只使用细节款式不适用颜色。」
先做实验。补一张门襟特写,6 张扣子全对。不补,3 张全错。
更有意思的在后面。手头的门襟特写,有一张是同款的红色。我们在提示词里写得明明白白,只参考款式,不准用它的颜色。
结果 3 张里有 1 张,扣子变红了。
改成先把特写转成黑白灰再喂进去,3 张都没串色。
指令拦不住的东西,就别靠指令。 颜色是画面上的事,那就在画面上处理掉。这跟前面的抽绳是同一个道理,它认的是画面,不是语法。
细节图后来变成了一个通用的办法。哪个部位总画不对,就给哪个部位补一张图,衣长不准就补一张衣长参考。
经验 06
图说不清的事实,用标签补成文字
9 月底做了一次对拍,又翻出一个大坑。
一查才发现,提示词里描述衣服本身的那一段,一直是空的。也就是说,提示词对衣服长什么样,从头到尾一个字都没说。
模型只能盯着一张两三百到四五百像素的商品图猜。于是平滑的面料被画成了罗纹,腰头上凭空多出一个 logo。
补法分两手。
第一手,用标签把事实补成文字。 我们给每件衣服打了标签,面料、光泽感、图案、下摆、衣长、腰头、裤型、裤长,都是从一张固定的词表里挑。出图时拼成一句话放进提示词,像这样。
「上衣,面料棉麻、光泽感哑光、图案纯色、衣长及腰。」
有个小细节,每个值前面都带着维度名。单写「哑光」两个字,模型可能理解成打光打得暗;写成「光泽感哑光」,它就知道说的是面料。这句话还限了 60 个字,太长会把前面最核心的那句话冲淡。
第二手,图太糊的,压根别让它进门。 一张 296×497 的商品图,出 6 张,有 4 张把光面画成了罗纹。换成高清图,4 张全是平的。一盘点,正面图里有 48% 不够清楚。
于是加了一道门槛,像素不够的衣服图,提交的时候就拦下来,红字标出是哪一张、差多少。
第二部分
提示词怎么管
经验 07
措辞交给运营,拼装留在系统里
最开始,提示词是放在文档里管的。
出一张,人眼看一眼,不行就手动重试,再去文档里改提示词。这种做法起步快,毛病也明显。文档里那版和实际在用的那版,靠人记着同步。谁改了哪句、为什么改,说不清。好用的写法,留在某个人自己的文档里。
后来提示词一步步搬进了系统。先是系统按规则自动拼,6 月有了核心模板,改提示词变成了改模板。
但还有一大块,写死在程序里,改一个词就得发一次版。运营想调一句话,得找开发,排期,上线。
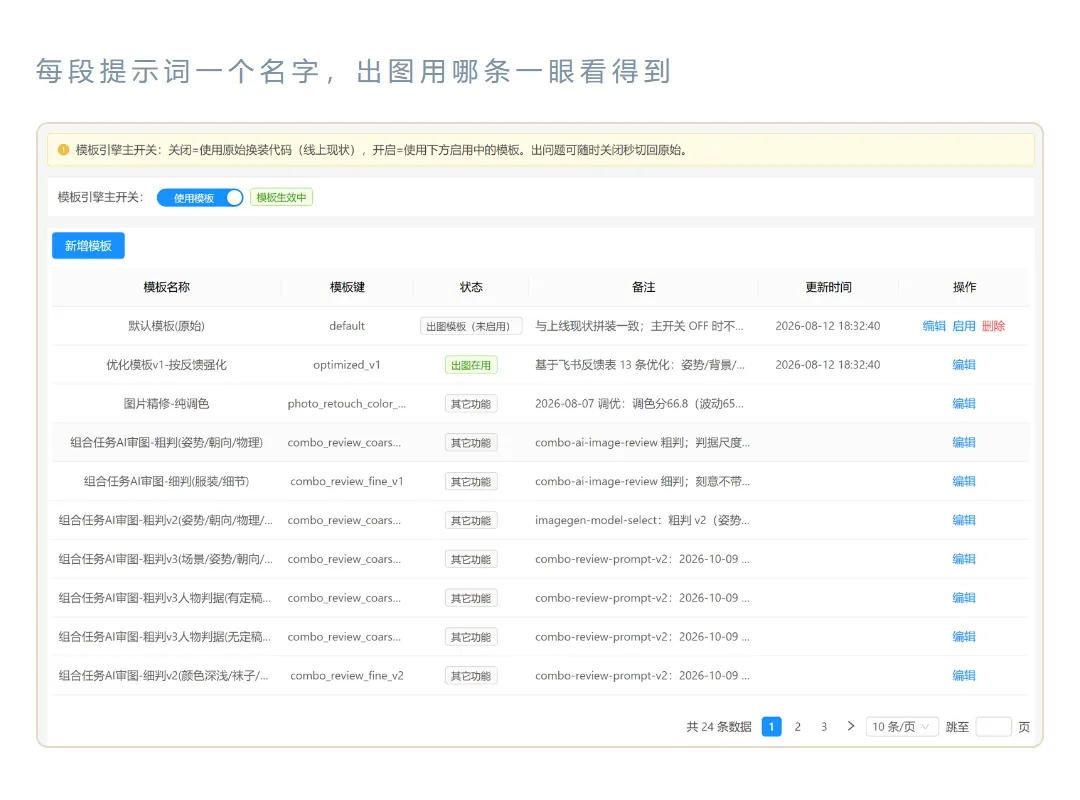
10 月中,我们把能改的那些话都搬到了页面上。
原则就一句,措辞交给运营,拼装留在系统里。 每一段话在页面上占一个格子,运营改完点保存,下一张图就生效。拼哪几段、往空里填什么,系统说了算。运营改字,改不坏流程。必须留的空要是被删了,系统直接拒绝保存。
经验 08
一段提示词一个名字,别「随便拿一条」
提示词多了以后,十几个功能的提示词,都放在同一个地方。种草文案的,买家秀评语的,审图的,修图的,出图的。
这时候,取提示词就不能再「拿第一条能用的」。一个功能拿到了另一个功能的提示词,不会报错,只会安安静静地出一批不对劲的东西。
每段提示词一个名字,按名字精确去取。
提示词也是资产,资产要有名有姓。 「拿第一条」这种写法,今天能用,是因为今天只有一条。
第三部分
工程化、系统化地管
经验 09
出图是任务,不是对话
对话窗口出图,最大的问题不是慢,是没有记录。
我们从一开始就没按对话来做。衣服和母图配成一个组合,一次提交,后台排队慢慢出,运营提交完就可以去干别的。一个组合任务拆成很多张图,每张一行记录,用了哪几张参考图,哪段提示词,哪个模型,出没出成,为什么失败,用了多久。
到今天,攒了 4,650 个组合任务。
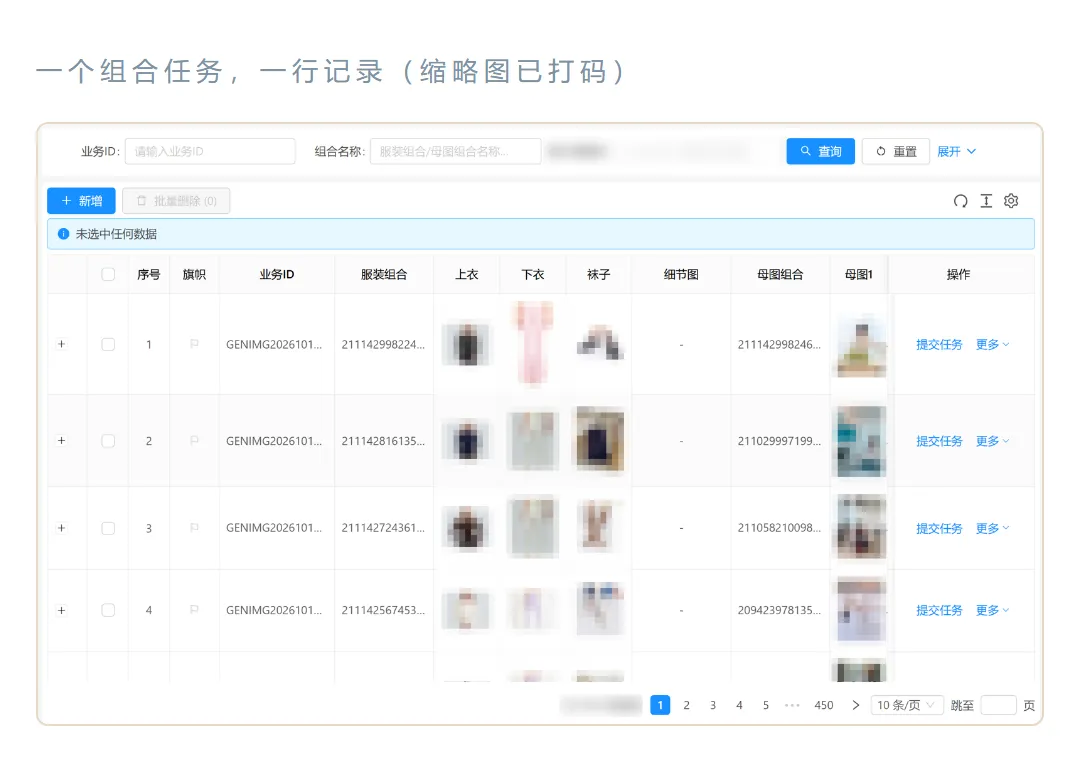
这一条是后面所有经验的地基。前面那些对照实验,能查出是哪句话惹的祸,能算出 9 张对 6 张,全靠每张图都有一行记录。没有记录,你连自己错在哪都不知道。
经验 10
把经验存进系统,别存在人脑子里
前面讲的细节图、标签、分辨率门槛、提示词模板,有个共同点。
运营不用懂提示词。
细节图配什么说明句、要不要先转成灰度,由开发在一张类型表里维护,运营只做三步,上传、裁剪、选类型。标签从固定词表里挑。门槛自动拦。提示词的措辞,有一个统一的地方改。
做细节图那会儿,我跟开发说的是「减少运营的决策压力」。
现在回头看,这句话的另一面更重要。每踩一个坑,就把它变成系统里的一条规矩。 黑扣子那次的教训,变成了类型表里的一行;罗纹那次的教训,变成了门槛上的一个数字。换一个运营来,规矩还在;换一个更强的模型来,规矩照样用。
经验 11
模型要能随时换,失败要有人接
主力模型没换过,不等于只用一个模型。
现在系统里接了 6 个出图模型,登记了 11 条调用通道。每个功能单独选模型,在页面上点一下就切。哪家便宜好用,就切哪家,业务流程一点不用动。
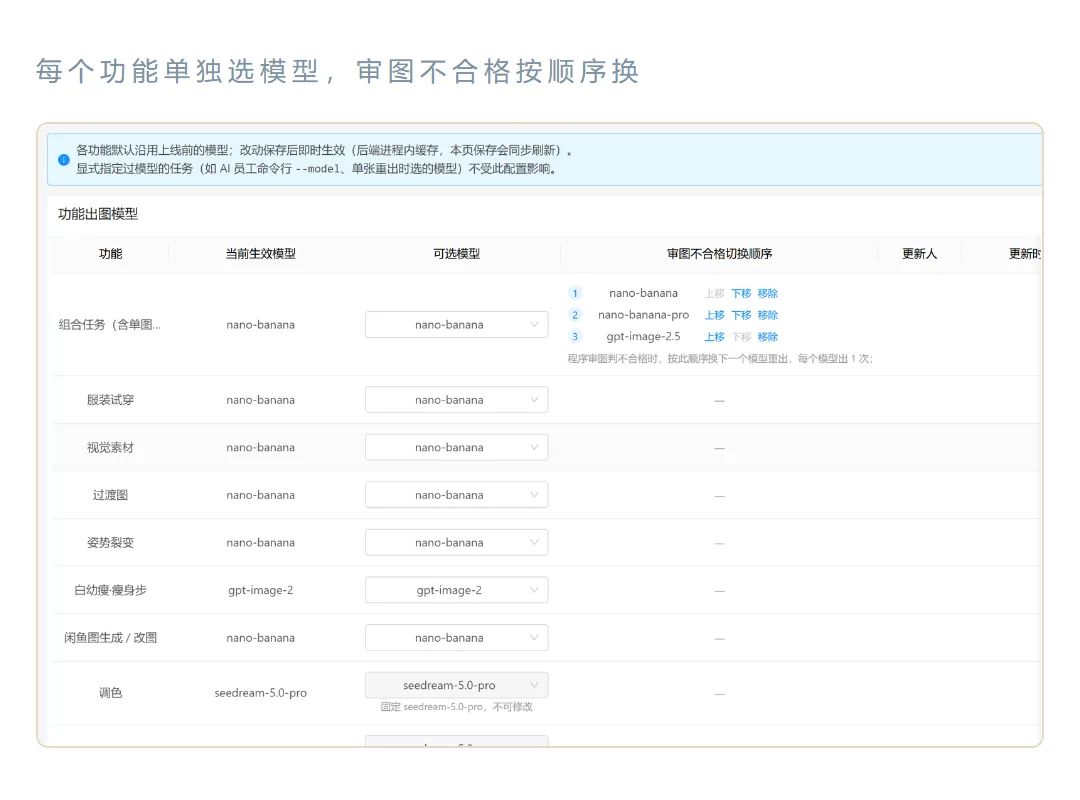
换着用,就得有人兜底。一张图出失败了,自动重试;审图判不合格,就换下一个模型接着出,按 nano-banana、nano-banana-pro、gpt-image-2.5 的顺序往下走。
这个月,系统一共调了 4,258 次模型,失败了 432 次,差不多每十次就有一次。最后真正没出成的,只有 6 张。
单次失败是常态,系统要做的是让失败不落到人头上。
第四部分
让它自己跑
经验 12
让 AI 审 AI,但先把判据教会它
图出得多了,新的瓶颈冒出来,人审不过来了。
我当时跟开发说的是,「人眼审核效率比较低」。9 月,出图后面接上了 AI 审图。
第一次试跑,15 张图,AI 和员工的结论只有 7 张一样。
7 张。47%。
拆开看,AI 放过、员工拦下的有 5 张,其中 2 张,模特的脸压根就没换。AI 拦下、员工放过的有 3 张,都是姿势有点偏,不影响上架。
问题不在 AI 不够聪明,在于我们没告诉它看什么。它压根没在查脸。
后来补了三样。让它专门查脸,把衣服正反两面都给它看,打开深度思考。拿 53 张人工标过答案的图回放,AI 跟人结论一致的,从 38 张升到了 47 张。
原理 | 大模型当裁判(LLM-as-a-Judge)
让一个大模型去评判另一个模型的产出,这个做法叫 LLM-as-a-Judge。2023 年 UC Berkeley 等机构的 Zheng 等人专门做过研究,结论大意是,强模型当裁判,跟人的一致率能做到和人与人之间差不多。但前提是裁判手里有清楚的评判标准。我们的体会一样,审得准不准,关键在判据给没给对、素材给没给够。同一套判据,换更高档的思考,一致的张数只差一两张;判据改对了,一下多出 9 张。
审图接上以后,出图就能自己闭环了。出图,审图,不合格换模型重出,最多三轮,人只看最后的结果。
在这个闭环上,又长出了几种跑法。
姿势裂变。 母图不够用,就让系统拿一张母图,裂变出新姿势的母图,母图库自己长。到现在跑了 20 批,长出了 44 张新母图。
爆款裂变。 挑几款卖得好的衣服,多选几张母图,一个任务就是几十套、上千张图,跨天慢慢出。我当时提的要求是,AI 审查款式、印花、袖型对不对,有没有三只手三只脚,不对就重出,最多三次。这一套已经搭好了,还没正式开闸,下一步就是它。
再往后,我们的 AI 员工也接了进来,自己选款、出图、审图、上架。那是另一个故事了。
第五部分
系统化的效率账
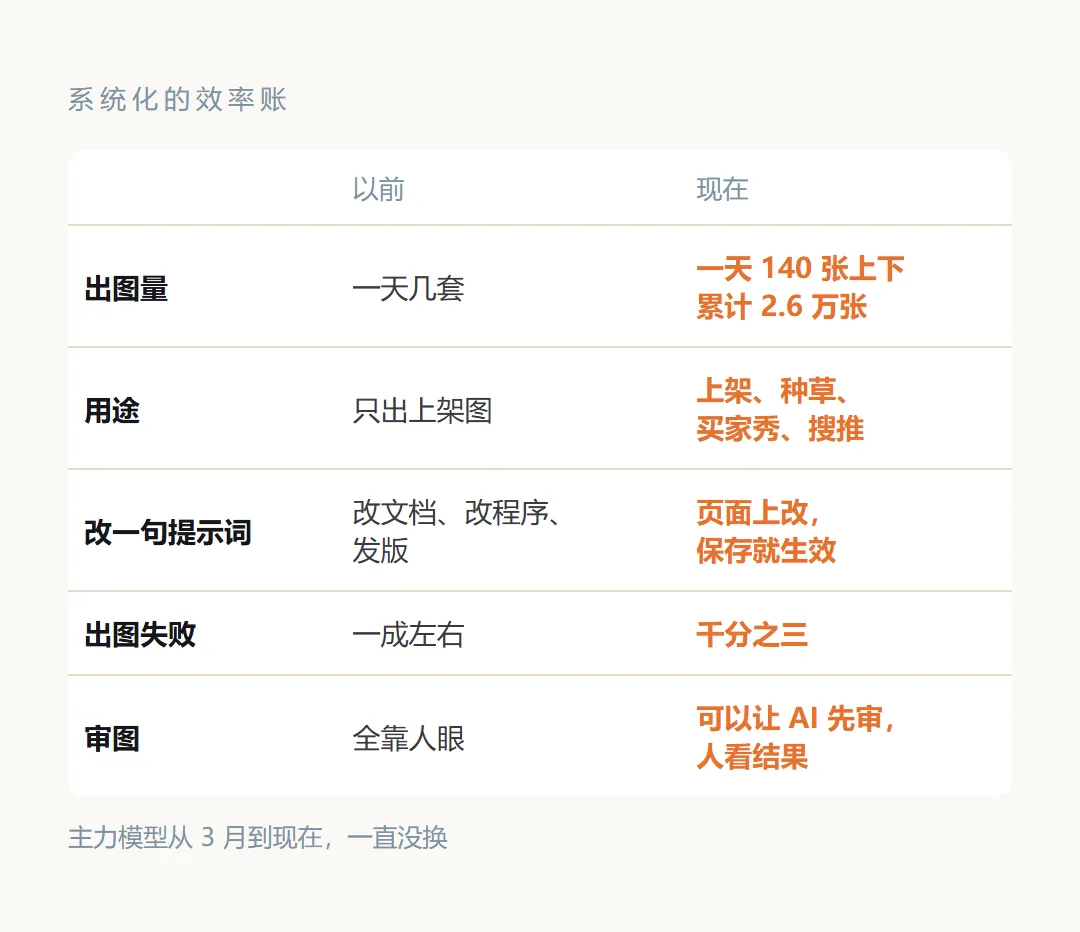
失败率是一个月一个月降下来的。1、2 月一成左右,3、4 月在 6% 到 9% 之间晃,5 到 7 月降到 2% 多,8 月起稳在千分之三。
再说一遍,这半年主力模型一直没换。
提升不是买来的,是一条一条规矩攒出来的。
· · ·
12 条经验,压成一张卡,存这一张就够了。
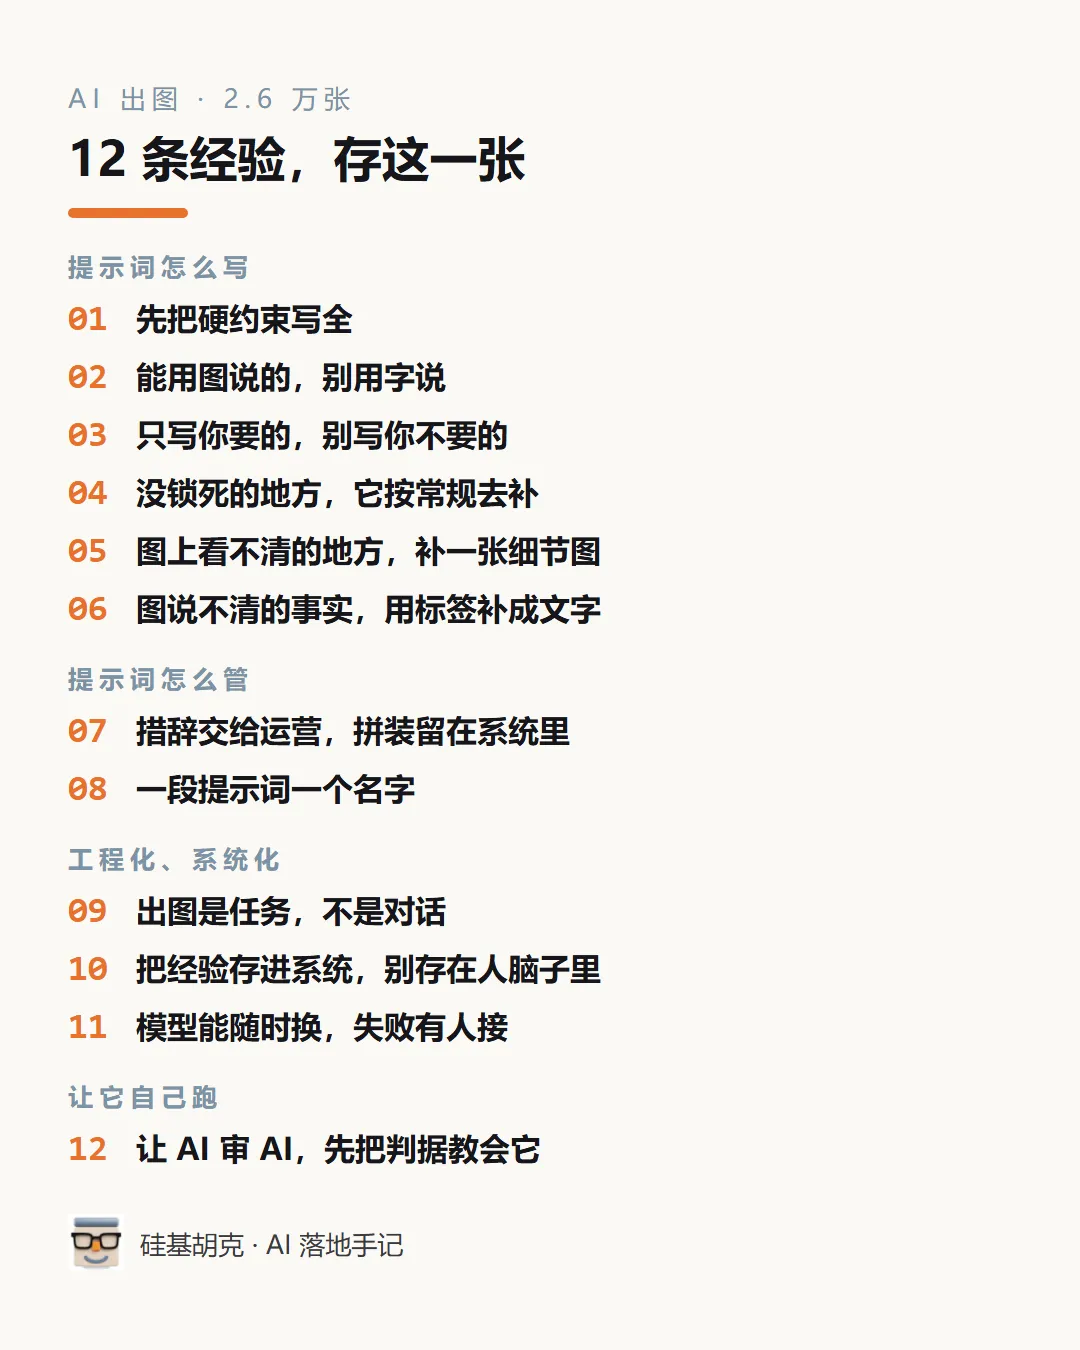
如果明天只想试一件事,我推荐这个。
把你提示词里所有的「不要什么」,全删掉,改成描述你要的样子。能给参考图的地方,就别用文字再说一遍。
不花钱,不用买工具,今天出的下一张图就能看到区别。
回头看,最早那个文档还在。里面记着我们复制粘贴过的一版版提示词,一天几套图,全靠人眼盯。
现在提示词在页面上,图在任务里,审图的是另一个 AI。
我们盯的,是那 12 条规矩还缺哪一条。
— 完 —
你用 AI 出图,遇到过最离谱的一次翻车是啥?留言说说,说不定就是我们的第 13 条。