ARTICLE · 1205428
Flink 任务调度 Graph 源码深度剖析:从 StreamGraph 到 ExecutionGraph 的三层演进
一、任务调度 Graph 整体架构
下面这张图是任务调度 Graph 整体架构,包括三层 Graph 层级关系、调度关系和核心类。
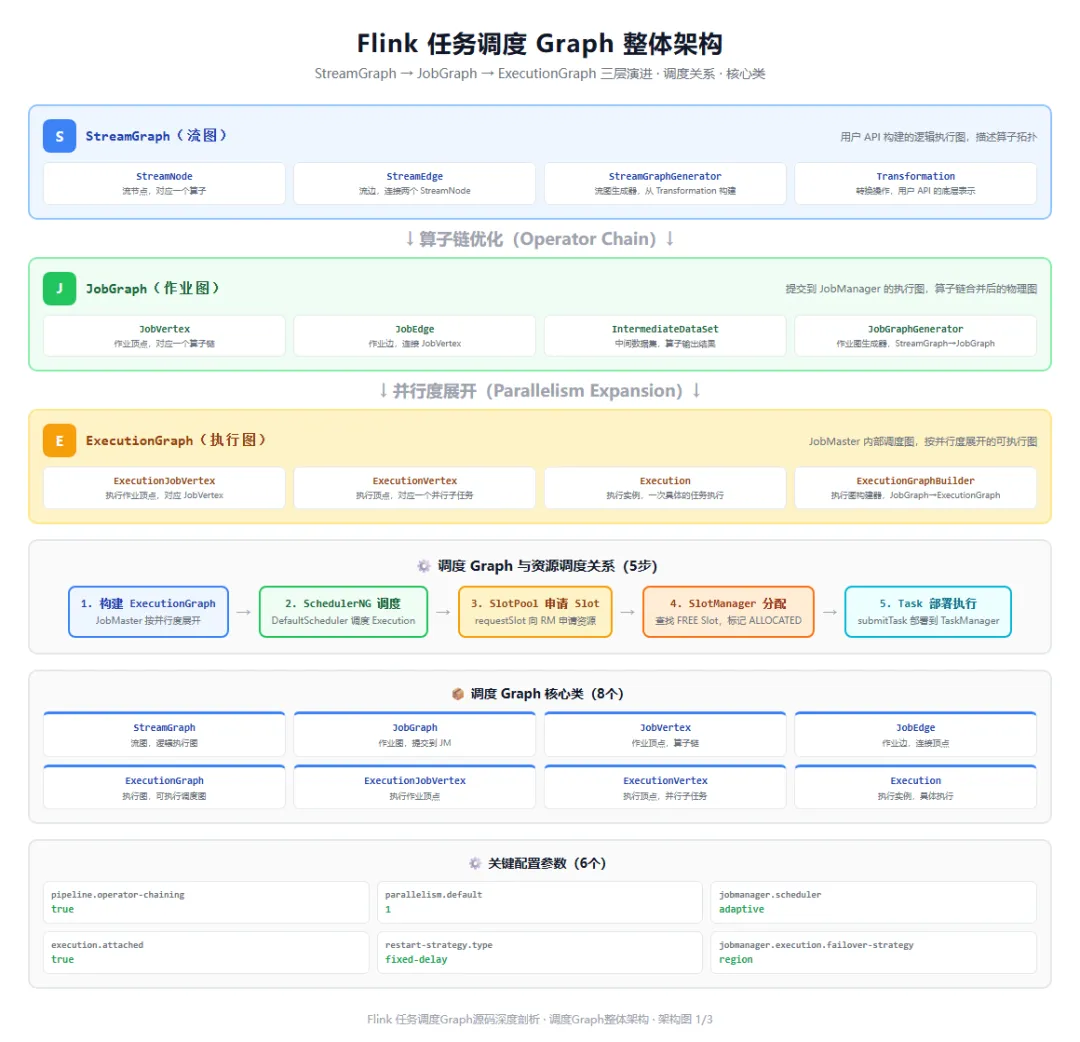
Flink 任务调度 Graph 分为三层,从逻辑到物理逐步演进:
●StreamGraph(流图):用户 API 构建的逻辑执行图,描述算子拓扑。包含 StreamNode(算子节点)和 StreamEdge(数据流边),从 Transformation 列表构建。
●JobGraph(作业图):提交到 JobManager 的执行图,算子链合并后的物理图。包含 JobVertex(作业顶点,对应算子链)、JobEdge(作业边)、IntermediateDataSet(中间数据集)。
●ExecutionGraph(执行图):JobMaster 内部调度图,按并行度展开的可执行图。包含 ExecutionJobVertex(执行作业顶点)、ExecutionVertex(执行顶点,对应并行子任务)、Execution(执行实例,具体执行)。
三层 Graph 的演进关系:StreamGraph 经过算子链优化(Operator Chain)生成 JobGraph,JobGraph 经过并行度展开(Parallelism Expansion)生成 ExecutionGraph。ExecutionGraph 构建完成后,SchedulerNG 调度 Execution,通过 SlotPool 申请 Slot,SlotManager 分配 Slot,最终部署 Task 到 TaskManager 执行。
二、JobGraph 构建流程
下面这张图是 JobGraph 构建流程,包括5步构建流程、算子链优化对比、组件关系和核心类。
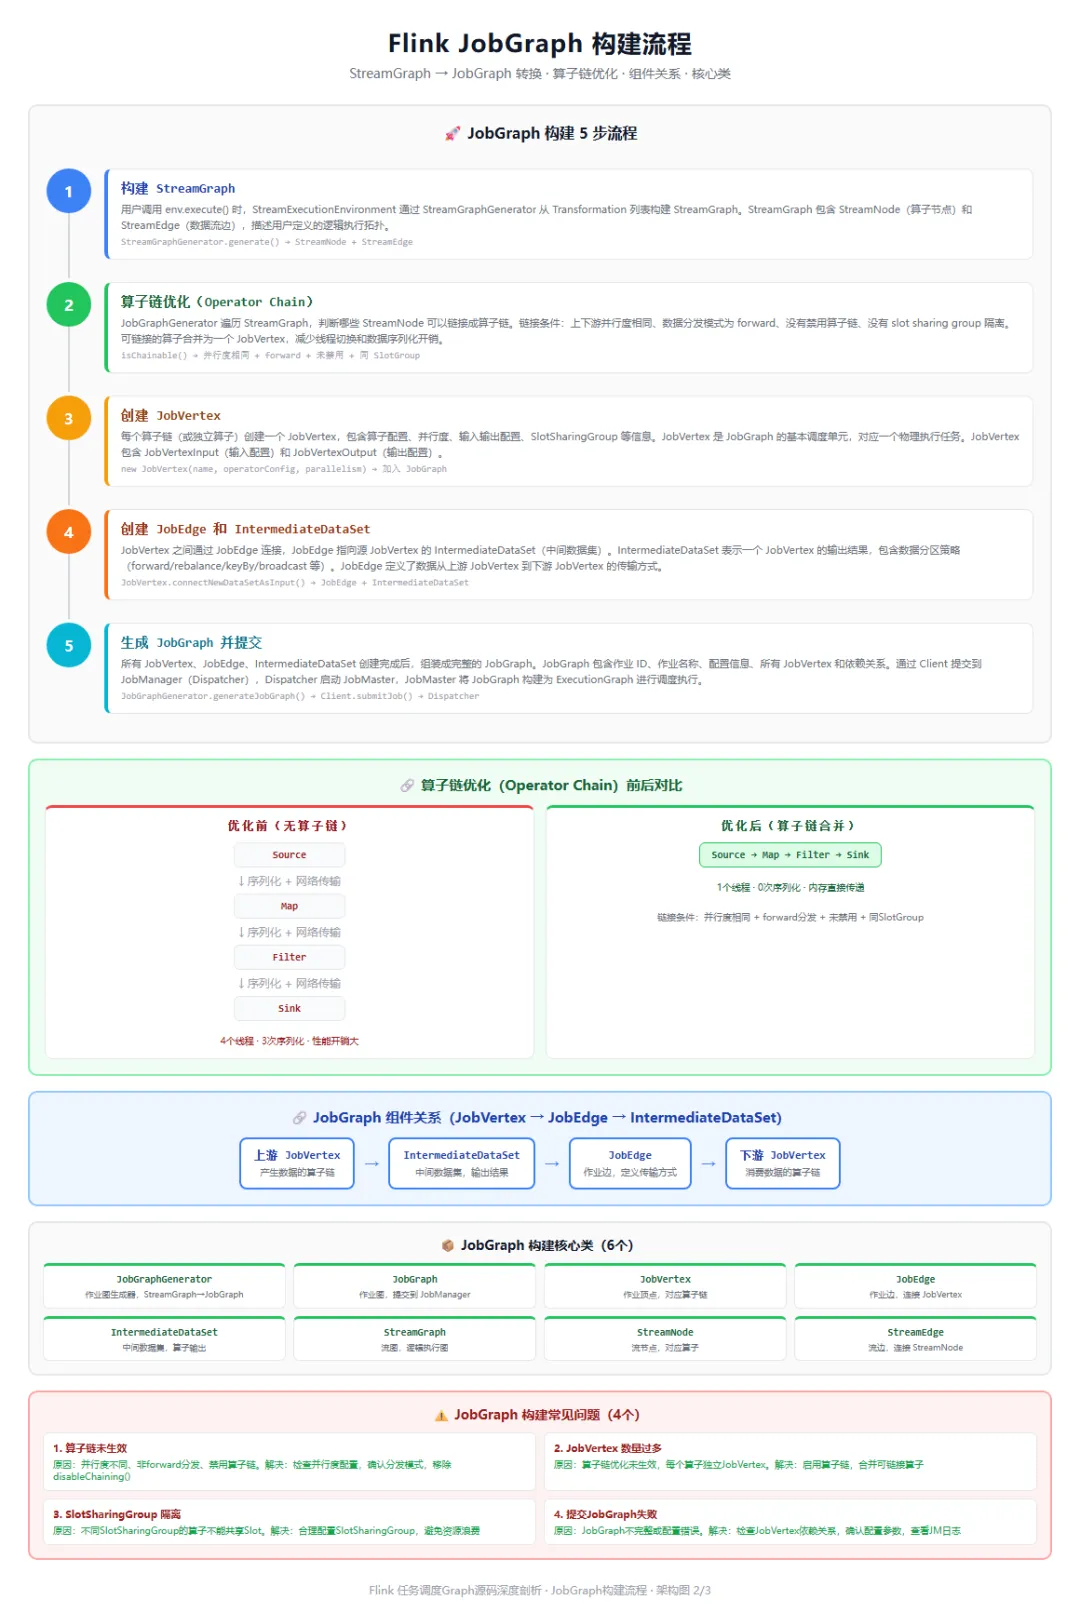
JobGraph 构建分为5步:
第1步:构建 StreamGraph。用户调用 env.execute() 时,StreamExecutionEnvironment 通过 StreamGraphGenerator 从 Transformation 列表构建 StreamGraph。StreamGraph 包含 StreamNode(算子节点)和 StreamEdge(数据流边),描述用户定义的逻辑执行拓扑。每个 Transformation 对应一个或多个 StreamNode,Transformation 之间的依赖关系对应 StreamEdge。
第2步:算子链优化(Operator Chain)。JobGraphGenerator 遍历 StreamGraph,判断哪些 StreamNode 可以链接成算子链。链接条件:上下游并行度相同、数据分发模式为 forward、没有禁用算子链(disableChaining)、没有 slot sharing group 隔离。可链接的算子合并为一个 JobVertex,减少线程切换和数据序列化开销。
第3步:创建 JobVertex。每个算子链(或独立算子)创建一个 JobVertex,包含算子配置、并行度、输入输出配置、SlotSharingGroup 等信息。JobVertex 是 JobGraph 的基本调度单元,对应一个物理执行任务。JobVertex 包含 JobVertexInput(输入配置)和 JobVertexOutput(输出配置)。
第4步:创建 JobEdge 和 IntermediateDataSet。JobVertex 之间通过 JobEdge 连接,JobEdge 指向源 JobVertex 的 IntermediateDataSet(中间数据集)。IntermediateDataSet 表示一个 JobVertex 的输出结果,包含数据分区策略(forward/rebalance/keyBy/broadcast 等)。JobEdge 定义了数据从上游 JobVertex 到下游 JobVertex 的传输方式。
第5步:生成 JobGraph 并提交。所有 JobVertex、JobEdge、IntermediateDataSet 创建完成后,组装成完整的 JobGraph。JobGraph 包含作业 ID、作业名称、配置信息、所有 JobVertex 和依赖关系。通过 Client 提交到 JobManager(Dispatcher),Dispatcher 启动 JobMaster,JobMaster 将 JobGraph 构建为 ExecutionGraph 进行调度执行。
算子链优化的价值
算子链优化是 Flink 重要的性能优化手段。优化前,Source、Map、Filter、Sink 四个算子各自独立,需要4个线程,3次序列化和网络传输,性能开销大。优化后,四个算子合并为一个算子链,只需要1个线程,0次序列化,数据在内存中直接传递,性能显著提升。
算子链的链接条件需要同时满足:
●上下游并行度相同
●数据分发模式为 forward(一对一)
●没有调用 disableChaining() 禁用算子链
●上下游属于同一个 SlotSharingGroup
三、ExecutionGraph 构建与调度
下面这张图是 ExecutionGraph 构建与调度,包括6步构建流程、并行度展开、Execution 状态机和配置最佳实践。
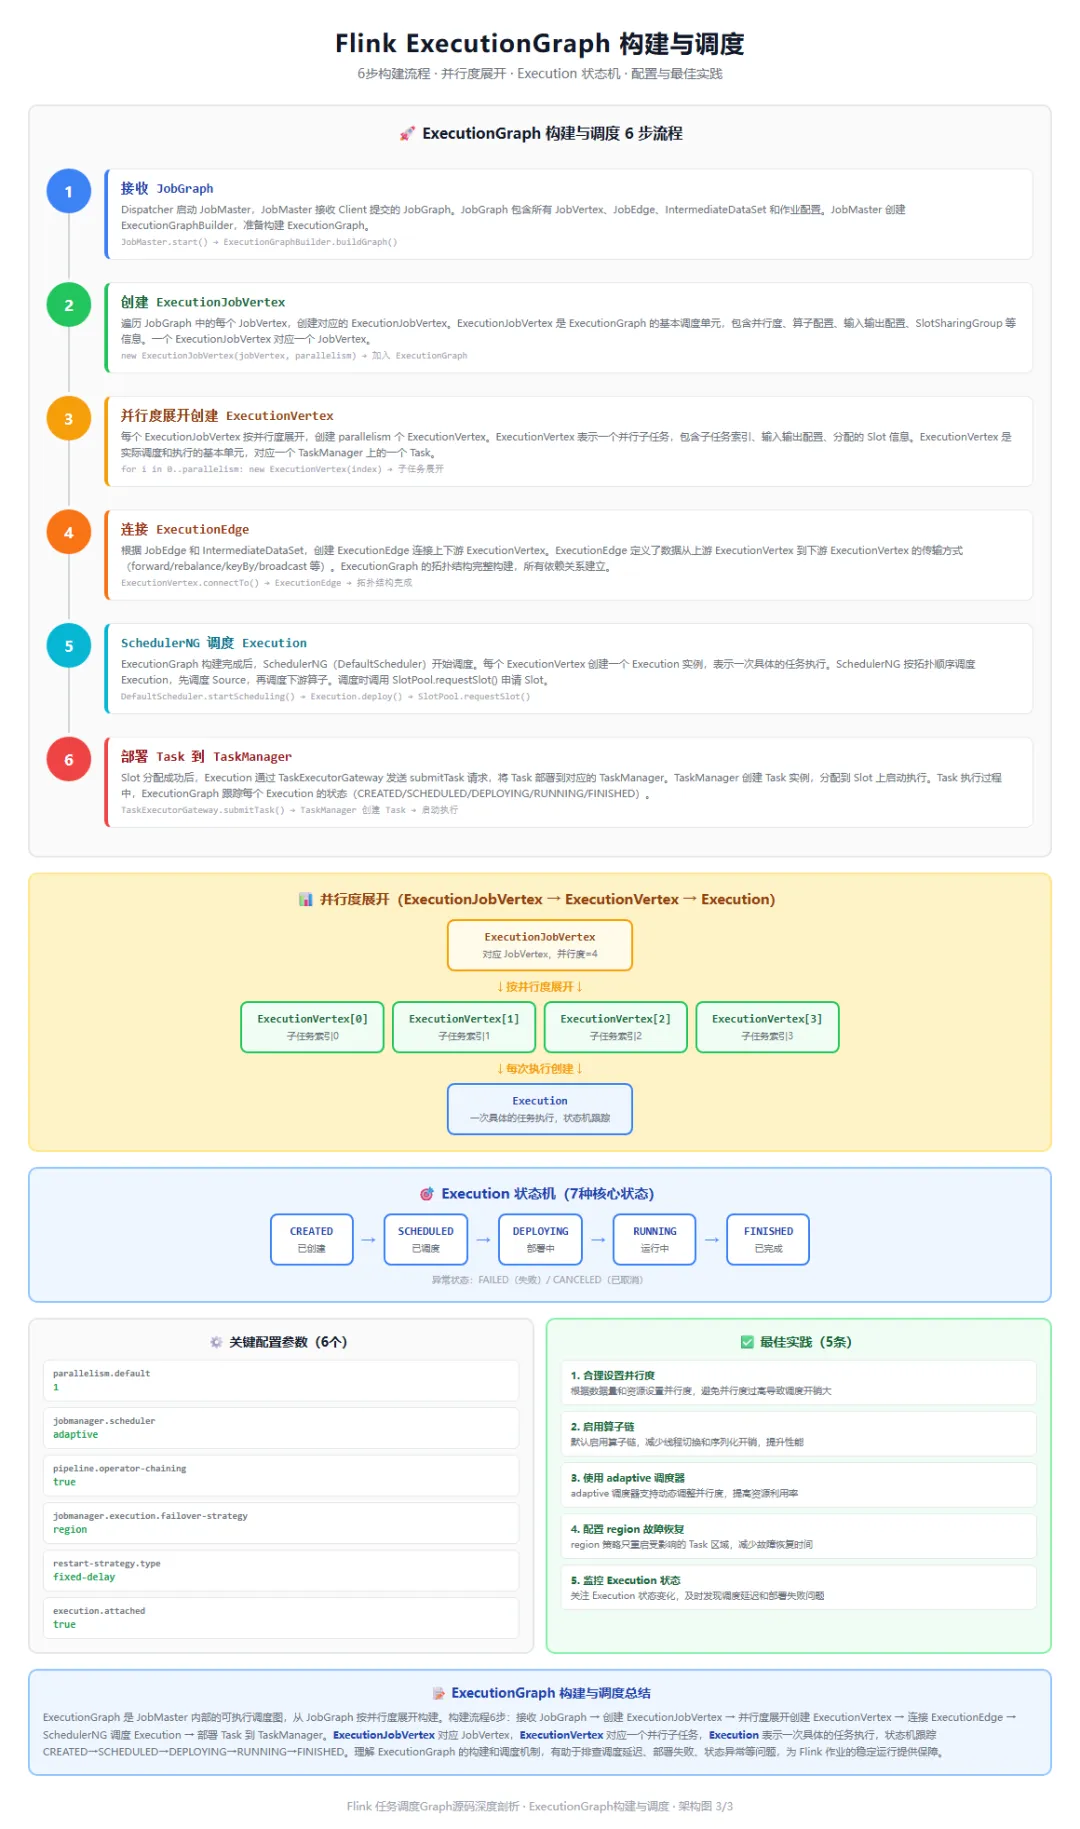
ExecutionGraph 构建与调度分为6步:
第1步:接收 JobGraph。Dispatcher 启动 JobMaster,JobMaster 接收 Client 提交的 JobGraph。JobGraph 包含所有 JobVertex、JobEdge、IntermediateDataSet 和作业配置。JobMaster 创建 ExecutionGraphBuilder,准备构建 ExecutionGraph。
第2步:创建 ExecutionJobVertex。遍历 JobGraph 中的每个 JobVertex,创建对应的 ExecutionJobVertex。ExecutionJobVertex 是 ExecutionGraph 的基本调度单元,包含并行度、算子配置、输入输出配置、SlotSharingGroup 等信息。一个 ExecutionJobVertex 对应一个 JobVertex。
第3步:并行度展开创建 ExecutionVertex。每个 ExecutionJobVertex 按并行度展开,创建 parallelism 个 ExecutionVertex。ExecutionVertex 表示一个并行子任务,包含子任务索引、输入输出配置、分配的 Slot 信息。ExecutionVertex 是实际调度和执行的基本单元,对应一个 TaskManager 上的一个 Task。
第4步:连接 ExecutionEdge。根据 JobEdge 和 IntermediateDataSet,创建 ExecutionEdge 连接上下游 ExecutionVertex。ExecutionEdge 定义了数据从上游 ExecutionVertex 到下游 ExecutionVertex 的传输方式(forward/rebalance/keyBy/broadcast 等)。ExecutionGraph 的拓扑结构完整构建,所有依赖关系建立。
第5步:SchedulerNG 调度 Execution。ExecutionGraph 构建完成后,SchedulerNG(DefaultScheduler)开始调度。每个 ExecutionVertex 创建一个 Execution 实例,表示一次具体的任务执行。SchedulerNG 按拓扑顺序调度 Execution,先调度 Source,再调度下游算子。调度时调用 SlotPool.requestSlot() 申请 Slot。
第6步:部署 Task 到 TaskManager。Slot 分配成功后,Execution 通过 TaskExecutorGateway 发送 submitTask 请求,将 Task 部署到对应的 TaskManager。TaskManager 创建 Task 实例,分配到 Slot 上启动执行。Task 执行过程中,ExecutionGraph 跟踪每个 Execution 的状态。
并行度展开机制
并行度展开是 ExecutionGraph 的核心机制。一个 ExecutionJobVertex(对应 JobVertex,并行度=4)按并行度展开为4个 ExecutionVertex(子任务索引0-3),每个 ExecutionVertex 每次执行创建一个 Execution 实例。ExecutionVertex 是静态的(对应一个并行子任务),Execution 是动态的(对应一次具体的执行,可能因故障重试而多次创建)。
Execution 状态机
Execution 有7种核心状态,状态转换严格按顺序执行:
●CREATED:已创建,Execution 实例创建完成
●SCHEDULED:已调度,SchedulerNG 已调度,等待 Slot 分配
●DEPLOYING:部署中,Slot 已分配,正在向 TaskManager 部署 Task
●RUNNING:运行中,Task 已启动,正在执行
●FINISHED:已完成,Task 执行成功完成
●FAILED:失败,Task 执行失败
●CANCELED:已取消,Task 被取消
四、核心类源码剖析
4.1 StreamGraph 流图
public class StreamGraph { private final String jobName; private final Map<Integer, StreamNode> streamNodes; private final Set<StreamEdge> streamEdges; private final Map<Integer, List<StreamEdge>> inEdges; private final Map<Integer, List<StreamEdge>> outEdges; public void addOperator( Integer vertexID, String slotSharingGroup, String coLocationGroup, StreamOperatorFactory operatorFactory, TypeInformation inTypeInfo, TypeInformation outTypeInfo, String operatorName) { // 创建 StreamNode 并加入映射 StreamNode vertex = new StreamNode( vertexID, slotSharingGroup, coLocationGroup, operatorFactory, operatorName, inTypeInfo, outTypeInfo); streamNodes.put(vertexID, vertex); } public void addEdge(Integer sourceId, Integer targetId, int typeNumber, String outputName) { // 创建 StreamEdge 连接两个 StreamNode StreamNode source = streamNodes.get(sourceId); StreamNode target = streamNodes.get(targetId); StreamEdge edge = new StreamEdge(source, target, typeNumber, outputName); streamEdges.add(edge); outEdges.get(sourceId).add(edge); inEdges.get(targetId).add(edge); } public StreamNode getStreamNode(Integer vertexID) { return streamNodes.get(vertexID); }}public class StreamNode { private final int id; private final StreamOperatorFactory operatorFactory; private final String operatorName; private int parallelism; private String slotSharingGroup; private List<StreamEdge> inEdges; private List<StreamEdge> outEdges;}
StreamGraph 是逻辑执行图,包含 StreamNode(算子节点)和 StreamEdge(数据流边)。addOperator 方法创建 StreamNode 并加入映射,addEdge 方法创建 StreamEdge 连接两个 StreamNode。StreamNode 包含算子工厂、并行度、SlotSharingGroup、输入输出边等信息。
4.2 JobGraph 作业图
public class JobGraph { private final JobID jobID; private String name; private final Map<JobVertexID, JobVertex> taskVertices; private final List<JobEdge> jobEdges; public void addVertex(JobVertex vertex) { // 添加 JobVertex 到作业图 taskVertices.put(vertex.getID(), vertex); } public void addEdge(JobEdge edge) { // 添加 JobEdge 到作业图 jobEdges.add(edge); } public JobVertex findVertexByID(JobVertexID id) { return taskVertices.get(id); }}public class JobVertex { private final JobVertexID id; private String name; private int parallelism; private StreamConfig configuration; private String slotSharingGroup; private List<JobEdge> inputs; private List<IntermediateDataSet> results; public void connectNewDataSetAsInput( JobVertex input, DistributionPattern distributionPattern, boolean isBroadcast) { // 创建 IntermediateDataSet 和 JobEdge IntermediateDataSet dataSet = input.createAndAddResultDataSet( this, distributionPattern); JobEdge edge = new JobEdge(dataSet, this, distributionPattern); inputs.add(edge); } public IntermediateDataSet createAndAddResultDataSet( JobVertex consumer, DistributionPattern pattern) { // 创建中间数据集 IntermediateDataSet dataSet = new IntermediateDataSet( new IntermediateDataSetID(), pattern, this); results.add(dataSet); return dataSet; }}public class IntermediateDataSet { private final IntermediateDataSetID id; private final DistributionPattern distributionPattern; private final JobVertex producer; private final List<JobEdge> consumers;}public class JobEdge { private final IntermediateDataSet source; private final JobVertex target; private final DistributionPattern distributionPattern;}
JobGraph 是提交到 JobManager 的物理执行图,包含 JobVertex(作业顶点)、JobEdge(作业边)、IntermediateDataSet(中间数据集)。JobVertex.connectNewDataSetAsInput 方法创建 IntermediateDataSet 和 JobEdge,连接上下游 JobVertex。IntermediateDataSet 表示一个 JobVertex 的输出结果,包含数据分区策略。JobEdge 定义了数据传输方式。
4.3 ExecutionGraph 执行图
public class ExecutionGraph { private final JobID jobID; private String jobName; private final Map<JobVertexID, ExecutionJobVertex> tasks; private final List<ExecutionVertex> allVertices; private SchedulerNG scheduler; public void attachJobGraph(List<JobVertex> topologiallySorted) throws Exception { // 遍历 JobVertex,创建 ExecutionJobVertex for (JobVertex jobVertex : topologiallySorted) { ExecutionJobVertex ejv = new ExecutionJobVertex( this, jobVertex, jobVertex.getParallelism()); tasks.put(jobVertex.getID(), ejv); } // 连接 ExecutionEdge for (ExecutionJobVertex ejv : tasks.values()) { ejv.connectToPredecessors(); } }}public class ExecutionJobVertex { private final ExecutionGraph graph; private final JobVertex jobVertex; private final int parallelism; private final ExecutionVertex[] taskVertices; public ExecutionJobVertex( ExecutionGraph graph, JobVertex jobVertex, int parallelism) { this.graph = graph; this.jobVertex = jobVertex; this.parallelism = parallelism; // 按并行度展开,创建 ExecutionVertex 数组 this.taskVertices = new ExecutionVertex[parallelism]; for (int i = 0; i < parallelism; i++) { taskVertices[i] = new ExecutionVertex( this, i, jobVertex.getConfiguration()); } } public void connectToPredecessors() { // 连接上下游 ExecutionVertex for (int i = 0; i < parallelism; i++) { taskVertices[i].connectSource(); } } public ExecutionVertex[] getTaskVertices() { return taskVertices; }}public class ExecutionVertex { private final ExecutionJobVertex jobVertex; private final int subTaskIndex; private final StreamConfig configuration; private Execution currentExecution; private SlotAndLocality assignedSlot; public ExecutionVertex( ExecutionJobVertex jobVertex, int subTaskIndex, StreamConfig configuration) { this.jobVertex = jobVertex; this.subTaskIndex = subTaskIndex; this.configuration = configuration; } public void deploy() throws Exception { // 创建 Execution 实例并部署 currentExecution = new Execution(this, subTaskIndex); currentExecution.deploy(); } public Execution getCurrentExecution() { return currentExecution; }}public class Execution { private final ExecutionVertex vertex; private final int attemptNumber; private ExecutionState state; private CompletableFuture<Void> releaseFuture; public Execution(ExecutionVertex vertex, int attemptNumber) { this.vertex = vertex; this.attemptNumber = attemptNumber; this.state = ExecutionState.CREATED; } public void deploy() throws Exception { // 状态转换:CREATED → SCHEDULED → DEPLOYING → RUNNING checkState(state == ExecutionState.CREATED); state = ExecutionState.SCHEDULED; // 申请 Slot,部署 Task state = ExecutionState.DEPLOYING; // TaskManager.submitTask() state = ExecutionState.RUNNING; } public void markFinished() { checkState(state == ExecutionState.RUNNING); state = ExecutionState.FINISHED; }}public enum ExecutionState { CREATED, SCHEDULED, DEPLOYING, RUNNING, FINISHED, FAILED, CANCELED}
ExecutionGraph 是 JobMaster 内部的可执行调度图。attachJobGraph 方法遍历 JobVertex,创建 ExecutionJobVertex,然后连接 ExecutionEdge。ExecutionJobVertex 按并行度展开创建 ExecutionVertex 数组,每个 ExecutionVertex 对应一个并行子任务。ExecutionVertex.deploy 方法创建 Execution 实例,Execution 管理任务执行的状态机(CREATED→SCHEDULED→DEPLOYING→RUNNING→FINISHED)。
五、关键配置参数
# 默认并行度parallelism.default: 1# 调度器类型jobmanager.scheduler: adaptive# 算子链优化pipeline.operator-chaining: true# 故障恢复策略jobmanager.execution.failover-strategy: region# 重启策略类型restart-strategy.type: fixed-delay# 固定延迟重启次数restart-strategy.fixed-delay.attempts: 3# 固定延迟重启间隔restart-strategy.fixed-delay.delay: 10s# 执行模式execution.attached: true# Slot 请求超时slotmanager.request-timeout: 5min# 每个 TaskManager 的 Slot 数taskmanager.numberOfTaskSlots: 1
关键配置说明:
●parallelism.default:默认并行度,所有算子的默认并行度,可在代码中单独设置。
●jobmanager.scheduler:调度器类型,adaptive 支持动态调整并行度,根据可用 Slot 数自动调整。
●pipeline.operator-chaining:算子链优化,默认 true,启用后可链接的算子合并为一个 JobVertex。
●jobmanager.execution.failover-strategy:故障恢复策略,region 只重启受影响的 Task 区域,减少故障恢复时间。
●restart-strategy:重启策略,fixed-delay 固定延迟重试,failure-rate 失败率重试。
●slotmanager.request-timeout:Slot 请求超时,默认5分钟,大作业可调大到10-15分钟。
六、常见问题与最佳实践
常见问题
●算子链未生效
●原因:并行度不同、非 forward 分发、禁用算子链、不同 SlotSharingGroup。
●解决:检查并行度配置,确认分发模式为 forward,移除 disableChaining(),确认 SlotSharingGroup 配置。
●JobVertex 数量过多
●原因:算子链优化未生效,每个算子独立 JobVertex,导致调度开销大。
●解决:启用算子链,合并可链接算子,减少 JobVertex 数量。
●Execution 调度延迟
●原因:Slot 不足、调度器配置不当、依赖关系复杂。
●解决:增加 TM 数量,使用 adaptive 调度器,优化算子拓扑,检查 Slot 分配状态。
●部署 Task 失败
●原因:TaskManager 无响应、网络异常、资源不足。
●解决:检查 TM 心跳,确认网络连通,增加资源,查看 TM 日志。
●Execution 状态异常
●原因:状态转换非法、并发问题、故障恢复失败。
●解决:检查日志,重启 JM,配置重启策略,查看 ExecutionGraph 状态。
●SlotSharingGroup 隔离
●原因:不同 SlotSharingGroup 的算子不能共享 Slot,导致资源浪费。
●解决:合理配置 SlotSharingGroup,避免不必要的隔离,提高资源利用率。
最佳实践
●合理设置并行度:根据数据量和资源设置并行度,避免并行度过高导致调度开销大,或过低导致处理能力不足。Source 并行度受数据源分片数限制。
●启用算子链:默认启用算子链,减少线程切换和序列化开销,提升性能。只有在需要隔离或调试时才禁用算子链。
●使用 adaptive 调度器:adaptive 调度器支持动态调整并行度,根据可用 Slot 数自动调整,提高资源利用率和作业稳定性。适合资源波动较大的环境。
●配置 region 故障恢复:region 策略只重启受影响的 Task 区域,而不是整个作业,减少故障恢复时间和资源消耗。适合大多数流处理作业。
●监控 Execution 状态:关注 Execution 状态变化,及时发现调度延迟和部署失败问题。监控 SCHEDULED 状态持续时间,过长说明 Slot 分配延迟。
●合理配置 SlotSharingGroup:默认所有算子共享同一个 SlotSharingGroup,提高资源利用率。只有在需要资源隔离时才配置独立的 SlotSharingGroup。
●优化算子拓扑:减少不必要的 shuffle,使用 forward 分发模式,促进算子链合并。避免数据倾斜,合理设计 keyBy 字段。
七、总结
Flink 任务调度 Graph 经历三层演进:StreamGraph(流图,逻辑执行图)→ JobGraph(作业图,算子链合并后的物理图)→ ExecutionGraph(执行图,按并行度展开的可执行图)。StreamGraph 从 Transformation 构建,包含 StreamNode 和 StreamEdge。JobGraph 经过算子链优化,包含 JobVertex、JobEdge、IntermediateDataSet。ExecutionGraph 按并行度展开,包含 ExecutionJobVertex、ExecutionVertex、Execution,是实际调度和执行的图。
核心类包括 StreamGraph(逻辑执行图)、JobGraph(物理执行图)、JobVertex(作业顶点)、JobEdge(作业边)、IntermediateDataSet(中间数据集)、ExecutionGraph(可执行调度图)、ExecutionJobVertex(执行作业顶点)、ExecutionVertex(执行顶点,并行子任务)、Execution(执行实例,状态机跟踪)。算子链优化合并可链接的算子,减少线程切换和序列化开销。并行度展开将 ExecutionJobVertex 展开为多个 ExecutionVertex。Execution 状态机跟踪 CREATED→SCHEDULED→DEPLOYING→RUNNING→FINISHED。
理解任务调度 Graph 的三层演进和核心类实现,有助于排查算子链未生效、JobVertex 数量过多、调度延迟、部署失败、状态异常等常见问题,为 Flink 作业的稳定运行提供保障。合理设置并行度、启用算子链、使用 adaptive 调度器、配置 region 故障恢复、监控 Execution 状态,可以显著提高作业的性能和稳定性。