ARTICLE · 1205419
V4L2 源码深度解析(九):从完成通知到取回图像——buffer_done 与 DQBUF
上一节中,STREAMON 已经让采集流程运行起来。沿用同一个场景:VIMC 使用 640 × 480 的 RGB24,四块 MMAP 缓冲区已经建立映射,buffer 0 和 buffer 1 已经交给驱动。软件处理线程从上游取得一帧,将数据写进其中一块存储。
像素写完以后,应用为什么不能直接读取任意一块映射?驱动怎样告诉框架“这块已经完成”?应用还不知道本次完成的是哪个索引,又该怎样取回它?
这一篇从这里接着往下读。先讲清完成与取回的含义,再沿 VIMC 的填帧函数进入 vb2_buffer_done(),最后经过等待、DQBUF 和结果回写,回到应用已经保存的映射地址。主线仍是普通 CAPTURE、MMAP、vmalloc 后端,不使用 Media Request。代码采用 prepared、synced、queued_count 和 owned_by_drv_count 这套实现;具体顺序以各节中的函数为准。
1. 写完像素,不等于应用已经取回这一帧
1.1 同一块存储,前后交给不同的执行方
图像仍然保存在第五篇建立、第六篇映射的那组内存中。一次正常采集循环不会在每次 DQBUF 时重新分配一帧,也不会为了取回结果再次把整帧像素复制进 ioctl 参数。
应用提交 buffer 0 后,驱动在合适的时刻写入它。驱动写完以后,把这个对象交回 VB2;应用随后执行 DQBUF,从 VB2 取回一个完成对象的描述,再用返回的索引找到已有映射。
这里有两次不同的交接:
驱动到 VB2 的交接,由 vb2_buffer_done() 完成。 它表示驱动本轮不再使用这个缓冲区。此后,驱动不能继续沿旧指针写入,必须等下一次 buf_queue() 再次把对象交给它。
VB2 到应用的正常交接,由成功的 DQBUF 完成。 返回描述告诉应用本次取得哪个缓冲区、数据有多长,以及时间戳和错误标志等信息。映射虽然始终存在,应用也应等到正确的取回时刻再消费图像。
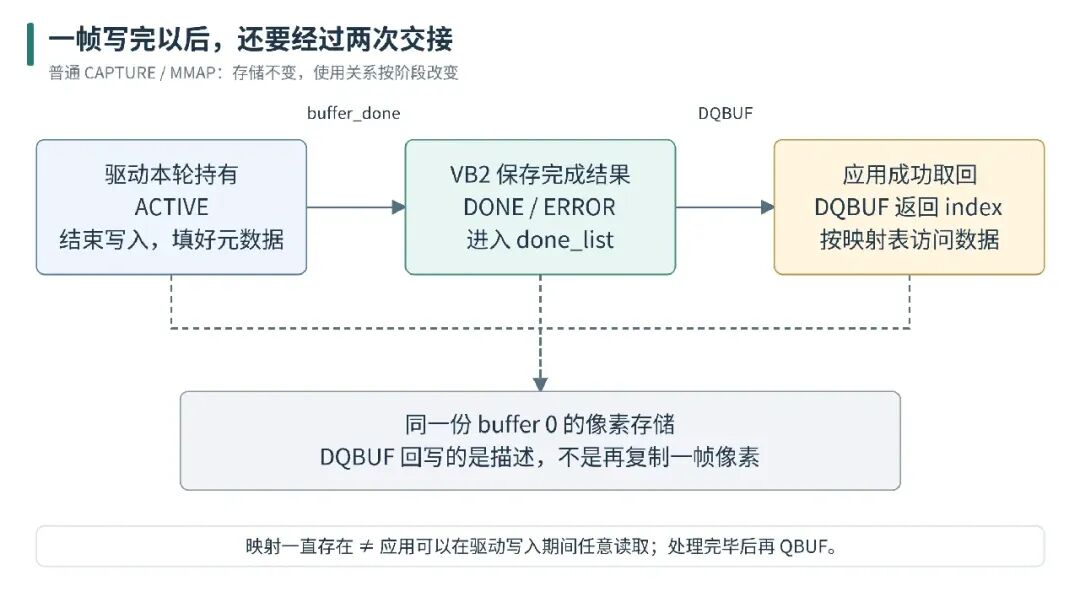
图 1:变化的是本轮使用关系与返回的描述,不是每一步都复制一份图像。这里讨论普通 MMAP 采集;驱动内部如何产生像素,由具体实现决定。
1.2 DQBUF 不是“读取指定的 buffer 0”
QBUF 用 index 选择要提交的对象。DQBUF 则从完成队列取得一个结果,返回的 index 才说明本次取回的是哪一块。调用前把 index 清成零,只是初始化结构体,不能要求框架必须等 buffer 0。
例如,应用维护:
maps[0] /* buffer 0 的映射 */
maps[1] /* buffer 1 的映射 */
maps[2] /* buffer 2 的映射 */
maps[3] /* buffer 3 的映射 */
DQBUF 返回 b.index = 1 后,应用使用 maps[1],并按 b.bytesused 等结果解释数据。不能每次按 0、1、2、3 自行循环猜测完成顺序。
1.3 “通知完成”不是执行应用回调
vb2_buffer_done() 是驱动调用的内核接口,不是应用发出的 ioctl。它登记完成结果并唤醒相关等待者,不会直接跳进应用的图像处理函数。
应用可能已经在等待,也可能正在处理上一帧。没有等待者时,完成结果仍可留在完成列表中;下一次 DQBUF 可以直接取到,不需要重新发生一次硬件中断或软件填帧。
实现对照:videobuf2-core.c 的 vb2_buffer_done()、vb2_core_dqbuf();接口约定见文末的 QBUF/DQBUF 与 VB2 文档。
2. 先看 VIMC 怎样把一帧交回来
2.1 从驱动私有列表取得一块待处理存储
vimc_streamer_thread() 沿管线调用处理函数,最终到达 vimc_capture_process_frame()。捕获函数先在 vcapture->qlock 下,从 vcapture->buf_list 取得并摘除一个对象;没有对象时解锁,返回 ERR_PTR(-EAGAIN)。
这个 -EAGAIN 返回给 VIMC 的软件处理路径,不是直接返回某次应用 DQBUF 的错误码。两个位置虽然使用同一个错误名称,调用者和含义却不同。
摘除驱动列表成员并不等于完成 VB2 出队。此时对象仍是 ACTIVE,仍由驱动负责,只是不再等待于驱动私有列表中,而是正在被当前处理函数使用。
2.2 填写结果、复制像素、报告完成
锁释放以后,VIMC 执行下面这一段连续源码:
vimc_buf->vb2.vb2_buf.timestamp = ktime_get_ns();
vimc_buf->vb2.sequence = vcapture->sequence++;
vimc_buf->vb2.field = vcapture->format.field;

vbuf = vb2_plane_vaddr(&vimc_buf->vb2.vb2_buf, 0);

memcpy(vbuf, frame, vcapture->format.sizeimage);

/* Set it as ready */
vb2_set_plane_payload(&vimc_buf->vb2.vb2_buf, 0,
                      vcapture->format.sizeimage);
vb2_buffer_done(&vimc_buf->vb2.vb2_buf, VB2_BUF_STATE_DONE);
第一组赋值记录时间戳、序号与场信息。随后取得平面的 CPU 地址,复制上游图像,再设置本次有效数据量,最后报告 DONE。对于当前 RGB24 场景,有效数据量为 640 × 480 × 3 = 921600 字节。
这段代码也给出了分析时间戳的依据:VIMC 在复制像素之前读取单调时钟,它不是曝光时间,也不是 DQBUF 返回时间。sequence 只在确实取得缓冲区后递增,因此不能仅凭本例序号连续,就证明上游从未出现过无法接收的帧。
2.3 为什么不能先 done,再补写结果
完成结果一旦发布,另一个 CPU 上的 DQBUF 路径就可能取得它。若驱动先报告完成,再修改载荷、时间戳或像素,应用可能看到未完成或前后不一致的内容。
正确顺序是:结束本轮实际访问,填写结果,再报告完成。 真正的 DMA 驱动还要确认设备不再写入这块存储;调用完成函数本身不会替它停止 DMA。
VIMC 的例子通过 memcpy() 写入像素,没有 DMA 完成中断。后面的 VB2 交接规则可以用于真实设备,但不能把这个软件实例当成硬件时序验证。
实现对照:vimc-capture.c 的 vimc_capture_process_frame();vimc-streamer.c 的软件处理线程。
3. vb2_buffer_done():先收尾,再把完成结果发布出去
3.1 入口要求当前对象确实属于驱动
函数入口检查:
if (WARN_ON(vb->state != VB2_BUF_STATE_ACTIVE))
return;

if (WARN_ON(state != VB2_BUF_STATE_DONE &&
            state != VB2_BUF_STATE_ERROR &&
            state != VB2_BUF_STATE_QUEUED))
    state = VB2_BUF_STATE_ERROR;
第一个判断防止把未交给驱动或已经归还的对象再次作为正常完成提交。检查不通过时直接返回,不再修改计数和链表。
第二个判断限制目标状态。正常结果用 DONE,单个结果损坏用 ERROR,启动失败撤回则用 QUEUED。传入其他目标会告警,并按 ERROR 处理,而不是直接原样保存。
这些检查不是允许重复调用的保证,也不是处理“两个完成线程同时归还同一对象”的原子认领机制:初始状态检查发生在 done_lock 之前。驱动必须先确保同一轮对象只有一个完成者。
3.2 内存后端的 finish 在发布之前
正常 DONE/ERROR 路径先执行:
if (state != VB2_BUF_STATE_QUEUED)
    __vb2_buf_mem_finish(vb);
辅助函数如下:
staticvoid __vb2_buf_mem_finish(struct vb2_buffer *vb)
{
unsignedint plane;

if (!vb->synced)
return;

    vb->synced = 0;
for (plane = 0; plane < vb->num_planes; ++plane)
        call_void_memop(vb, finish, vb->planes[plane].mem_priv);
}
synced 为零时不重复收尾;否则先清零,再逐平面调用可选的内存后端 finish。它与提交时的内存 prepare 配对,用于后端需要的访问同步。
这里不能把 synced = 0 解释成“框架检测到所有硬件缓存已经一致”。这是调用配对状态,不是硬件检测结果。当前 vb2_vmalloc_memops 没有设置 prepare/finish,所以本例不会在这里凭空执行一套 DMA 缓存维护操作。
也不能把它与驱动的 ops->buf_finish 合并。后者在正常 DQBUF 时执行,用于驱动收尾;两张操作表、两个调用位置,后文会分别跟踪。
3.3 在 done_lock 下写入完成列表和状态
完成函数的关键临界区为:
spin_lock_irqsave(&q->done_lock, flags);
if (state == VB2_BUF_STATE_QUEUED) {
    vb->state = VB2_BUF_STATE_QUEUED;
} else {
    list_add_tail(&vb->done_entry, &q->done_list);
    vb->state = state;
}
atomic_dec(&q->owned_by_drv_count);
普通 DONE/ERROR 被加到完成列表尾部,并记录完成状态;驱动持有数减一。这个数量表示已交给驱动、尚未归还的对象数,不是应用能立即 DQBUF 的数量。
实际临界区后面还有可选的 Request 对象解绑和引用归还,然后才解锁。本篇没有 Request 关联,因此这些条件分支不执行;上面的节选不能被理解成完整锁范围。
3.4 解锁以后唤醒,不是在锁里完成应用处理
后续先解锁、记录 trace,然后 DONE/ERROR 路径执行:
wake_up(&q->done_wq);
此时完成对象已经加入列表。等待者有机会恢复运行,但还要重新取得操作锁、检查队列状态,再从列表中取对象。唤醒不会预订一个缓冲区,也不保证当前线程立刻让出 CPU。
QUEUED 分支则直接返回:不执行普通内存 finish,不进入完成列表,也不经过这里的完成唤醒。这是启动失败时撤回驱动责任的分支,不是一帧可以正常 DQBUF 的结果。
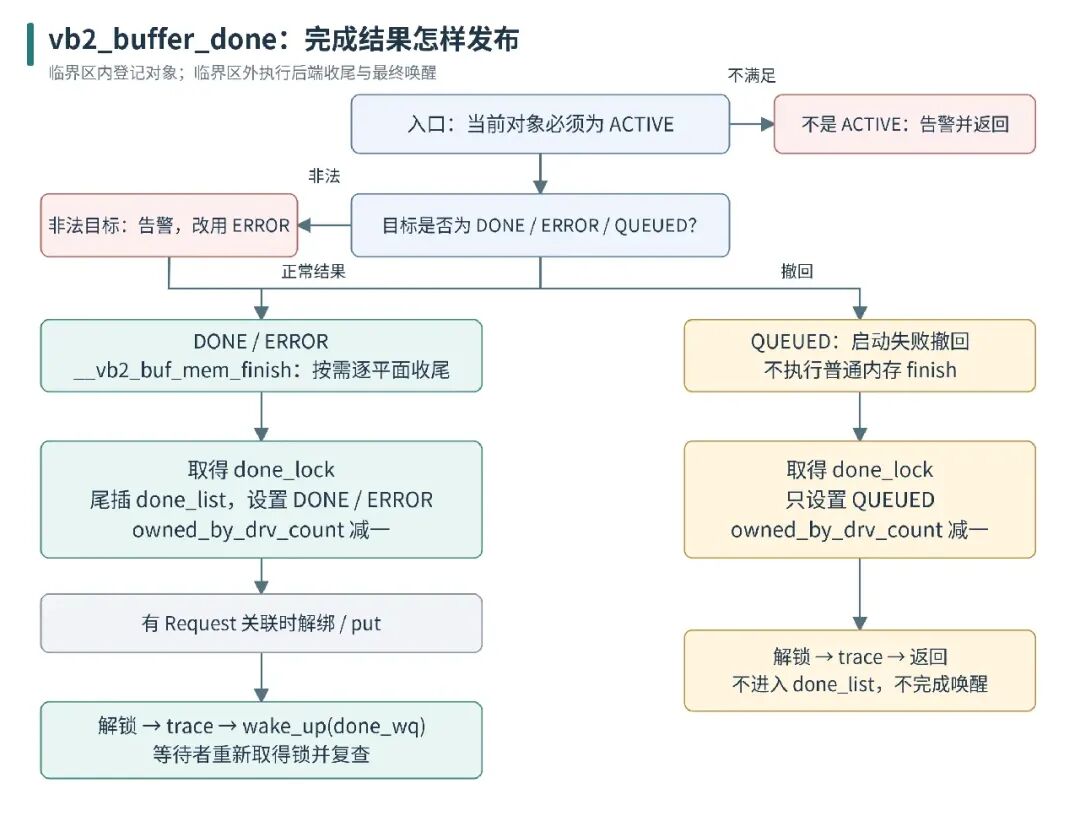
图 2:DONE 和 ERROR 进入同一条完成发布主线;QUEUED 撤回不产生完成结果。内存收尾在完成锁之前,唤醒在解锁之后。
3.5 驱动不能把“计数归零”当成已完成全部清理
owned_by_drv_count 减到零,说明对象已经通过约定路径归还。它不能证明某条硬件任务一定停止,也不能证明工作线程已经退出。驱动必须在归还之前安排好这些事实,不能反过来依赖一个软件计数替硬件兜底。
完成函数还会被真实设备的中断或其他异步路径调用,因此额外加入的处理必须满足实际执行上下文约束。不能在硬中断里添加可睡眠的清理,也不能把“大块像素复制”搬到 done_lock 保护范围内。
实现对照:vb2_buffer_done()、__vb2_buf_mem_finish() 和 vb2_vmalloc_memops。
4. 一块缓冲区,为什么可以同时出现在两条 VB2 链表里
4.1 三条链表分别在记录什么
沿 VIMC 观察,会遇到三条列表:
q->queued_list 记录已经提交给 VB2、但尚未完成 DQBUF 的对象。即使图像已经完成,只要还没有出队,它仍可以留在这里。
vcapture->buf_list 是驱动自己的待处理列表。对象通过驱动扩展中的 list 挂接,VIMC 准备处理它时将它摘下。
q->done_list 保存已经完成、等待 DQBUF 取出的对象,使用 vb2_buffer 中的另一个成员 done_entry。
不同列表使用不同的内嵌成员,所以一个完成对象可以同时拥有 queued_entry 和 done_entry 两种关系。它们不是两个互斥的像素仓库,也没有复制两份图像。
4.2 用 buffer 0 看一轮连续变化
下面假定只有 buffer 0 和 buffer 1 提交,buffer 0 先完成;各行是受控的阶段快照,不是声称真实线程一定按截图顺序停住。
queued_list | buf_list | done_list | |||
|---|---|---|---|---|---|
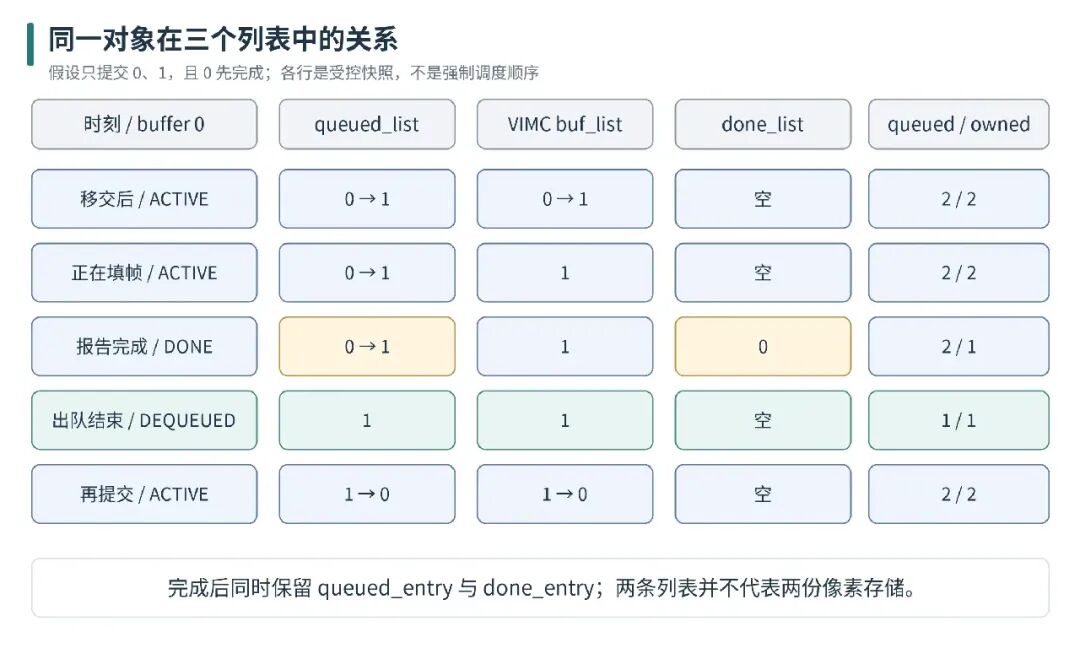
图 3:done 减少驱动持有数;DQBUF 才减少提交计数。正在填帧的对象虽然已离开驱动待处理列表,仍然属于驱动责任范围。
4.3 出队依据完成列表,不依据索引大小
vb2_buffer_done() 尾插完成列表,DQBUF 取列表首项。因此,正常串行消费时依据的是完成列表中的顺序,不是索引排序。
并发完成时,顺序取决于完成对象进入这条列表的先后;VB2 不在此额外按时间戳、拍摄时刻或 sequence 排序。应用应该读取返回元数据,而不是从 index 推导拍摄顺序。
对外的 V4L2_BUF_FLAG_QUEUED/DONE 也不是两条内部链表的直接位图。它们按对象状态填写;内部同时挂两条列表,并不表示对外两个标志也要同时置位。
实现对照:vb2_core_qbuf()、vimc_capture_buf_queue()、vimc_capture_process_frame()、vb2_buffer_done()、vb2_core_dqbuf()。
5. DQBUF 从哪里进入,当前操作拿的是哪把锁
5.1 最小请求只声明要从哪类队列取回
假设已经运行普通单平面 MMAP 采集:
structv4l2_bufferb = {0};
b.type = V4L2_BUF_TYPE_VIDEO_CAPTURE;
b.memory = V4L2_MEMORY_MMAP;

int ret = ioctl(fd, VIDIOC_DQBUF, &b);
/* 仅在 ret == 0 后,用 b.index 查映射,再解释本次结果。 */
这里没有把像素地址传进内核,也没有指定必须返回哪个 index。多平面时还要准备 v4l2_plane[],其检查稍后讨论。
5.2 驱动操作表建立实际连接
VIMC 把 .vidioc_dqbuf 接到 vb2_ioctl_dqbuf。调用路径为:
v4l2_ioctl → video_ioctl2 → video_usercopy
  → __video_do_ioctl
    → v4l_dqbuf:check_fmt
      → vidioc_dqbuf = vb2_ioctl_dqbuf
        → vb2_dqbuf
          → vb2_core_dqbuf
            → __vb2_get_done_vb
              → __vb2_wait_for_done_vb
外层参数编组和命令表已经在第二篇介绍,本篇只保留返回过程中必需的边界:核心收到的 b 是本次 ioctl 的内核临时描述,多平面数组也经过相应编组,不是让自旋锁中的校验去直接读取任意应用地址。
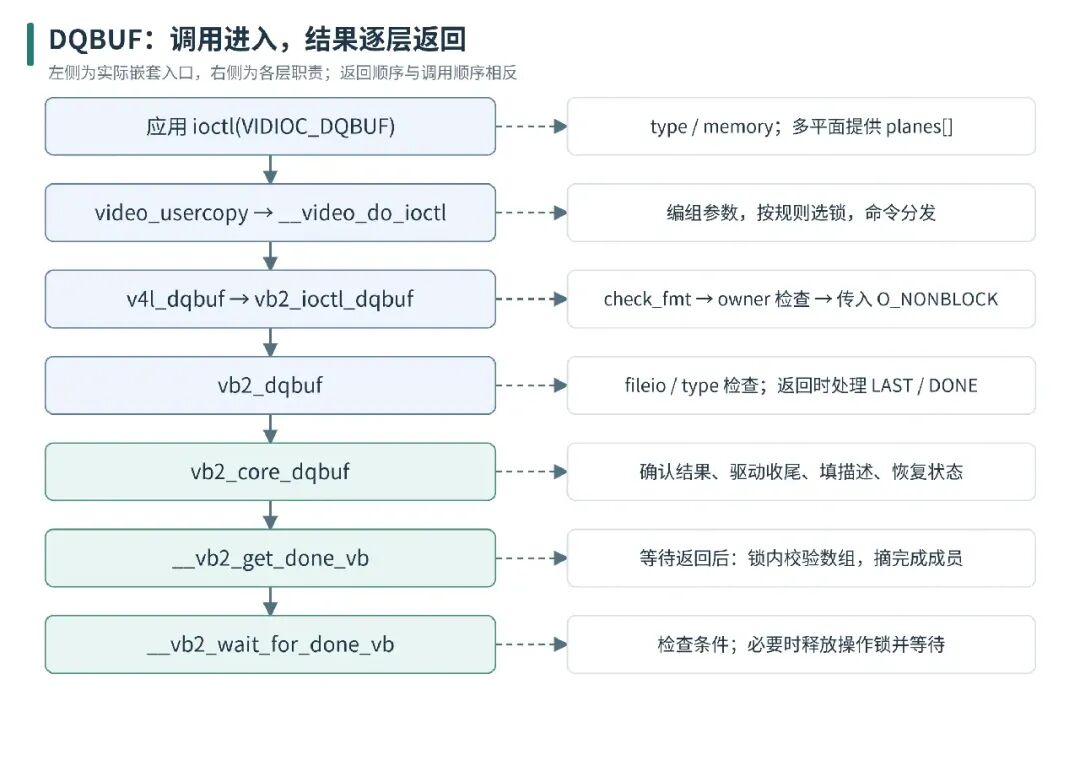
图 4:等待函数返回给取出函数,取出函数返回给核心,随后逐层收尾。各层有自己的检查,不能把最内层返回零等同于整次 ioctl 已成功。
最外层辅助函数如下:
intvb2_ioctl_dqbuf(struct file *file, void *priv, struct v4l2_buffer *p)
{
structvideo_device *vdev = video_devdata(file);

if (vb2_queue_is_busy(vdev->queue, file))
return -EBUSY;
return vb2_dqbuf(vdev->queue, p, file->f_flags & O_NONBLOCK);
}
它先检查队列归属,再把 O_NONBLOCK 从文件状态传入后续函数。非 owner 的另一独立打开可能在这里得到 EBUSY,还没有进入完成列表等待。
vb2_dqbuf() 随后拒绝正在 fileio 模式下运行的队列,检查 b->type == q->type,再调用核心。它不按应用输入的 index 选择结果,也不是原样复用 QBUF 的全部参数检查;返回的 memory 来自内部对象,应用仍应按接口填写正确模式。
5.3 锁在标准分发层取得,不是核心每次自行取得
命令表给 VIDIOC_DQBUF 配置 INFO_FL_QUEUE。标准分发按队列相关规则选锁;本例 q->lock 与 vdev->lock 都指向 vcapture->lock。
这把互斥锁串行化正常队列操作。vb2_core_dqbuf() 本身不会替任意直接调用者获取它。自行调用核心接口的驱动必须遵守同样的同步约定,否则后面“检查非空后,取出时仍非空”的推理就不成立。
DQBUF 表项没有 INFO_FL_PRIO,所以不能把所有 EBUSY 都解释成 V4L2 优先级不足。这里更直接的原因包括 owner 冲突、fileio 占用或已有另一个出队等待者。
实现对照:v4l_dqbuf()、v4l2_ioctls[]、v4l2_ioctl_get_lock()、vb2_ioctl_dqbuf()、vb2_dqbuf()。
6. 等待完成:不是一进 DQBUF 就睡眠
6.1 先把“没有帧”分成不同情况
__vb2_wait_for_done_vb() 在循环中依次判断:
-EBUSY | ||
-EINVAL | ||
-EIO | ||
-EPIPE | ||
done_list | ||
-EAGAIN | ||
顺序本身有意义。队列已经设置 error,即使列表里还有完成对象,这条路径也会先返回 EIO。不能把“列表非空”当成绕过所有状态检查的许可。
waiting_in_dqbuf 是队列级的等待标志,不是 fd 数量。某个调用等待期间释放操作锁后,另一个共享上下文的 DQBUF 才能进入并看到这个标志;它甚至可能是非阻塞调用,仍会因为前面的检查得到 EBUSY。
6.2 阻塞只发生在允许等待且暂无结果时
真正进入等待部分后,去掉调试日志的关键控制流为:
q->waiting_in_dqbuf = 1;
call_void_qop(q, wait_prepare, q);

ret = wait_event_interruptible(q->done_wq,
        !list_empty(&q->done_list) || !q->streaming ||
        q->error);

call_void_qop(q, wait_finish, q);
q->waiting_in_dqbuf = 0;
if (ret)
return ret;
等待条件有三个:出现完成对象、队列停止、队列错误。它并不只等“有新图像”。收到信号时,等待也可能以中断错误结束。
返回后先重新取得操作锁,再清除等待标志。没有信号错误时,回到外层循环重新检查状态,不能仅凭被唤醒就直接从列表取对象。
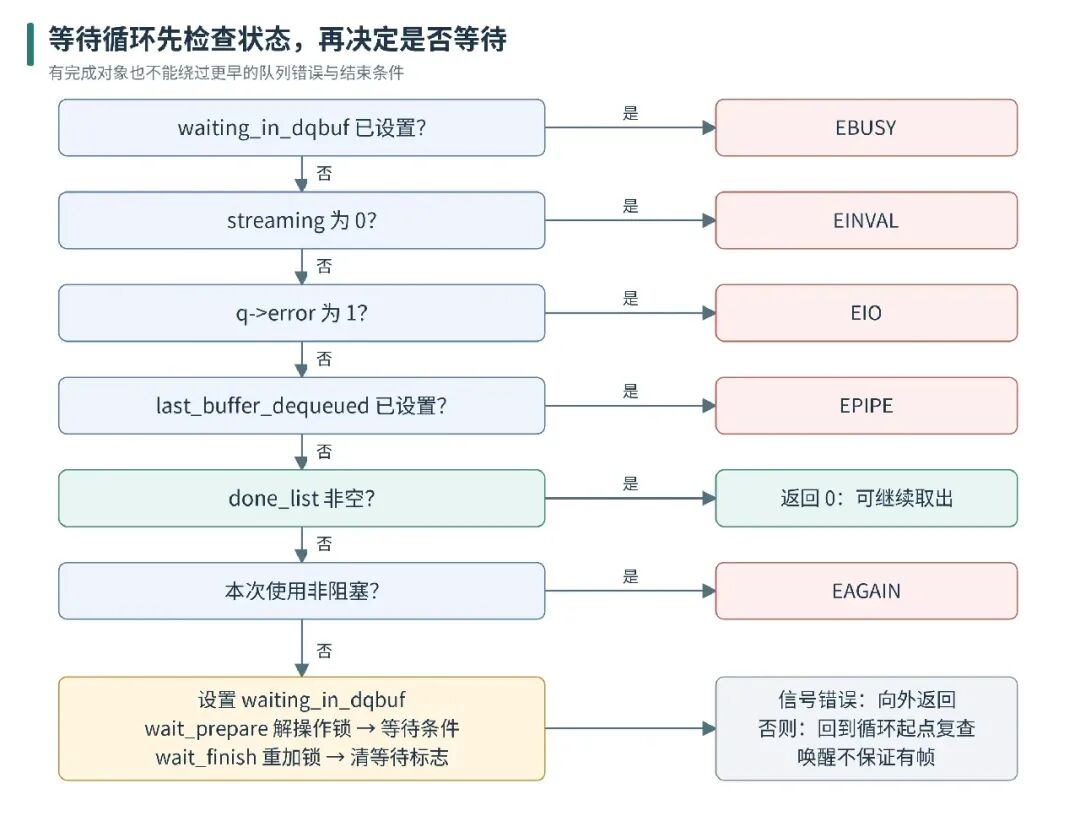
图 5:阻塞调用也可能立即取得已有完成结果。等待被唤醒后走的是重新检查,不是无条件宣告有帧。
6.3 完成恰好发生在睡眠之前,会不会错过?
考虑这样的时序:DQBUF 刚判断列表为空,驱动就完成了一个对象,随后 DQBUF 才进入等待宏。
标准等待宏会围绕等待队列登记重新检查条件。如果条件已经成立,就不需要真正睡眠;即使唤醒发生在它正式睡下之前,也不是把完成结果当作一个已经丢失的瞬间脉冲。完成列表中的对象是持续存在的条件,直到被取走或被取消。
这个结论依赖正常的链表、锁和等待协议。单独增加一个 wake_up(),不能修复驱动未正确发布状态、提前释放对象或破坏互斥规则的问题。
6.4 核心为何可以先不持 done_lock 检查非空?
源码注释给出了前提:驱动完成路径在 done_lock 下追加对象;正常 DQBUF 的移除路径则同时受外层操作锁与 done_lock 保护。
因此,当前线程持有正确的外层操作锁并观察到非空后,另一个遵守协议的出队或取消路径不能抢先移除最后一个对象。下一层取得 done_lock 后就可以直接取首项。若驱动自行从其他无关路径删列表,这一前提被破坏,辅助函数不会自动补救。
实现对照:__vb2_wait_for_done_vb()、__vb2_get_done_vb(),以及配套等待回调契约。
7. 等待时为什么必须让出操作锁
7.1 让出的不是完成列表自旋锁
VIMC 配置了以下两个标准辅助函数:
voidvb2_ops_wait_prepare(struct vb2_queue *vq)
{
    mutex_unlock(vq->lock);
}
voidvb2_ops_wait_finish(struct vb2_queue *vq)
{
    mutex_lock(vq->lock);
}
它们操作的是 vq->lock 指向的互斥锁。等待之前解锁,返回以后重新加锁;done_lock 不会被这两个函数操作。
如果一个 DQBUF 一直握着操作锁等待,而另一个线程必须取得同一把锁才能 STREAMOFF 或继续 QBUF,后者就无法推进队列。临时让出操作锁,正是为了让这些操作有机会执行。
这不表示 VIMC 每次填帧都必须先取得 vcapture->lock。它使用自己的 qlock 处理私有列表,完成函数再短暂取得 done_lock;不要把三把锁画成同一把。
7.2 一个正常的跨线程时序
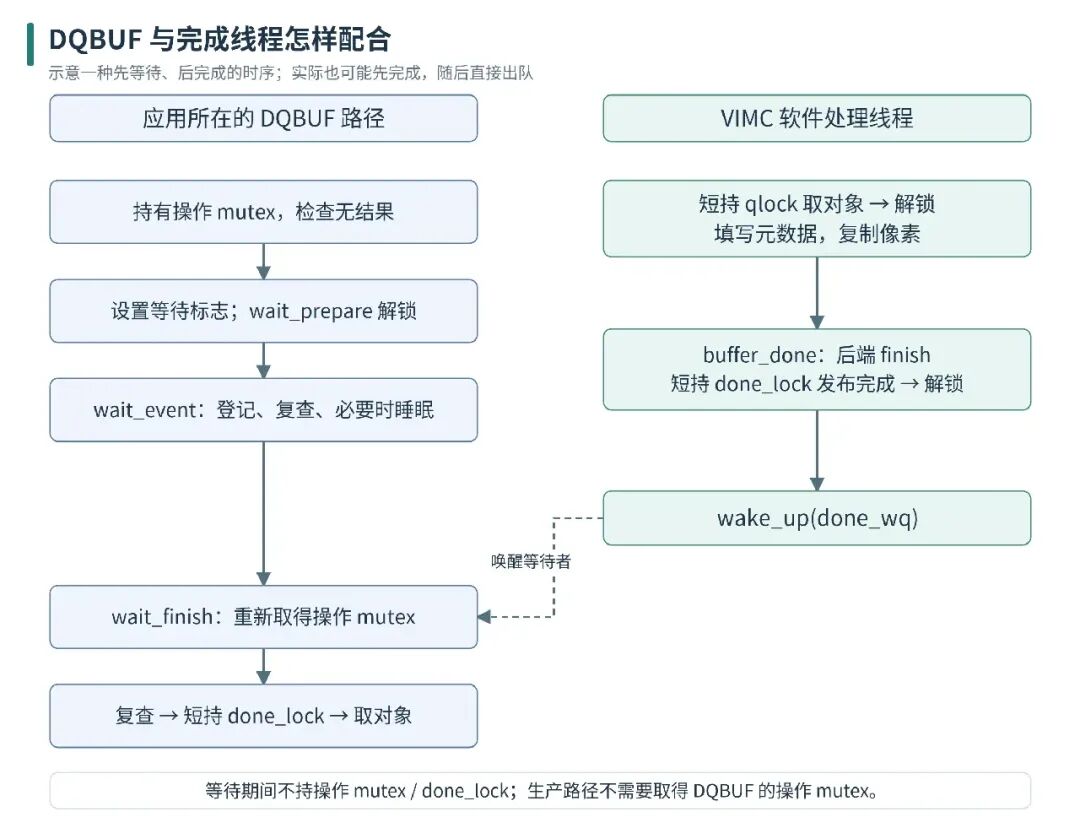
图 6:左侧在 DQBUF 等待时释放操作锁;右侧完成路径不需要取得这把操作锁。唤醒后,左侧重新取得锁并复查,再进入短暂的完成列表临界区。
标准辅助函数的使用前提是:q->lock 有效,而且正是当前调用路径实际持有的那把锁。自行取得另一把锁却机械挂接标准 wait 回调,会造成错误解锁或锁顺序问题。
硬件完成路径要使用适合实际中断上下文的锁;VIMC 的软件 qlock 用法不能直接复制到任意硬中断驱动。
7.3 中断等待的返回还要经过系统调用层
内核可中断等待可能返回 -ERESTARTSYS。它属于内核重启系统调用的机制,应用是否观察到 EINTR、调用是否被重启,需要结合信号和重启规则,不能把内核数值直接当成应用 errno。
对应用而言,应明确处理 EINTR;对驱动而言,即使等待被中断,也必须先恢复进入该路径时的锁约定,再向外返回。
实现对照:VIMC 的 vimc_capture_qops、vb2_ops_wait_prepare/finish()、__vb2_wait_for_done_vb()。
8. 从完成列表取出对象:为什么先检查平面数组
8.1 等待成功以后,还没有立即移除
取出函数的完整实现如下:
staticint __vb2_get_done_vb(struct vb2_queue *q, struct vb2_buffer **vb,
void *pb, int nonblocking)
{
unsignedlong flags;
int ret = 0;

/*
     * Wait for at least one buffer to become available on the done_list.
     */
    ret = __vb2_wait_for_done_vb(q, nonblocking);
if (ret)
return ret;

/*
     * Driver's lock has been held since we last verified that done_list
     * is not empty, so no need for another list_empty(done_list) check.
     */
    spin_lock_irqsave(&q->done_lock, flags);
    *vb = list_first_entry(&q->done_list, struct vb2_buffer, done_entry);
/*
     * Only remove the buffer from done_list if all planes can be
     * handled. Some cases such as V4L2 file I/O and DVB have pb
     * == NULL; skip the check then as there's nothing to verify.
     */
if (pb)
        ret = call_bufop(q, verify_planes_array, *vb, pb);
if (!ret)
        list_del(&(*vb)->done_entry);
    spin_unlock_irqrestore(&q->done_lock, flags);

return ret;
}
外层操作锁一直保持到这里,函数再短暂取得 done_lock,选中首个完成对象。若提供了返回描述 pb,就先检查它能否容纳该对象的平面信息;只有检查成功才摘下 done_entry。
多平面数组不足时,结果仍留在完成列表,应用可以修正数组再取。不能先把完成对象移除,随后才发现没有足够的返回空间。
pb == NULL 服务于部分内核内部接口,本篇标准 ioctl 路径有描述对象,所以会执行校验。这里的校验检查内核临时描述与数组容量,不在自旋锁中重新执行可能缺页的应用地址复制。
8.2 多平面 DQBUF 的输入怎样准备
structv4l2_bufferb = {0};
structv4l2_planeplanes[VIDEO_MAX_PLANES] = {0};

b.type = V4L2_BUF_TYPE_VIDEO_CAPTURE_MPLANE;
b.memory = V4L2_MEMORY_MMAP;
b.m.planes = planes;
b.length = VIDEO_MAX_PLANES;
b.length 表示数组能够容纳的元素数量,不是某个平面的字节容量。当前 __verify_planes_array() 要求指针非空、容量不少于实际平面数且不超过支持上界。
成功后,b.length 改为实际平面数。各平面的容量和载荷保存在对应 planes[p] 中;顶层 b.bytesused 不承担多个平面的总载荷统计。
VIMC 捕获节点本身采用单平面接口。这段多平面代码用于说明公共接口,不能据此声称 VIMC 支持相应的多平面格式。
8.3 不同错误点,留下的状态并不一样
数组校验失败发生在摘下之前,因此不会消耗该完成对象。但后续核心发现内部状态不是 DONE/ERROR 时,代码是在已经摘下 done_entry 之后返回 EINVAL,并没有自动把它重新插回。这是内部协议异常,不是正常参数重试场景。
再往外,参数回写失败时内部出队甚至已经完整结束。因此不能笼统地说“DQBUF 返回错误,缓冲区一定仍在原处”。要根据错误发生在哪个阶段判断。
实现对照:__vb2_get_done_vb()、__verify_planes_array()、vb2_core_dqbuf()。
9. vb2_core_dqbuf():取到以后,还要按顺序收尾
9.1 先确认是普通完成结果
核心取得对象后接受 DONE 与 ERROR;其他内部状态返回 EINVAL。ERROR 在这里是可以正常交付的结果状态,而不是立即返回一个负错误码。
后续正常路径的连续节选为:
call_void_vb_qop(vb, buf_finish, vb);
vb->prepared = 0;

if (pindex)
    *pindex = vb->index;

/* Fill buffer information for the userspace */
if (pb)
    call_void_bufop(q, fill_user_buffer, vb, pb);

/* Remove from vb2 queue */
list_del(&vb->queued_entry);
q->queued_count--;

trace_vb2_dqbuf(q, vb);

/* go back to dequeued state */
__vb2_dqbuf(vb);
其顺序不能随意调换:先执行可选的驱动 buf_finish,再清 prepared、填写本次返回描述,然后撤销提交关系,最后恢复 DEQUEUED。
9.2 两个 finish 发生在不同时间
vb2_buffer_done() | mem_ops->finish | |
vb2_core_dqbuf() | ops->buf_finish |
VIMC 没有提供 buf_finish,vmalloc 后端也没有提供内存 finish;本例经过这些可选调用位置,但不存在对应的具体回调工作。它们的次序仍然重要,因为其他驱动和后端可能实现这些接口。
驱动 buf_finish 在描述填充之前,意味着它整理的标志等结果可以被带回。不要将其移到填充之后,否则应用拿到的仍可能是整理之前的描述。
9.3 描述填充时,内部 state 仍是 DONE 或 ERROR
q->buf_ops->fill_user_buffer 接到 __fill_v4l2_buffer()。它从内部对象取得 index、type、memory、载荷、时间戳、序号和标志。
填充时 state 尚未改回 DEQUEUED,所以函数可以根据 DONE/ERROR 生成状态相关结果;ERROR 会同时设置错误标志和当时的 DONE 标志。随后 V4L2 包装层还会清除返回的 DONE,不能只停在这个填充函数就判断应用最终看到什么。
多平面分支将顶层 bytesused 保持为零,逐项填写每个平面的 bytesused/length/data_offset。单平面分支则把第 0 平面的容量和载荷写入顶层字段。
9.4 从两条列表退出,不释放像素存储
done_entry 已在上一层摘下;这里才删除 queued_entry 并减少 queued_count。本轮提交关系到此结束,但 q->bufs[index] 仍指向原来的缓冲区对象,MMAP 存储和映射也继续存在。
__vb2_dqbuf() 的实现很短:
staticvoid __vb2_dqbuf(struct vb2_buffer *vb)
{
structvb2_queue *q = vb->vb2_queue;

/* nothing to do if the buffer is already dequeued */
if (vb->state == VB2_BUF_STATE_DEQUEUED)
return;

    vb->state = VB2_BUF_STATE_DEQUEUED;

    call_void_bufop(q, init_buffer, vb);
}
它恢复 DEQUEUED,并调用接口层的 init_buffer。当前 V4L2 的这个回调只是把 request_fd 设为 -1,不会清零整帧像素,也不会重新分配缓冲区。
随后核心还处理适用的 Request 引用;本篇普通路径没有关联对象。不能把这些引用处理误读成每次 DQBUF 都解除 MMAP 或释放整块内存。
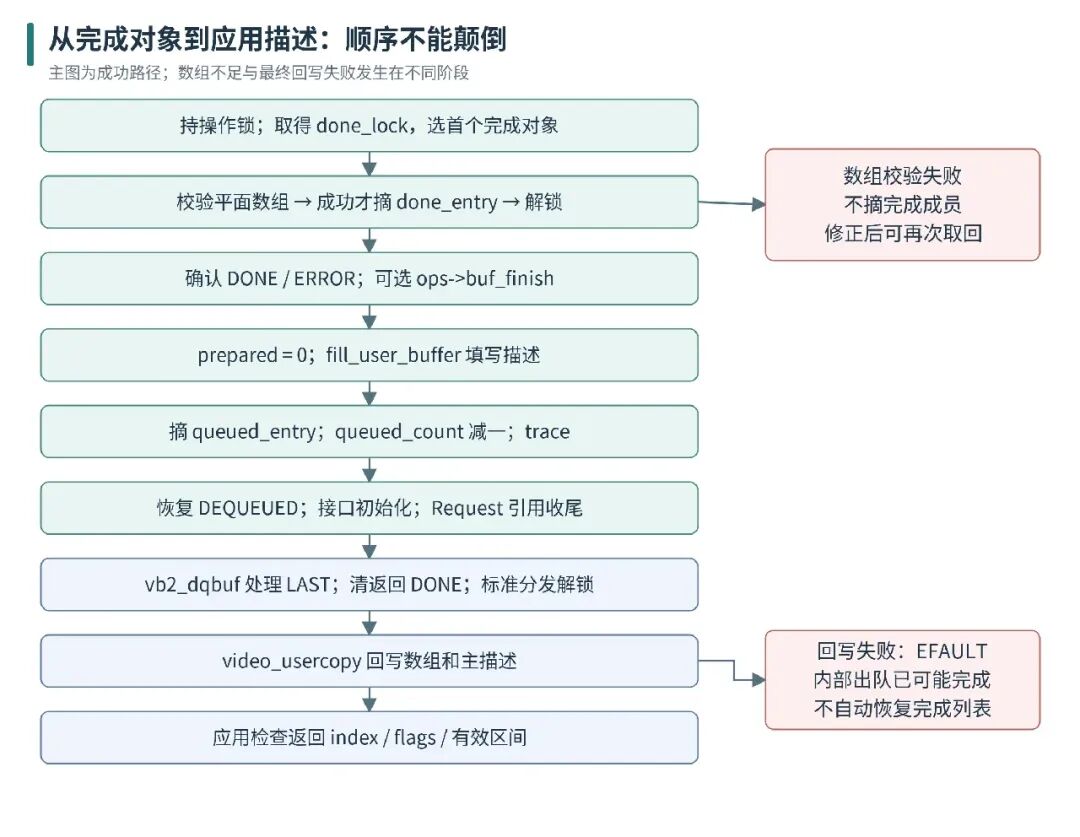
图 7:内部状态先完成交接,外层再回写描述。像素仍在已有映射里;回写失败也不会自动撤销已经完成的内部出队。
9.5 正常一轮结束时的标志
只观察 buffer 0,普通成功路径为:
这是一轮正常过程,不包括启动失败撤回或 Request 分支。synced 是配对标志,不直接等同于硬件缓存状态;未完成正常取回时也不能只凭 state == DEQUEUED 概括所有失败后的访问约束。
实现对照:vb2_core_dqbuf()、__vb2_dqbuf()、__fill_v4l2_buffer()、__init_vb2_v4l2_buffer()。
10. 返回应用之前:DONE、ERROR、LAST 与参数回写
10.1 成功 DQBUF 后,DONE 标志反而会被清除
V4L2 包装层 vb2_dqbuf() 在核心调用之后执行:
if (!q->is_output &&
    b->flags & V4L2_BUF_FLAG_DONE &&
    b->flags & V4L2_BUF_FLAG_LAST)
    q->last_buffer_dequeued = true;

b->flags &= ~V4L2_BUF_FLAG_DONE;
return ret;
DONE 表示还处于完成、等待取出的阶段。成功 DQBUF 已经取回对象,因此对外清除这个标志是正常行为;不能要求 b.flags & DONE 非零才处理图像。
ERROR 标志不会在这里一同被清除。它表示这块对象虽然成功取回,载荷却可能不可靠;普通处理可以丢弃该帧,再按约定重新提交对象,而不是因任何错误标志都立即假定队列已经崩溃。
这份代码的 LAST 判断没有额外写 ret == 0。调用描述应每轮重新初始化,应用只在 ioctl 成功后解释本次返回字段,不能把失败时残留的 DONE/LAST 当成新结果。
10.2 LAST 与普通“暂时没有帧”不同
CAPTURE 收到带 LAST 语义的结果后,包装层设置 last_buffer_dequeued。后续等待检查会返回 EPIPE,而不是继续阻塞或只返回 EAGAIN。
这用于具备相应流结束语义的设备,常见于编解码队列。本文 VIMC 普通采集并未用 LAST 结束每一轮,不能把一次超时、一次丢帧或最后一个索引解释成 LAST。
10.3 核心返回成功,整次 ioctl 还可能失败
核心修改的是内核临时描述。离开标准分发并解锁后,video_usercopy() 还要恢复数组指针、回写平面数组和主结构体,再释放临时内存。
若回写地址无效,应用最终得到 EFAULT,但对象可能已经从两条列表摘下、状态也已恢复 DEQUEUED。本层不自动把它放回完成队列。多平面数组与主结构体的复制也不是一个不可分割的事务。
这类错误后不能猜一个 index 继续操作,也不能指望下一次 DQBUF 必然返回刚才那一帧。应先修正地址或 ABI 问题,再通过明确的停止、回收和重新提交过程重建已知状态。
普通 EAGAIN 则不同:在这条标准等待路径中,它发生在还没有可取结果时,没有消耗一个完成对象。不同 errno 需要放回具体阶段解释。
10.4 成功日志不能替代最终返回值
trace_vb2_dqbuf 出现在核心恢复 DEQUEUED 之前;外层 trace_v4l2_dqbuf 也早于应用参数回写。看到 trace 只能证明执行到了相应阶段,不能证明应用最终收到了完整描述。
实现对照:vb2_dqbuf()、video_usercopy()、DQBUF 命令表项和两层 trace 位置;接口约定见文末的缓冲区标志说明。
11. poll 怎样等待:它报告就绪,不替应用取走缓冲区
11.1 poll 与 DQBUF 是两条入口
VIMC 使用 .poll = vb2_fop_poll。调用经过文件操作入口,进入 vb2_poll(),再由 vb2_core_poll() 检查数据队列。它不经过 video_ioctl2() 的命令分发表。
vb2_fop_poll() 选择队列锁或节点锁,在调用期间取得它,返回事件掩码前再释放。实际 poll 系统调用要睡眠时,并不是一直把这把操作锁握在手里。
11.2 poll_wait() 登记等待关系,不是自己睡下去
核心先调用:
poll_wait(file, &q->done_wq, wait);
它把当前 poll 检查与完成等待队列建立联系,实际等待由 poll 系统调用框架安排。代码特意把登记放在请求事件筛选之前,避免后续再检查时无法补上需要的等待关系。
对本文已经建立 MMAP 缓冲区池的路径,随后检查请求方向、streaming、queue error、兼容性等待标志,以及完成列表。CAPTURE 的 DONE 或 ERROR 对象可以报告 EPOLLIN | EPOLLRDNORM;应用接口中的相应名称是 POLLIN | POLLRDNORM。
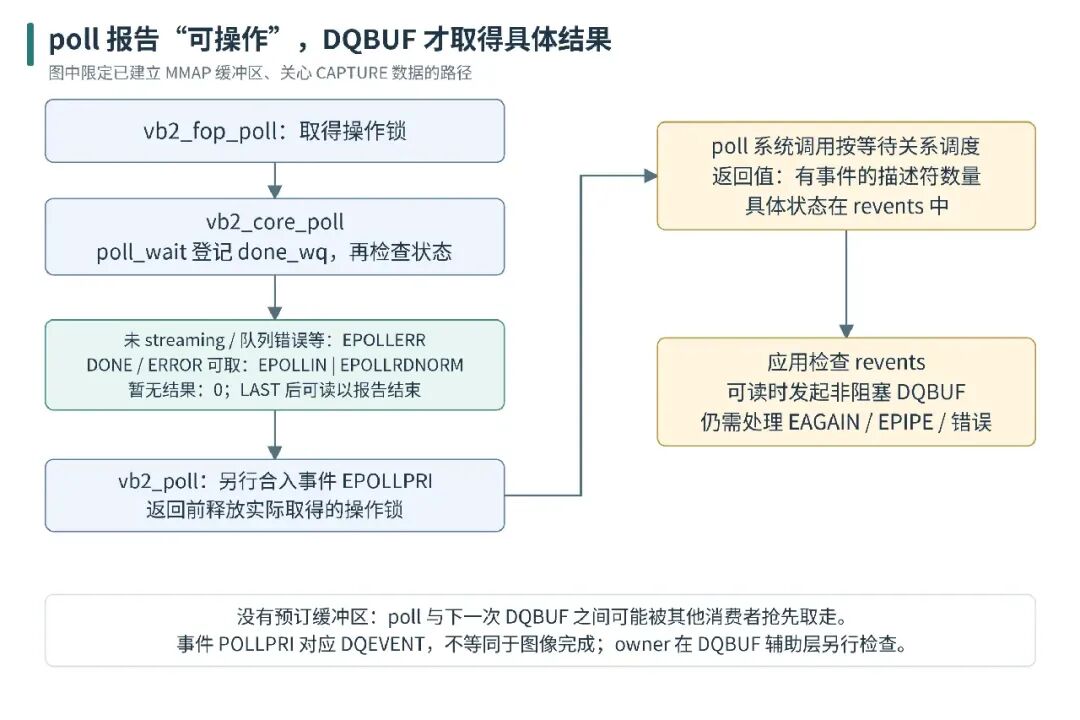
图 8:普通采集数据路径。poll 返回的是就绪状态,DQBUF 返回的才是具体缓冲区描述。没有注册事件订阅的 VIMC 示例,不将 POLLPRI 当作图像完成。
11.3 这几个容易误判的结果
单个 ERROR 缓冲区可以表现为可读。 它仍有一个可 DQBUF 的完成结果;并不是每次载荷损坏都报告 POLLERR。
流停止或队列 error 可以报告 POLLERR。 poll 系统调用本身仍可能返回正数,正数表示至少一个描述符有返回事件,不保证所有事件都是正常图像就绪。
LAST 后也可能报告可读。 当前实现让空完成队列且已取走 LAST 的 CAPTURE 返回可读,使后续 DQBUF 立即报告 EPIPE。可读意味着操作不必继续等待,并不永远意味着还有一帧正常图像。
V4L2 事件则通过 fh->wait 与 v4l2_event_pending() 额外贡献 POLLPRI。事件应使用 DQEVENT 取出,不能把它当成 DQBUF 的另一种通知名称。
11.4 poll 没有为后续 DQBUF 预订对象
poll 释放操作锁、返回应用以后,另一个共享上下文的消费线程可能先取走最后一个结果;队列也可能已经停止。因此,非阻塞 DQBUF 仍必须处理 EAGAIN 和其他状态错误。
这个 poll 辅助入口也不做与 vb2_ioctl_dqbuf() 相同的 owner 检查。另一个已经打开的上下文看到就绪,并不代表它有权操作那条已被占用的队列。
实际程序应检查 revents,不能只判断 poll() > 0。POLLNVAL、POLLHUP 和 POLLERR 都需要单独处理,事件路径也需要自己安排消费。
11.5 本篇范围之外的 fileio 分支
vb2_core_poll() 还可能在未建立流式缓冲区、队列支持 READ/WRITE 时启动 fileio 辅助流程。不能把“本篇 poll 没有申请缓冲区”推广成所有 VB2 poll 都没有状态副作用。
本例已经通过 REQBUFS 建立 MMAP 池,不走该初始化分支。后续 read/write 专题再展开这条入口。
实现对照:vb2_fop_poll()、vb2_poll()、vb2_core_poll();公共语义见文末的 V4L2 poll 文档。
12. 应用取得的描述,怎样变成可处理的图像
12.1 地址由 index 查表,数据区间由结果确定
MMAP 存储已有固定映射。DQBUF 返回后,先检查 index 在实际池范围内,再使用此前登记的地址。单平面正常结果的有效区间为 [0, bytesused),且 bytesused 不得超过映射容量。
多平面时,每个平面单独检查:
data_offset <= bytesused <= 已映射的平面容量
有效数据起点 = 映射地址 + data_offset
有效数据长度 = bytesused - data_offset
例如容量为 4096、bytesused = 3000、data_offset = 128,数据区间是 [128, 3000),长度为 2872 字节,不是从偏移 128 再读取 3000 字节。
b.length 在多平面接口里是平面数,不是整帧字节数;顶层 bytesused 也不是各平面载荷的总和。应用需要逐平面使用返回描述。
12.2 元数据有各自的时钟和含义
index 标识存储位置,sequence 表示驱动报告的结果序号,timestamp 表示驱动按接口声明填写的时间。它们不能互相替代。
VIMC 使用单调时钟并在复制前取样。本例中,“应用当前单调时间减去返回时间戳”包含软件复制、完成登记、调度和排队等时间;它不是从 Sensor 曝光到显示的端到端延迟。
不同设备还应检查时间戳类型和来源标志。不能把单调时钟时间戳直接与墙上时钟相减,也不能因为序号有跳变就只归因于 VB2。
12.3 使用结束后再提交,而不是取得地址后马上归还
同步处理时,调用图像处理函数返回以后再 QBUF。若把地址交给异步编码器、GPU 或其他线程,应等所有实际读取者结束本轮访问,再重新提交。
过早 QBUF 会允许采集端覆盖同一块存储;映射指针没有改变,访问也未必立刻报错,但得到的可能是一帧混杂内容。这是访问时序问题,不是 mmap 失败。
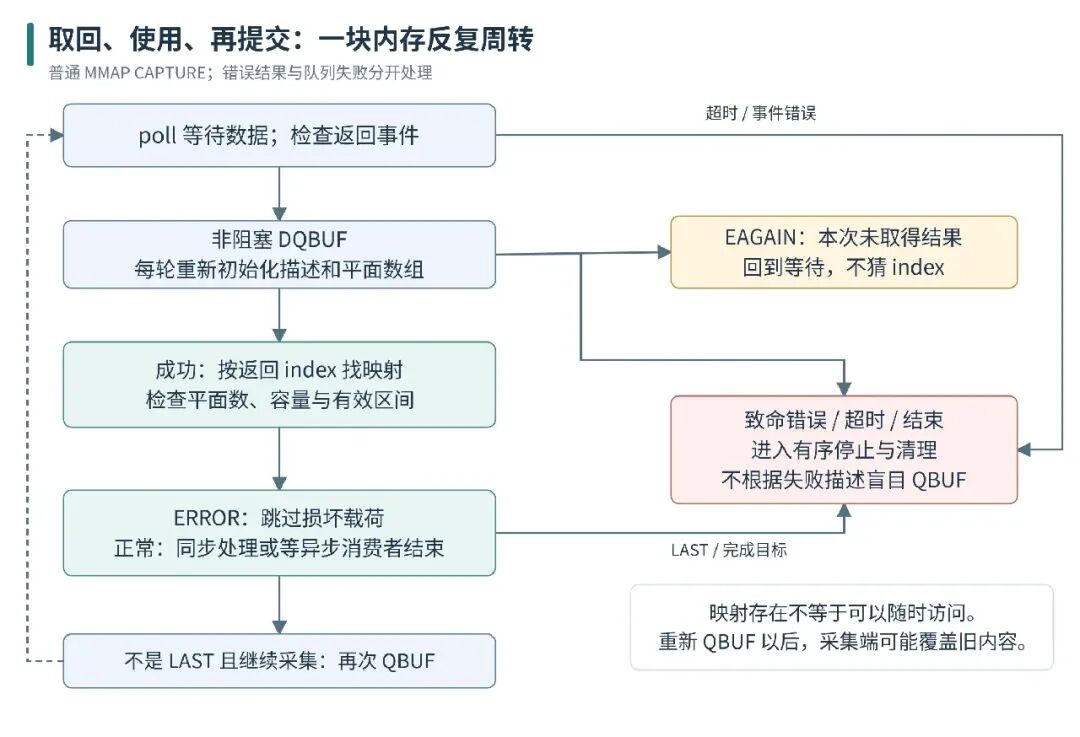
图 9:返回 index 后访问已有映射;完成处理才重新 QBUF。错误载荷与致命队列错误走不同分支,不能对所有失败都盲目重试。
12.4 一个可直接接入前文映射表的接收循环
配套 examples/dqbuf_demo.c 提供完整的单平面/多平面 MMAP 采集程序,包含能力查询、当前格式读取、申请、映射、预排、启动、poll、出队、载荷检查、短校验和及停止清理。
下面只保留运行阶段的主要组织。dequeue_and_process() 和 queue_buffer() 是配套程序中的应用辅助函数,不是内核 API:
for (unsignedint frame = 0; frame < target; ) {
structpollfdpfd = { .fd = fd, .events = POLLIN };
int ret = poll(&pfd, 1, 2000);
if (ret < 0 && errno == EINTR)
continue;
if (ret <= 0 || (pfd.revents & (POLLERR | POLLHUP | POLLNVAL)))
goto stop;
if (!(pfd.revents & POLLIN))
continue;

    ret = dequeue_and_process(fd, &pool, &index, &last);
if (ret < 0 && errno == EAGAIN)
continue;
if (ret < 0)
goto stop;
    frame++;
if (last)
break;
if (queue_buffer(fd, &pool, index) < 0)
goto stop;
}
配套完整程序每轮重新清零描述,单平面读取顶层载荷,多平面按各平面结果处理。ERROR 帧只记录并跳过内容;正常帧同步计算短校验和后再 QBUF。校验和仅用于确认代码实际访问了已出队数据,不用于证明图像质量或完整采集性能。
程序默认取回 8 个结果,不设置新格式,不保存图像文件。它会真实启动采集,必须在空闲、媒体拓扑和格式已经配置正确的测试节点运行。使用 VIMC 时应先完成相关管线配置;示例不会自动修改媒体连接。
cc -std=c11 -Wall -Wextra -Werror -O2 \
   dqbuf_demo.c -o dqbuf_demo
./dqbuf_demo /dev/video0 8
程序按“停止流、解除映射、释放池、关闭”退出;如果停止失败,不继续把可能仍由设备访问的存储当作正常空闲区使用,而是先进入关闭回收并报告错误。完整硬件断开策略仍应由驱动实现,应用错误清理不是 DMA 停止保证。
13. 按发生阶段排障,不要只记一个 errno
队列错误接口 vb2_queue_error() 只设置错误并唤醒等待者,不会自行停止硬件,也不会自动把每个 ACTIVE 变成 DONE。STREAMOFF 则会取消本轮排队结果,等待者重新检查后走停止出口;不能指望停流之后还从旧完成队列逐帧取完历史结果。
这两条路径在下一篇停止与异常退出专题继续展开。本篇到此应当能回答一个完整问题:buffer 0 写完后,怎样由驱动交回、进入完成列表、唤醒等待、被取出并转换描述,最后由应用沿已有映射访问。