ARTICLE · 1218539
一口气讲完AI芯片软件栈: 从Pytorch代码到芯片硬件
Study in 2026.10
定位:这篇文章系统梳理 AI 软件栈的七层,从推理引擎、框架、图编译、算子库、算子编译、运行时、硬件。重点在推理引擎、框架、图编译这三层——框架把代码变成图,图编译把图优化好,推理引擎把模型高效跑起来,最终落到算子编译、运行时和硬件执行。
一、AI 软件栈的八层:从应用到硬件
AI 软件栈从上到下分八层:
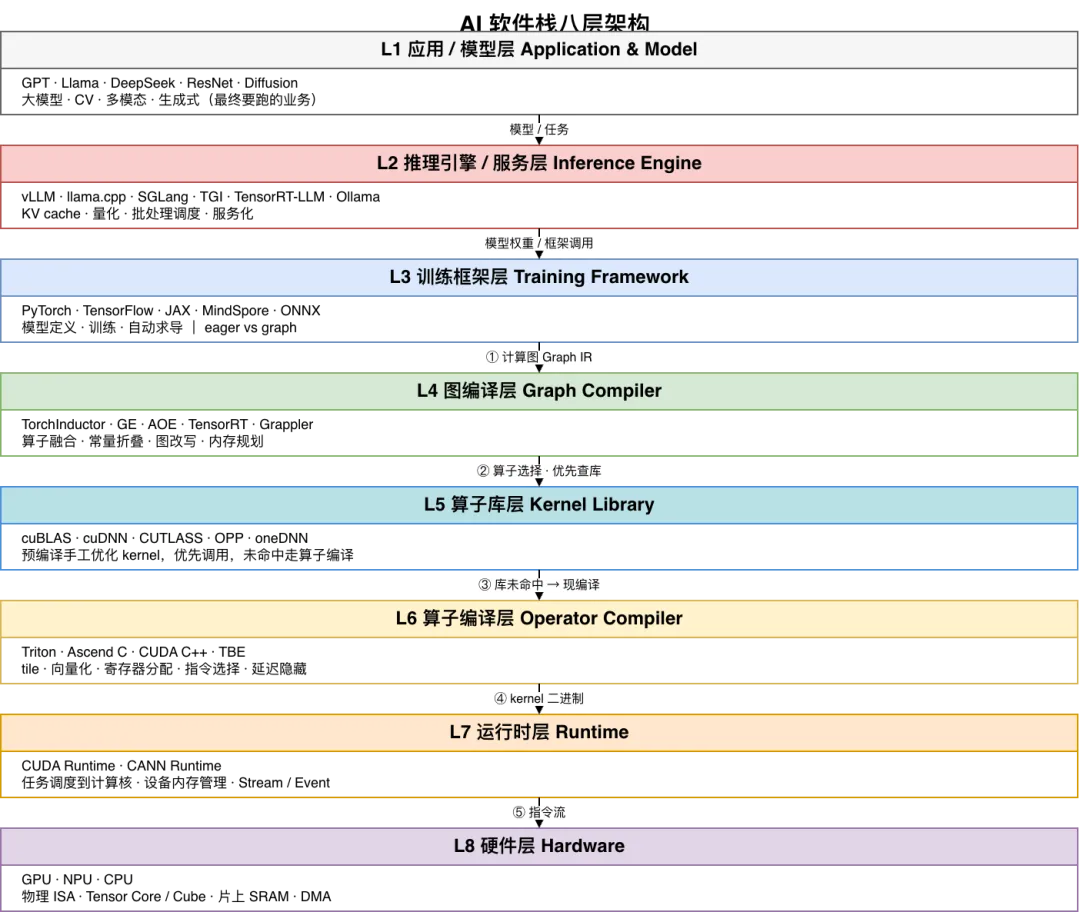
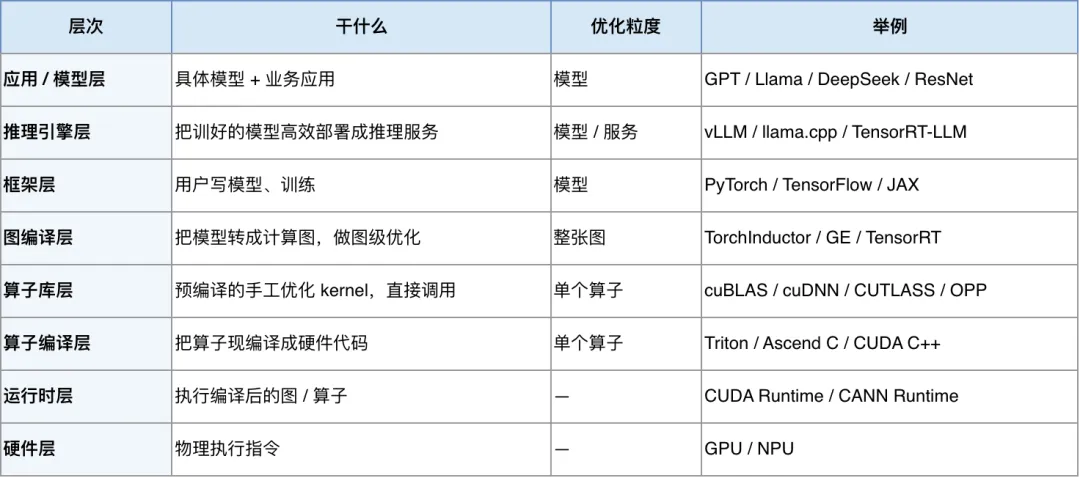
各层之间靠产出物衔接,每层只做一件明确的事,把结果交给下一层,不越界。
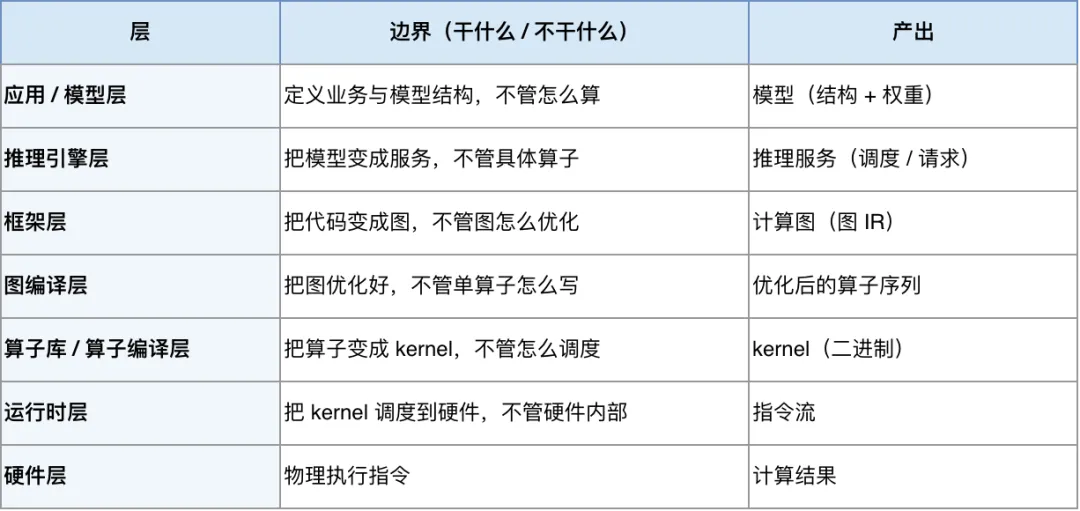
框架不优化图,图编译不写算子,算子编译不管调度。层层解耦,各层才能独立演进、独立优化。
二、推理引擎:模型怎么被高效「服务」起来
推理引擎位于应用、模型层之下,框架层之上。它的职责就一句话:把训好的模型,高效地部署成推理服务。训练框架负责造出模型,推理引擎负责让模型在真实环境里又快又省地跑起来。
2.1 为什么推理需要专门的引擎
推理和训练是两种完全不同的任务:训练要前向加反向传播再加更新权重,推理只要前向算一遍出结果。训练框架(PyTorch、TF、JAX)也能做前向推理,但它是为训练设计的,直接拿来推理会带着一身用不上的包袱。
反向传播的包袱:训练框架要维护计算图、要存中间激活,都是为了反向求导;推理根本不做反向,这些全是浪费。
优化目标相反:训练追求收敛、通用、好写;推理追求高吞吐、低延迟、省显存。
推理独有的需求:KV cache 管理、量化、continuous batching、服务化,这些训练框架一样都不擅长。
所以推理需要专门的引擎,不能直接拿训练框架凑合。这也回答了前面那个问题:训练有框架,推理也需要框架吗?需要,但推理侧的框架叫推理引擎,它和训练框架是两种完全不同的工具。
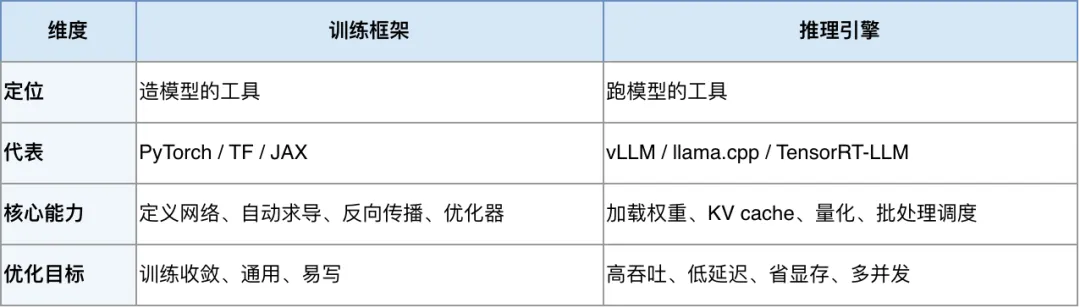
一句话:训练框架是造模型的工具,推理引擎是跑模型的工具,职责不同,所以推理要有专门的一套。
2.2 推理引擎的核心技术
推理引擎所有的技术,都围绕同一个目标:在内存带宽这个硬约束下,把 LLM 推理的吞吐和延迟做到极致。下面四件事各解决一个问题——KV cache 解决显存复用、量化解决带宽压力、continuous batching 解决算力利用率、服务化解决对外提供。
KV cache 管理:LLM 自回归解码时,每生成一个 token 都要和前面所有 token 做注意力。KV cache 把已经算过的 K、V 缓存起来复用,避免重复计算;它是显存占用的大头,vLLM 的 PagedAttention 就是专门治这个的。
低精度与量化支持:量化这个动作,是把权重从 FP16 压到 INT8、INT4,由离线的量化工具完成,比如 AutoGPTQ、AutoAWQ、llama-quantize、TensorRT 的 PTQ。推理引擎的职责,是支持这些量化模型——加载 GGUF、AWQ、GPTQ 格式,跑 INT4、INT8 的 kernel,省显存、省带宽。
continuous batching(连续批处理):不同请求生成的 token 数不一样,推理引擎动态拼接请求、随时插拔,把 GPU 利用率拉满。
服务化:提供 HTTP、gRPC 接口,支持多用户并发和流式输出,把模型变成服务。
上面四件事里,KV cache 和量化最值得展开,下面分别深入。
先看 PagedAttention 是怎么优化 KV cache 的:传统做法是,每个请求按最大长度预留一整块连续显存,但多数请求根本生成不了那么长,显存浪费可达 60% 到 80%。PagedAttention 借鉴操作系统虚拟内存的分页思路,把 KV cache 切成固定大小的 block,按需分配,用 block table 寻址。
分块:KV cache 切成固定大小 block,比如一个 block 存 16 个 token 的 KV,不再按最大长度预留整块。
按需分配:请求生成到哪,才分配下一个 block,显存按实际用量走,而不是预留最大长度。
block table 寻址:记录逻辑 KV 到物理 block 的映射,attention 时跨 block 拼起来算。
额外收益:支持跨请求共享前缀(prefix cache),还能复制 block 实现并行采样。
效果是,显存浪费从 60% 到 80% 降到 4% 以内。这些分块、映射、复用,全是 vLLM 软件层的逻辑,和硬件 cache 无关——物理显存还是走 PyTorch 到 CUDA runtime 分配。
再看量化,支持量化,和支持非量化,区别到底在哪:不只是执行时换一个对应精度的 kernel 那么简单,因为量化是精度、反量化参数、打包存储、混合精度这几件事的组合。以 group-wise INT4 为例。
非量化的 linear:x 和 W 都是 FP16,一个 FP16 GEMM kernel 直接搞定。
INT4 的 linear:要先解包权重(INT4 是两个值挤在一个 byte 里),读每组的 scale 和 zero-point,反量化,再做 GEMM;而且很多硬件没有原生 INT4 单元,得 unpack 成 INT8 再算。
更关键的是混合精度:量化几乎都是部分量化,只量化线性层,norm 和激活仍是 FP16,所以图里 INT8 和 FP16 混杂。编译栈要额外做两件事——插入反量化和重量化节点,做反量化、GEMM、量化的融合 pass。这才是支持量化的真实成本,比加几条指令大得多。
2.3 主流推理引擎对比
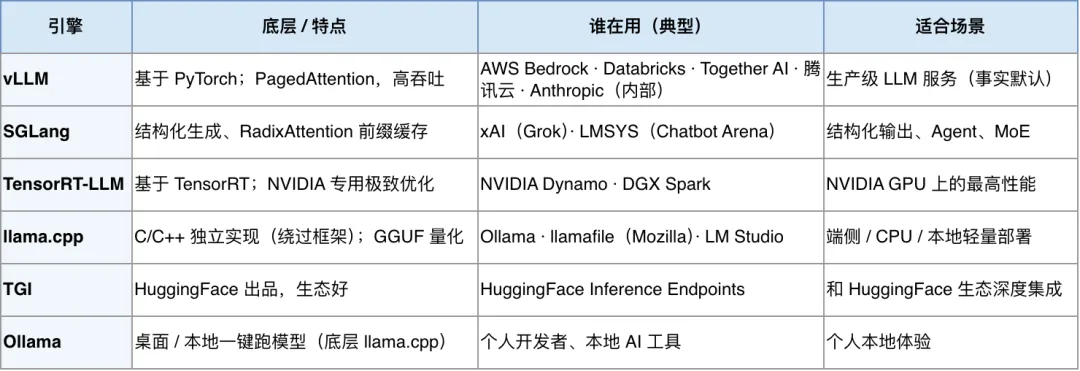
格局上,vLLM 是生产环境的事实默认,生态最全、采用者最多;SGLang 靠结构化输出和前缀缓存在 Agent、MoE 场景崛起,xAI 的 Grok 就在用它;TensorRT-LLM 是 NVIDIA 自家生态里的极致性能选择;llama.cpp、Ollama 占据本地、端侧、无 GPU 的轻量市场。对推理芯片来说,vLLM 是绕不开的——2.5 节讲的支持 PyTorch 后端,最终目的就是让 vLLM 跑在推理芯片上。
2.4 推理引擎和框架的关系
推理引擎分两类:一类构建在框架之上,比如 vLLM 依赖 PyTorch、TensorRT-LLM 依赖 TensorRT,复用框架的算子;另一类完全独立,比如 llama.cpp 用 C、C++ 从头写,直接调 CUDA、Metal,绕过框架。所以推理引擎和框架不是串行依赖,而是并行协作——引擎决定跑什么服务、怎么调度,框架和算子决定具体怎么算。
2.5 建议部署方案
推理芯片的胜负手在生态,而生态的入口就是 PyTorch。不接 PyTorch 后端,客户就得改部署流程、放弃 vLLM 这套最主流的东西,芯片再快也难用起来。所以推理芯片的战略选择是:支持 PyTorch 后端,让客户无感地继续用 PyTorch、vLLM,底层换成推理芯片的编译栈。
有两条路线:
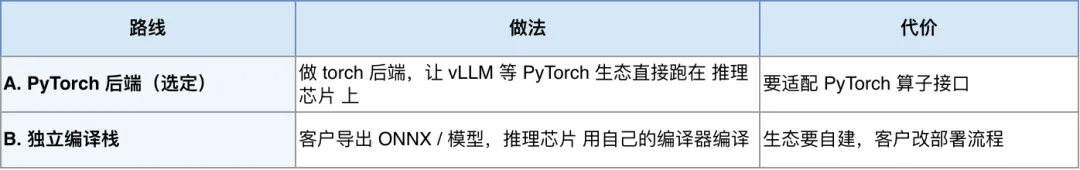
支持 PyTorch 后端的本质,是做一个 torch 后端。PyTorch 内部有 Dispatcher 机制,每个算子按 DispatchKey 分发到不同后端,比如 CPU、CUDA、MPS、XLA。给推理芯片注册一个自己的 DispatchKey,就能让 PyTorch 算子落到推理芯片的硬件上跑。
要做的四件事(按工作量排序):
设备注册:把推理芯片注册成 device(自定义 device),注册 DispatchKey。
算子实现:给算子提供推理芯片的实现,这是最大工作量——PyTorch 有 2000 多个算子,常用的几百个,先覆盖 vLLM 的核心子集。
内存和张量管理:推理芯片上的 allocator、Storage、Stream、Event。
编译栈集成:算子的实现,内部调推理芯片的图编译、算子库、算子编译。
参考对象:昇腾的 torch_npu 是直接对标,还有 AMD 的 ROCm,以及 PyTorch 2.x 的 PrivateUse1 机制——这是第三方设备注册的标准接口,走它,别自造协议。
关键理解:后端是壳,编译栈是核。torch 后端主要是算子分发和内存管理的适配层;真正决定推理芯片推理性能的,还是自己的图编译、算子库、算子编译、运行时。客户无感地继续用 PyTorch、vLLM,底层偷偷换成推理芯片的编译栈,这就是 torch_npu 给昇腾做的事。
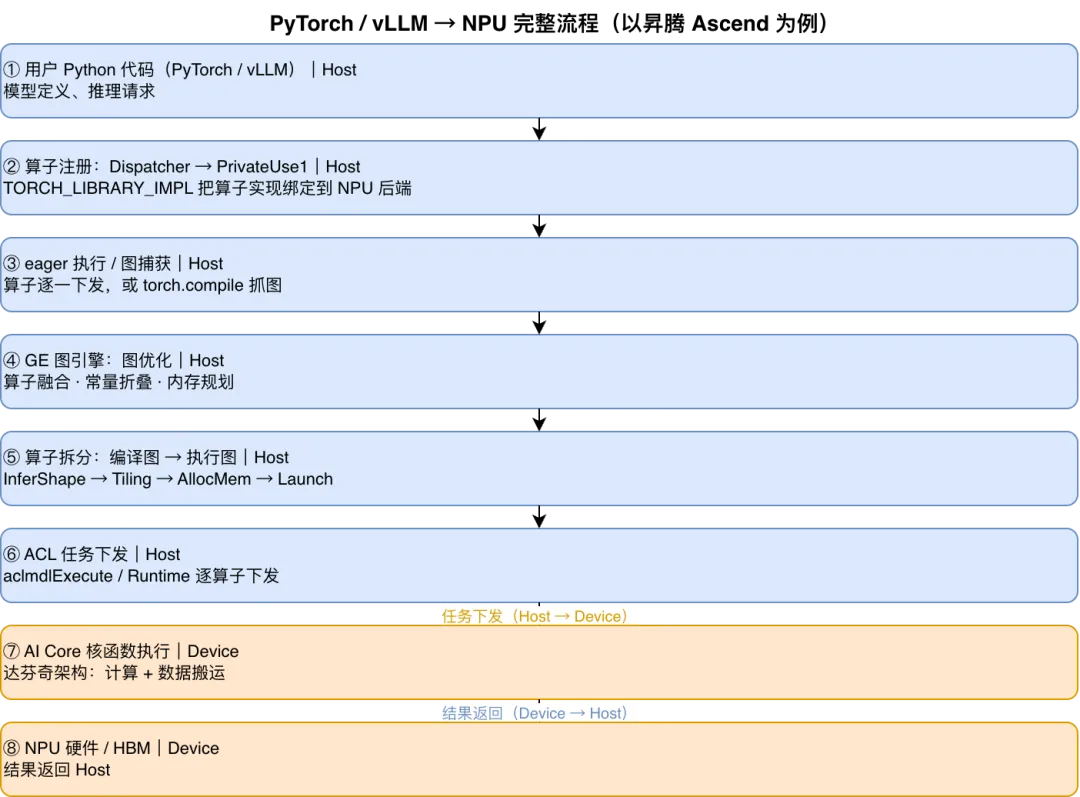
① 怎么注册后端:Dispatcher → PrivateUse1
PyTorch 内部有个 Dispatcher,也就是分发器,每个算子执行时按 DispatchKey 路由到不同后端,比如 CPU、CUDA、MPS。昇腾 NPU 作为第三方硬件,挂在 PrivateUse1 这个 DispatchKey 上。注册一个 NPU 算子分两步——用 TORCH_LIBRARY 定义算子 schema,用 TORCH_LIBRARY_IMPL 把实现绑定到 PrivateUse1。
// 1. 定义算子 schemaTORCH_LIBRARY(ascendc_ops, m) {m.def("ascendc_add(Tensor x, Tensor y) -> Tensor");}// 2. 注册 NPU 实现(绑定到 PrivateUse1)TORCH_LIBRARY_IMPL(ascendc_ops, PrivateUse1, m) {m.impl("ascendc_add", TORCH_FN(ascendc_ops::ascendc_add));}
补充一句:定义 schema 和写算子不是一回事。schema 只声明这个算子叫什么、吃什么、吐什么,不写具体怎么算;写算子才是真正实现计算逻辑。就像 C++ 里的函数声明和函数定义——m.def(...) 是声明签名,ascendc_add 的函数体才是实现,m.impl(...) 把两者绑定、挂到某个后端。之所以拆成两步,是因为同一个 schema 可以让 CPU、CUDA、NPU 各自写一套实现,Dispatcher 靠 schema 做类型检查和路由。
注册后,用户写 x + y,Dispatcher 发现 x、y 在 NPU 上,就把 add 算子路由到 NPU 的实现,这就是后端的含义。
② 代码怎么变成图
PyTorch 的代码变图、eager 与图模式的区别,详见 3.2 和 3.5。这里只需记住昇腾的结论——昇腾是「图模式为主场」,GE 图引擎是标准路径,eager 只是为兼容 PyTorch 生态补的路径。
③ 图怎么拆算子
GE,也就是图引擎,拿到图后做图级优化,比如算子融合、常量折叠、内存规划,再把编译图拆成执行图——每个算子在执行时又被拆成几个 Host Kernel:InferShape、Tiling、AllocMem、Launch。其中 Tiling 是昇腾的特色:Host 侧先算好这个算子要切几块、每块的形状和参数,再下发给 Device 执行。
④ 所谓的「服务」是什么
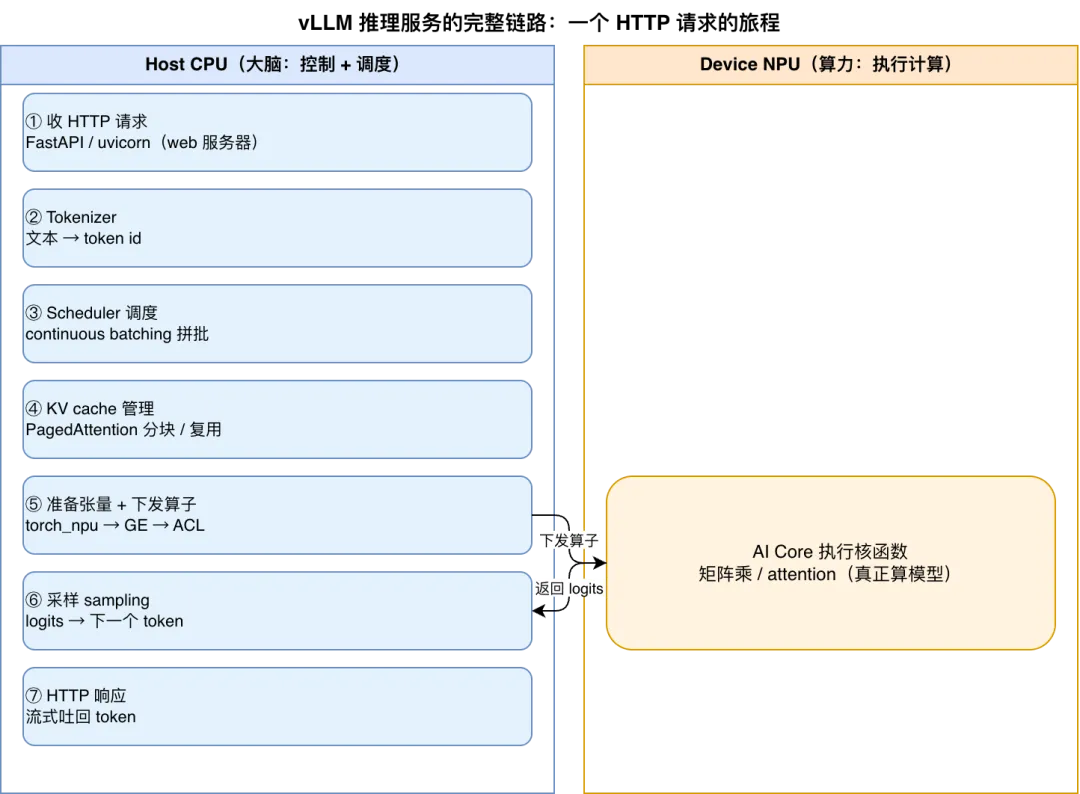
这里的服务,指 vLLM 这层提供的推理服务——在 CPU 上起一个 web 服务器,把模型包装成 HTTP、gRPC 接口,客户端发一个请求,服务端流式吐回 token。关键在于 Host CPU 和 Device NPU 的分工:CPU 是大脑,管流程;NPU 是算力,管计算。
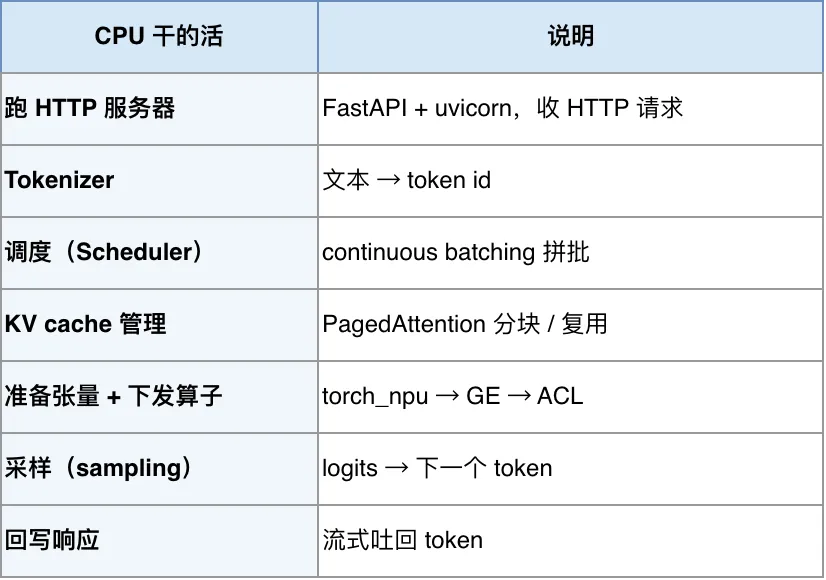
Host CPU 干的活(全是控制类、不重算力):
前置背景:LLM 是怎么吐答案的,也就是自回归。一个请求的完整回答是一串 token,但这串 token 不是一次性算出来的,而是循环 N 次、每次生成 1 个——每次把 prompt 加已生成的 token 作为输入,预测出下一个 token,拼上去再预测下一个,直到出现 EOS 结束标记。原因在于,下一个 token 依赖前面所有 token,要回头算 attention,所以只能一个一个来,这就是自回归。
补充一下,continuous batching,也就是连续批处理,在做什么。LLM 是自回归的,每个请求生成的 token 数不一样,有的 10 个就结束,有的 1000 个。传统 static batching 是凑满一批、一起算、整批结束、换下一批,导致早结束的请求要等慢请求,GPU 空转。continuous batching 把调度粒度细化到每生成一个 token 的每一轮:有请求生成 EOS 就立刻踢出 batch、腾位给新请求,有新请求立刻塞进当前 batch。效果是 GPU 几乎没有空窗,高并发下吞吐提升好几倍,类比就是公交车等满才发、地铁随时上下。这也是 vLLM 能成为生产默认推理引擎的核心原因之一。
软件栈,从上到下:FastAPI、uvicorn 做 HTTP 服务器,vLLM 做调度和 KV cache,PyTorch 加 torch_npu 做算子分发,CANN 的 GE 和 ACL 做图优化和任务下发,再往下是 NPU 驱动,最后是 NPU 硬件。
协议:对外是标准 HTTP,用的是 OpenAI 兼容 API,比如 POST /v1/chat/completions,也支持 gRPC;Host 和 Device 之间走 PCIe 加 ACL Runtime API,不是 HTTP。
⑤ Host 和 Device 的交互分工
Host(CPU):控制流、图编译、Tiling 参数计算、内存分配、任务下发。擅长复杂逻辑,不擅长高并行计算。
Device(NPU):核函数执行(AI Core 达芬奇)、数据搬运。擅长高并行计算。
交互:Host 下发一个算子后不等结果、继续调度下一个,Device 同时执行已下发的任务——两者异步并行,Host 下发的开销和 Device 执行的时间重叠。
最核心的一点:CUDA 世界里,图编译是可选的优化;昇腾世界里,图模式是架构主场。这是理解昇腾这类 NPU 编程模型最关键的区别。
三、框架:把代码变成图
先厘清两个阶段。本章讲的代码变成图,是训练、开发阶段的事,你写 Python 代码,比如 nn.Linear 那套,框架把它转成图。而模型文件,比如 .onnx、.om 这些二进制,是部署阶段的产物,训练完导出、再编译生成。到部署时,代码和框架都不在了,只剩编译好的模型文件。两者是先后两步,别混淆。
框架这一层的核心职责只有一个:把用户的 Python 代码变成计算图,也就是图 IR。这个职责训练和推理共用,训练时用图做反向传播,推理时用图做前向。所以框架不是训练专用,而是训练和推理的公共基础,图编译的一切优化,前提都是框架先把图交出来。
3.1 框架的职责:把代码变成图
定义模型:用 Python 描述网络结构,比如层、激活、连接。
自动求导:反向传播自动算梯度,不用手写。
训练:优化器更新权重、分布式训练、混合精度等。
产出图:把模型转成计算图,交给下游图编译。
3.2 两种编程范式:define-and-run vs define-by-run
这是理解所有框架差异的总纲:
define-and-run,也就是先定义、后执行的静态图:先把整张图构建出来,再喂数据执行,执行前就能看到全局、做图级优化,代表是 TensorFlow 1.x。
define-by-run,也就是边定义、边执行的动态图:代码执行到哪算到哪,灵活好调试,但看不到整张图,图优化无从下手,代表是 PyTorch 的 eager。
一句话:静态图 = 图优先(好优化),动态图 = 体验优先(好写)。整个框架演进史,就是这两者互相靠拢的历史。
3.3 三大框架对比
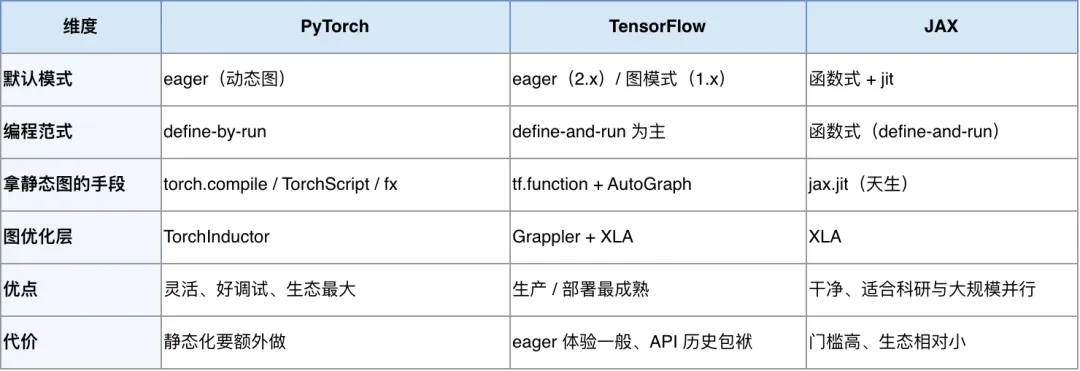
3.4 JAX 详解:函数式版的「PyTorch」
JAX 是 Google 开发的开源高性能数值计算库,2018 年发布。一句话定位:带 XLA 编译器、能自动求导、编译、向量化的 NumPy。它的 API 和 NumPy 几乎一样,也就是 jax.numpy,底层通过 XLA 编译器自动跑到 CPU、GPU、TPU。
最根本的区别在于函数式编程。PyTorch 是面向对象的,权重封装在 nn.Module 里;JAX 是纯函数式的,模型不持有任何状态,参数必须从外面显式传入。
# PyTorch:参数在模型内部out = model(x)# JAX:参数显式传入,模型是纯函数out = model_fn(params, x)
核心能力:四个函数变换——jax.grad(自动求导,还能求高阶导)、jax.jit(即时编译,天生静态图)、jax.vmap(自动向量化)、jax.pmap(多设备并行)。这些变换可以自由组合,如 jit(grad(vmap(f)))。
几个反直觉的细节:随机数要显式传 key,也就是 jax.random.PRNGKey,结果完全可复现;没有 zero_grad、backward、step 这套东西,参数更新是一次组合函数调用;天生就是静态图,没有 eager 和 graph 的切换。
谁在用:DeepMind 的 Gemini、Anthropic 的 Claude 是两大主力,Google 内部大量使用。JAX 配 Google TPU 是最强组合,XLA 最初就是为 TPU 设计的。
选型建议:快速研究迭代、灵活调试、生态最全,就用 PyTorch;用 TPU、要自定义梯度和高阶导、超大规模多设备训练、追求可复现,就用 JAX。一句话,JAX 是函数式版的 PyTorch,门槛高、调试难,但在 TPU、大规模分布式、高阶微分这些前沿场景更强,是研究圈增长最快的框架。
3.5 推理时框架做了什么:从 Python 代码到图 IR
先厘清:代码是结构,权重是数据。PyTorch 模型由两部分组成,代码只定义网络结构,比如 nn.Linear(10, 20) 表示这一层是全连接、输入 10 维输出 20 维;权重是训练出来的具体数值,单独存在 .pth 文件里。推理时,先跑代码把结构搭起来,权重先随机占位,再 load_state_dict 把训练好的权重填进去。所以代码表示网络和权重固定不矛盾,它们是结构和数据两个东西,靠 load_state_dict 组装。
框架在推理时最核心的一件事,是把「用户的 Python 代码」转成「图 IR」。用一个具体例子看全过程:
① 用户的 Python 代码(你写的模型 + 前向):
import torchdef my_model(x, w1, b1, w2, b2):x = torch.matmul(x, w1) + b1 # 线性层 1x = torch.relu(x) # ReLU 激活x = torch.matmul(x, w2) + b2 # 线性层 2return x
② 用什么转换成图 IR:
不是 MLIR,而是 PyTorch 自己的图表示,常用三种——torch.fx 符号化 trace、TorchScript、TorchDynamo(torch.compile 捕获字节码)。它们的输入是「Python 函数 / 模型」,输出是「图 IR」。
③ 图 IR 长什么样(用 torch.fx 符号化 trace 后打印 graph):
graph():%x : placeholder(target='x')%w1 : placeholder(target='w1')%b1 : placeholder(target='b1')%mm1 : call_function(target=torch.matmul, args=(%x, %w1))%add1 : call_function(target=torch.add, args=(%mm1, %b1))%relu : call_function(target=torch.relu, args=(%add1,))%mm2 : call_function(target=torch.matmul, args=(%relu, %w2))%add2 : call_function(target=torch.add, args=(%mm2, %b2))return %add2
④ 这张图 IR 是什么:
节点 = 算子(matmul / add / relu),边 = 张量(%x → %mm1 → %add1 → %relu → ...)。它就是一个「数据流图(DAG)」——把原来「一行行 Python 代码」变成「算子之间的依赖关系」。图编译层(第四章)就是在这张图上做融合、改写、内存规划。
输入输出总结:输入是用户的 Python 模型代码,也就是 nn.Module 或函数;输出是图 IR,节点是算子、边是张量。这个转换由 torch.fx、TorchScript、TorchDynamo 完成。MLIR 是 LLVM 生态的另一套 IR,PyTorch 默认不走它,只有 torch-mlir 这类进阶项目才会把 PyTorch 图转成 MLIR。
其他框架怎么生成图:
TensorFlow:用 tf.function 装饰器 + AutoGraph——AutoGraph 会把 Python 函数里的 if / for 控制流自动转成图的表示;1.x 时代更是天生静态图(先建图再执行)。
JAX:天生就是图——函数式编程 + jax.jit,代码即图,交给 XLA 编译,没有 PyTorch 那种「先 eager 再捕获」的转换步骤。
静态图和动态图的区别,详见 3.2。这里只需记住一个衔接:PyTorch 默认是动态图,也就是 eager,所以要拿静态图,才用 torch.compile 去捕获,这正是本节讲的内容。
推理时 .om 文件怎么变成图、怎么运行:.om 是昇腾 ATC 工具编译出的离线模型,里面已经包含了优化后的计算图、每个算子的二进制 kernel、权重,不是纯二进制待重新解析。
整条链路:训练时 Python 代码变成图,导出 ONNX,ATC 做图优化和算子编译,生成 .om 文件;部署时 aclmdlLoadFromFile 加载,aclmdlExecute 按图逐算子下发 kernel 到 NPU 执行。
关键:图在 ATC 编译阶段就已经定好了,推理时不是重新变图,而是加载图、执行 kernel。所以 .om 文件里,图结构和 kernel 二进制都已经是编译好的产物。
四、图编译器:把图优化好
图编译是框架之下的一层,处理计算图级别的优化。它决定该有哪些算子,把整张图组织得高效。
4.1 计算图基础
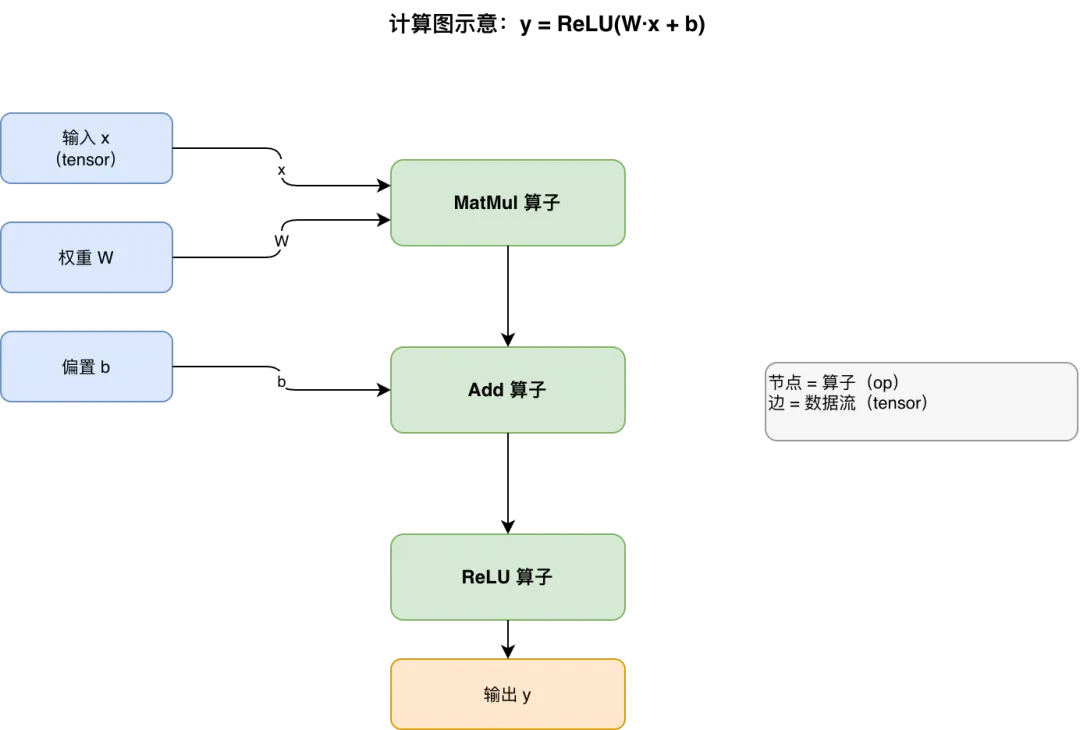
如上图所示,计算图把模型表达成一张图,节点是算子,边是数据流,也就是 tensor。比如 y = ReLU(W·x + b) 是一条链:x 到 MatMul,再到 Add 加 bias,再到 ReLU,最后到 y。
图编译的前提是「静态化」——把动态图转静态图(静态图 / 动态图的区别见 3.2),才能拿到整张图做优化。
4.2 图编译的核心优化
图编译的优化里,算子融合最重要、收益最大,其他几个都是辅助,包括图改写、内存优化、常量折叠、死代码消除。原因是 AI 推理的瓶颈在内存带宽,不在算力,所以一切优化都围绕减少中间结果的读写。
算子融合,是最重要的优化,把多个算子合并成一个,中间结果留在片上,不写回内存。最经典的例子,MatMul、Bias、ReLU 三个算子。
融合前:x → MatMul → 写回内存 → Add(bias) → 写回内存 → ReLU → 写回内存 → y(中间结果要读写 3 次,全是显存带宽的浪费)融合后:x → FusedMatMulBiasReLU → y(三个算子合成一个 kernel,中间结果留在寄存器 / 片上,一次算完)
怎么识别「可以融合」:在图里做模式匹配,找「Conv+BN+ReLU」「MatMul+Bias+激活」这类常见序列;同时满足两个条件——第一个算子的输出只被第二个用(单消费者)、中间结果能留在片上。最容易融合的是逐元素算子(ReLU / BN / Add),因为它们点对点操作、不改数据布局。
价值:一个融合省 1 到 2 次显存读写,多个融合累积下来,推理能提升 20% 到 50%,这是所有图优化里最划算的一笔。NVIDIA 的 TensorRT、TorchInductor,昇腾的 GE,都把它作为核心 pass。
其他几个优化(辅助):
图改写,也就是 Graph Pass:模式匹配后做等价替换,比如 x 乘 1 换成 x,把图改写成更容易融合、执行的形式,为融合铺路。
内存优化:分析 tensor 的存活区间,不重叠的就复用同一块内存,省显存、不省时间,让更大模型能跑。
常量折叠、死代码消除:编译期算掉常量,删掉没有输出的算子,小收益但免费。
4.3 图捕获 / 静态化(怎么拿到静态图)
这是图编译最工程化的一环——不同框架有不同的「把动态图转静态图」手段:
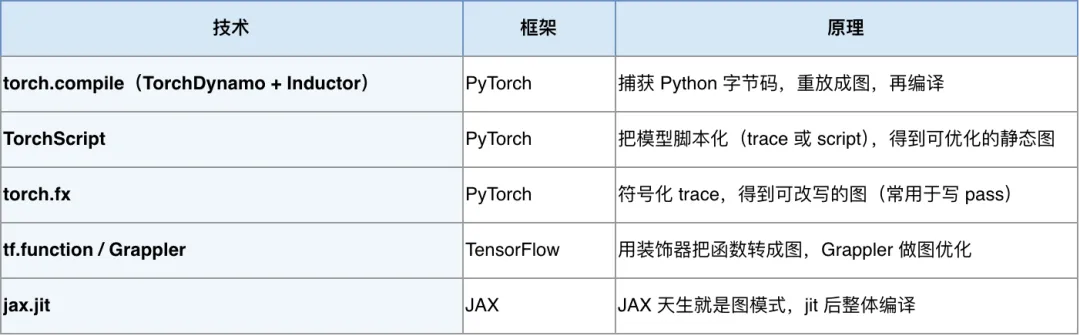
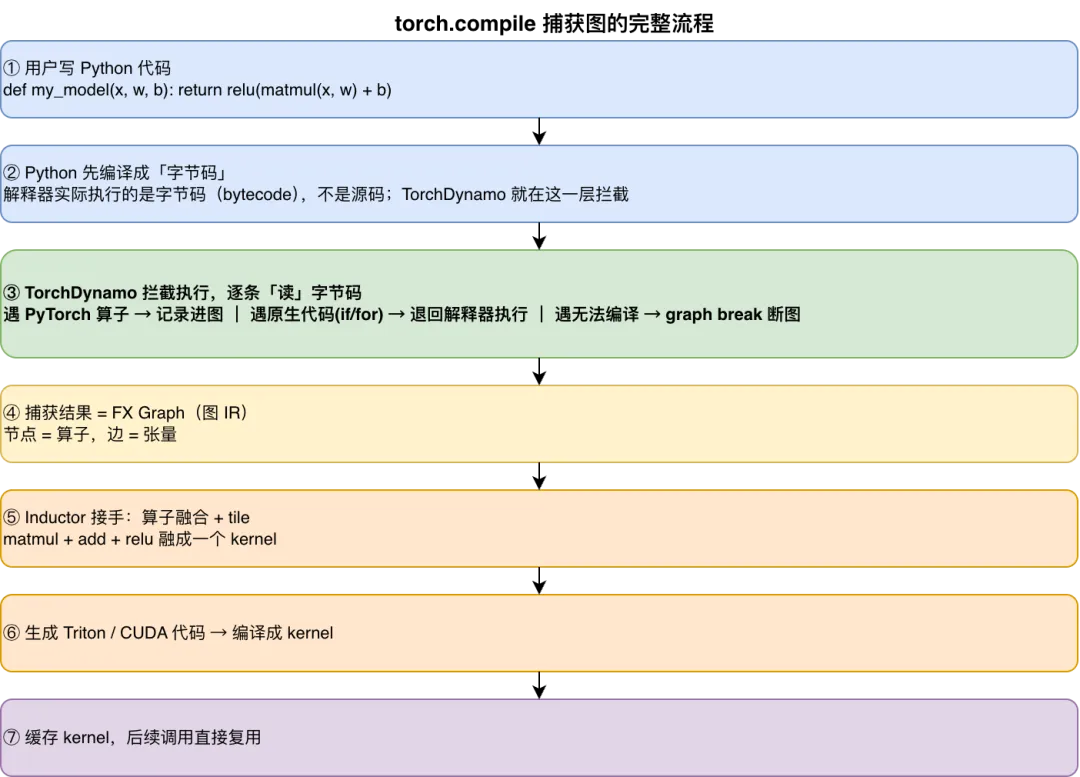
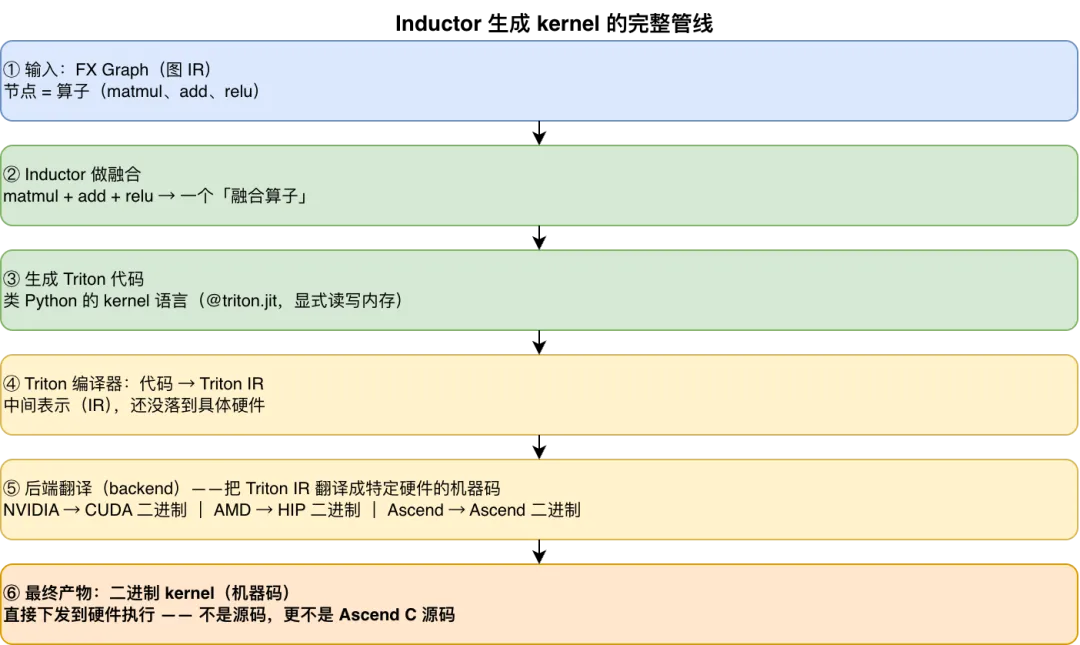
跟着流程图走一遍。torch.compile 是 PyTorch 2.0 的编译入口,核心是两段式:TorchDynamo 捕获图,Inductor 生成 kernel。
①② 字节码是什么:Python 代码执行前,会先被编译成字节码,这是一种中间指令。解释器真正执行的是字节码,不是源码。TorchDynamo 就在字节码这一层拦截。
③ 字节码重放和 graph break:TorchDynamo 逐条读字节码,判断每条是不是 PyTorch 算子。是,就记录进图;不是,比如 if、for、普通计算,就退回解释器执行。遇到无法静态分析的代码,比如数据相关的 if、未知函数调用,就断图,也就是 graph break,这段当普通 Python 跑,之后重新捕获下一段。所以一个函数可能切成图 1、原生代码、图 2,多段。
④ 输出 FX Graph(torch.fx 的图表示,节点 = 算子、边 = 张量):
graph():%x : placeholder(target='x')%mm1 : call_function(target=torch.matmul, args=(%x, %w1))%add1 : call_function(target=torch.add, args=(%mm1, %b1))%relu : call_function(target=torch.relu, args=(%add1,))return %relu
⑤⑥⑦ Inductor 生成 kernel:Inductor 拿到 FX Graph,做算子融合(matmul+add+relu 融成一个 kernel)、tile 分块,生成「中间语言」(默认 Triton)——Triton 有 NVIDIA / AMD / Ascend 多个后端,同一份 Triton 代码在 NVIDIA 上编译成 CUDA kernel、在昇腾上编译成 Ascend kernel,编译后缓存复用。Ascend 上还有几种模式可切:默认 Triton-Ascend(生成 triton_poi_fused_xxx 融合 kernel)、npu_backend='mlir'(Torch-MLIR / AKG)、npu_backend='ascendc'(Ascend C kernel);融合不了的单算子则回退到 CANN 的 ACLNN 算子。
Triton 代码长什么样(Inductor 融合后生成的,示意):
@triton.jitdef fused_mul_add_relu(x_ptr, w_ptr, b_ptr, out_ptr, N, BLOCK: tl.constexpr):pid = tl.program_id(0) # 当前线程块 idoffs = pid * BLOCK + tl.arange(0, BLOCK) # 这块负责哪些元素mask = offs < Nx = tl.load(x_ptr + offs, mask=mask) # 从内存加载(显式)w = tl.load(w_ptr + offs, mask=mask)b = tl.load(b_ptr + offs, mask=mask)out = x * w + b # 计算out = tl.maximum(out, 0) # relutl.store(out_ptr + offs, out, mask=mask) # 写回内存(显式)
这段 Triton 代码在说什么:它不像普通 Python「一行算一个数」,而是描述「一个线程块(block)并行地处理一块数据」——tl.program_id(0) 拿块 id、tl.arange 算出这块负责哪些下标、tl.load / tl.store 显式读写内存。这就是 kernel 语言:描述「硬件上怎么并行算」。
后端是干什么的:Triton 代码不能直接跑,要先被 Triton 编译器翻译。Triton 编译器分两段,先把 Triton 代码编译成 Triton IR,这是和硬件无关的中间表示;再由后端把 Triton IR 翻译成特定硬件的机器码。NVIDIA 后端翻译成 CUDA 二进制,AMD 后端翻译成 HIP 二进制,Ascend 后端翻译成 Ascend 二进制。
最终 kernel 是二进制的,不是源码。整个链路的产物是二进制机器码,直接下发到硬件执行,不是 Triton 源码,更不是 Ascend C 源码。Ascend C 是另一条完全不同的路,开发者手写 Ascend C 源码,由 CANN 的 Ascend C 编译器编译成二进制。torch.compile 默认不走它,走的是 Triton 到 Ascend 后端到二进制。
补充介绍一下Triton 之前的 kernel 语言。Triton 准确说是 kernel DSL,也就是写 kernel 的高级语言,不是中间表示 IR。在 Triton 之前,生成 kernel 有三类:底层手写语言,比如 CUDA C++、OpenCL、HIP、Ascend C,性能最高但门槛最高,要手动管线程 id、共享内存、tile;张量 DSL,比如 Halide、TVM,用算法和调度分离来自动生成代码;Polyhedral 编译,比如 PPCG、Pluto,用多面体模型自动优化循环。其中最关键的转折是 Halide,MIT 2012 年提出算法和调度分离的思想,先用纯函数写算什么,再用 schedule 原语描述怎么算得快,编译器据此自动生成代码,这个思想直接启发了 TVM。Triton 的定位是卡中间,比 CUDA C++ 高层,不用手动管线程和共享内存,比 Halide、TVM 直观,用类 Python 直接写 kernel,所以成了 Inductor 的默认选择。
为什么用字节码重放,而不是 trace 或 script:trace 是跑一遍记录,遇 if 控制流会漏掉没走到的分支;script 是解析 AST,对 Python 动态特性支持差;字节码重放靠 graph break 兜底,最通用。整个链路涉及的 IR 是:TorchDynamo 捕获,FX Graph 是 PyTorch 自己的图 IR,不是 MLIR,Inductor 生成 kernel,默认用 Triton 这个中间语言,多后端。
五、算子库与算子编译
图编译决定该有哪些算子,接下来是每个算子怎么跑。这一步有两条并列路径:算子库,用现成的 kernel;算子编译,现编译 kernel。
5.1 算子库(Kernel Library)
算子库是预编译好、手工高度优化的 kernel 集合,图编译做「算子选择」时优先调用。分两大阵营: NVIDIA 的 CUDA 算子库:
cuBLAS:BLAS 标准的 GPU 实现,GEMM、GEMV、矩阵分解等基础线性代数,GEMM 是手写到汇编级的极致优化。
cuDNN:深度学习原语库,卷积、池化、RNN、注意力,是训练推理里卷积类算子的主力。
CUTLASS:不是预编译库,而是 C++ 模板库,你用它模板化地写 GEMM,编译期按指定的 tile 大小、数据类型展开成高效 kernel,可高度自定义。
cuSPARSE、cuFFT、NCCL:分别做稀疏矩阵、快速傅里叶变换、多卡集合通信。
华为开源算子库(CANN,2025 年全面开源):
OPP 算子包:1400 多个标准算子,按功能解耦为 ops-math 做数学、ops-nn 做神经网络、ops-cv 做图像、ops-transformer 做大模型融合算子,比如 FlashAttention、MoE。
ACLNN:单算子 C API,用 aclnn 直接执行算子,无需 IR 定义。
ACLOP:基于图 IR 执行算子,也就是 acl_op。
CATLASS:昇腾的算子模板库,对标 CUTLASS。
torch_npu、op_plugin:PyTorch 在昇腾上的适配层,底层调用 ACLNN、ACLOP。
关键理解:算子库里的算子分两类。预编译的,比如 cuBLAS、cuDNN、OPP,直接调用;模板的,比如 CUTLASS、CATLASS,按需实例化、编译期展开。图编译优先查库,库没有的才走算子编译。
5.2 算子编译(Operator Compiler)
算子编译,把单个算子现编译成硬件代码,可以用 Triton、Ascend C、CUDA C++。核心是一套分块、循环变换、指令选择的流程。详细介绍可以看我的上一篇公众号文章。以 GEMM 为例,看伪代码。
# 原始 GEMM:三层循环,数据反复读写全局内存for i in range(M):for j in range(N):for k in range(K):C[i, j] += A[i, k] * B[k, j]# tile 分块后(算子编译生成的逻辑,数据分块留在片上)for i_block in range(0, M, TILE_M):for j_block in range(0, N, TILE_N):C_tile = zeros(TILE_M, TILE_N) # 输出块放寄存器for k_block in range(0, K, TILE_K):A_tile = load(A[i_block:i_block+TILE_M, k_block:k_block+TILE_K]) # 加载 A 块到共享内存B_tile = load(B[k_block:k_block+TILE_K, j_block:j_block+TILE_N]) # 加载 B 块C_tile += A_tile @ B_tile # 用 Tensor Core 矩阵乘指令store(C[i_block:i_block+TILE_M, j_block:j_block+TILE_N], C_tile) # 写回
这几步在做什么:
tile 分块——把大矩阵切成能放进片上 SRAM 的小块,减少全局内存访问(这是「内存墙」问题的核心解法);
循环变换 + 向量化——重排循环顺序让访存连续、用 SIMD 一次算多个元素;
寄存器分配——把最热的数据(C_tile 累加器)放寄存器;
指令选择——选 Tensor Core / 向量指令做矩阵乘,而不是标量指令。
和算子库的关系:算子库负责成熟、高频的算子,比如 cuBLAS 的 GEMM 已经手写好;算子编译负责长尾、自定义的算子,比如库没有的融合算子。两者互补,这正是图编译先查库、查不到才编译的原因。
六、NVIDIA 与 Ascend 的实现
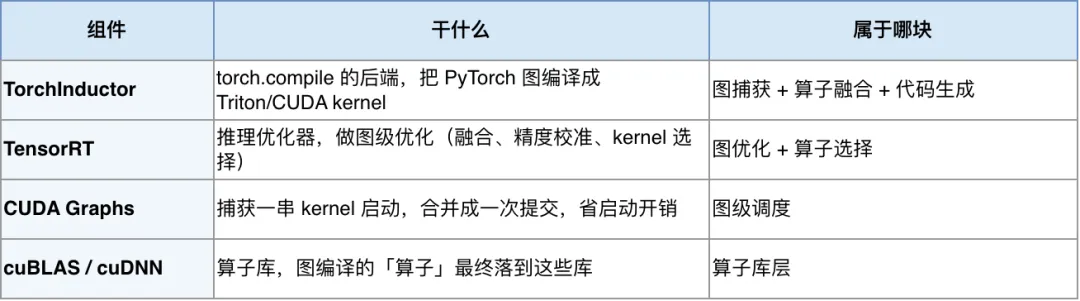
6.1 NVIDIA 的图编译栈
6.2 Ascend 的图编译栈
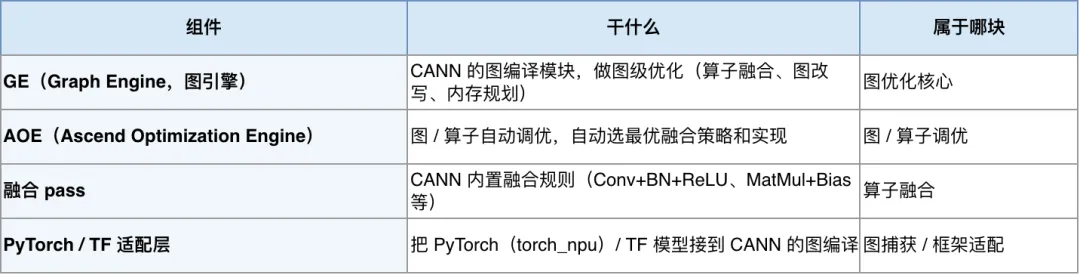
Ascend 图编译流程:模型到适配层转图,GE 做图优化,包括融合、改写、内存规划,各算子经 CCEC,也就是昇腾的算子编译器,编译成二进制,最后运行时执行。
七、Runtime 与驱动:软件怎么和硬件打交道
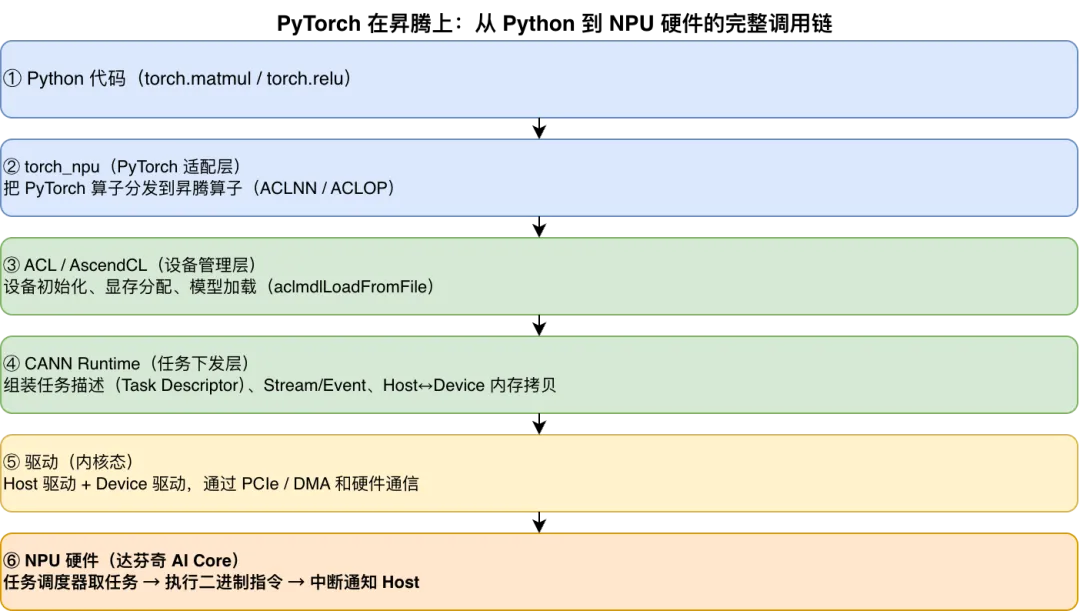
前面讲的是算子怎么编译成 kernel,这一章讲 kernel 怎么真正跑在硬件上。以 PyTorch 在昇腾上为例,看完整的调用链。
Runtime 做了什么:Runtime,也就是 CANN Runtime、AscendCL,是 Host 侧控制 NPU 的 API 层,做四件事,设备管理、内存管理、任务下发、同步机制。用一个完整的推理例子看,这是 ACL 的典型调用。
// 1. 初始化 + 设备管理aclInit(nullptr);aclrtSetDevice(0); // 指定用 0 号 NPUaclrtCreateContext(&ctx, 0);// 2. 加载编译好的离线模型(.om,里面是二进制 kernel)aclmdlLoadFromFile("model.om", &modelId);// 3. 分配输入输出内存(Device 侧 HBM)aclrtMalloc(&input, inputSize, ACL_MEM_MALLOC_HUGE_FIRST);aclrtMalloc(&output, outputSize, ACL_MEM_MALLOC_HUGE_FIRST);// 4. 输入从 Host 拷到 Device(Host↔Device 内存拷贝)aclrtMemcpy(input, inputSize, hostInput, inputSize, ACL_MEMCPY_HOST_TO_DEVICE);// 5. 下发执行(任务提交到硬件队列,立即返回)aclmdlExecute(modelId, input, output);// 6. 结果从 Device 拷回 HostaclrtMemcpy(hostOutput, outputSize, output, outputSize, ACL_MEMCPY_DEVICE_TO_HOST);// 7. 释放(反序)aclmdlUnload(modelId);aclrtDestroyContext(ctx);aclrtResetDevice(0);aclFinalize();
关键理解:aclmdlExecute 这步,Host 只是「把任务提交到硬件的任务队列」然后立即返回(异步);NPU 在 Device 侧自己取任务、执行、完成后再通知 Host。这就是「Host 下发、Device 执行」的异步模型。
驱动做了什么:驱动分两层。Host 驱动在内核态,管设备管理、PCIe 通信、DMA、中断;Device 驱动跑在 NPU 侧,管 AI Core、内存。它是软件和硬件的最后一道边界,Runtime 的 API 最终变成对驱动的系统调用,驱动再通过 PCIe、DMA 和硬件寄存器交互。
算子最后怎么在硬件上执行:一个算子(已编译成二进制 kernel)在硬件上的执行路径:
组装任务描述:Runtime 把要执行哪个 kernel、参数、内存地址,打包成 Task Descriptor。
提交任务队列:Task Descriptor 写入硬件的任务队列,也就是 Task Scheduler。
调度执行:硬件任务调度器取任务,分配到空闲的 AI Core。
执行二进制:AI Core 执行 kernel 的二进制指令,做矩阵乘、向量运算,读写 HBM 内存。
完成通知:执行完触发中断,通知 Host 取结果。
一句话总结:Python 算子到 torch_npu 分发,ACL、Runtime 组装任务并下发,驱动通过 PCIe 把任务送到硬件,硬件调度器分配 AI Core 执行二进制 kernel,最后中断回 Host。软件侧,也就是 Host,只负责准备数据和下发任务;真正的计算在 Device 侧,由硬件异步完成。
八、总结与关键要点
八层全景:应用/模型 → 推理引擎 → 框架 → 图编译 → 算子库/算子编译 → 运行时 → 硬件。
推理引擎是「跑模型」的工具,训练框架是「造模型」的工具——两者职责不同,所以推理需要专门的引擎(KV cache、量化、批处理调度)。
框架决定能不能拿到图:define-and-run vs define-by-run,三大框架各有手段(torch.compile / tf.function / jax.jit)。
图编译是「图粒度」的优化层,在算子编译之上,先图后算子;算子融合是最重要、收益最大的优化。
算子库 vs 算子编译:算子库是现成的手工优化 kernel(cuBLAS/OPP),算子编译是现编译(Triton/Ascend C),互补。
NV 与 Ascend 是两大参考:NV 靠 TorchInductor/TensorRT/CUDA Graphs,Ascend 靠 GE/AOE/融合 pass。
小 H
读书 | 思考 | 写作 | 心情