ARTICLE · 1223293
REA 源码解析 文件组织与分析流程
把一个程序交给 AI,问它某项功能怎样实现,背后需要完成很多具体工作:识别文件格式,连接分析引擎,定位函数,追踪引用,整理结果,再说明哪些结论有依据、哪些仍然未知。
REA 把这些工作组织成一套本地分析工具。它同时提供终端命令和 MCP 接口,底层接入原生反编译引擎、JavaScript 分析器、浏览器观测和多种格式解码器。理解这个项目,需要同时看它怎样获得事实、怎样组合答案,以及怎样管理分析过程中产生的资源。
本文先解释文件怎样组织、各目录有多少文件,再沿调用路径展开,面向第一次阅读 REA 的开发者。分析固定在 2026 年 10 月 18 日的提交 23f984b1a884baefc3c44e4ab697f6eff61dffb6,其中 package.json 的版本是 6.7.0;以下结论对应这一份源码,不代表后续版本或 npm 当前发布状态。
一 REA 接受的输入远不止原生可执行文件
先从使用者的问题看 REA,会比直接打开某个引擎目录更容易理解。
面对原生程序,问题可能是“这个字符串在哪里被使用”“这个函数的调用者是谁”。面对 Electron 应用,问题可能是“页面上的按钮经过哪个 IPC 通道调用主进程”。面对一个网站,问题又可能是“这次点击实际发了什么请求,相关脚本从哪里加载”。
这些问题的输入、观察方法和证明范围都不同。REA 用不同的适配器获取事实,再通过共享工作流向调用者返回结果。
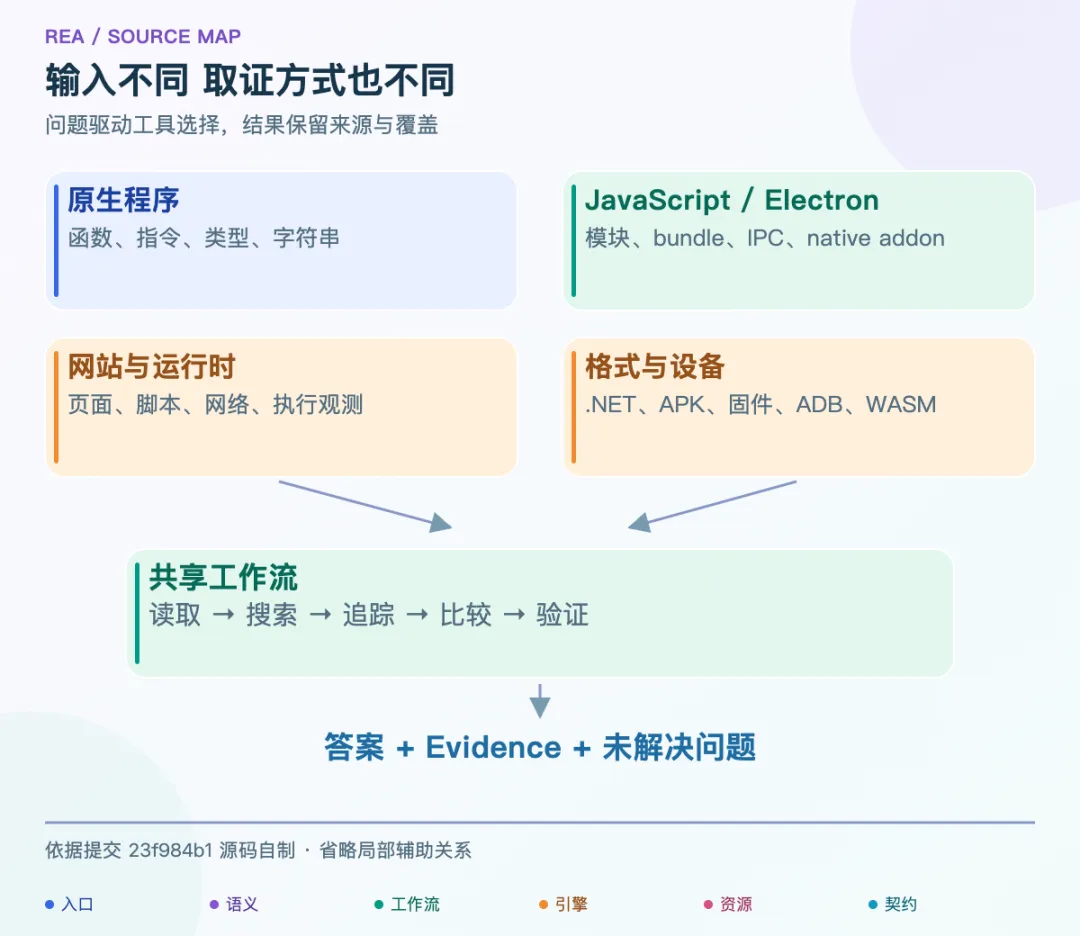
图 1:输入可以是静态工件,也可以是明确选定的运行目标。工作流把获取事实、追踪关系、比较和记录证据连接起来。依据固定版本源码自制。
在这个提交中,TOOL_CONTRACTS 导出了 207 个工具契约。契约可以理解为一份接口说明:工具叫什么、接受什么输入、返回什么结构、可能产生什么效果。
207 不是当前机器能运行的工具数量,也不是 CLI 命令数量。某个工具是否可用,还取决于操作系统、外部程序、目标格式和会话状态。源码中存在定义,与某台机器上满足执行条件,是两件事。
从功能上看,可以先把这些工具分为五组:读取和解码,搜索和定位,追踪关系,运行时观测,以及比较与验证。配套的 tool-index.md 按源码导出顺序列出了全部工具、契约描述和定义位置。
二 仓库根目录先把运行代码 验证材料和产品文档分开
先看文件组织,可以避免一开始就陷入某个引擎的实现细节。这个提交包含 4,347 个 Git 跟踪文件,另有 5 个子模块引用;这里没有把子模块内部文件、node_modules/、dist/ 和本地生成物算进来。
按扩展名看,.ts 文件有 3,232 个,.mjs 有 419 个,Markdown 有 190 个。其余还包括 63 个 Python 文件、21 个 Java 文件、19 个 Swift 文件,以及 C/C++、配置、样例和翻译资源;这是仓库文件类型分布,不是各语言生产代码量的比较。
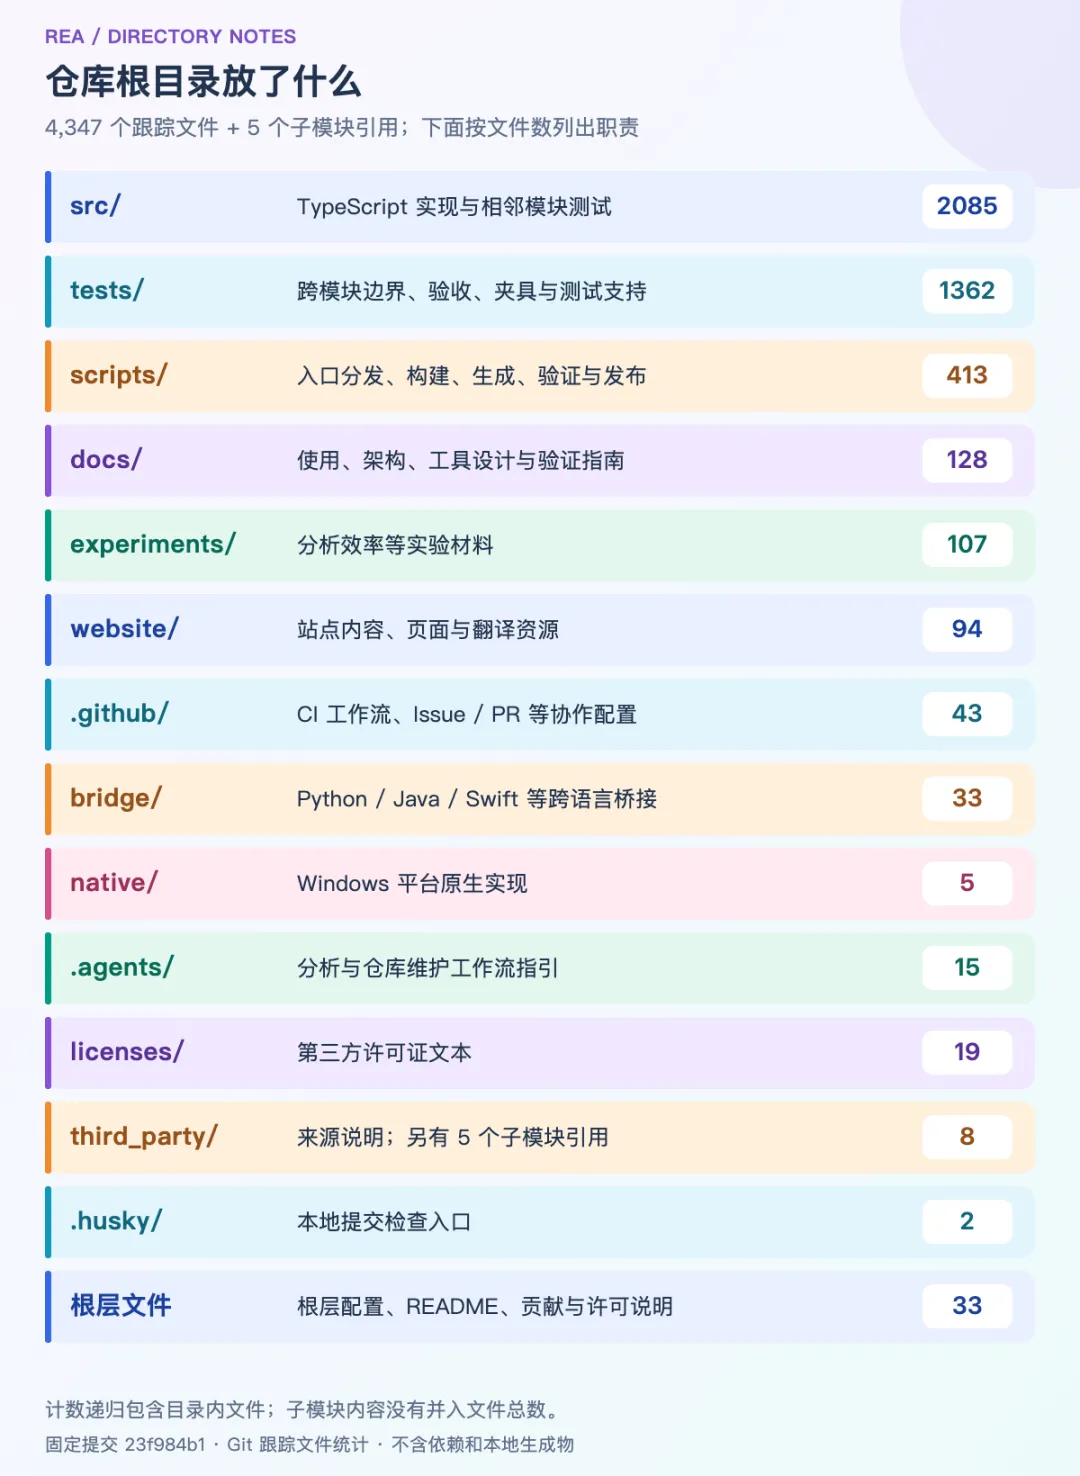
图 2:数量按固定提交的 Git 文件树计算,递归包含各目录的文件。
third_party/的 8 个文件与 5 个子模块引用分开统计。数据见directory-stats.json。
src/ 有 2,085 个文件,全部是 TypeScript,承担运行时的主要实现。这里既放生产代码,也放相邻的模块测试;不能把这个总数直接当作业务实现文件数。
tests/ 有 1,362 个文件,放跨模块测试、公共入口验收、测试夹具和辅助代码。它与 src/ 中的测试并存:前者按跨模块边界组织,后者适合紧贴具体规则与解析器。
scripts/ 有 413 个文件,负责可执行入口、构建、生成、验证和发布。rea.mjs 是用户命令的分发器;generate-*、verify-*、scripts/ci/ 分别处理生成材料、验证与 CI 支持。脚本目录也是开发工具链的一部分。
bridge/ 有 33 个文件,放跨语言或引擎侧的桥接代码。Hopper 的 Python bridge、Ghidra 的 Java bridge、原生 UI 和进程身份相关的 Swift 助手,都是在这里连接宿主能力与 TypeScript 实现。
native/ 有 5 个文件,主要对应 Windows 原生边界。它和 src/native/ 需要分开理解:前者是仓库中的平台原生实现,后者有 69 个 TypeScript 文件,处理原生工件、Apple 元数据、系统工具和离线分析等适配。
docs/ 有 128 个文件,提供使用、安装、设计和验证说明;website/ 有 94 个文件,承担站点内容与相关资源。experiments/ 有 107 个文件,用于分析效率等实验;实验材料不能直接当作所有产品路径的性能结论。
.github/ 有 43 个文件,其中包括 30 个 workflow;.agents/ 有 15 个文件,包含仓库维护和分析工作流指引。licenses/ 有 19 个文件,third_party/ 有 8 个跟踪文件,另外用 5 个子模块引用固定部分上游来源;.husky/ 有 2 个文件,连接本地提交检查。
根目录直接放置的文件有 33 个。新人优先看 README.md、AGENTS.md、CONTRIBUTING.md、package.json、tsconfig.json 和 turbo.json:它们分别说明产品范围、协作约束、贡献规则、命令依赖、类型检查与任务组织。
三 src 的 44 个目录按语义 用例和具体能力展开
src/ 的 2,085 个文件,可以分成 1,506 个生产口径文件、555 个 *.test.ts 文件和 24 个文件名含 .fixture. 的夹具文件。生产口径文件共 332,203 个物理行,包含空行和注释。
这里的“生产口径”是一个明确的统计筛选规则:排除上述测试和夹具命名,不代表剩余文件全部都是业务算法。src/ 根层还有 27 个文件,其他文件分布在 44 个模块目录中。
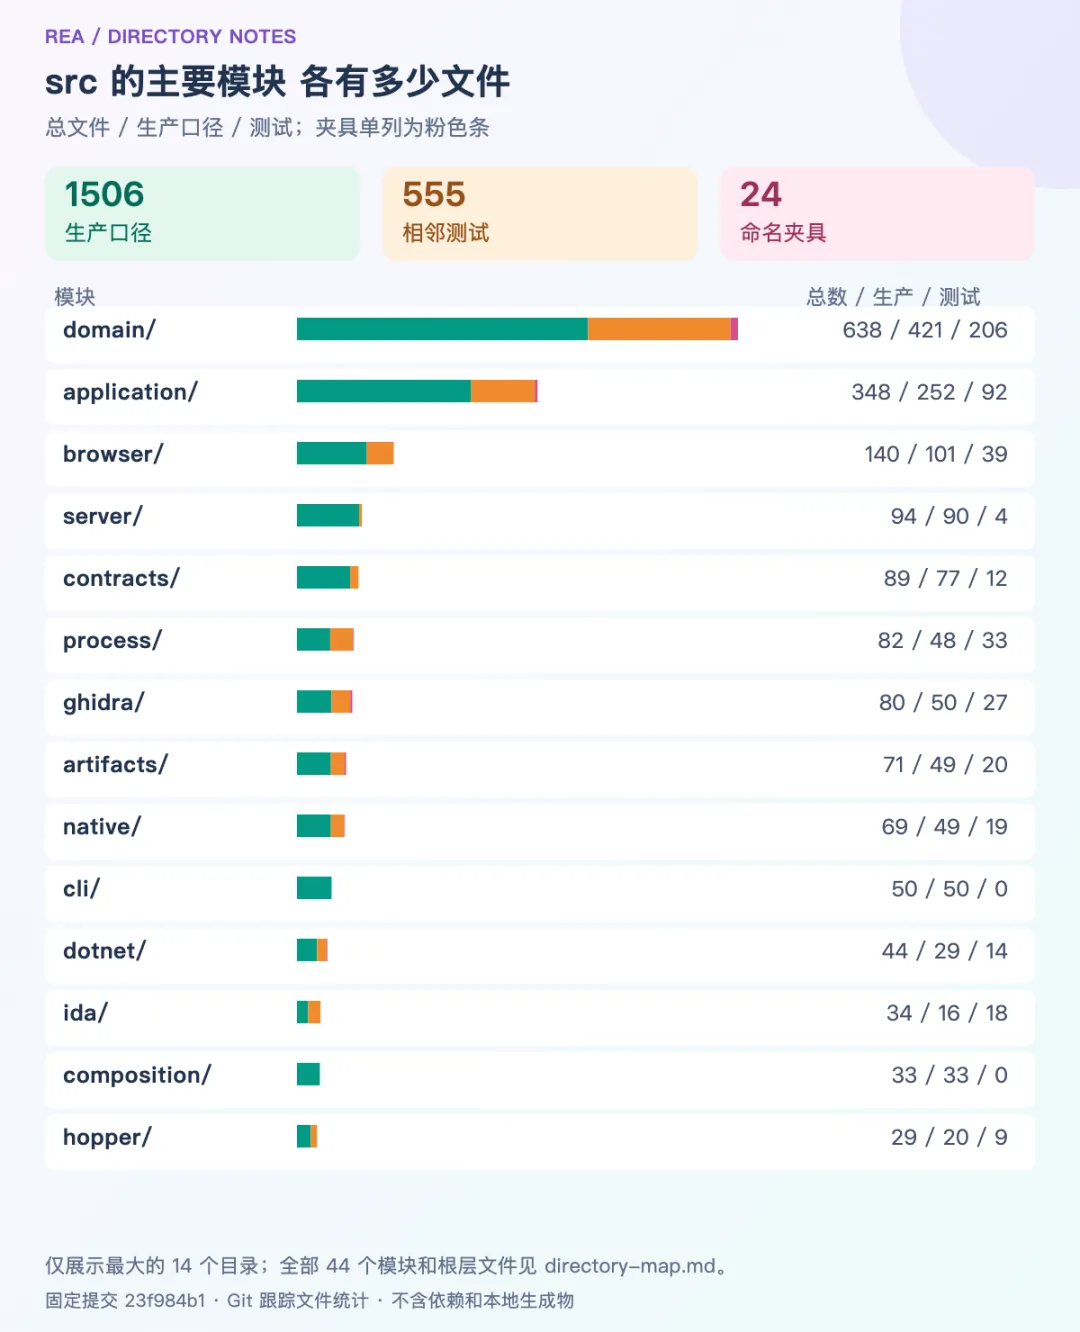
图 3:展示文件数最多的 14 个模块,数字依次列出总文件、生产口径和测试文件。彩色条分别表示生产、测试和夹具;完整 44 目录清单在
directory-map.md。
语义与用例。domain/ 有 638 个文件,其中 421 个为生产口径;application/ 有 348 个,其中 252 个为生产口径。它们分别回答“事实和规则怎样表达”与“一次分析怎样组织”。
公开接口与运行入口。contracts/ 有 89 个文件,其中生产口径 77 个,定义工具输入输出、效果与示例。server/ 有 94 个,承担 MCP 注册与交付;cli/ 有 50 个,组织终端命令;main/ 有 6 个,拆分 MCP 启动、传输和关闭;composition/ 有 33 个,创建具体服务与 provider。
原生深度分析。ghidra/ 有 80 个文件,ida/ 有 34 个,hopper/ 有 29 个,kuna/ 有 25 个。每个引擎目录内部继续拆分能力、配置、目标支持、客户端、协议与生命周期;文件数不能用来推断哪个引擎支持得更多。
工件与观察。browser/ 有 140 个文件,处理 CDP、Playwright、脚本和场景;artifacts/ 有 71 个,负责读取、清单和提取;src/native/ 有 69 个,处理原生辅助能力;dotnet/ 有 44 个,处理托管静态元数据和指令。
资源与主机边界。process/ 有 82 个文件,生产口径 48 个、测试 33 个、夹具 1 个。providers/ 有 6 个,filesystem/ 有 9 个,windows/ 有 6 个;它们分别承担共享 client 拥有者、文件边界与平台适配等工作。
其余目录按具体能力展开,例如 android/ 13 个、adb/ 14 个、apktool/ 16 个、wasm/ 15 个、evm/ 13 个、firmware/ 11 个。javascript/ 有 25 个文件,主要承接 JS 分析的工作进程、恢复和 source map 等支持;更大的 JavaScript 图模型和应用工作流分别位于 domain/javascript/ 与 application/javascript/。
这个布局中,同一个主题出现在不同层是有意的分工。以 Android 为例,src/android/ 处理具体接入,src/application/android/ 组织用例,src/domain/android/ 表达相应语义,src/contracts/android/ 定义公开接口。阅读时应沿一条用例跨层追踪。
四 大目录按主题分组 关键文件各有职责
最大的两个目录还需要再看一层,否则“领域层”和“应用层”仍然只是抽象标签。
domain/ 下面有 22 个直接子目录,根层另有 252 个文件。根层的 result.ts、analysisErrorBase.ts、evidence.ts、analysisProfile.ts 等,提供跨多种能力共享的表达;其中 result.ts 只定义成功和失败的带类型通道,却被许多工作流使用。
domain/javascript/ 有 229 个文件,其中生产口径 136 个,涉及应用图、语义图、遍历、版本比较与运行时对照。domain/native/ 有 35 个,domain/analysisView/ 有 33 个,domain/apple/ 有 22 个,domain/process/ 有 21 个,分别承接对应主题的规则和结果模型。
application/ 有 28 个直接子目录,根层另有 160 个文件。根层的 DirectAnalysis.ts、EnhancedTools.ts、FunctionAnalysisEvidence.ts、Setup.ts 等,把具体问题组织为可调用工作流。
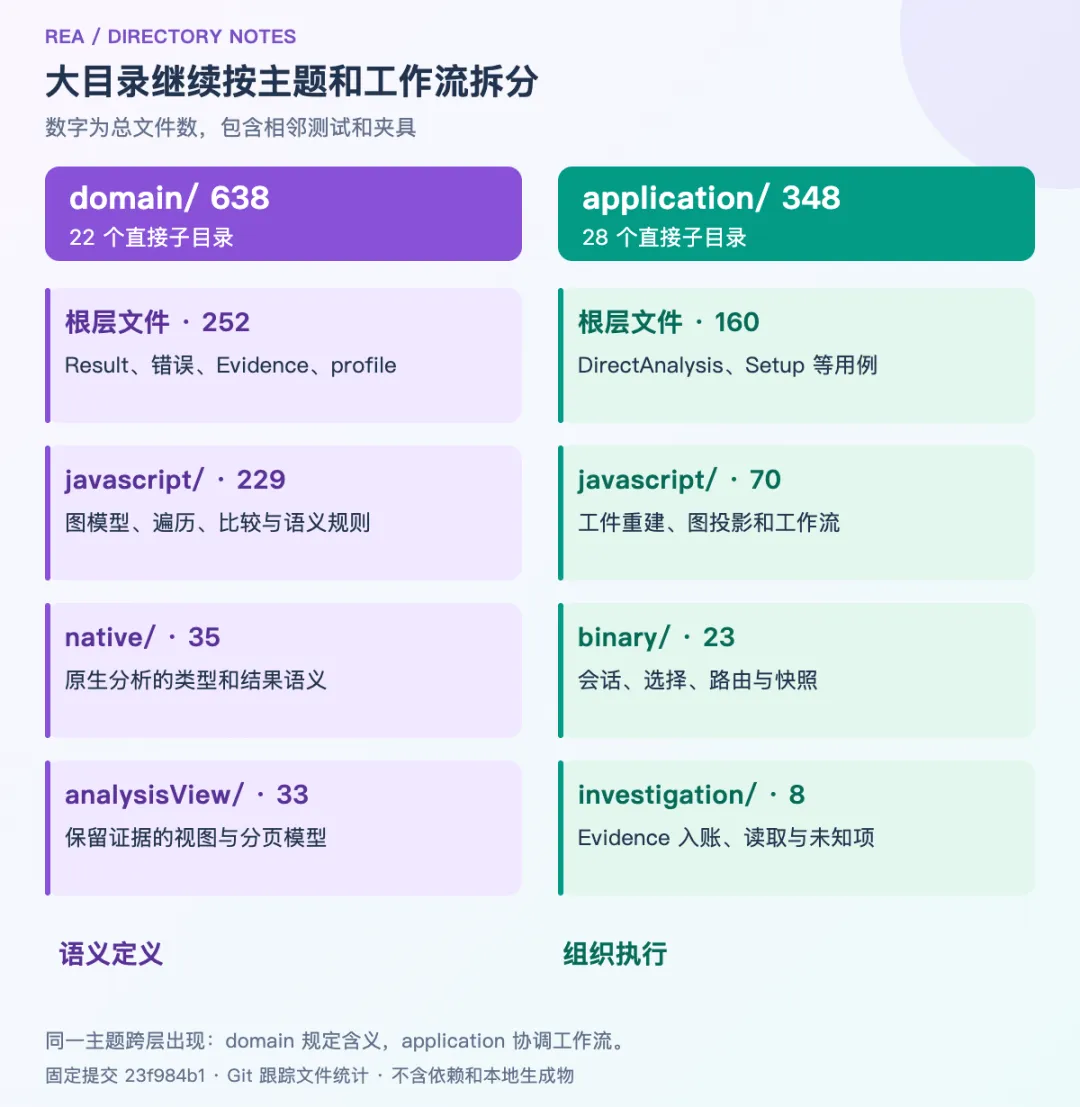
图 4:两个大目录都按主题继续拆分,但一个侧重语义,一个侧重工作流。数量为递归总文件数,包含相邻测试和夹具。依据 Git 文件树与相关源码自制。
application/binary/ 有 23 个文件,其中生产口径 15 个。BinarySession.ts 管当前目标与转换,AnalysisProviderRegistry.ts 管候选选择,SessionProviderRouter.ts 管操作路由,AnalysisSnapshotCache.ts 管可复用结果。会话、选择、路由与缓存分别有清晰入口。
application/investigation/ 有 8 个文件,其中生产口径 5 个。InvestigationRecords.ts 提供调查记录端口,EvidenceLedger.ts 负责记录一致性,UnknownEvidence.ts 处理未知项变更相关证据。
application/javascript/ 有 70 个文件,其中生产口径 55 个。JavaScriptApplicationService.ts 是用例入口,JavaScriptArtifactReconstruction.ts 协调重建,JavaScriptArtifactGraphBuilder.ts 建应用图,JavaScriptSemanticGraphBuilder.ts 组织语义投影;IPC、窗口、资源等边界再由更具体的文件处理。
同样的拆分也出现在外层。server/createServer.ts 组织服务,register*Tools.ts 注册具体工具族,toolResult.ts 负责交付策略;Ghidra 的 GhidraProvider.ts 声明候选与能力,GhidraClient.ts 处理客户端边界,GhidraClientWire.ts 处理传输细节,Java bridge 则放在 bridge/ghidra/。
从这些文件的协作方式看,这套组织有三个具体好处:可以分别定位规则与外部协议;CLI 与 MCP 能调用同一工作流;某种解码结果有明确生产者,下游不必各自重新解释原始文本。这些是对源码职责分工的分析,不是性能测量结论。
代价是完成一项分析需要跨多个文件,文件名也较长。这个版本的 domain/ 和 application/ 根层仍各有 252 与 160 个文件,初读时并不轻松。更稳妥的办法是选定一条实际用例,再顺着调用和数据类型跳转,而不是顺序读完目录。
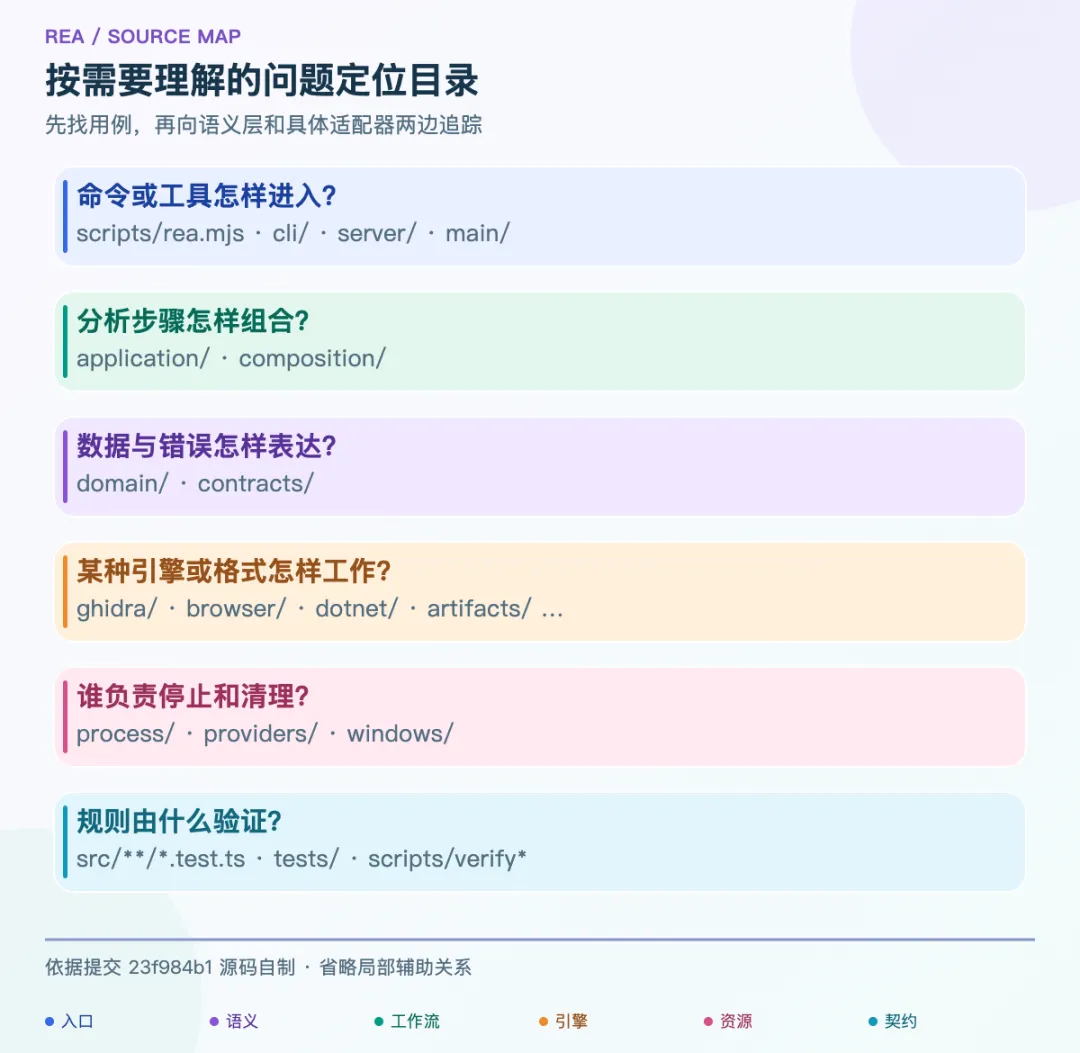
图 5:目录名用于确定职责,具体文件用于追踪当前用例。源码计数和关键文件清单保存在
directory-map.md,便于对照阅读。
五 这些目录通过共享语义和生产装配协作
REA 的核心是几组职责不同的代码。
domain/ 描述分析中的通用规则,例如目标身份、证据结构、图关系、比较语义和错误类型。contracts/ 定义对调用者公开的工具输入与输出。
application/ 负责组织用例:打开目标,选择能力,运行分析,组合结果,保留证据。它通过端口调用具体能力;端口就是对所需操作的类型约定。
具体引擎和格式代码分布在 ghidra/、hopper/、ida/、browser/、artifacts/、dotnet/ 等目录。composition/ 则创建具体实例,把这些实现接到共享工作流上。
最外层是 CLI 和 MCP。它们负责接收请求、传递取消信号、报告进度、交付结果,并管理各自的运行边界。
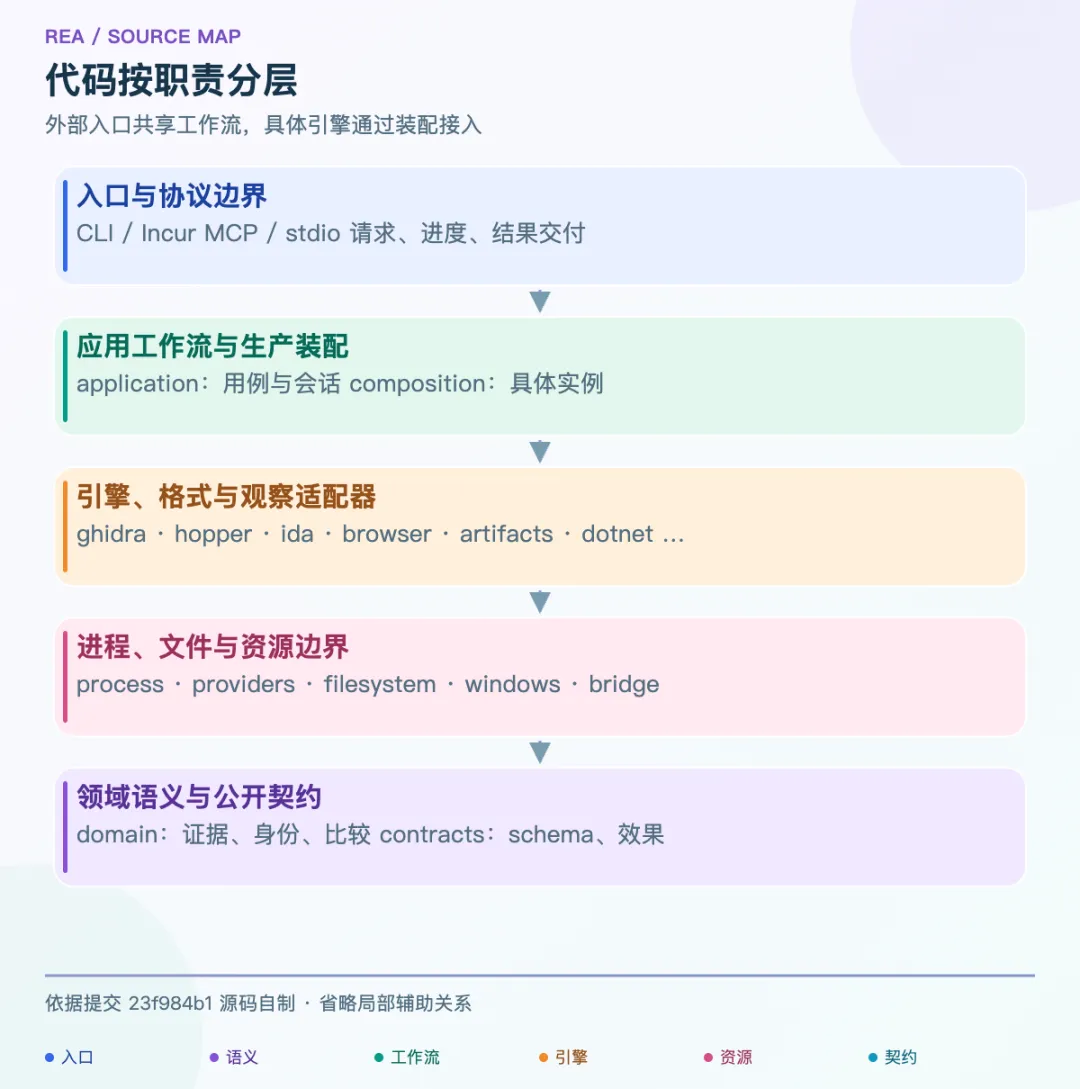
图 6:图中表示主要职责和依赖方向,省略局部辅助引用。公开契约与领域规则由多个外层共同使用。依据
docs/architecture.mermaid和生产装配代码自制。
这种结构让同一种分析可以供两套入口使用。CLI 不需要自己实现一遍 Ghidra 协议,MCP 也不需要重新定义一套证据含义。
实际源码还保留了部分对具体适配器的直接依赖,因此不能把架构图理解为每个目录之间都已经完全隔离。仓库的 verify-module-boundaries 检查对已明确的边界设置了规则,包括纯语义层不能依赖外部适配层、应用层不能反向依赖生产装配层等。
六 CLI 与 MCP 共享工作流 会话寿命却不同
可执行入口是 scripts/rea.mjs。它首先判断这次调用应该进入哪条路径。
当参数恰好是 mcp 或 --mcp 时,入口加载 MCP 运行时。普通命令进入 CLI;mcp doctor 还有单独的诊断分支。分流发生在导入完整命令框架之前,避免让 MCP 启动依赖整套 CLI 初始化。
CLI 的 createCli() 使用 Incur 注册命令。不同命令组调用共享分析服务,普通原生分析命令通过 DirectAnalysis 获得和释放自己的会话。
MCP 则从 main.ts 开始:解析配置,创建 BinarySession,按配置打开初始目标,建立 stdio 传输,再安装关闭处理。stdio 指通过标准输入和标准输出传递协议消息。
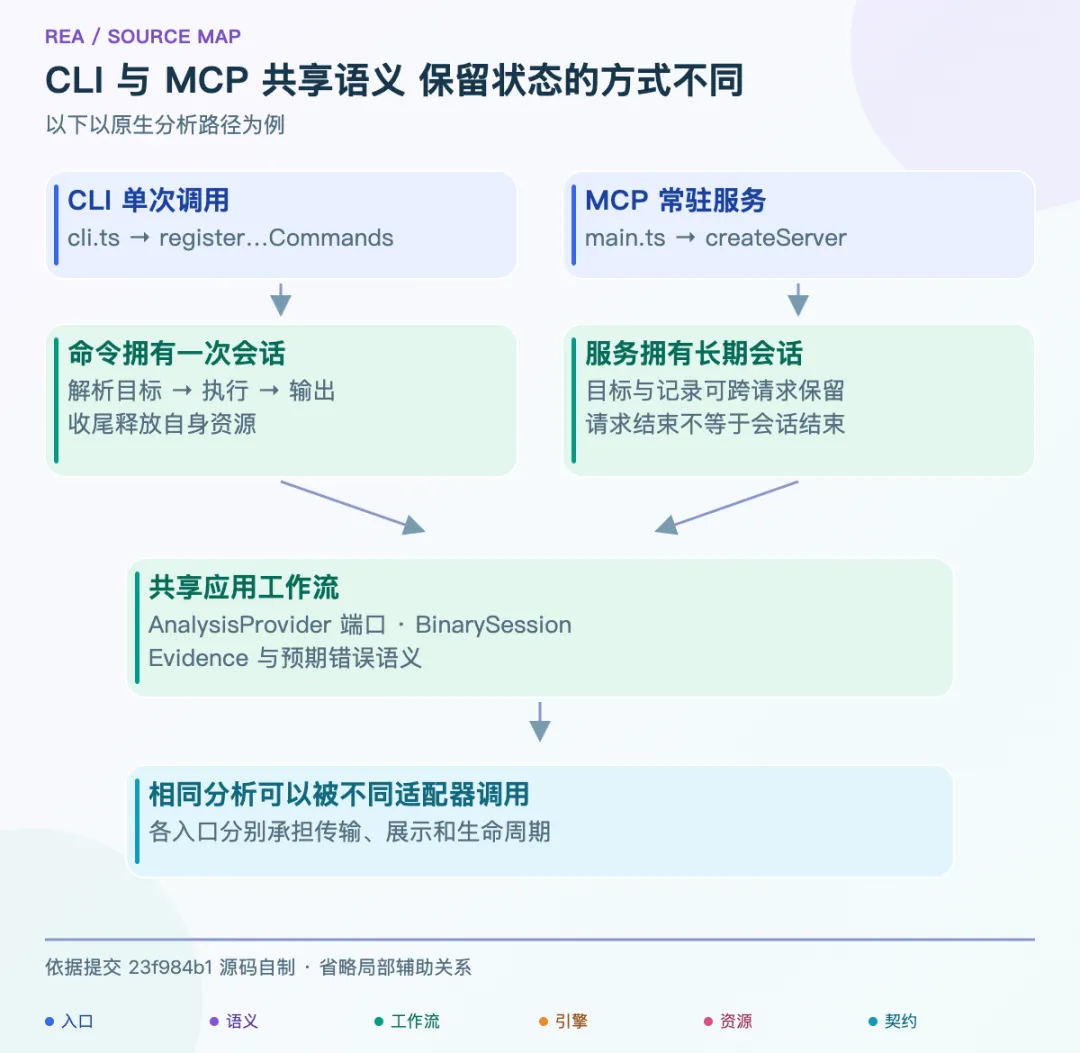
图 7:CLI 原生分析通常在单次命令内打开、执行和清理;MCP 的目标与证据可以跨工具调用保留。两边使用共享应用逻辑。依据入口和会话代码自制。
这一区别影响缓存、目标切换和清理。连续运行两个 CLI 命令,不能假设它们共用上一条命令的引擎连接;MCP 在同一服务会话内,可以继续使用已打开的目标和已记录的证据。
因此,理解一项功能时,需要同时标出“本次请求”的边界和“整个会话”的边界。它们不一定同时结束。[3]
七 跟踪一次函数分析 可以把各层连起来
以这条命令作为阅读入口:rea function ./program main --provider ghidra --json。这是源码中的命令形式示例,不是本文执行过的引擎测试。
src/cli/coreBinaryCommands.ts 注册 function 命令,把位置参数或 --procedure 选项解析成明确的过程选择器,再调用 runDirectAnalysis(),操作名是 analyze_function。
DirectAnalysis.ts 负责原生目标的分析生命周期。执行到 analyze_function 分支时,它调用 executeFunctionAnalysisEvidence()。
MCP 的入口不同:registerEnhancedTools.ts 用命名契约注册 analyze_function,完成请求准入后进入 executeFunctionTool()。这个函数也调用 executeFunctionAnalysisEvidence()。
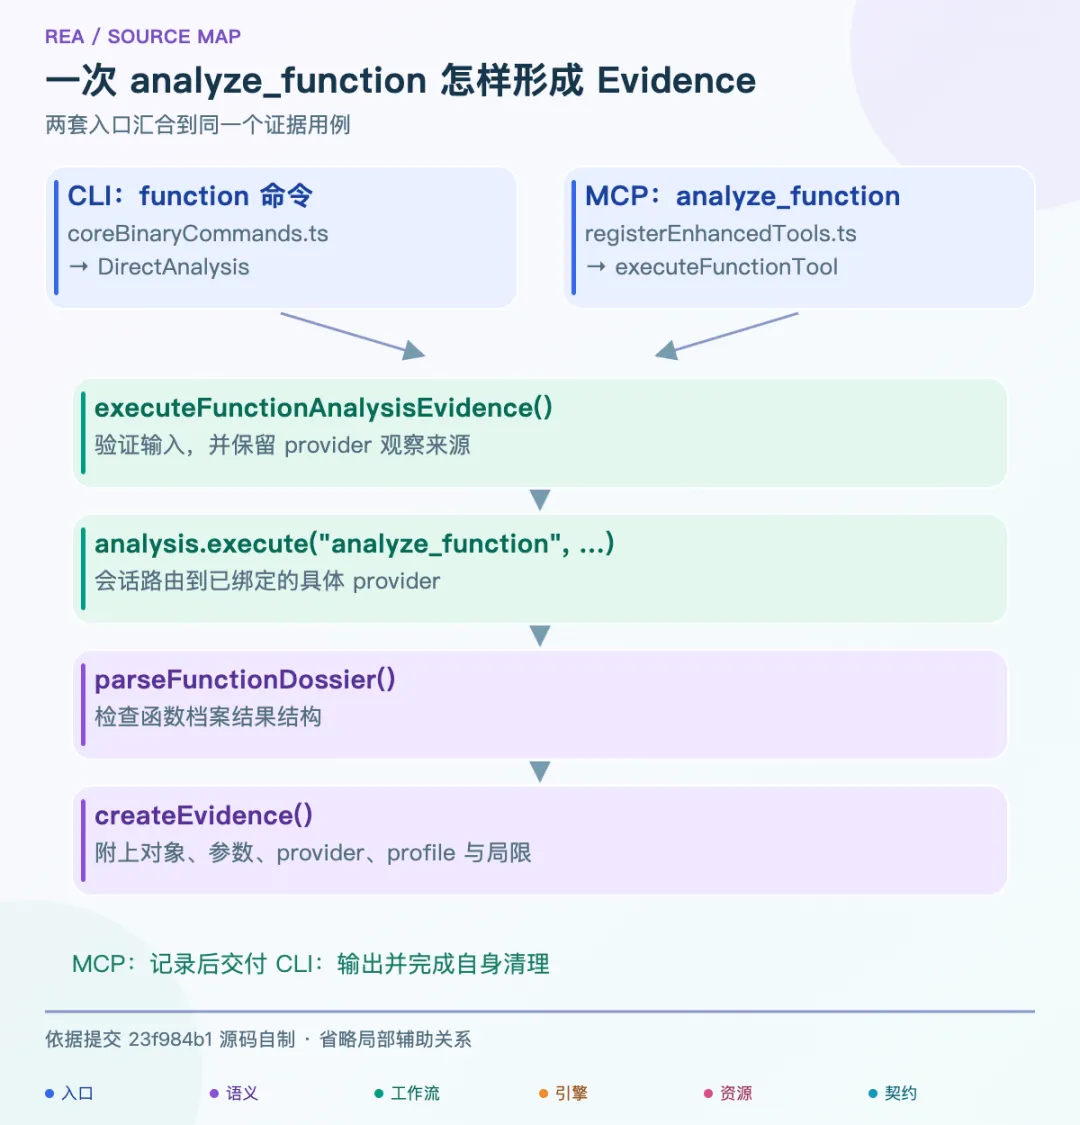
图 8:CLI 与 MCP 在
executeFunctionAnalysisEvidence()汇合。analyze_function的生产路径专门保留 provider 的观察来源;不要把所有增强工具都画成同一条组合链路。依据相关函数自制。
共享函数首先用工具契约验证参数,再调用分析端口的 execute("analyze_function", …)。获得结果后,parseFunctionDossier() 检查函数档案结构,最后用 createEvidence() 包装结果。
这里的函数档案并不只有伪代码。它可以包含该 provider 获得的函数事实与关系,具体字段和覆盖由结果契约约束。包装时还会保留 provider、profile、原始结果、位置、局限以及关系覆盖信息。
在 MCP 路径中,成功结果会交给记录端口,并由统一 delivery 编码返回。CLI 则继续走自己的输出和会话清理路径。
这条链路展示了 REA 怎样复用用例:入口不同,生命周期不同,获得事实和构造证据的语义保持一致。[4]
八 契约说明如何调用 Evidence 说明答案依据什么
ToolContract 是工具的公开定义。除了名字和 schema,它还包括描述、示例、效果元数据、MCP 提示,以及返回内容是否可能来自分析目标。
schema 是机器可检查的数据规则。例如输入必须包含哪些字段,某个字段能否省略,输出可以出现哪些状态。类型约束帮助开发者接对 handler,运行时校验负责处理真正传进来的未知值。
预期失败通过 Result 表达:成功时包含 value,失败时包含带类型标记的 error。取消、资源限制和清理未完成可以保留各自语义,再由 CLI 或 MCP 投影成调用者可读的错误。
REA 的 toolContract(name) 按工具名返回对应契约,并保留精确的 schema 类型。工具目录可以排序用于展示,但位置不能决定执行哪项操作。
returnsTargetContent 还说明结果可能包含目标程序提供的文字,成功和失败都可能如此。交付层会标记这类不可信内容,避免把来源不同的文本混成同一类协议说明。
工具返回的事实还有另一层结构:Evidence,带有来源与结论范围的证据记录。
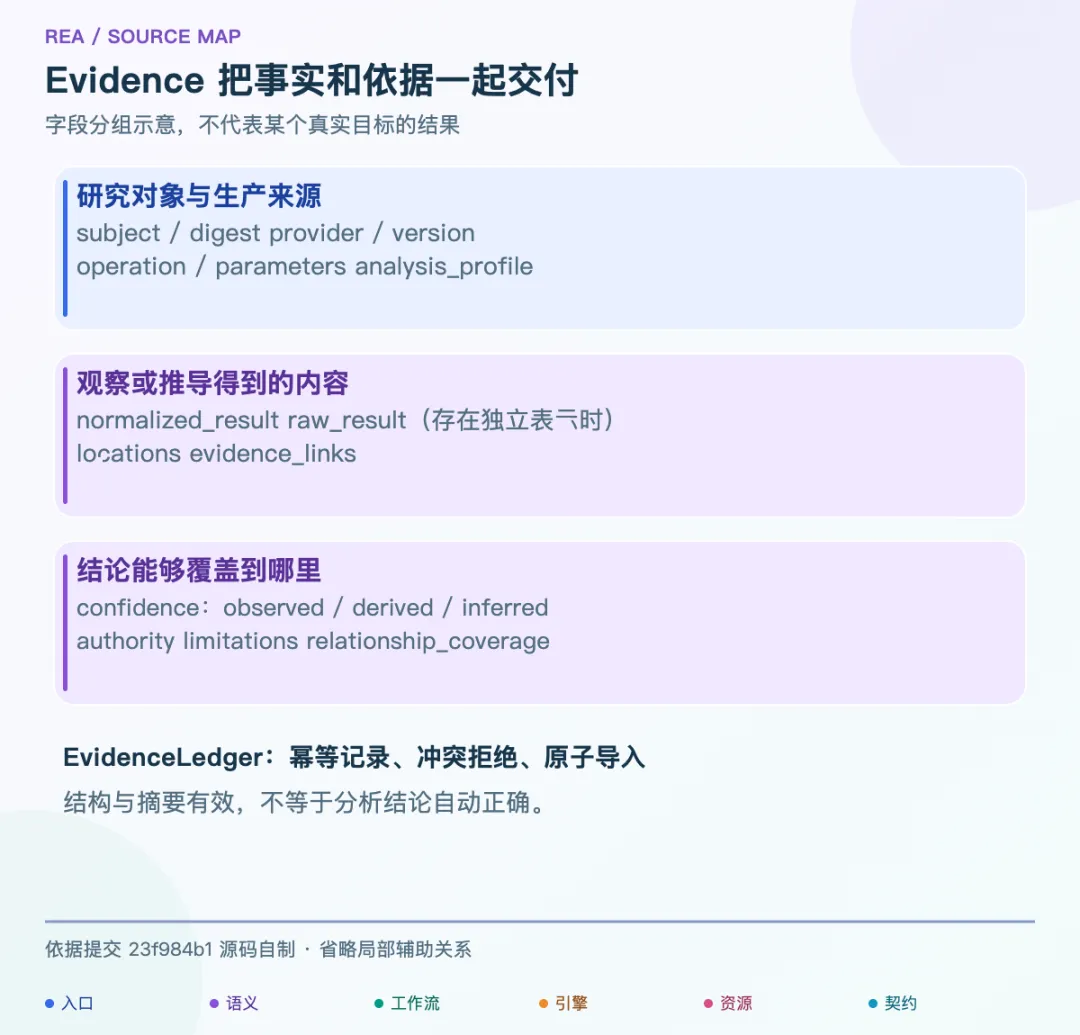
图 9:Evidence 将对象身份、生产者、操作输入、观察内容和结论范围放在同一份记录中。图示为字段分组,不是一份真实目标的分析结果。依据
domain/evidence.ts自制。
假设某个引擎返回“函数 A 调用了函数 B”。只有这句话,调用者无法判断它来自哪个程序版本、哪个引擎,也不知道它是静态引用、运行观察还是推断。
Evidence 会同时保留对象与摘要、provider 身份、操作与参数、规范化结果、来源位置和局限。适用时还会带上 analysis profile,即影响分析结果的引擎版本与设置承诺。
confidence 区分 observed、derived 和 inferred,也就是观察、按规则推导和推断。authority 描述证据来自发货工件、受控重放、历史参考、外部服务还是分析推断等来源;这两个维度回答不同问题。
另一项容易误读的是 relationship_coverage。它描述 provider 返回的直接关系集合是否存在已知读取缺口;即使该集合被标为 complete,也不代表所有可能的运行时调用都已找到。
证据记录由 EvidenceLedger 管理。相同 ID、相同内容的重复记录是幂等操作;同 ID 却出现冲突内容时会拒绝。bundle 导入先验证,再原子合并,避免半份不一致记录进入调查。
InvestigationRecords 把读取、写入和未知项管理组织成较窄的端口。消费者按所需能力接入,不必都拿到整个会话对象。
Evidence 提高了可追溯性,但 schema 校验和摘要一致性不能替 provider 保证语义正确。反编译器的错误、未解析调用和不完整观察仍然需要在结果中保留。[5]
九 会话选择一个深度引擎 再组合辅助能力
src/composition/binary.ts 是理解原生装配的关键入口。这里创建 Hopper、Ghidra、IDA、Kuna 候选,把它们交给 AnalysisProviderRegistry,并另外创建延迟加载的辅助 provider。
深度 provider 负责重叠的原生分析能力。辅助 provider 可以提供工件、托管或平台特定能力,但路由需要保证操作归属明确,不能让同一操作同时被多个互相冲突的拥有者解释。
自动选择规则比“按顺序试几个引擎”更严格。Registry 先发现候选的可用性和目标支持,再判断哪些候选能形成有效 profile。
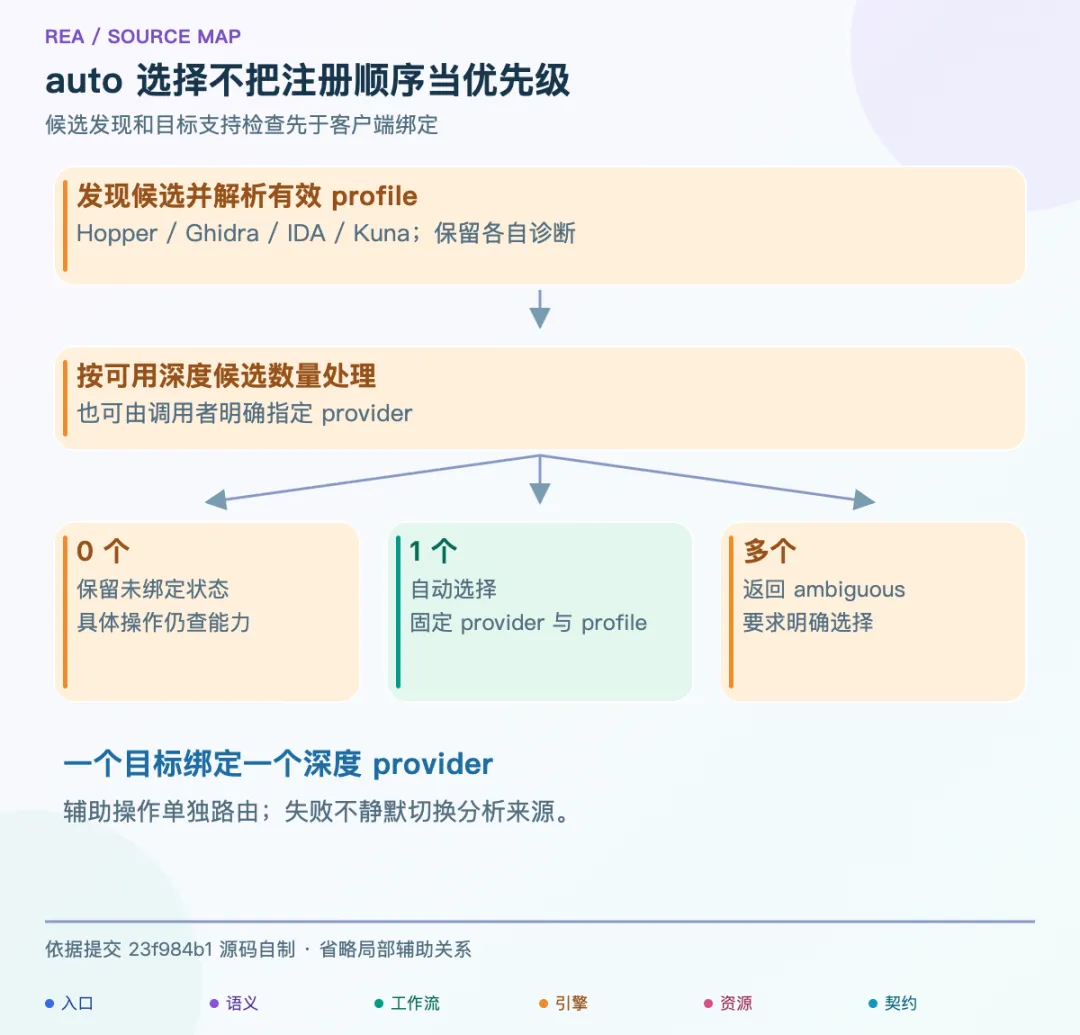
图 10:零个、一个、多个可用候选分别有不同结果。零候选可保留未绑定状态,后续操作仍受能力检查;多候选返回歧义,要求明确选择。依据 Registry 自制。
没有可用深度候选时,可以保留未绑定状态。恰好一个时自动选择。多个可用时返回 ambiguous,调用者需要指定 provider;候选注册顺序不会变成隐藏优先级。
这样做有明确的语义收益。分析到一半静默切换引擎,会改变结果来源、命名规则、类型恢复和分析 profile,原先保留的证据与缓存也可能不再适用。
BinarySession 持有当前目标与绑定。切换目标前,它会串行化过渡,并等待针对当前目标的调用排空。如果旧 client 已经被关闭,而新目标打开失败,恢复旧目标需要重新创建客户端,不能继续使用已经拆掉的实例。
对同一目标的复用也有存活检查。保存着一个 JavaScript 对象,不代表它背后的分析进程和连接仍然健康。[6]
不同原生引擎有不同的实际边界
Ghidra 通过 headless 进程和 Java bridge 工作,使用临时分析数据库。解析安装、建立 profile、启动、握手和清理分别有专门代码;Windows P0 的能力范围更窄,不能套用其他平台的全部声明。
Hopper 使用应用内部的 Python bridge 和 Unix socket。启动分析辅助资源、附着已有应用、操作文档与移动 GUI 光标,是不同的效果与所有权。
IDA 通过 MCP 适配连接调用者已有环境,连接模式也有差异。附着的 GUI 数据库保持只读,不能因为 REA 管理连接就保存或关闭它。
Kuna 是独立候选,具有自己的支持范围。GNU objdump、Rizin 和 Cutter 还提供另外的命令或 bridge 能力,不能把这些接口理解为完全相同的反编译服务。[7]
十 取消请求只是开始 资源清理还有自己的结果
逆向分析经常会启动进程、创建临时工程、打开 socket、读取大文件。正常返回结果只是其中一条路径,启动失败、超时、取消和清理失败都必须有对应处理。
REA 把通用进程监管放在 src/process/,把部分延迟 client 与检查资源的拥有者放在 src/providers/,工件资源则有 ArtifactResourceScope 和 cleanup lease 等结构。
scope 记录这一轮操作获得了哪些资源;lease 保留释放某个具体资源所需的能力。它们让“谁负责清理”可以沿错误路径继续传递。
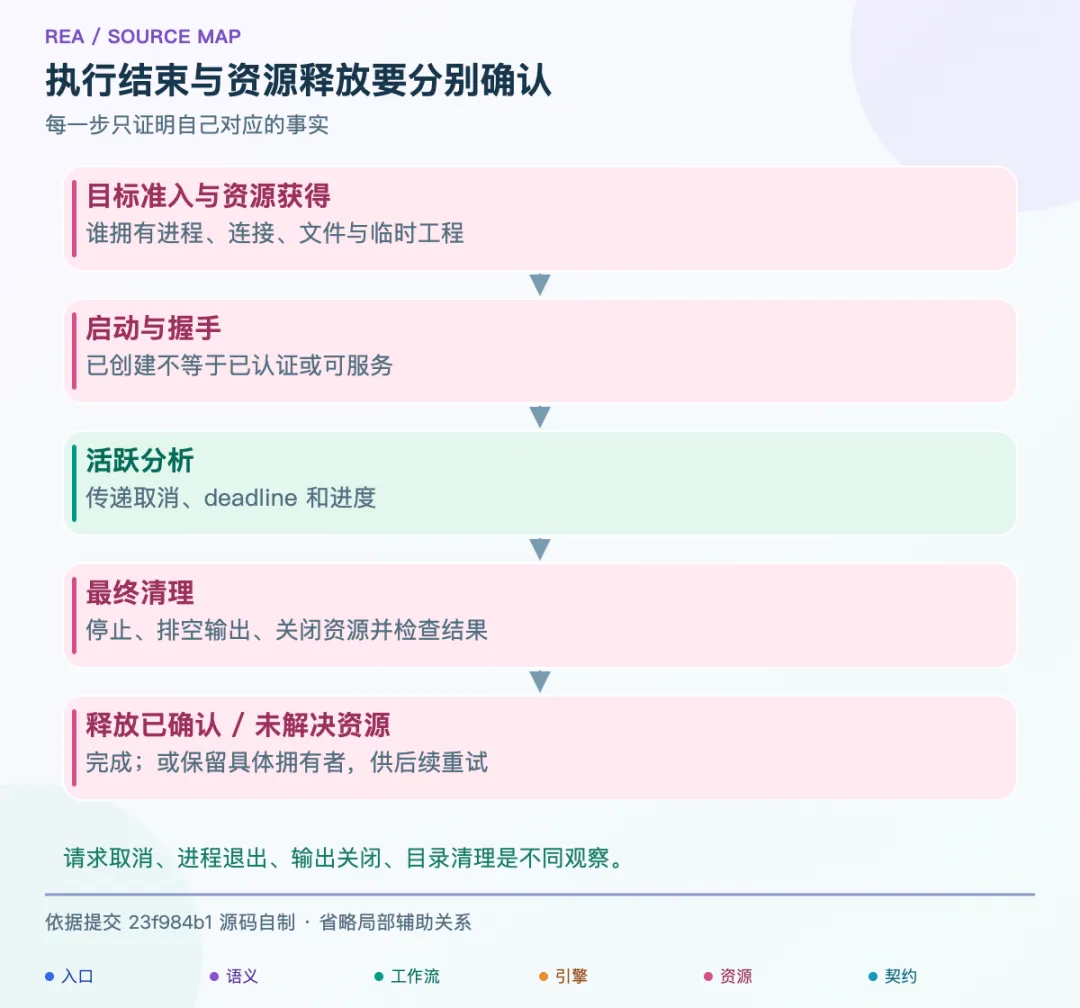
图 11:这是跨 provider 的生命周期不变量示意。清理未确认时保留原拥有者,重试只针对未解决资源。依据进程监管与资源 scope 自制。
进程 ID 不能单独证明所有权。一个 PID 可能被系统复用,启动器退出后也可能还有子进程。清理需要结合进程组、启动身份、命令与 run token 等生产边界获得的事实。
同样,进程退出不等于输出流已关闭,输出流关闭也不等于临时工作区已经释放。这些观察需要分别记录。
SharedStartupAttempt 处理了一个更细的场景:多个调用者等待同一次启动。某个等待者取消时,如果其他人仍需要它,启动工作继续;最后一个等待者离开时,才触发停止并等待生产者完成清理。
这避免了把“我的请求取消了”误解成“所有人的共享资源都应立即销毁”。provider 拥有者主动关闭,又是另一种信号。
取消发生在收尾阶段也要保留。若结果已采集、最终清理时才收到取消,不能简单丢掉已完成观察,也不能把清理失败包装成普通成功。主要失败、部分 Evidence 和未解决资源各有自己的事实。[8]
十一 JavaScript 分析会同时建立应用图和语义图
JavaScript 与 Electron 是另一条适合深入的源码路径。它说明 REA 的分析并不都要启动原生反编译引擎。
analyze_javascript_application 的服务入口位于 JavaScriptApplicationService.ts。它接受本地目录或 ASAR,后者是 Electron 常见的资源归档格式。
服务调用 reconstructJavaScriptArtifact(),通过工件读取器获取文件、建立稳定清单,再选择相关源码进行静态解析。静态解析意味着读取程序文本和结构,不运行这个应用。
AST 是抽象语法树,可以把它理解为解析器眼中的程序结构:哪些位置声明了函数,哪些表达式执行调用,哪些语句导入模块。它比对整份脚本做文本搜索更适合提取结构关系。
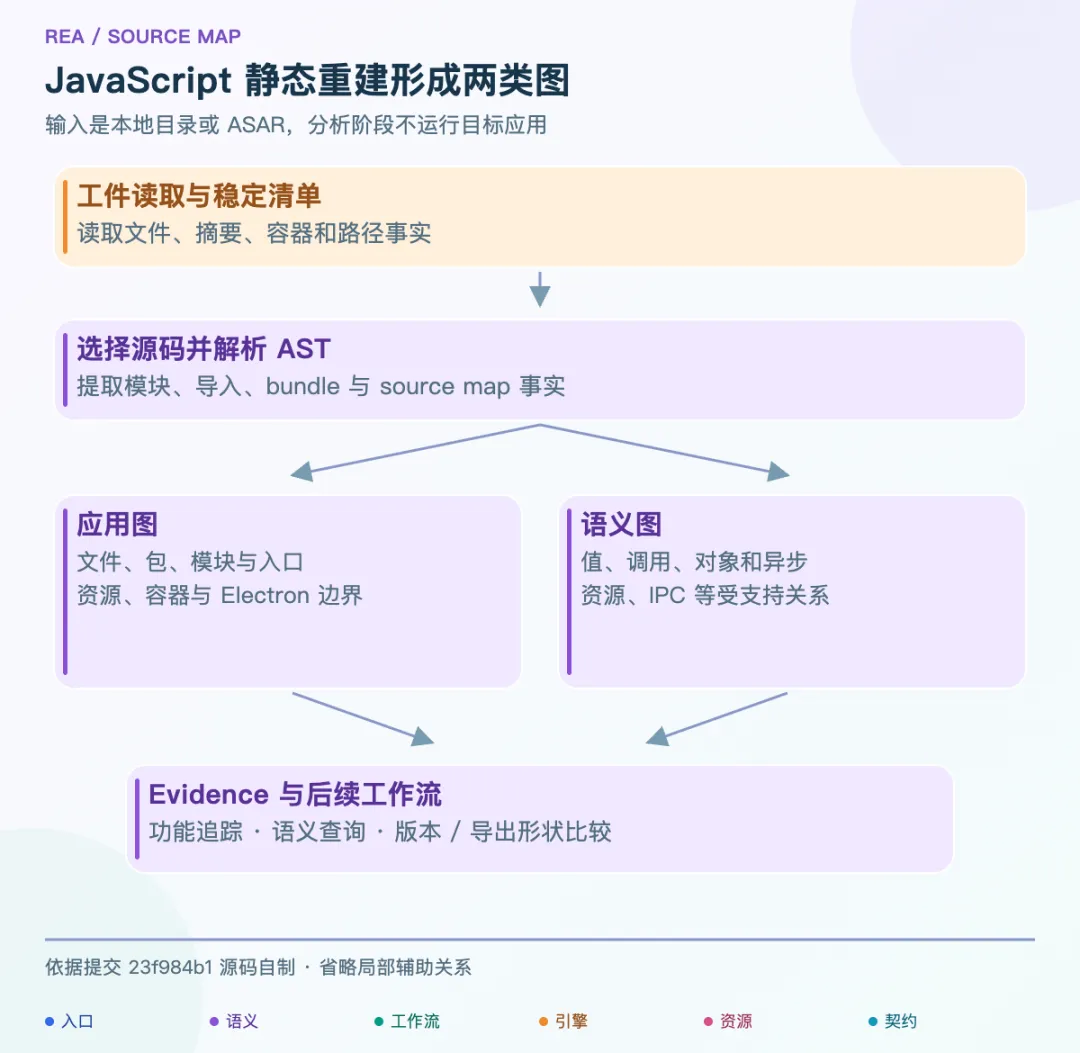
图 12:应用图回答模块与资源怎样组织;语义图进一步表达受支持的值、调用、对象、异步与跨边界关系。依据 JavaScript 重建代码自制。
应用图描述文件、包、模块、入口、资源和容器之间的关系。语义图进一步表达受支持的程序关系,例如值与调用、对象成员、异步行为、资源,以及 Electron 边界。
这些投影被拆成多个明确模块:工件结构、bundle、source map、IPC、窗口、child process 等分别处理。下游使用拥有者已经解析的事实,避免在每层重新猜测同一段源文本。
Electron 中,一项功能可能从 renderer 页面进入 preload,经 contextBridge 暴露的接口到达 IPC channel,再进入 main process,最后调用 native addon 或子进程。renderer、preload 和 main 可以理解为页面代码、受控桥接层与应用主进程。
源码并没有把所有这些边都视为同等强度的证明。IPC 配对、未解析动态行为和源文件遗漏仍会影响覆盖;画出了静态关联,不等于确认它实际执行。
有了图与 Evidence,JavaScriptApplicationWorkflowService.ts 可以继续进行功能追踪、应用版本比较、历史源码与 bundle 对照、导出返回形状比较。比较工作流先验证双方证据与图身份,再派生新的结果。[9]
十二 浏览器和 Inspector 补上实际发生过的观察
静态分析解释代码可能怎样组织,运行时观测记录选定目标在某段观察范围内发生了什么。REA 为后者准备了浏览器、Electron 和 V8 Inspector 接入。
CDP 是 Chrome DevTools Protocol,即浏览器开发者工具使用的远程协议。REA 的 CDP 适配器处理目标连接、页面快照、脚本、网络和其他观察,并保留目标与 frame 身份。
Playwright 场景则处理明确的交互步骤和产物。截图、storage、service worker、事件与场景资源分别有自己的代码;Electron 主动场景还涉及启动应用与执行请求动作。
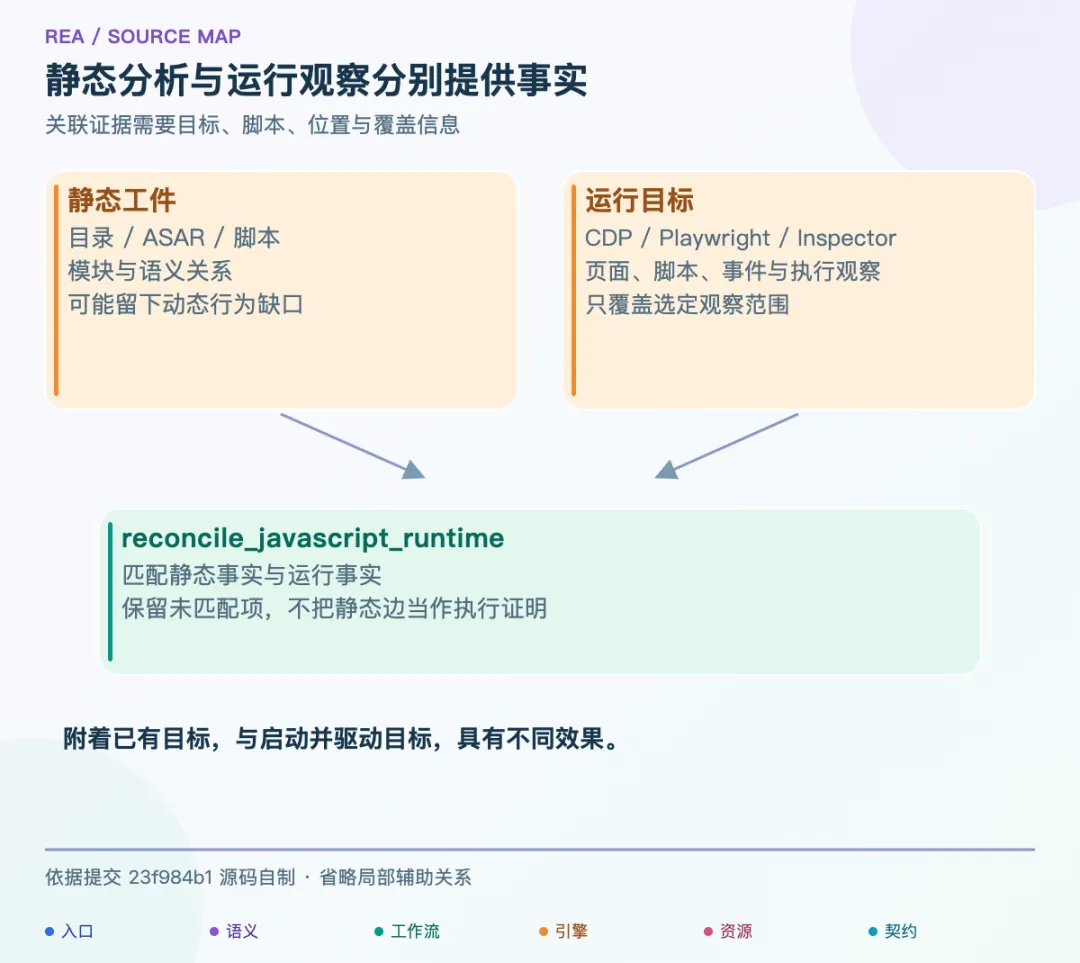
图 13:两种证据可以相互关联,但不能互相代替。关联依赖目标、脚本、位置与覆盖信息。依据浏览器服务和运行时 reconciliation 代码自制。
src/inspector/ 提供 V8 Inspector 目标发现和捕获。它与浏览器适配共享部分 CDP、文件和位置处理,但面向的目标与观察范围有所不同。
reconcile_javascript_runtime 可以把运行观察和静态 JavaScript 分析联系起来。这里的 reconciliation 是核对两种证据:哪些运行脚本或事件能在静态工件中找到对应项,哪些仍未匹配。
历史网络文件又是另一种输入。HAR、SAZ、qlog 或 mitmproxy 捕获反映的是保存下来的观察,不能当作服务此刻仍保持相同行为的证明。
读这部分代码时,尤其要区分“打开一个已有目标的连接”和“启动并驱动一个目标”。两者可能都返回页面信息,但副作用与清理责任不同。[10]
十三 更多能力沿着相同的证据原则扩展
REA 的格式支持面很宽,但可以沿“从哪里获取事实”分组阅读。
托管与移动代码。.NET 路径静态读取 PE/CLI 元数据、类型、成员与 CIL 指令,还支持 native 边界和成员比较。Android APK/DEX 路径接入 headless JADX,查询包、类、方法和引用;Apktool 负责另外一类资源解码。
应用结构与构建身份。 Flutter 相关功能处理构建、snapshot、engine 来源和 Dart AOT 检查;它不等于自动恢复完整 Dart 源码。JEB 接入调用者启动的 MCP 客户端;Android、Apple、Harmony 还有基于已有工件事实的应用图投影。
专用字节码和数据格式。 WASM 使用调用者提供的 WABT;EVM 在受限 worker 中调用 EVMole 推断接口;Go、Rust 提供各自的静态检查。SQLite 对拥有的数据库副本执行可取消检查,避免写入输入数据库。
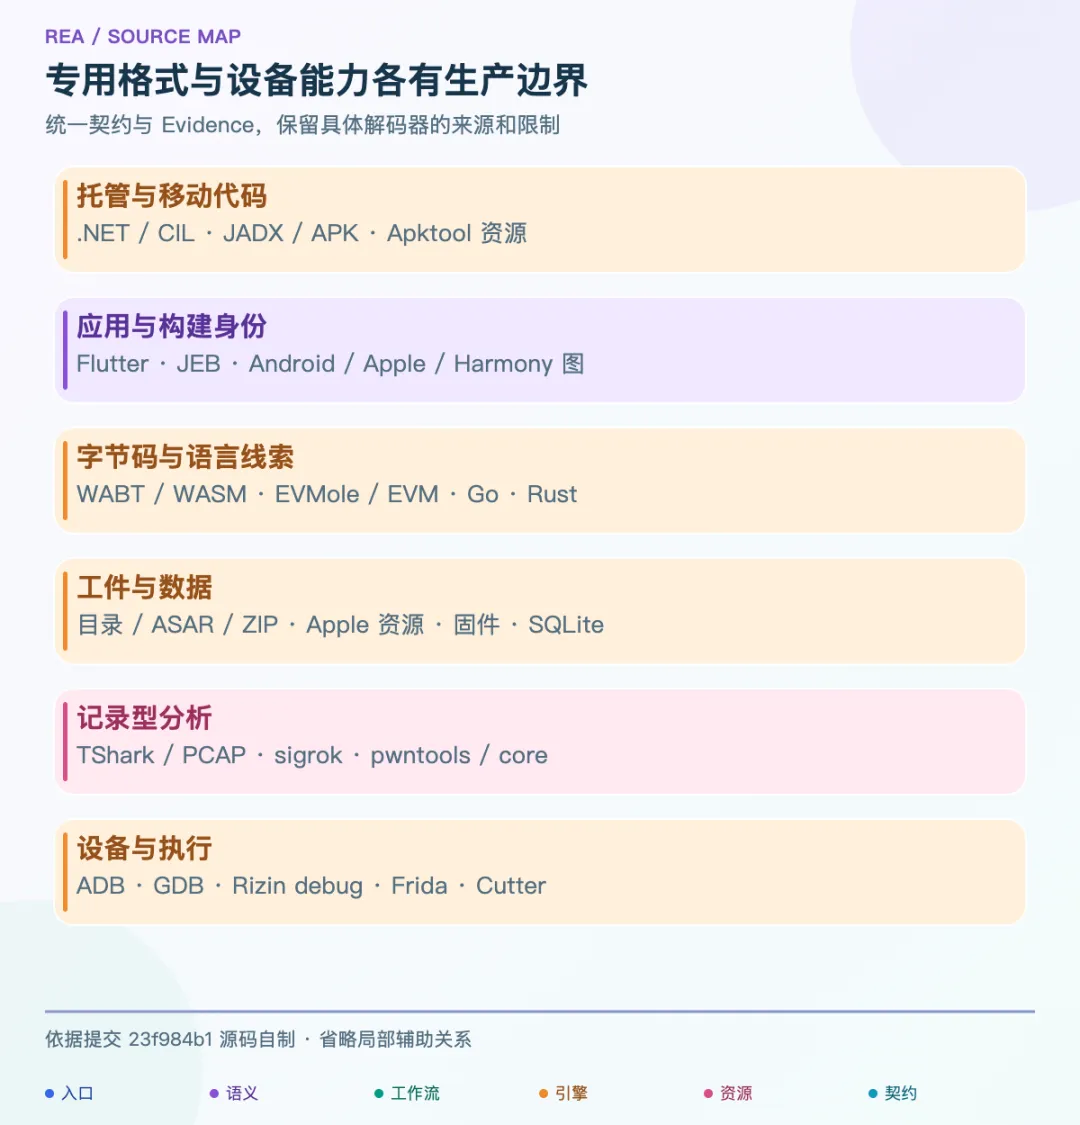
图 14:同一组中也可能包含不同效果的操作。实际依赖、宿主与覆盖以各工具契约、provider 和对应指南为准。依据源码和 README 自制。
工件与资源。artifacts/ 提供目录、ASAR、ZIP 等读取,生成清单并处理提取。Apple 资源包含 plist、Interface Builder、keyed archive、asset catalog 等;固件通过 Binwalk、Unblob 取得区域和提取结果,再交给后续分析。
记录型数据。 包捕获有 TShark、capinfos 相关路径,字段选择与高层摘要分开。逻辑信号接入 sigrok-cli;离线 ELF/core 分析还使用调用者已有的 pwntools,部分路径可用 core-only GDB/pwndbg。
设备与调试。 ADB 除了读取设备、包、日志和屏幕,也有文件传输、安装卸载、启动停止等操作。GDB、Rizin debug、Frida 和 Cutter 具有自己的会话或命令能力。
因此,“分析在本地运行”不能推导出“所有工具都只读”。toolEffects.ts 明确描述启动进程、网络访问、目标或设备修改、外部代码执行、UI 改变等效果,调试命令和注入能力尤其需要按实际请求理解。[11]
十四 缓存能否重放 取决于身份和操作语义
反编译和大工件分析存在可复用结果,但缓存不能只以文件路径为键。路径上的内容会变,引擎版本和设置也可能影响结论。
REA 的 analysis profile 将具体 provider 身份、版本和影响分析的参数规范化,并计算摘要。目标、profile、操作和参数共同参与快照查询的身份。
AnalysisSnapshotCache 既保存适用的 provider 查询,也保存派生工作流的结果。目标或 profile 不匹配时,已有绑定不能继续复用。
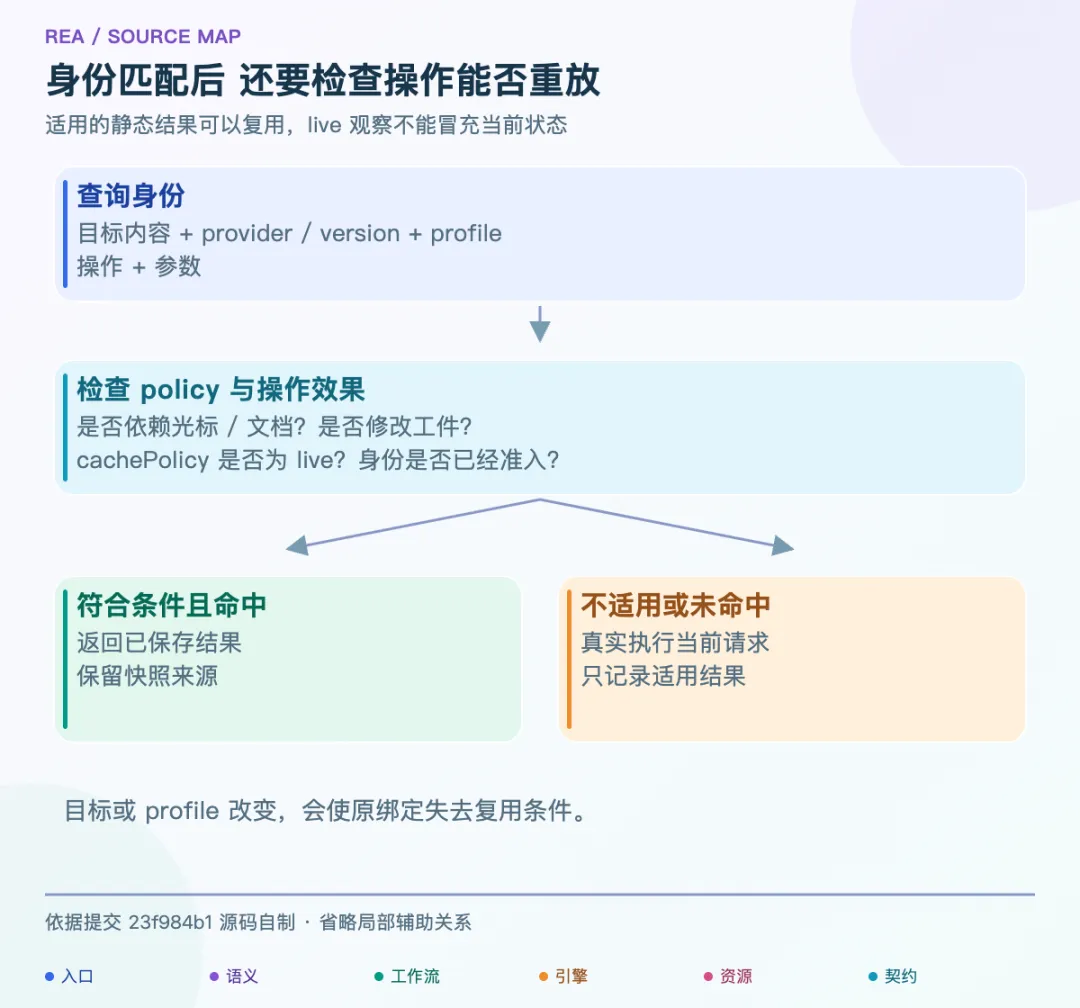
图 15:身份匹配只是前提,操作还必须适合快照重放。live 状态、依赖当前光标的调用、修改操作等有不同限制。依据缓存实现自制。
isSnapshotCacheable() 还检查操作本身。依赖当前文档或光标的请求,需要明确身份;修改工件、实时状态和部分文件系统效果也影响缓存适用性。
cachePolicy 为 live 的能力不能被快照重放成“现在的状态”。这对附着进程、GUI 和运行观察很重要,因为它们会在两次调用之间变化。
CLI 可以用显式 snapshot 在独立命令之间复用符合条件的结果。MCP 在会话中自然保留状态,但仍要区分保存过的静态证据与当前 live 健康情况。
另一个优化方向是减少不必要的上下文。inspect_analysis_view 从保留 Evidence 中读取相关视图;MCP delivery 管理响应编码与预算,必要时报告资源限制或给出适用的 continuation。完整证据的保留和本次展示的大小分别有拥有者。
这些代码说明了复用和交付机制,不能单凭机制存在就给出提速比例。本文没有测量 token、CPU、内存或冷暖耗时。[12]
十五 测试要沿生产边界选 真实引擎需要另外验证
固定提交中,仓库共有 1,580 个 *.test.ts 文件。这是文件数,不是断言数、通过数或覆盖率。
Vitest 项目按边界拆分。domain、services 关注规则与工作流;adapters、composition 覆盖适配和装配;conformance、evaluation 处理契约一致性和评价规则。
更靠外的项目包括 CLI、MCP、进程边界和 acceptance。acceptance 面向编译后的公共工作流,进程边界则需要处理真实宿主上的身份、退出和清理观察。
对应到文件组织,tests/boundary/ 有 813 个文件,其中 798 个是 *.test.ts;tests/acceptance/ 有 125 个文件,全部采用测试命名。tests/fixtures/ 有 214 个文件,提供样本和假引擎;tests/conformance/ 有 108 个文件,其中 25 个为测试,其余包括用于对照的材料。这些目录总数与测试文件数需要分开看。
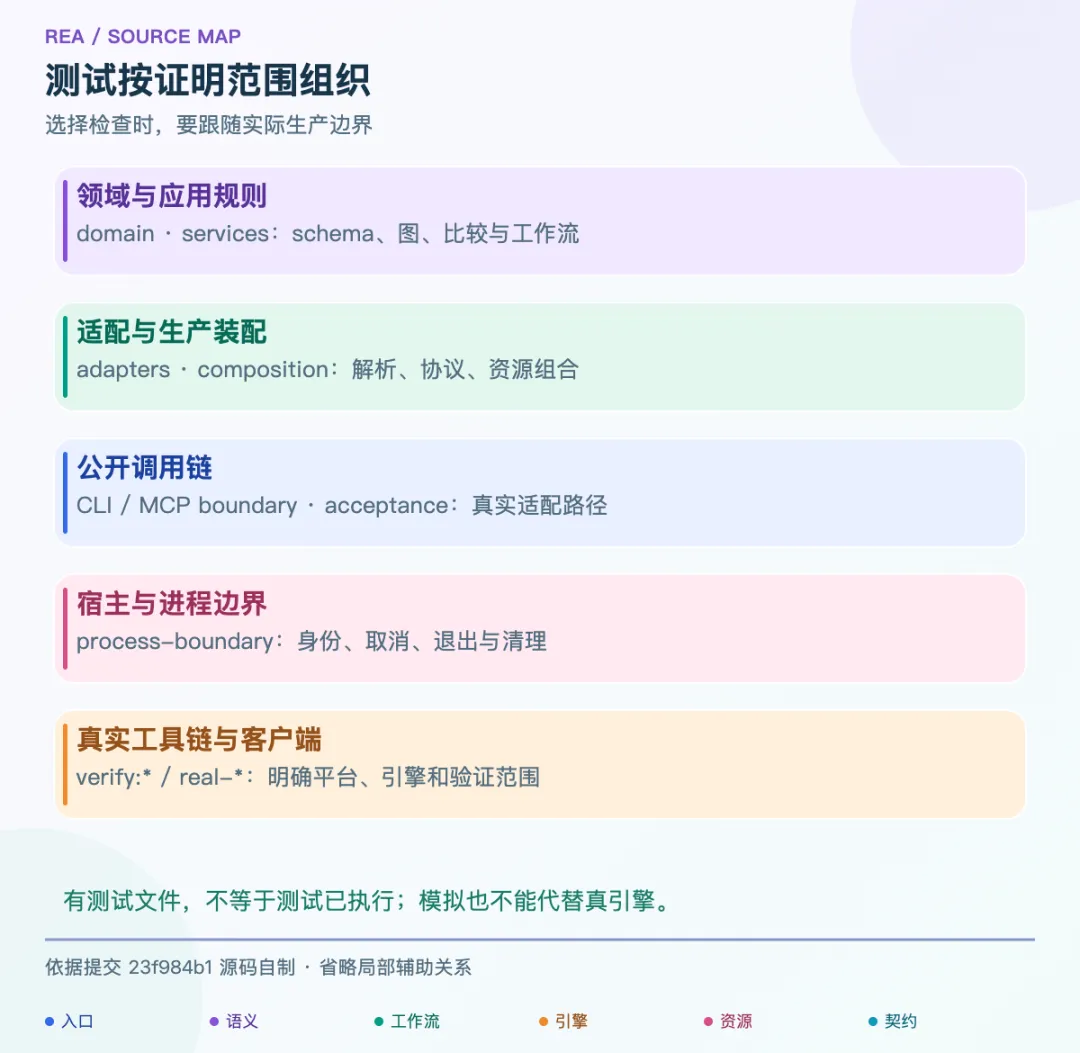
图 16:模块测试、公共工作流和真实 provider 验证各有用途。通过模拟边界不能代替真实引擎运行。依据测试项目定义与 testing 指南自制。
日常修改可以先用 npm run test:local -- PATH... 运行精确源码测试。test:focused 根据所选现有文件准备必要产物;涉及编译、注册、bridge 或公共调用链时,再选对应 boundary 和 acceptance。
按导入图选择测试可以减少反馈成本,但它可能遗漏运行时注册、生成数据、shell 或语言桥接关系。空选择只能说明没有选到测试,不能说明功能正确。
仓库还有 verify:* 脚本和 real-* workflow,检查指定真实工具链、平台或客户端。真实 Ghidra 的结果不能由假 bridge 证明,Windows 的生命周期也不能由 macOS 模块测试代替。
公开 schema 也需要分层验证。源 Zod 规则正确,不等于 SDK 转换出的 JSON Schema 符合声明的 dialect;schema 有效,又不等于实际客户端能接受和正确展示。因此仓库还有转换后的 schema 与客户端验证要求。
这也解释了为什么 provider 修改的验证成本较高:它跨越类型、文件、协议、操作系统和引擎本身。[13]
十六 比较与重建需要把未知项留在结果里
REA 的一部分工作发生在取得初始证据之后:比较两个工件、函数、应用版本或运行场景,追踪变化,再判断重建方案覆盖了哪些边界。
比较首先要求可比较性。两次结果是否对应明确的输入,双方覆盖是否对齐,差异来自源程序还是不同分析设置,都影响最后的解释。
Unknown 是对未解决问题的显式记录。它可以随调查形成修订,并与支持或解决它的 Evidence 关联;“没有查到”不能直接改写成“目标里不存在”。
重建覆盖和义务账本进一步记录哪些边界需要验证,以及已有材料支持到哪里。账本表达验证责任和状态,不能为没有执行的验证生成成功事实。
例如,静态观察支持“按钮处理器可能走到某项 IPC”,与受控运行验证“指定输入下确实发生了对应行为”,应保留为不同证据。把二者都标成“已还原”,会丢掉重建中最有价值的缺口信息。[14]
十七 开发时先找拥有者 再决定改哪一层
阅读源码的下一步通常是修改功能。这里最实用的问题是:这项解释应该由谁负责,这份资源应该由谁释放。
新增一种文件格式,通常要补齐格式语义、生产边界解码和应用服务,再考虑公开契约与适配入口。新增组合分析,则应优先使用已有解析事实,保留每项事实的来源与局限。
新增 provider 时,除操作实现外,还需要可用性、目标支持、profile、取消、进度、握手与精确清理。若涉及执行、注入、修改或保护恢复,还需先按 CONTRIBUTING 明确维护者范围决定;探索原型不等于可以直接集成。
仓库要求在修 bug 或处理 review 时检查生产边界和消费者。下游不断补正则、补别名或重读原始字符串,往往说明同一份解释被复制到了多处。
先修拥有者提供的表示,再让消费者使用同一份解析事实,可以同时减少语义分歧和重复工作。直接相关的旧包装、旧表示与冗余测试也应随变更清除,而不是永久保留两套路径。[15]
构建方面,这个提交用 .nvmrc 固定 Node 24.18.0,packageManager 固定 npm 11.16.0。常用入口是 npm ci、npm run build:cached、npm run check:fast 和 npm run docs:check;涉及 Turborepo 配置时,应以仓库安装版本自带文档为准。
setup 也有明确边界:先展示计划,经批准后再写配置或安装 Hopper,并保留备份。Ghidra、IDA 由调用者提供,安装流程不能顺便升级无关工具链。[16]
十八 新人可以沿两条路径建立阅读顺序
第一轮只读入口和公共语言:scripts/rea.mjs、src/cli.ts、src/main.ts,接着读 Result、Evidence、AnalysisProvider 和 ToolContract。先弄清请求、结果、预期错误与来源怎样表达。
第二轮选择原生路径。沿 function 命令进入 DirectAnalysis 和 FunctionAnalysisEvidence,再到 BinarySession、Registry 与某一个 provider。最后追到它使用的 bridge 和资源监管。
第三轮选择 JavaScript 路径。沿 JavaScriptApplicationService 进入工件重建,观察清单、AST、应用图、语义图和 Evidence 如何逐步形成,再读功能追踪或版本比较。
第四轮对照测试。对同一能力分别找 CLI/MCP 的 boundary、生产边界集成和真实 provider 验证脚本,看看源码规则在哪种环境里被检查过。
读完后,可以用六个问题检查理解:输入身份是什么,谁负责解析,谁组织工作流,哪个 provider 生产事实,证据保留了什么,以及失败后谁继续负责清理。
REA 的核心设计集中在这些连接处。引擎提供分析能力,共享工作流组织问题,Evidence 保留依据,会话与资源拥有者维持执行过程的完整性。理解了这些连接,再进入某一种格式或工具,源码就更容易定位。
分析范围
本文依据固定提交的源码、契约与仓库文档,并复用了该提交的全量生产 TypeScript 解析和工具目录清点。静态引用扫描覆盖 1,506 个文件,识别 9,141 条已解析内部相对导入或重导出声明,包含类型导入和字面量动态导入;这不是运行时函数调用图。
本文没有运行 REA 产品测试套件或启动真实分析目标。配图都是根据源码自制的示意图,图中未展开的辅助依赖仍应以实际代码为准。
参考来源
以下源码于 2026-10-20 从本地固定提交读取。链接均指向同一提交;完整事实分类、逐项位置和统计口径见配套 sources.md。
项目说明与版本 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/package.json架构与模块边界 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/docs/architecture.mermaid可执行分发入口 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/scripts/rea.mjs函数证据工作流 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/src/application/FunctionAnalysisEvidence.tsEvidence 领域模型 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/src/domain/evidence.tsProvider 选择规则 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/src/application/binary/AnalysisProviderRegistry.ts原生生产装配 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/src/composition/binary.ts生命周期设计 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/docs/tool-design.mdJavaScript 工件重建 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/src/application/javascript/JavaScriptArtifactReconstruction.ts浏览器观察指南 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/docs/browser-observation.md全部工具与效果 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/src/contracts/toolContracts.ts快照缓存 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/src/application/binary/AnalysisSnapshotCache.ts测试指南 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/docs/testing.md重建义务账本 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/src/application/ReconstructionObligationLedgerService.ts贡献约定 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/CONTRIBUTING.md安装工作流 : https://github.com/morluto/rea/blob/23f984b1a884baefc3c44e4ab697f6eff61dffb6/src/application/Setup.ts